
डेटा इंजीनियर लर्निंग पाथ
यदि आप डेटा इंजीनियर बनने पर विचार कर रहे हैं, तो यह ब्लॉग पोस्ट आपकी सभी ज़रूरतों को कवर करता है। मैं बताऊँगा कि डेटा इंजीनियर क्या होता है, दैनिक काम में उसकी भूमिकाएँ और ज़िम्मेदारियाँ कैसी दिखती हैं, और 2026 में डेटा इंजीनियरिंग क्यों एक संतोषजनक करियर है। साथ ही, मैं आवश्यक कौशल और योग्यताओं पर चर्चा करूँगा और पहली नौकरी पाने के लिए सुझाव साझा करूँगा।
हालाँकि, एक नज़र में, तकनीकी डेटा इंजीनियर का लर्निंग पाथ इस प्रकार है:
- Python और Scala जैसी भाषाओं में प्रोग्रामिंग में दक्ष बनें।
- ऑटोमेशन और स्क्रिप्टिंग सीखें।
- डेटाबेस प्रबंधन समझें और अपने SQL कौशल विकसित करें।
- डेटा प्रोसेसिंग तकनीकों में महारत हासिल करें।
- अपने वर्कफ़्लोज़ को शेड्यूल करना सीखें।
- AWS जैसे प्लेटफ़ॉर्म पर क्लाउड कंप्यूटिंग का ज्ञान विकसित करें।
- Docker और Kubernetes जैसे इंफ्रास्ट्रक्चर टूल्स का ज्ञान विकसित करें।
- उद्योग प्रवृत्तियों से अद्यतन रहें।
हम इस पोस्ट में इनमें से कई बिंदुओं को विस्तार से कवर करेंगे, क्योंकि हम जानेंगे कि डेटा इंजीनियर कैसे बनें।
डेटा इंजीनियर क्या है?
डेटा इंजीनियर्स किसी संगठन में डेटा के अधिग्रहण, संग्रहण, रूपांतरण और प्रबंधन की बुनियाद रखते हैं। वे डेटाबेस आर्किटेक्चर और डेटा प्रोसेसिंग सिस्टम्स के डिज़ाइन, निर्माण और रखरखाव का प्रबंधन करते हैं, ताकि विश्लेषण, विज़ुअलाइज़ेशन और मशीन लर्निंग मॉडल विकास का आगे का काम निर्बाध, सतत, सुरक्षित और प्रभावी ढंग से हो सके।
संक्षेप में, डेटा इंजीनियर्स डेटा साइंस क्षेत्र में सबसे तकनीकी प्रोफ़ाइल होते हैं, जो सॉफ़्टवेयर और एप्लिकेशन डेवलपर्स तथा पारंपरिक डेटा साइंस पदों के बीच एक अहम सेतु का काम करते हैं।
डेटा इंजीनियर्स पारंपरिक डेटा साइंस वर्कफ़्लो के पहले चरण के लिए ज़िम्मेदार होते हैं: डेटा संग्रह और संग्रहण की प्रक्रिया। वे सुनिश्चित करते हैं कि विभिन्न स्रोतों से एकत्रित बड़े पैमाने का डेटा अन्य डेटा विशेषज्ञों, जैसे डेटा विश्लेषक और डेटा वैज्ञानिकों, के लिए सुलभ कच्चा माल बन जाए।
एक ओर, इसमें उच्च उपलब्धता, प्रदर्शन और नई तकनीकों के एकीकरण की क्षमता वाली स्केलेबल डेटा इन्फ्रास्ट्रक्चर का विकास और रखरखाव शामिल है। दूसरी ओर, डेटा इंजीनियर्स इन प्रणालियों में डेटा की आवाजाही और स्थिति की निगरानी का काम भी करते हैं।
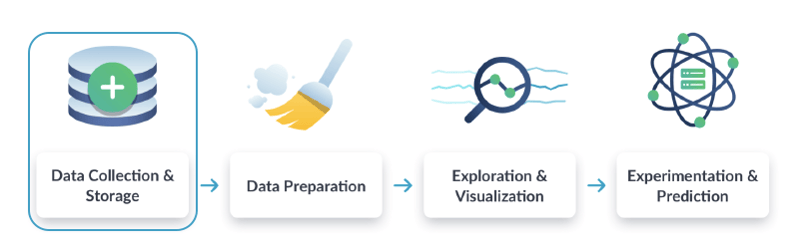
डेटा साइंस वर्कफ़्लो
डेटा इंजीनियर क्या करता है?
किसी भी कंपनी की डेटा आर्किटेक्चर के विकास और रखरखाव में डेटा इंजीनियर्स प्रमुख भूमिका निभाते हैं। वे बड़े डेटासेट्स को विश्लेषकों के उपयोग के लिए तैयार करने में विशेषज्ञ होते हैं। जब किसी विश्लेषक को जानकारी की व्याख्या करनी होती है, तो डेटा इंजीनियर डेटा को उपयुक्त प्रारूप में तैयार करने के लिए प्रोग्राम और रूटीन बनाता है।
नतीजतन, डेटा इंजीनियर का रोज़मर्रा का काम मुख्यतः तीन प्रक्रियाओं के बीच चलता है:
- ETL (Extract, Transform, Load) प्रक्रियाएँ, जिनमें डेटा का एक्सट्रैक्शन, ट्रांसफ़ॉर्मेशन और लोडिंग कार्य विकसित करना, साथ ही डेटा को भिन्न परिवेशों के बीच ले जाना शामिल है।
- डेटा सफाई और मॉडलिंग प्रक्रियाएँ, ताकि डेटा विश्लेषकों और डेटा वैज्ञानिकों के हाथ में सामान्यीकृत और संरचित रूप में पहुँचे।
- डेटा ऑर्केस्ट्रेशन ताकि जटिल डेटा वर्कफ़्लोज़ और डेटा पाइपलाइंस का शेड्यूलिंग, समन्वय और प्रबंधन स्वचालित हो सके।
हालाँकि, डेटा संग्रह और संग्रहण की प्रक्रिया अत्यंत जटिल हो सकती है। विभिन्न डेटा स्रोत शामिल हो सकते हैं, और इनके डेटा प्रकार भी अलग-अलग हो सकते हैं। जैसे-जैसे डेटा की मात्रा, विविधता और वेग बढ़ता है, डेटा इंजीनियर के काम की जटिलता भी बढ़ती है।
डेटा इंजीनियर्स तथाकथित डेटा पाइपलाइंस विकसित करते हैं, ताकि कार्य समय पर, मज़बूती से और स्केल पर पूरे हों। एक डेटा पाइपलाइन डेटा को परिभाषित चरणों से गुज़ारती है; उदाहरण के लिए, ऑन-प्रिमाइसेस डेटाबेस से क्लाउड सेवा में डेटा लोड करना।
एक प्रमुख विशेषता यह है कि पाइपलाइंस इस मूवमेंट को स्वचालित करती हैं। हर बार नया डेटा बनने पर डेटा इंजीनियर से मैन्युअली प्रोग्राम चलवाने की जगह, वह कार्य को घंटा-दर-घंटा, रोज़ाना, या किसी विशिष्ट घटना पर ट्रिगर होने के लिए शेड्यूल कर सकता/सकती है।
चूँकि प्रक्रिया स्वचालित है, डेटा पाइपलाइंस की निगरानी आवश्यक होती है। सौभाग्य से, अलर्ट स्वतः उत्पन्न किए जा सकते हैं। सभी डेटा साइंस परियोजनाओं के लिए डेटा पाइपलाइंस आवश्यक नहीं होतीं, लेकिन जब विभिन्न स्रोतों से बहुत-सा डेटा होता है—जो कि डेटा-ड्रिवेन कंपनियों में सामान्य है—तब वे ज़रूरी हो जाती हैं। यदि आप जानना चाहते हैं कि व्यावहारिक रूप से डेटा पाइपलाइंस कैसे काम करती हैं, तो हमारा कोर्स Building Data Engineering Pipelines in Python देखें।
अब भी सोच रहे हैं कि डेटा इंजीनियर क्या करता है? हमारा पूरा लेख पढ़ें और अधिक जानें।
डेटा इंजीनियर बनाम डेटा साइंटिस्ट बनाम डेटा एनालिस्ट
डेटा इंजीनियरिंग की अन्य डेटा भूमिकाओं से ओवरलैप होती है, जिससे करियर की योजना बनाते समय भ्रम हो सकता है। यहाँ तीन मुख्य डेटा भूमिकाओं की तुलना दी गई है:
| पहलू | डेटा इंजीनियर | डेटा साइंटिस्ट | डेटा एनालिस्ट |
|---|---|---|---|
| प्राथमिक फोकस | डेटा इन्फ्रास्ट्रक्चर और पाइपलाइंस बनाना | एमएल मॉडलों से अंतर्दृष्टि निकालना | बिज़नेस इंटेलिजेंस और रिपोर्टिंग |
| मुख्य टूल | SQL, Python, Spark, Kafka, Airflow | Python, R, TensorFlow, scikit-learn | SQL, Excel, Tableau, Power BI |
| मुख्य आउटपुट | स्वचालित ETL पाइपलाइंस, डेटा वेयरहाउस | प्रीडिक्टिव मॉडल, प्रयोग | डैशबोर्ड, रिपोर्ट्स, मेट्रिक्स |
| मुख्य कौशल | वितरित प्रणालियाँ और क्लाउड आर्किटेक्चर | सांख्यिकीय मॉडलिंग और ML | डेटा विज़ुअलाइज़ेशन और स्टोरीटेलिंग |
संक्षेप में, डेटा इंजीनियर्स वे सिस्टम बनाते हैं जो डेटा को सुलभ बनाते हैं, डेटा साइंटिस्ट उस डेटा का विश्लेषण कर पैटर्न ढूँढते हैं, और डेटा एनालिस्ट निष्कर्षों को व्यावसायिक अंतर्दृष्टियों में बदलते हैं। और जानें हमारे लेख में: what is data engineering।
डेटा इंजीनियर कैसे बनें
नीचे हमने वे चरण बताए हैं जिनका पालन करके आप डेटा इंजीनियर के रूप में करियर बना सकते हैं। सटीक चरण आपके मौजूदा कौशल और अनुभव पर कुछ हद तक निर्भर करेंगे, लेकिन यह प्रक्रिया आपको शून्य से डेटा इंजीनियर बनने तक मार्गदर्शन कर सकती है।
चरण 1: डेटा इंजीनियर की शिक्षा और योग्यताओं पर विचार करें
डेटा इंजीनियरिंग अब भी उभरती हुई नौकरी है। परिणामस्वरूप, कुछ ही विश्वविद्यालय और कॉलेज डेटा इंजीनियरिंग में डिग्री प्रदान करते हैं। डेटा इंजीनियर्स प्रायः डेटा साइंस, सॉफ़्टवेयर इंजीनियरिंग, गणित, या व्यवसाय-संबंधी क्षेत्र की पृष्ठभूमि से आते हैं।
अपने काम या उद्योग के आधार पर, अधिकांश डेटा इंजीनियर्स बैचलर डिग्री हासिल करने के बाद पहली एंट्री-लेवल नौकरी पाते हैं। हालाँकि, डेटा इंजीनियर्स के कार्यों के लिए आवश्यक अत्यधिक विशिष्ट कौशल सेट को देखते हुए, कई मामलों में, औपचारिक शिक्षा से अधिक ज्ञान और क्षमता को महत्व मिलता है।
इसलिए, यदि आप औपचारिक शिक्षा लेना चाहते हैं, तो सुनिश्चित करें कि चुनी गई डिग्री के पाठ्यक्रम में सिस्टम आर्किटेक्चर, प्रोग्रामिंग और डेटाबेस कॉन्फ़िगरेशन शामिल हों।
आप DataCamp के Data Engineer in Python करियर ट्रैक जैसे विकल्प भी चुन सकते हैं, जो आपको प्रभावी डेटा आर्किटेक्चर बनाने, डेटा प्रोसेसिंग को सुव्यवस्थित करने और बड़े पैमाने के डेटा सिस्टम्स को बनाए रखने के लिए आवश्यक सभी बुनियादी बातें सिखाएगा।
चरण 2: अपने डेटा इंजीनियर कौशल बनाएँ
डेटा इंजीनियर्स को अपने कार्यों के लिए महत्वपूर्ण तकनीकी कौशल के सेट की आवश्यकता होती है। हालाँकि, किसी भी डेटा इंजीनियरिंग भूमिका में सफलता के लिए आवश्यक कौशल और ज्ञान की विस्तृत और व्यापक सूची बनाना मुश्किल है; अंततः, डेटा साइंस इकोसिस्टम तेज़ी से विकसित हो रहा है और नई तकनीकें व सिस्टम लगातार सामने आ रहे हैं। इसका अर्थ है कि डेटा इंजीनियर्स को तकनीकी प्रगति के साथ तालमेल बिठाने के लिए निरंतर सीखना होगा।
फिर भी, यहाँ उन कौशलों की अपूर्ण सूची है जिन्हें डेटा इंजीनियर बनने के लिए आपको विकसित करना होगा:
1. डेटाबेस प्रबंधन के बारे में सीखें
डेटा इंजीनियर्स अपने दैनिक काम का एक बड़ा भाग डेटाबेस ऑपरेट करने में बिताते हैं—चाहे डेटा इकट्ठा करना हो, संग्रहीत करना हो, स्थानांतरित करना हो, साफ़ करना हो, या केवल देखना हो। इसलिए, डेटा इंजीनियर्स को डेटाबेस प्रबंधन का अच्छा ज्ञान होना चाहिए। इसका अर्थ है SQL (Structured Query Language) में दक्ष होना—जो डेटाबेस से इंटरैक्ट करने की मूल भाषा है—और MySQL, SQL Server और PostgreSQL जैसे लोकप्रिय SQL डायलैक्ट्स में विशेषज्ञता होना।
रिलेशनल डेटाबेस के अलावा, डेटा इंजीनियर्स को NoSQL (“Not only SQL”) डेटाबेस से भी परिचित होना चाहिए, जो बिग डेटा और रियल-टाइम एप्लिकेशंस के लिए तेज़ी से पसंदीदा सिस्टम बन रहे हैं।
इसलिए, भले ही NoSQL इंजन्स की संख्या बढ़ रही है, डेटा इंजीनियर्स को कम से कम NoSQL डेटाबेस प्रकारों का अंतर और उनके उपयोग मामलों को समझना चाहिए। यदि आप NoSQL को लेकर उलझन में हैं और यह SQL से कैसे भिन्न है, तो हमारा कोर्स NoSQL Concepts स्पष्टता पाने के लिए बेहतरीन है।
2. प्रोग्रामिंग सीखें
अन्य डेटा साइंस भूमिकाओं की तरह, डेटा इंजीनियर्स के लिए कोडिंग एक अनिवार्य कौशल है। SQL के अलावा, डेटा इंजीनियर्स कई प्रकार के कार्यों के लिए अन्य प्रोग्रामिंग भाषाएँ उपयोग करते हैं। डेटा इंजीनियरिंग के लिए कई प्रोग्रामिंग भाषाएँ हैं, लेकिन Python निश्चय ही सर्वोत्तम विकल्पों में से एक है।
Python डेटा साइंस की लिंगुआ फ़्रांका है, और ETL जॉब्स चलाने तथा डेटा पाइपलाइंस लिखने के लिए बेहतरीन है। आप एक अलग पोस्ट में पढ़ सकते हैं कि Python का उपयोग किसके लिए होता है।
Python का एक और कारण यह है कि यह डेटा इंजीनियरिंग में महत्वपूर्ण टूल्स और फ़्रेमवर्क्स—जैसे Apache Airflow और Apache Spark—के साथ शानदार इंटीग्रेशन देता है। इनमें से कई ओपन-सोर्स फ़्रेमवर्क Java Virtual Machine पर चलते हैं। यदि आपकी कंपनी ये फ़्रेमवर्क उपयोग करती है, तो आपको Java या Scala भी सीखनी पड़ सकती है।
3. वितरित कंप्यूटिंग फ़्रेमवर्क्स के बारे में सीखें
हाल के वर्षों में, वितरित प्रणालियाँ डेटा साइंस में सर्वत्र हो गई हैं। वितरित प्रणाली वह कंप्यूटिंग परिवेश है जहाँ विभिन्न कंपोनेंट्स नेटवर्क पर कई कंप्यूटरों (क्लस्टर) में फैले होते हैं।
वितरित प्रणालियाँ कार्य को क्लस्टर में बाँटती हैं और प्रयासों का समन्वय कर काम को अधिक कुशलता से पूरा करती हैं। Apache Hadoop और Apache Spark जैसे वितरित कंप्यूटिंग फ़्रेमवर्क विशाल डेटा प्रोसेसिंग के लिए बनाए गए हैं और कुछ सबसे प्रभावशाली बिग डेटा एप्लिकेशंस की नींव रखते हैं। इन फ़्रेमवर्क्स में से किसी एक में विशेषज्ञता हर महत्वाकांक्षी डेटा इंजीनियर के लिए महत्वपूर्ण है। हमारा Foundations of PySpark कोर्स वितरित डेटा प्रोसेसिंग सीखने की अच्छी शुरुआत है।
4. क्लाउड टेक्नोलॉजी का ज्ञान विकसित करें
क्लाउड कंप्यूटिंग डेटा साइंस के सबसे गर्म विषयों में से एक है। क्लाउड-आधारित समाधानों की मांग परिदृश्य को तेज़ी से बदल रही है। आज, डेटा इंजीनियर होना बड़े पैमाने पर आपकी कंपनी के बिज़नेस सिस्टम्स को क्लाउड-आधारित सिस्टम्स से जोड़ना है।
AWS, Azure और Google Cloud जैसी सेवाओं के उभार के साथ, पूरा डेटा वर्कफ़्लो क्लाउड में ही हो सकता है। इसलिए, एक अच्छे डेटा इंजीनियर को क्लाउड सेवाओं, उनके फ़ायदे-नुकसान, और बिग डेटा प्रोजेक्ट्स में उनके उपयोग का ज्ञान और अनुभव होना चाहिए। आपको कम से कम AWS या Azure जैसे किसी प्लेटफ़ॉर्म से परिचित होना चाहिए, क्योंकि ये सबसे व्यापक हैं।
क्लाउड डेटा वेयरहाउसेज़ के साथ प्रथम हैंड्स-ऑन अनुभव पाने के लिए हमारा Exploring London’s Travel Network Project आज़माएँ। यह सीधे आपके ब्राउज़र में Amazon Redshift, Google BigQuery और Snowflake के साथ काम करने का अच्छा अवसर देता है।
5. ETL फ़्रेमवर्क्स का व्यावहारिक ज्ञान अर्जित करें
डेटा इंजीनियर्स की मुख्य भूमिकाओं में से एक ETL तकनीकों और ऑर्केस्ट्रेशन फ़्रेमवर्क्स के साथ डेटा पाइपलाइंस बनाना है। इस खंड में हम कई तकनीकों की सूची दे सकते हैं, लेकिन डेटा इंजीनियर को कम-से-कम कुछ जानी-पहचानी तकनीकों—जैसे Apache Airflow और Apache NiFi—का ज्ञान या सहजता होनी चाहिए। Airflow एक ऑर्केस्ट्रेशन फ़्रेमवर्क है। यह डेटा पाइपलाइंस की योजना, निर्माण और ट्रैकिंग के लिए एक ओपन-सोर्स टूल है। NiFi बुनियादी, दोहराए जाने वाले बिग डेटा ETL प्रोसेस के लिए उपयुक्त है।
6. स्ट्रीम प्रोसेसिंग फ़्रेमवर्क्स के बारे में सीखें
सबसे नवाचारी डेटा साइंस एप्लिकेशंस में से कुछ रियल-टाइम डेटा का उपयोग करते हैं। नतीजतन, स्ट्रीम प्रोसेसिंग फ़्रेमवर्क्स से परिचित उम्मीदवारों की मांग बढ़ रही है। इसलिए Flink, Kafka Streams या Spark Streaming जैसे स्ट्रीमिंग प्रोसेसिंग टूल्स का उपयोग सीखना उन डेटा इंजीनियर्स के लिए एक ठोस कदम है जो अपने करियर को अगले स्तर पर ले जाना चाहते हैं।
7. स्क्रिप्टिंग सीखें
क्लाउड और अन्य बिग डेटा टूल्स व फ़्रेमवर्क्स के अधिकांश जॉब्स और रूटीन शेल कमांड्स और स्क्रिप्ट्स से चलते हैं। डेटा इंजीनियर्स को टर्मिनल के साथ सहज होना चाहिए—फ़ाइलें संपादित करना, कमांड चलाना और सिस्टम में नेविगेट करना। अधिक जानें हमारे bash स्क्रिप्ट ट्यूटोरियल से।
8. संचार कौशल विकसित करें
अंत में, डेटा इंजीनियर्स को विभागों के बीच काम करने और डेटा विश्लेषकों, डेटा वैज्ञानिकों और बिज़नेस लीडर्स की ज़रूरतों को समझने के लिए संचार कौशल भी चाहिए। संगठन पर निर्भर करते हुए, डेटा इंजीनियर्स को स्टेकहोल्डर्स से संवाद के लिए डैशबोर्ड, रिपोर्ट और अन्य विज़ुअलाइज़ेशंस विकसित करना भी आना पड़ सकता है।
9. डेटा मॉडलिंग और ट्रांसफ़ॉर्मेशन टूल्स सीखें
आधुनिक डेटा इंजीनियर्स डेटा पाइपलाइंस को प्रबंधित करने के लिए विशेष ट्रांसफ़ॉर्मेशन फ़्रेमवर्क्स का अधिक उपयोग कर रहे हैं। dbt (Data Build Tool) SQL-आधारित डेटा ट्रांसफ़ॉर्मेशंस के लिए उद्योग मानक बन गया है, जो आपके डेटा मॉडलों के लिए वर्ज़न कंट्रोल, टेस्टिंग और डाक्यूमेंटेशन देता है। डायमेंशनल मॉडलिंग तकनीकों (स्टार स्कीमा, स्नोफ़्लेक स्कीमा) और मेडेलियन आर्किटेक्चर (ब्रॉन्ज, सिल्वर, गोल्ड लेयर्स) को समझना ऐसे डेटा वेयरहाउस डिज़ाइन करने में मदद करता है जिन्हें विश्लेषक कुशलतापूर्वक क्वेरी कर सकें।
10. डेटा क्वालिटी और ऑब्ज़र्वेबिलिटी समझें
जैसे-जैसे डेटा पाइपलाइंस अधिक जटिल होती जा रही हैं, डेटा गुणवत्ता सुनिश्चित करना एक मुख्य ज़िम्मेदारी बन गया है। Great Expectations और Monte Carlo जैसे टूल डेटा को वैलिडेट करने, विसंगतियाँ पहचानने और डेटा लीनिएज ट्रैक करने में मदद करते हैं। डेटा गवर्नेंस प्रथाएँ—जिनमें डेटा कॉन्ट्रैक्ट्स और स्कीमा वैलिडेशन शामिल हैं—लागू करना सीखना सुनिश्चित करता है कि आपकी पाइपलाइंस ऐसा डेटा उत्पन्न करें जिस पर टीमें निर्णय लेने और AI एप्लिकेशंस के लिए भरोसा कर सकें।
चरण 3: अपना डेटा इंजीनियर पोर्टफोलियो पर काम करें
डेटा इंजीनियर बनने का अगला चरण ऐसे डेटा इंजीनियरिंग प्रोजेक्ट्स पर काम करना है जो आपके कौशल और मुख्य विषयों की समझ को प्रदर्शित करें। आप प्रेरणा के लिए हमारा पूरा मार्गदर्शक देख सकते हैं: डेटा साइंस पोर्टफोलियो बनाना।
संभावित नियोक्ताओं को प्रभावित करने के लिए आपको वे कौशल दिखाने होंगे जिन्हें हमने पहले रेखांकित किया है, जिसका मतलब है विविध प्रोजेक्ट्स पर काम करना। DataLab एक सहयोगी क्लाउड-आधारित नोटबुक देता है जो आपको अपने स्वयं के प्रोजेक्ट्स पर काम करने देता है—अर्थात आप डेटा का विश्लेषण कर सकते हैं, दूसरों के साथ सहयोग कर सकते हैं, और अंतर्दृष्टियाँ साझा कर सकते हैं।
आप विभिन्न डेटा साइंस प्रोजेक्ट्स में अपना ज्ञान भी लागू कर सकते हैं, जिससे आप अपने ब्राउज़र से वास्तविक दुनिया की समस्याएँ हल कर सकते हैं और साथ ही अपने डेटा इंजीनियरिंग पोर्टफोलियो में योगदान कर सकते हैं।
जब आप अपनी पसंद के किसी विशेष व्यवसाय क्षेत्र का अन्वेषण करने के लिए तैयार महसूस करें, तो आप उस क्षेत्र में डोमेन ज्ञान हासिल करने और संबंधित व्यक्तिगत प्रोजेक्ट्स पर काम करने पर ध्यान केंद्रित करना शुरू कर सकते हैं।
चरण 4: अपनी पहली डेटा इंजीनियर नौकरी के लिए आवेदन करें
डेटा इंजीनियरिंग, डेटा साइंस उद्योग की सबसे अधिक मांग वाली भूमिकाओं में से एक है। सिलिकॉन वैली की बड़ी टेक कंपनियों से लेकर विभिन्न सेक्टर्स की छोटी डेटा-ड्रिवेन स्टार्टअप्स तक, व्यवसाय अपने डेटा संसाधनों को स्केल करने और उनका अधिकतम लाभ उठाने में मदद के लिए डेटा इंजीनियर्स को हायर करना चाहते हैं। साथ ही, संगठनों की ज़रूरतों को पूरा करने के लिए आवश्यक व्यापक और अत्यधिक विशिष्ट कौशल सेट के कारण कंपनियों को सही उम्मीदवार ढूँढने में कठिनाई होती है।
इस विशेष संदर्भ में, अपनी पहली डेटा इंजीनियरिंग नौकरी पाने का कोई परफेक्ट फ़ॉर्मूला नहीं है। कई मामलों में, डेटा इंजीनियर्स अपनी ही कंपनी में अन्य डेटा साइंस भूमिकाओं—जैसे डेटा साइंटिस्ट या डेटाबेस एडमिनिस्ट्रेटर—से ट्रांज़िशन करते हुए इस पद पर आते हैं।
यदि आप जॉब पोर्टल्स पर डेटा इंजीनियरिंग अवसर ढूँढ रहे हैं, तो यह ध्यान रखना ज़रूरी है कि “डेटा इंजीनियर” शीर्षक के साथ कई ओपनिंग्स होती हैं—जैसे क्लाउड डेटा इंजीनियर, बिग डेटा इंजीनियर और डेटा आर्किटेक्ट। विशिष्ट कौशल और आवश्यकताएँ पद के अनुसार बदलेंगी, इसलिए कुंजी यह है कि आप जो जानते हैं और कंपनी को जो चाहिए उसके बीच निकटतम मेल ढूँढें।
अन्य उम्मीदवारों से अलग दिखने के लिए हमारा पूरा मार्गदर्शक देखें: डेटा साइंस नौकरियों के लिए आवेदन करना। संभवतः आपको विविध कौशल दिखाने वाला ठोस पोर्टफोलियो चाहिए होगा। आप यह भी देख सकते हैं कि हायरिंग मैनेजर्स क्या चाहते हैं हमारे डेटा इंजीनियर जॉब डिस्क्रिप्शन कैसे लिखें पर लेख में।
डेटा इंजीनियरिंग नौकरी पाने की अपनी संभावना कैसे बढ़ाएँ?
उत्तर सरल है: सीखते रहें। अपनी विशेषज्ञता गहरी करने और डेटा इंजीनियरिंग टूलकिट का विस्तार करने के कई मार्ग हैं।
आप आगे औपचारिक शिक्षा का भी विकल्प चुन सकते हैं—चाहे वह डेटा साइंस या कंप्यूटर साइंस में बैचलर डिग्री हो, निकट से संबंधित क्षेत्र हो, या डेटा इंजीनियरिंग में मास्टर डिग्री।
शिक्षा के अलावा, अभ्यास सफलता की कुंजी है। इस क्षेत्र के नियोक्ता अद्वितीय कौशल और सॉफ़्टवेयर व प्रोग्रामिंग भाषाओं पर मज़बूत पकड़ वाले उम्मीदवारों की तलाश में हैं। जितना अधिक आप व्यक्तिगत प्रोजेक्ट्स में कोडिंग का अभ्यास करेंगे और बिग डेटा टूल्स व फ़्रेमवर्क्स आज़माएँगे, आवेदन प्रक्रिया में अलग दिखने की आपकी संभावनाएँ उतनी ही बढ़ेंगी। अपनी विशेषज्ञता साबित करने के लिए, डेटा इंजीनियरिंग में प्रमाणित होना एक अच्छा विकल्प है।
डेटा इंजीनियरिंग प्रमाणपत्र
उद्योग प्रमाणपत्र आपके कौशल को सत्यापित कर सकते हैं और आपकी मार्केट वैल्यू बढ़ा सकते हैं। आगे बढ़ते हुए इन प्रमाणपत्रों पर विचार करें:
- DataCamp Data Engineer Associate Certification बुनियादी डेटा इंजीनियरिंग क्षमता दर्शाने के लिए।
- AWS Certified Data Engineer – Associate—सबसे व्यापक रूप से उपयोग किए जाने वाले क्लाउड प्लेटफ़ॉर्म पर आपके क्लाउड डेटा इंजीनियरिंग कौशल सिद्ध करने के लिए।
- Databricks Certified Data Engineer Associate—उन टीमों के लिए जो Databricks लेकहाउस प्लेटफ़ॉर्म का उपयोग करती हैं।
- Google Cloud Professional Data Engineer या Microsoft Azure Data Engineer Associate—GCP या Azure इकोसिस्टम में विशेषज्ञता के लिए।
एक प्लेटफ़ॉर्म-अज्ञेय प्रमाणपत्र से शुरू करें, फिर उन क्लाउड-विशिष्ट प्रमाणपत्रों को जोड़ें जो आपके लक्षित नियोक्ताओं द्वारा उपयोग किए जाने वाले प्लेटफ़ॉर्म के अनुरूप हों।
अंततः, यदि आपको अपनी पहली डेटा इंजीनियर नौकरी खोजने में कठिनाई हो रही है, तो अन्य एंट्री-लेवल डेटा साइंस पदों के लिए आवेदन करने पर विचार करें। अंत में, डेटा साइंस एक सहयोगी क्षेत्र है, जहाँ कई विषय और कौशल विभिन्न डेटा भूमिकाओं में कॉमन होते हैं। ये पद आपको मूल्यवान अंतर्दृष्टि और अनुभव देंगे, जो आपकी मनचाही डेटा इंजीनियरिंग भूमिका हासिल करने में मदद करेंगे।
करियर विशेषज्ञताएँ और विकास पथ
जैसे-जैसे आपका करियर आगे बढ़ता है, आप कई दिशाओं में विशेषज्ञता हासिल कर सकते हैं:
- क्लाउड डेटा इंजीनियर: AWS, GCP या Azure में विशेषज्ञ, सर्वरलेस और स्केलेबल डेटा पाइपलाइंस बनाता है।
- बिग डेटा इंजीनियर: Spark, Flink और Kafka का उपयोग करके टेराबाइट्स या पेटाबाइट्स प्रोसेस करने वाली वितरित प्रणालियों पर केंद्रित।
- डेटा आर्किटेक्ट: एंटरप्राइज़-स्तरीय डेटा सिस्टम्स, गवर्नेंस मानकों और इंटीग्रेशन पैटर्न्स का डिज़ाइन करता है। आधुनिक डेटा आर्किटेक्चर के बारे में और जानें।
- ML/AI डेटा इंजीनियर: मशीन लर्निंग मॉडलों के लिए डेटा इन्फ्रास्ट्रक्चर तैयार करता है और फीचर स्टोर्स व वेक्टर डेटाबेस बनाए रखता है।
- एनालिटिक्स इंजीनियर: dbt, Snowflake और Looker जैसे टूल्स का उपयोग करके डेटा इंजीनियरिंग और बिज़नेस इंटेलिजेंस के बीच पुल बनाता है।
कई डेटा इंजीनियर्स अनुभव के साथ ML इंजीनियर, क्लाउड आर्किटेक्ट या इंजीनियरिंग मैनेजर जैसी भूमिकाओं में भी जाते हैं।
चरण 5: डेटा इंजीनियरिंग इंटरव्यू की तैयारी करें
डेटा इंजीनियरिंग इंटरव्यू सामान्यतः तकनीकी और गैर-तकनीकी हिस्सों में बँटे होते हैं। हमारा पूरा मार्गदर्शक देखें: शीर्ष डेटा इंजीनियरिंग इंटरव्यू प्रश्न और उत्तर।
संक्षेप में, आप चार विषयों से जुड़े प्रश्नों की अपेक्षा कर सकते हैं:
आपका रेज़्यूमे और अनुभव
रिक्रूटर्स डेटा इंजीनियरिंग पद से संबंधित आपके अनुभवों के बारे में जानना चाहेंगे। सुनिश्चित करें कि आप अपने रेज़्यूमे में डेटा साइंस पदों और प्रोजेक्ट्स में अपने पिछले काम को हाइलाइट करें और उनके बारे में विस्तार से बताने की तैयारी रखें, क्योंकि यही जानकारी रिक्रूटर्स को आपके तकनीकी कौशल, समस्या-समाधान, संचार और प्रोजेक्ट प्रबंधन का आकलन करने में मदद करती है।
प्रोग्रामिंग
यह संभवतः डेटा साइंस इंटरव्यू का सबसे तनावपूर्ण हिस्सा होता है। आम तौर पर, आपसे कहा जाएगा कि आप Python या Spark जैसे डेटा फ़्रेमवर्क का उपयोग करके कम समय में कुछ लाइनों के कोड में समस्या हल करें।
उदाहरण के लिए, आपका अभ्यास एक साधारण डेटा पाइपलाइन बनाकर डेटा लोड और क्लीन करने का हो सकता है। समस्या आमतौर पर प्रबंधनीय होती है, लेकिन उस पल का दबाव आपके प्रदर्शन को प्रभावित कर सकता है। यदि आप इस तरह के परीक्षण से परिचित नहीं हैं, तो पहले से कुछ कोडिंग प्रश्नों के साथ अभ्यास कर सकते हैं।
SQL
SQL में ठोस विशेषज्ञता के बिना आप डेटा इंजीनियरिंग करियर में दूर तक नहीं जा पाएँगे। इसलिए, प्रोग्रामिंग टेस्ट के अलावा, आपसे SQL का उपयोग करके समस्या हल करने को भी कहा जा सकता है। आमतौर पर अभ्यास में डेटाबेस में कुछ डेटा प्रोसेस करने के लिए कुशल क्वेरी लिखना शामिल होगा।
सिस्टम डिज़ाइन
यह तकनीकी इंटरव्यू का सबसे वैचारिक और अक्सर सबसे चुनौतीपूर्ण हिस्सा होता है। डेटा आर्किटेक्चर का डिज़ाइन डेटा इंजीनियर्स के सबसे प्रभावकारी कार्यों में से एक है। इस हिस्से में, आपसे एंड-टू-एंड डेटा समाधान डिज़ाइन करने को कहा जाएगा, जो सामान्यतः तीन पहलुओं को समेटता है: डेटा संग्रहण, डेटा प्रोसेसिंग और डेटा मॉडलिंग।
डेटा साइंस इकोसिस्टम के तीव्र विस्तार को देखते हुए, डिज़ाइन के विकल्प अनंत हैं। आपको अपने चुनावों के पक्ष-विपक्ष और संभावित ट्रेड-ऑफ़्स पर चर्चा के लिए तैयार रहना होगा।
तकनीकी भाग पूरा करने के बाद, डेटा इंजीनियरिंग इंटरव्यू का अंतिम चरण आपके संभावित टीम सदस्यों में से एक या अधिक के साथ व्यक्तिगत बातचीत होगा। उद्देश्य? यह जानना कि आप कौन हैं और टीम में कैसे फिट बैठेंगे।
पर याद रखें, डेटा इंजीनियर इंटरव्यू द्विपक्षीय बातचीत है—अर्थात आपको भी प्रश्न पूछने चाहिए ताकि आप आकलन कर सकें कि आप स्वयं को उस टीम का हिस्सा देख पाते हैं या नहीं।
डेटा इंजीनियर वेतन अपेक्षाएँ
कई IT नौकरियों की तुलना में डेटा इंजीनियर्स का वेतन ऊँचा होता है, जो मांग को दर्शाता है। आँकड़े देश, शहर और सीनियरिटी के अनुसार बदलते हैं, पर हम मोटे तौर पर कुछ रेंज बतला सकते हैं (सभी आंकड़े प्री-टैक्स वार्षिक वेतन हैं):
-
संयुक्त राज्य: राष्ट्रीय औसत $120K–$130K के दायरे में हैं (Indeed लगभग $126,300 रिपोर्ट करता है)। Glassdoor ~ $153K को औसत बताता है, जबकि बड़े टेक हब्स में सीनियर भूमिकाएँ $180K से ऊपर जाती हैं। एंट्री-लेवल यू.एस. डेटा इंजीनियर्स (0–3 वर्ष) आम तौर पर $80–90K, मिड-कैरियर (~3–5 वर्ष) लगभग $110–115K, और सीनियर अक्सर $140K से अधिक कमाते हैं। (उदाहरण के लिए, एक सर्वे में जूनियर ~ $80K, मिड ~ $114K, और सीनियर ~ $142K दिखा।) शीर्ष टेक हब्स में वेतन और भी अधिक है: सिलिकॉन वैली या न्यूयॉर्क की सीनियर भूमिकाएँ आसानी से $180K+ तक पहुँच सकती हैं।
-
यूनाइटेड किंगडम/यूरोप: लंदन में मिड-लेवल डेटा इंजीनियर्स अक्सर लगभग £75–100K कमाते हैं। Morgan McKinley लंदन के लिए £75–100K रेंज बताता है, जूनियर (~0–3 वर्ष) लगभग £50–75K और सीनियर (5+ वर्ष) £125K तक। महाद्वीपीय यूरोप में वेतन आम तौर पर यू.एस. से कम हैं: उदाहरण के लिए, जर्मनी में डेटा इंजीनियर्स औसतन लगभग €50–70K कमाते हैं, और पश्चिमी यूरोप में भी इसी तरह (अक्सर €60–80K रेंज)।
-
एशिया-प्रशांत (APAC): व्यापक विविधता है। सिंगापुर में डेटा इंजीनियर्स लगभग S$120–170K प्रतिवर्ष (लगभग US$90–125K) कमाते हैं, रिक्रूटिंग डेटा के अनुसार सीनियर भूमिकाएँ S$240K से अधिक तक जाती हैं। ऑस्ट्रेलिया में, सिडनी के डेटा इंजीनियर्स औसतन लगभग A$155K (~US$100K) कमाते हैं। इसके विपरीत, भारत में वेतन काफी कम है: एक सामान्य डेटा इंजीनियर एंट्री/मिड स्तर पर लगभग ₹9–10 लाख (लगभग US$12K) प्रतिवर्ष कमा सकता है (हालाँकि अनुभव के साथ, और विशेषकर MNCs या स्टार्टअप हब्स में, यह बढ़ सकता है)।
ये आँकड़े सीनियरिटी और क्षेत्रीय भिन्नताओं को रेखांकित करते हैं। सामान्य दिशा-निर्देश के तौर पर, क्षेत्र में प्रवेश (जूनियर) पर आप मिड-लेवल बाज़ार दर का लगभग 50–70% पा सकते हैं, जबकि सीनियर/लीड भूमिकाएँ अक्सर मिड-कैरियर औसत से 20–40% ऊपर होती हैं।अंततः, पारिश्रमिक प्रत्येक क्षेत्र की जीवन-यापन लागत और स्थानीय बाज़ार पर निर्भर करता है, लेकिन समग्र प्रवृत्ति स्पष्ट है: डेटा इंजीनियरिंग बेहद प्रतिस्पर्धी वेतन देती है, जो इसकी रणनीतिक महत्ता को दर्शाती है।
डेटा इंजीनियरिंग को आकार देती प्रवृत्तियाँ
डेटा इंजीनियर की भूमिका नई तकनीकों के साथ विकसित हो रही है। क्षेत्र को प्रभावित करने वाली प्रमुख प्रवृत्तियों में शामिल हैं:
-
AI और मशीन लर्निंग का एकीकरण: जैसे-जैसे व्यवसाय AI अपना रहे हैं, डेटा इंजीनियर्स उच्च-गुणवत्ता वाला डेटा ML सिस्टम्स को उपलब्ध कराने में अहम भूमिका निभाते हैं। डेटा इंजीनियरिंग को बदलने के बजाय, जेनरेटिव AI और ML टूल्स बेहतर डेटा पाइपलाइंस की मांग बढ़ा रहे हैं। डेटा इंजीनियर्स अब प्रोडक्शन में मॉडलों के प्रशिक्षण और स्ट्रीमिंग प्रेडिक्शंस के लिए इन्फ्रास्ट्रक्चर बनाते और बनाए रखते हैं। वे अक्सर वर्कफ़्लोज़ को स्वचालित करने और मॉडलों को आवश्यक डेटा तक पहुँच सुनिश्चित करने के लिए DataOps/MLOps प्रथाओं को लागू करते हैं। प्रभावतः, डेटा इंजीनियर्स AI के सक्षमकर्ता बन रहे हैं—वे बड़े, स्वच्छ डेटासेट्स का निर्माण करते हैं जिनकी AI को सफलता के लिए आवश्यकता है।
-
रीयल-टाइम और स्ट्रीमिंग डेटा: केवल बैच ETL का युग समाप्त हो रहा है। कंपनियों को बढ़ते हुए रीयल-टाइम इनसाइट्स चाहिए, इसलिए डेटा इंजीनियर्स स्ट्रीमिंग प्लेटफ़ॉर्म्स (Kafka, Flink, Spark Streaming) और यहाँ तक कि एज कंप्यूटिंग की ओर मुड़ रहे हैं। आधुनिक स्ट्रीमिंग सिस्टम्स व्यवसायों को इवेंट्स प्रोसेस करने और विश्लेषिकी को तुरंत अपडेट करने देते हैं, जो एक बड़ा प्रतिस्पर्धी लाभ है। 5G और एज कंप्यूटिंग में प्रगति का मतलब है कि डेटा अपने स्रोत के पास बहुत कम विलंबता पर एकत्र और प्रोसेस किया जा सकता है। इसलिए, डेटा इंजीनियर्स को कम-विलंबता पाइपलाइंस डिज़ाइन करनी होंगी और स्ट्रीम प्रोसेसिंग फ़्रेमवर्क्स में दक्ष होना होगा। व्यवहार में, आप अक्सर ऐसी पाइपलाइंस पर काम करेंगे जो निरंतर डेटा (जैसे क्लिकस्ट्रीम, सेंसर डेटा या लॉग फ़ीड्स) इनजेस्ट और ट्रांसफ़ॉर्म करती हैं ताकि लाइव डैशबोर्ड्स और स्वचालित अलर्ट्स को शक्ति मिल सके।
-
डेटा मेष और डेटा फ़ैब्रिक आर्किटेक्चर: जैसे-जैसे डेटा प्लेटफ़ॉर्म्स स्केल कर रहे हैं, संगठन केंद्रीकृत आर्किटेक्चर पर पुनर्विचार कर रहे हैं। डेटा मेष—जिसमें प्रत्येक बिज़नेस डोमेन को उसकी डोमेन टीम के स्वामित्व वाले “मिनी डेटा प्रोडक्ट” की तरह माना जाता है—लोकप्रिय हो रहा है। डेटा इंजीनियर्स एकल केंद्रीय टीम की बजाय विशिष्ट डेटा डोमेन्स (मार्केटिंग डेटा, सेल्स डेटा, आदि) के स्वामी क्रॉस-फ़ंक्शनल टीमों में काम कर सकते हैं। इस बीच, डेटा फ़ैब्रिक आर्किटेक्चर—जो कई साइलोज़ में डेटा को जोड़ने के लिए एकीकृत मेटाडेटा और इंटीग्रेशन लेयर्स का उपयोग करते हैं—भी उभर रहे हैं।
Gartner बताता है कि दोनों दृष्टिकोण (मेष और फ़ैब्रिक) हॉट टॉपिक्स हैं: मेष विकेंद्रीकरण और “डेटा ऐज़ अ प्रोडक्ट” के लिए, और फ़ैब्रिक वितरित डेटा के इंटीग्रेशन के लिए। व्यवहार में, नए प्लेटफ़ॉर्म्स और टूल्स (जैसे डोमेन-विशिष्ट लेक्स, कैटलॉग सेवाएँ, और स्वचालित डेटा पाइपलाइंस) इन पैटर्न्स को लागू करने में मदद करते हैं। डेटा इंजीनियर के लिए निष्कर्ष यह है कि डोमेन-ओरिएंटेड टीमों में काम करने के लिए तैयार रहें और आधुनिक मेटाडेटा/कैटलॉग सिस्टम्स को समझें। (महत्वपूर्ण रूप से, विश्लेषक चेतावनी देते हैं कि डेटा मेष अभी विकसित होती प्रैक्टिस है और अक्सर डेटा फ़ैब्रिक समाधानों के साथ मिलकर उपयोग होती है।) -
क्लाउड-नेटिव आधुनिकीकरण: लगभग सारा डेटा इंजीनियरिंग अब क्लाउड पर चलता है। कंपनियाँ ऑन-प्रेम डेटा वेयरहाउस से क्लाउड डेटा वेयरहाउस और लेकहाउस (Snowflake, Redshift, Azure Synapse, Databricks, आदि) पर माइग्रेट कर रही हैं। क्लाउड-नेटिव आर्किटेक्चर—सर्वरलेस पाइपलाइंस, मैनेज्ड स्ट्रीमिंग (जैसे Kinesis, Pub/Sub) और स्केलेबल स्टोरेज—मुख्य प्रवृत्तियाँ हैं। इसलिए, डेटा इंजीनियर्स को क्लाउड सेवाओं और ऑटोमेशन (Infrastructure-as-Code, डेटा पाइपलाइंस के लिए CI/CD) में कुशल होना चाहिए। क्लाउड-नेटिव टूल्स अपनाने का मतलब है कि आप डिमांड पर कंप्यूट स्केल अप/डाउन कर सकते हैं, लागत अनुकूलित कर सकते हैं और सर्वर ऑप्स के बजाय डेटा लॉजिक पर ध्यान केंद्रित कर सकते हैं। संक्षेप में, डेटा प्लेटफ़ॉर्म्स क्लाउड युग के लिए आधुनिकीकरण हो रहे हैं, और डेटा इंजीनियर्स उस आधुनिकीकरण को आगे बढ़ाते हैं।
-
डेटा गवर्नेंस और गुणवत्ता टूल्स: बढ़ती डेटा मात्राओं और विनियमों के साथ, डेटा गवर्नेंस, लीनिएज और गुणवत्ता (डेटा कैटलॉग्स, कॉन्ट्रैक्ट-ड्रिवन पाइपलाइंस, ऑब्ज़र्वेबिलिटी) के टूल्स परिपक्व हो रहे हैं। डेटा कॉन्ट्रैक्ट्स और स्कीमा रजिस्ट्रियों (डेटा उत्पादकों और उपभोक्ताओं के बीच समझौतों का स्वचालन) का प्रचलन बढ़ रहा है, ताकि टीमें एक-दूसरे की पाइपलाइंस न तोड़ें। एक डेटा इंजीनियर के रूप में, आप नए गवर्नेंस फ़्रेमवर्क्स और टूल्स (जैसे Great Expectations, Monte Carlo, या ओपन-सोर्स डेटा कैटलॉग्स) के साथ काम कर सकते हैं ताकि आपका संगठन अपने डेटा पर भरोसा कर सके। (उदाहरण के लिए, एक प्रवृत्ति “डेटा कॉन्ट्रैक्ट्स” का उपयोग कर टीमों में सुसंगत स्कीमाज़ सुनिश्चित करना है।)
-
DevOps और ऑटोमेशन: अंततः, सॉफ़्टवेयर इंजीनियरिंग और डेटा इंजीनियरिंग के बीच की रेखा धुंधली होती जा रही है। कई संगठन डेटा के लिए DevOps प्रथाएँ (अक्सर DataOps या MLOps कहलाती हैं) अपनाते हैं। इसका मतलब है डेटा कोड के लिए वर्ज़न कंट्रोल, डेटा पाइपलाइंस की स्वचालित टेस्टिंग, और डेटा इन्फ्रास्ट्रक्चर की कंटीन्युअस डिलीवरी। ऑटोमेशन फ़्रेमवर्क्स (जैसे पाइपलाइंस के लिए Apache Airflow, इंफ्रास्ट्रक्चर के लिए Terraform या CloudFormation) अब मानक हैं। इन DevOps टूल्स और प्रथाओं में दक्ष रहना आपको डेटा समाधान तेज़ और अधिक विश्वसनीयता से डिप्लॉय करने में मदद करेगा।
निष्कर्ष
डेटा इंजीनियरिंग, डेटा साइंस परिदृश्य की सबसे अधिक मांग वाली नौकरियों में से एक है और निस्संदेह उभरते डेटा प्रोफेशनल्स के लिए एक बेहतरीन करियर विकल्प है। यदि आप डेटा इंजीनियर बनने के लिए दृढ़ संकल्पित हैं लेकिन शुरुआत कैसे करें यह नहीं जानते, तो मैं हमारे करियर ट्रैक Data Engineer in Python का पालन करने की दृढ़ता से सिफारिश करता/करती हूँ, जो आपको आत्मविश्वासी डेटा इंजीनियर बनने के लिए आवश्यक व्यावहारिक ज्ञान देता है। आप हमारे Introduction to Data Engineering कोर्स से भी शुरुआत कर सकते हैं या शुरुआत से डेटा इंजीनियरिंग सीखने की पूरी गाइड देखें।
FAQs
डेटा इंजीनियर बनने में कितना समय लगता है?
चार से पाँच वर्ष। अधिकांश डेटा इंजीनियर्स बैचलर डिग्री हासिल करने के बाद पहली एंट्री-लेवल नौकरी पाते हैं, लेकिन किसी अन्य डेटा-संबंधी भूमिका से ट्रांज़िशन करके भी डेटा इंजीनियर बनना संभव है।
क्या बिना डिग्री के मैं डेटा इंजीनियर बन सकता/सकती हूँ?
बिल्कुल! यदि आप साबित करते हैं कि आपके पास कौशल और ज्ञान है, तो डिग्री न होना बाधा नहीं होना चाहिए। पूरी तरह शुरुआती से प्रशिक्षित डेटा इंजीनियर बनने के कई मार्ग हैं। एक बढ़िया विकल्प है DataCamp का करियर ट्रैक Data Engineer with Python।
डेटा इंजीनियर के वेतन कितने होते हैं?
अमेरिका में, एंट्री-लेवल डेटा इंजीनियर्स आमतौर पर $90K–$120K कमाते हैं, मिड-कैरियर प्रोफेशनल्स $120K–$150K, और सीनियर डेटा इंजीनियर्स अक्सर $160K–$180K+ से अधिक कमाते हैं। वेतन स्थान के अनुसार बदलता है, जहाँ San Francisco और New York जैसे टेक हब्स में सबसे अधिक पारिश्रमिक मिलता है।
डेटा इंजीनियर बनने के लिए किस डिग्री की आवश्यकता है?
डेटा इंजीनियर्स आमतौर पर डेटा साइंस, कंप्यूटर साइंस, गणित या किसी व्यवसाय-संबंधी क्षेत्र में अंडरग्रेजुएट डिग्री रखते हैं। वर्तमान में, कुछ ही विश्वविद्यालय डेटा इंजीनियरिंग में डिग्री प्रदान करते हैं।
डेटा इंजीनियर क्या करता है?
डेटा इंजीनियर्स डेटाबेस और प्रोसेसिंग सिस्टम्स की आर्किटेक्चर के डिज़ाइन, निर्माण और रखरखाव का प्रबंधन करते हैं। वे सुनिश्चित करते हैं कि एकत्रित बड़े पैमाने का डेटा अन्य डेटा विशेषज्ञों के लिए सुलभ कच्चा माल बन जाए।
डेटा इंजीनियर और डेटा साइंटिस्ट में क्या अंतर है?
डेटा इंजीनियर्स डेटा आर्किटेक्चर को डिज़ाइन, बनाना और बनाए रखना के लिए ज़िम्मेदार होते हैं, जबकि डेटा साइंटिस्ट डेटा का उपयोग कर गहन विश्लेषण करते हैं ताकि व्यावसायिक समस्याएँ हल हो सकें।
डेटा इंजीनियरिंग ऑनलाइन सीखने का सबसे अच्छा तरीका क्या है?
DataCamp डेटा इंजीनियरिंग सीखने के लिए सर्वश्रेष्ठ ऑनलाइन प्लेटफ़ॉर्म्स में से एक है। हमारे हैंड्स-ऑन कोर्सेज़, जो सर्वोत्तम प्रशिक्षकों द्वारा विकसित हैं, के माध्यम से आप डेटा इंजीनियरिंग शुरू करने के लिए आवश्यक सब कुछ सीखेंगे। यहाँ हमारे सभी डेटा इंजीनियरिंग कोर्स ब्राउज़ करें।
डेटा इंजीनियर के लिए कौन सी प्रोग्रामिंग भाषाएँ सबसे महत्वपूर्ण हैं?
डेटा इंजीनियर्स आमतौर पर SQL, Python या R, और Java या Scala का उपयोग करते हैं।
2026 में डेटा इंजीनियर्स कौन से टूल्स उपयोग करते हैं?
2026 में डेटा इंजीनियर्स आम तौर पर SQL और Python को कोर भाषाओं के रूप में, वितरित प्रोसेसिंग के लिए Apache Spark, रीयल-टाइम स्ट्रीमिंग के लिए Apache Kafka, ऑर्केस्ट्रेशन के लिए Apache Airflow, और डेटा ट्रांसफ़ॉर्मेशन के लिए dbt का उपयोग करते हैं। AWS, Azure और GCP जैसे क्लाउड प्लेटफ़ॉर्म अनिवार्य हैं, साथ ही Snowflake, BigQuery और Redshift जैसे डेटा वेयरहाउस भी। Great Expectations जैसे डेटा क्वालिटी टूल्स भी तेजी से मानक बन रहे हैं।
क्या 2026 में डेटा इंजीनियरिंग एक अच्छा करियर है?
हाँ। 2026 में डेटा इंजीनियरिंग सबसे अधिक मांग और अच्छा पारिश्रमिक देने वाले टेक करियर में से एक है। World Economic Forum बिग डेटा स्पेशलिस्ट्स को 2030 तक सबसे तेज़ी से बढ़ती नौकरियों में रखता है। अमेरिका में वेतन एंट्री लेवल पर $90K से लेकर सीनियर भूमिकाओं के लिए $180K+ तक है। AI, रीयल-टाइम एनालिटिक्स, और क्लाउड-नेटिव सिस्टम्स के उभार से उद्योगों में डेटा इंजीनियर्स की मांग बनी रहेगी।
क्या मैं कंप्यूटर साइंस डिग्री के बिना डेटा इंजीनियर बन सकता/सकती हूँ?
हाँ। जबकि कंप्यूटर साइंस, डेटा साइंस या संबंधित क्षेत्र में डिग्री आम है, कई डेटा इंजीनियर्स सॉफ़्टवेयर इंजीनियरिंग, डेटा एनालिसिस या IT ऑपरेशंस जैसी अन्य भूमिकाओं से ट्रांज़िशन करते हैं। DataCamp Data Engineer in Python जैसे संरचित लर्निंग प्रोग्राम, क्लाउड प्रमाणन (AWS, GCP, Azure), और हैंड्स-ऑन प्रोजेक्ट्स का मज़बूत पोर्टफोलियो आपको पारंपरिक डिग्री के बिना भी इस क्षेत्र में प्रवेश करने में मदद कर सकता है।

मैं एक स्वतंत्र डेटा विश्लेषक हूँ और दुनिया भर की कंपनियों व संगठनों के साथ डेटा साइंस परियोजनाओं पर सहयोग करता/करती हूँ। मैं 2+ वर्षों के अनुभव वाला/वाली डेटा साइंस प्रशिक्षक भी हूँ। मैं नियमित रूप से अंग्रेज़ी और स्पेनिश में डेटा साइंस से संबंधित लेख लिखता/लिखती हूँ, जिनमें से कुछ DataCamp, Towards Data Science और Analytics Vidhya जैसी स्थापित वेबसाइटों पर प्रकाशित हुए हैं। राजनीतिक विज्ञान और क़ानून की पृष्ठभूमि वाले/वाली डेटा वैज्ञानिक के रूप में, मेरा लक्ष्य लोक नीति, क़ानून और प्रौद्योगिकी के संगम पर काम करना है—विचारों की शक्ति का उपयोग करके ऐसे अभिनव समाधान और कथाएँ विकसित करना जो हमें तात्कालिक चुनौतियों, विशेषकर जलवायु संकट, से निपटने में मदद कर सकें। मैं स्वयं-अध्येता, सतत सीखने वाला/वाली और बहुविषयक दृष्टिकोण का प्रबल समर्थक/समर्थक हूँ। नई चीज़ें सीखने में कभी देर नहीं होती।
जैसे-जैसे संगठन डेटा-आधारित अंतर्दृष्टियों पर अधिक निर्भर हो रहे हैं, दुनिया भर में डेटा इंजीनियरिंग का क्षेत्र तेज़ी से बढ़ रहा है। हालिया World Economic Forum जैसी प्रमुख रिपोर्टें “बिग डेटा स्पेशलिस्ट्स” (जिसमें डेटा इंजीनियर्स शामिल हैं) को सबसे तेज़ी से बढ़ने वाली टेक नौकरियों में शुमार करती हैं। शुरुआती AI-डर से जुड़ी भविष्यवाणियों के विपरीत, डेटा इंजीनियरिंग की भूमिकाएँ बढ़ रही हैं।
AI सिस्टम्स को शक्ति देने वाले इंफ्रास्ट्रक्चर के निर्माण में डेटा इंजीनियर्स की भूमिका लगातार निर्णायक होती जा रही है। व्यावहारिक रूप से, इसका अर्थ है कि डेटा इंजीनियर्स के लिए हज़ारों नौकरियाँ उपलब्ध हैं और विभिन्न उद्योगों के नियोक्ता प्रतिभा के लिए प्रतिस्पर्धा कर रहे हैं।
अन्य सन्निकट डेटा इंजीनियरिंग भूमिकाएँ, जैसे AI और मशीन लर्निंग स्पेशलिस्ट्स तथा डेटा वेयरहाउसिंग स्पेशलिस्ट्स, सूची में शीर्ष पर हैं। एक अलग लेख में अन्य शीर्ष एनालिटिक्स करियर पर चर्चा की गई है।
संक्षेप में