
उन्नत ट्रांसफर लर्निंग तकनीकों के प्रकार
पारंपरिक तरीके—जैसे बड़े डेटासेट पर प्री-ट्रेन करना और फिर कार्य-विशिष्ट डेटासेट पर फाइन-ट्यून करना—आधारभूत हैं लेकिन कभी-कभी अपर्याप्त साबित होते हैं। अधिक उन्नत विधियाँ डोमेन शिफ्ट, डेटा की कमी और मल्टी-टास्क लर्निंग की बारीकियों से निपटने के लिए सामने आई हैं।
उन्नत तरीकों में अतिरिक्त जटिलता और लचीलापन शामिल होता है। इन तकनीकों का उद्देश्य उन परिस्थितियों में मॉडल के प्रदर्शन में सुधार करना है जहाँ पारंपरिक तरीके पर्याप्त नहीं होते।
डोमेन एडेप्टेशन
डोमेन एडेप्टेशन तकनीकें स्रोत (प्री-ट्रेनिंग) और लक्ष्य (फाइन-ट्यूनिंग) डोमेन के बीच असमानताओं से निपटने के लिए बनाई गई हैं। जब प्री-ट्रेंड मॉडल अपने प्रशिक्षण डेटा से काफी अलग डेटा से टकराते हैं, तो पारंपरिक फाइन-ट्यूनिंग अक्सर कमतर परिणाम देती है। डोमेन एडेप्टेशन तकनीकें डेटा वितरणों को संरेखित कर इस असंगति को घटाती हैं, ताकि मॉडल नए परिवेशों में बेहतर सामान्यीकरण कर सके।
मल्टी-टास्क लर्निंग (MTL)
MTL किसी मॉडल को एक साथ कई संबंधित कार्यों पर सीखने की अनुमति देता है। कार्यों के बीच ज्ञान साझा करके, मॉडल समानताओं का लाभ उठाता है और सभी कार्यों में प्रदर्शन बेहतर होता है। यह रणनीति विशेष रूप से तब प्रभावी होती है जब कार्य पूरक हों, जैसे एनएलपी में टेक्स्ट वर्गीकरण और भाव विश्लेषण का संयुक्त अधिगम। MTL साझा पैटर्न पर ध्यान केंद्रित करने के लिए मॉडल का मार्गदर्शन करके सामान्यीकरण को बढ़ाता है और ओवरफिटिंग के जोखिम को घटाता है।
फ्यू-शॉट लर्निंग
एक और प्रमुख तकनीक है फ्यू-शॉट लर्निंग, जो न्यूनतम लेबल युक्त डेटा के साथ मॉडल को प्रशिक्षित करने के लिए बनाई गई है। जहाँ पारंपरिक तरीकों को लेबल वाले डेटा की भारी मात्रा चाहिए, वहीं फ्यू-शॉट तकनीकें कुछ उदाहरणों से ही ज्ञान का हस्तांतरण संभव बनाती हैं। मेटा-लर्निंग और प्रोटोटाइपिकल नेटवर्क जैसी विधियाँ नए कार्यों में त्वरित अनुकूलन करा सकती हैं, जिससे वे निजी अनुशंसाएँ या विशेष श्रेणी की छवि वर्गीकरण जैसे क्षेत्रों में अमूल्य बनती हैं।
सेल्फ-सुपरवाइज्ड लर्निंग (SSL)
SSL बिना लेबल वाले डेटा का उपयोग कर मॉडल को प्रशिक्षित करता है, जिससे यह तब शक्तिशाली उपकरण बन जाता है जब लेबल युक्त डेटा दुर्लभ या अनुपलब्ध हो। यह तकनीक डेटा से ही सुपरवाइजरी सिग्नल बनाती है, जैसे किसी छवि के खोए हिस्से की भविष्यवाणी करना या उलझे हुए पाठ का पुनर्निर्माण करना जैसे प्रीटेक्स्ट टास्क हल करना। SSL से प्री-ट्रेन किए गए मॉडलों ने अनेक अनुप्रयोगों में उच्च ट्रांसफरेबिलिटी दिखाई है।
जीरो-शॉट लर्निंग
जीरो-शॉट लर्निंग एक कदम और आगे बढ़कर मॉडल को बिल्कुल नए कार्यों को बिना किसी लेबल युक्त डेटा के संभालने देती है। यह सहायक जानकारी, जैसे सेमांटिक संबंध या कार्य विवरण, के माध्यम से संभव होता है, जो मॉडल को नई श्रेणियों का सामना करने पर भी सामान्यीकरण करने में सक्षम बनाती है। यह क्षमता उन गतिशील क्षेत्रों में अत्यंत प्रासंगिक है जहाँ नई श्रेणियाँ अक्सर उभरती रहती हैं, जैसे नई उपाधियों या स्लैंग से निपटने वाले NLP अनुप्रयोग।
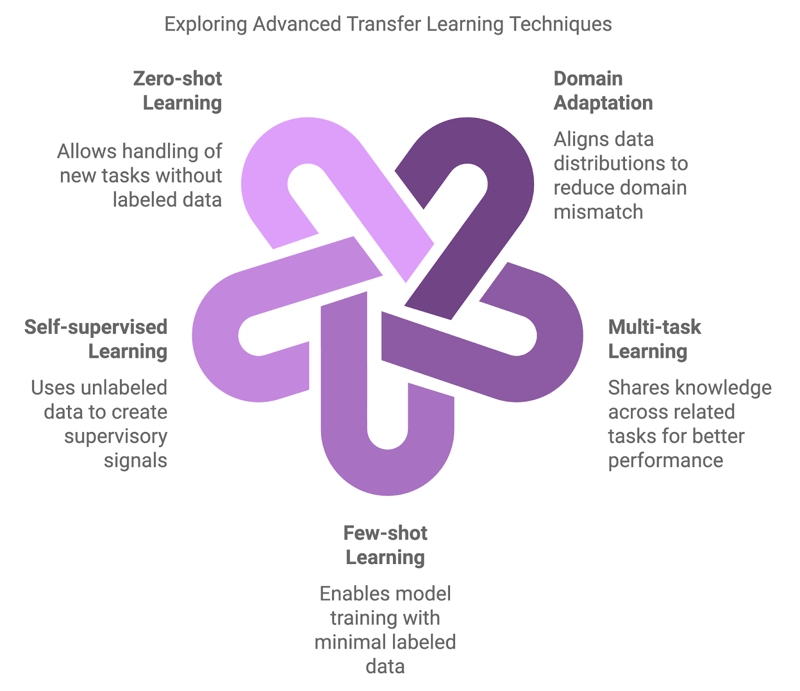
आरेख napkin.ai से जनरेट किया गया
डोमेन एडेप्टेशन तकनीकें
जैसा कि पहले संक्षेप में चर्चा की गई, डोमेन एडेप्टेशन ट्रांसफर लर्निंग का एक उपक्षेत्र है जो उन परिस्थितियों से निपटने पर केंद्रित है जहाँ मॉडल को प्रशिक्षित करने वाले डेटा और जिस डेटा पर मॉडल तैनात है, उनके बीच महत्वपूर्ण अंतर यानी "डोमेन शिफ्ट" होता है।
सामान्य ट्रांसफर लर्निंग में यह मान लिया जाता है कि स्रोत और लक्ष्य डोमेन समान विशेषताएँ साझा करते हैं, पर वास्तविक दुनिया के कई परिदृश्यों में ये डोमेन काफी भिन्न होते हैं। अंततः, इससे प्रदर्शन घट सकता है, क्योंकि एक सेट के डेटा पर प्रशिक्षित मॉडल नई स्थितियों पर सामान्यीकरण करने में संघर्ष करते हैं।
डोमेन एडेप्टेशन तकनीकें इस अंतर को पाटने के लिए डिज़ाइन की गई हैं, जिससे एक डोमेन में प्रशिक्षित मॉडल स्रोत और लक्ष्य डेटा वितरण के बीच असमानता को न्यूनतम करके दूसरे डोमेन में प्रभावी ढंग से काम कर सके। परिणामस्वरूप, यह तब और भी अधिक उपयोगी हो जाती है जब एक डोमेन में लेबल युक्त डेटा बहुत है लेकिन दूसरे में दुर्लभ या अनुपलब्ध।
डोमेन एडेप्टेशन की चुनौती से निपटने के लिए कई तकनीकें विकसित की गई हैं—इनमें से दो सबसे आम दृष्टिकोण हैं एडवर्सेरियल विधियाँ और डोमेन-इनवेरिएंट फीचर लर्निंग।
एडवर्सेरियल डोमेन एडेप्टेशन
डोमेन एडेप्टेशन के लिए व्यापक रूप से उपयोग की जाने वाली एक तकनीक एडवर्सेरियल लर्निंग है। यहाँ, मॉडल को ऐसे फीचर सीखने के लिए प्रशिक्षित किया जाता है जो लक्ष्य कार्य के लिए उपयोगी हों और साथ ही स्रोत और लक्ष्य डोमेन के बीच अप्रभेद्य भी हों।
हम यह एक डिस्क्रिमिनेटर—अर्थात् एक न्यूरल नेटवर्क—की मदद से कर सकते हैं, जिसका कार्य स्रोत और लक्ष्य डोमेन के डेटा में भेद करना होता है। मॉडल को एडवर्सेरियल तरीके से प्रशिक्षित किया जाता है ताकि वह डिस्क्रिमिनेटर को "फूल" सके और फीचर रिप्रेज़ेंटेशन को डोमेन-इनवेरिएंट बना दे। अगर यह परिचित लगता है, तो इसका कारण यह है कि यह तकनीक जेनरेटिव एडवर्सेरियल नेटवर्क (GANs) से प्रेरित है, जो यथार्थसंगत सिंथेटिक डेटा जनरेट करने के लिए समान सेटअप का उपयोग करते हैं।
डोमेन-इनवेरिएंट फीचर लर्निंग
एक अन्य दृष्टिकोण उन रिप्रेज़ेंटेशनों को सीखने पर केंद्रित है जो डोमेन-विशिष्ट भिन्नताओं से अप्रभावित हों। यह दोनों डोमेन के इनपुट डेटा को एक साझा फीचर स्पेस में रूपांतरित करता है, जहाँ स्रोत और लक्ष्य डोमेन अधिक निकटता से संरेखित हो जाते हैं। Maximum Mean Discrepancy (MMD) और CORAL (Correlation Alignment) जैसी तकनीकें इस स्पेस में सांख्यिकीय भिन्नताओं को कम करने में मदद करती हैं, जिससे लक्ष्य डोमेन पर लागू होने पर मॉडल अधिक प्रभावी ढंग से सामान्यीकरण कर सके।
उपयोग के मामले
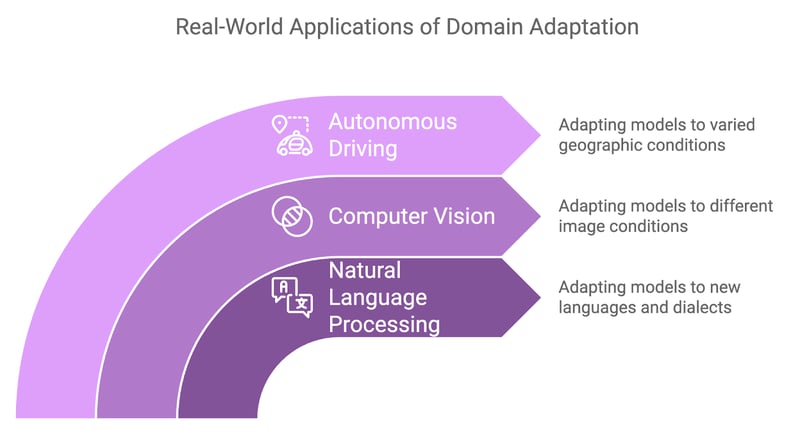
डोमेन एडेप्टेशन ने उन अनेक वास्तविक-world अनुप्रयोगों में उपयोगिता सिद्ध की है जहाँ डोमेन शिफ्ट अपरिहार्य हैं:
- एनएलपी में, एक भाषा या बोली में प्रशिक्षित मॉडलों को दूसरी में स्थानांतरित करते समय डोमेन एडेप्टेशन का अक्सर उपयोग होता है।
- उदाहरण के लिए, अंग्रेज़ी में प्रशिक्षित भाव विश्लेषण मॉडल को उसी भाषा की क्षेत्रीय बोली पर काम करने के लिए अनुकूलित करना पड़ सकता है, या औपचारिक पाठ पर प्रशिक्षित मॉडल को अनौपचारिक, बोलचाल की भाषा—जैसे सोशल मीडिया डेटा—के अनुरूप ढालना पड़ सकता है।
- कंप्यूटर विज़न में, जब प्रशिक्षण और लक्ष्य डेटा के बीच छवि विशेषताओं में अंतर होते हैं, तो डोमेन एडेप्टेशन का उपयोग किया जाता है।
- उदाहरण के लिए, प्राकृतिक प्रकाश में वस्तुओं की छवियों पर प्रशिक्षित मॉडल को मंद या कृत्रिम प्रकाश में काम करने के लिए अनुकूलित करना पड़ सकता है।
- स्वायत्त ड्राइविंग सिस्टम को भौगोलिक क्षेत्रों की परवाह किए बिना मजबूत प्रदर्शन चाहिए—यहाँ भी डोमेन एडेप्टेशन उपयोगी साबित होता है।
- एक देश में रोड साइन, पैदल यात्रियों या वाहनों को पहचानने के लिए प्रशिक्षित मॉडल को दूसरे क्षेत्र में थोड़े अलग सड़क हालात, मौसम पैटर्न या यहाँ तक कि ट्रैफिक नियमों के अनुरूप ढलना पड़ सकता है।
मल्टी-टास्क लर्निंग और ट्रांसफर लर्निंग का तालमेल
जैसे-जैसे मशीन लर्निंग कार्य जटिल होते जा रहे हैं, अनेक संबंधित समस्याओं से एक साथ निपटने की क्षमता मॉडल के प्रदर्शन और दक्षता को उल्लेखनीय रूप से बढ़ा सकती है। MTL इसे इस तरह संबोधित करता है कि मॉडल को अलग-थलग एक कार्य पर केंद्रित होने के बजाय एक साथ कई कार्य करने के लिए प्रशिक्षित किया जाए।
मल्टी-टास्क लर्निंग क्या है?
MTL की ताकत कार्यों के बीच संबंधों और साझा संरचनाओं का लाभ उठाने में निहित है, जिससे मॉडल अधिक समृद्ध फीचर रिप्रेज़ेंटेशन सीख पाते हैं। एक कार्य से मिली अंतर्दृष्टियाँ दूसरे पर मॉडल के प्रदर्शन को सुधारती हैं, जिससे समग्र शिक्षण दक्षता बढ़ती है।
MTL में दो मुख्य रणनीतियाँ आमतौर पर उपयोग होती हैं:
- हार्ड पैरामीटर शेयरिंग: इसमें मॉडल अपने अधिकांश पैरामीटर कार्यों के बीच साझा करता है, जबकि केवल कार्य-विशिष्ट लेयर स्वतंत्र रहती हैं। यह ओवरफिटिंग घटाता है क्योंकि मॉडल को ऐसे रिप्रेज़ेंटेशन सीखने पड़ते हैं जो कार्यों के बीच अच्छा सामान्यीकरण करें।
- सॉफ्ट पैरामीटर शेयरिंग: इसमें प्रत्येक कार्य के अपने पैरामीटर होते हैं, पर किसी न किसी रूप में रेगुलराइज़ेशन यह सुनिश्चित करता है कि ये पैरामीटर समान रहें, ताकि बिना पूर्ण ओवरलैप के साझा अधिगम प्रोत्साहित हो।
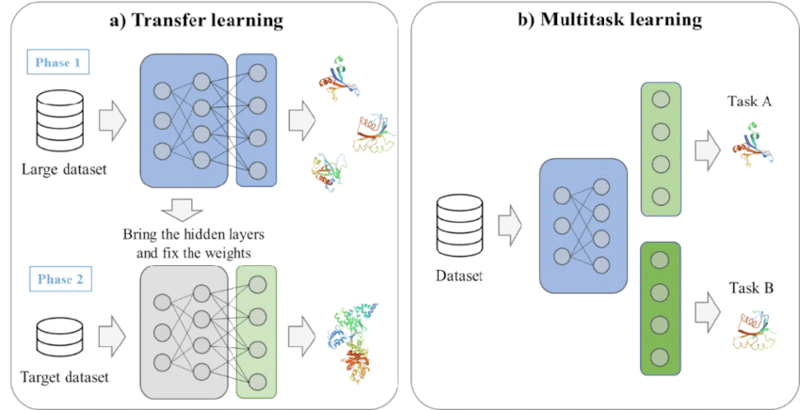
ट्रांसफर लर्निंग और मल्टीटास्क लर्निंग का एक उदाहरण। स्रोत: Kim et al., 2021
मल्टी-टास्क लर्निंग के लाभ
MTL कई ऐसे फायदे देता है जो इसे जटिल मशीन-लर्निंग परिदृश्यों के लिए मूल्यवान दृष्टिकोण बनाते हैं।
बेहतर सामान्यीकरण
कई कार्यों में सीखते हुए, मॉडल व्यापक डेटा के संपर्क में आता है और अधिक सामान्य रिप्रेज़ेंटेशन सीखता है। यह अक्सर प्रत्येक कार्य पर बेहतर प्रदर्शन की ओर ले जाता है, खासकर जब वे कार्य आपस में संबंधित हों।
डेटा दक्षता
MTL के साथ, मॉडल उपलब्ध डेटा का बेहतर उपयोग करते हैं, विशेष रूप से तब जब लेबल युक्त डेटा सीमित हो। क्योंकि मॉडल कई कार्यों से सीखता है, वह संबंधित कार्यों से मिली अंतर्दृष्टियों का उपयोग कर प्रदर्शन सुधार सकता है। यह क्रॉस-टास्क लर्निंग सीखने की प्रक्रिया को तेज करती है और हर कार्य के लिए बड़े डेटासेट पर निर्भरता घटाती है।
मॉडल दक्षता
हर कार्य के लिए अलग-अलग मॉडल प्रशिक्षित करने के बजाय, MTL एक ही मॉडल में अधिगम को समेकित कर देता है। इससे कम्प्यूटेशनल लागत और मेमोरी फ़ुटप्रिंट घटता है, और सीमित संसाधनों वाले परिवेशों में परिनियोजन अधिक कुशल बनता है।
मल्टी-टास्क लर्निंग के अनुप्रयोग
MTL का विभिन्न डोमेन में सफलतापूर्वक उपयोग हुआ है, जिनमें एनएलपी और कंप्यूटर विज़न प्रमुख हैं।
नैचुरल लैंग्वेज प्रोसेसिंग
एनएलपी में, MTL का उपयोग कई संबंधित कार्यों पर मॉडल को एक साथ प्रशिक्षित करने के लिए सामान्य रूप से किया जाता है। उदाहरण के लिए, एक भाषा मॉडल को एक साथ मशीन अनुवाद और टेक्स्ट वर्गीकरण करने के लिए प्रशिक्षित किया जा सकता है। इन कार्यों में सीखी गई रिप्रेज़ेंटेशन साझा करने से मॉडल भाषा की संरचना और संदर्भ की समझ बेहतर करता है, जिससे दोनों कार्यों को लाभ होता है।
कंप्यूटर विज़न
कंप्यूटर विज़न में, MTL को ऑब्जेक्ट डिटेक्शन और इमेज सेगमेंटेशन जैसे कार्यों पर लागू किया जा सकता है। हम किसी मॉडल को छवि में वस्तुओं की पहचान करने के लिए प्रशिक्षित कर सकते हैं और साथ ही उन वस्तुओं को वर्गीकृत करना भी सिखा सकते हैं। यह साझा अधिगम प्रक्रिया मॉडल को वस्तुओं के स्थान और श्रेणी—दोनों—पहचानने में सक्षम बनाती है, जिससे वह अधिक बहुमुखी और कुशल बनता है।
फ्यू-शॉट और सेल्फ-सुपरवाइज्ड लर्निंग
जहाँ लेबल युक्त डेटा दुर्लभ या अनुपलब्ध हो, वहाँ फ्यू-शॉट लर्निंग और SSL पारंपरिक सुपरवाइज्ड तरीकों की सीमाओं को दूर करने के लिए शक्तिशाली तकनीकों के रूप में उभरी हैं।
ये दृष्टिकोण मॉडलों को न्यूनतम लेबल युक्त डेटा के साथ नए कार्यों के अनुरूप ढालने या भारी मात्रा में अनलेबल्ड डेटा का उपयोग करने के नवीन तरीके पेश करते हैं, जिससे वे उन्नत ट्रांसफर लर्निंग के क्षेत्र में आवश्यक उपकरण बनते हैं।
फ्यू-शॉट लर्निंग
जैसा कि अब हम जानते हैं, फ्यू-शॉट लर्निंग का उद्देश्य मॉडलों को केवल कुछ लेबल युक्त उदाहरणों से ही नए कार्यों के अनुरूप तेजी से ढालना है।
हालाँकि, कई अनुप्रयोगों—जैसे दुर्लभ रोगों का निदान या विशेष उत्पाद पहचान—में बड़े डेटासेट इकट्ठा करना व्यावहारिक नहीं होता। फ्यू-शॉट लर्निंग संबंधित कार्यों से ज्ञान स्थानांतरित करके और न्यूनतम नए डेटा के साथ मॉडलों को फाइन-ट्यून करके इस समस्या को हल करती है।
नीचे, हम फ्यू-शॉट लर्निंग की दो प्रमुख रणनीतियों पर चर्चा करते हैं।
मेटा-लर्निंग
“लर्निंग टू लर्न” के रूप में भी जानी जाने वाली मेटा-लर्निंग में मॉडल को न्यूनतम डेटा के साथ नए कार्यों में तेजी से अनुकूलित होने के लिए प्रशिक्षित किया जाता है। विचार यह है कि मॉडल को विभिन्न कार्यों पर प्रशिक्षित किया जाए ताकि वह अपने अधिगम का सामान्यीकरण कर सके और अनदेखे कार्यों में शीघ्रता से समायोजित हो सके।
Model-Agnostic Meta-Learning (MAML) जैसे मेटा-लर्निंग फ्रेमवर्क मॉडल को पैरामीटरों का एक इष्टतम सेट सीखने में सक्षम बनाते हैं, जिन्हें केवल कुछ उदाहरणों के साथ नए कार्यों के लिए फाइन-ट्यून किया जा सकता है।
प्रोटोटाइपिकल नेटवर्क
एक अन्य सामान्य दृष्टिकोण प्रोटोटाइपिकल नेटवर्क है, जो सीखे गए फीचर स्पेस में बिंदुओं के बीच दूरी की गणना कर डेटा बिंदुओं का वर्गीकरण करते हैं। इस सेटअप में प्रत्येक वर्ग का प्रतिनिधित्व एक प्रोटोटाइप (उस वर्ग के उदाहरणों का फीचर स्पेस में औसत) द्वारा होता है।
फिर नए डेटा बिंदुओं को इन प्रोटोटाइप के निकटता के आधार पर वर्गीकृत किया जाता है। प्रोटोटाइपिकल नेटवर्क फ्यू-शॉट लर्निंग में प्रभावी हो सकते हैं, क्योंकि वर्गीकरण के लिए सार्थक प्रोटोटाइप बनाने के लिए इन्हें प्रति वर्ग केवल न्यूनतम उदाहरणों की आवश्यकता होती है।
सेल्फ-सुपरवाइज्ड लर्निंग
SSL, मैनुअल लेबल की आवश्यकता को दरकिनार करते हुए, बिना लेबल वाले विशाल डेटा से सुपरवाइजरी सिग्नल जनरेट कर सार्थक रिप्रेज़ेंटेशन निकालने देता है। एक बार मॉडल ने अनलेबल्ड डेटा से सीख लिया, तो उसे छोटे लेबल युक्त डेटासेट पर फाइन-ट्यून किया जा सकता है और डाउनस्ट्रीम कार्यों पर मजबूत प्रदर्शन हासिल किया जा सकता है।
सबसे प्रभावशाली SSL तकनीकों में से एक है कॉन्ट्रास्टिव लर्निंग, जो पॉजिटिव और नेगेटिव डेटा-जोड़े की तुलना करके मॉडल को प्रशिक्षित करती है। उद्देश्य फीचर स्पेस में समान डेटा बिंदुओं (पॉजिटिव पेयर) को पास लाना और असमान (नेगेटिव) को दूर धकेलना होता है।
नैचुरल लैंग्वेज प्रोसेसिंग में, मास्क्ड लैंग्वेज मॉडलिंग—जैसे BERT में—एक लोकप्रिय SSL विधि है। यहाँ इनपुट के हिस्सों को मास्क किया जाता है और मॉडल को आस-पास के संदर्भ का उपयोग कर खोए हुए तत्वों की भविष्यवाणी करने के लिए प्रशिक्षित किया जाता है। यह प्री-ट्रेनिंग रणनीति मॉडल को मजबूत, सामान्य-उद्देश्य रिप्रेज़ेंटेशन सीखने में मदद करती है, जिन्हें विभिन्न NLP कार्यों के लिए फाइन-ट्यून किया जा सकता है।
अनुप्रयोग
फ्यू-शॉट और सेल्फ-सुपरवाइज्ड लर्निंग का व्यापक उपयोग उन क्षेत्रों में होता है जहाँ डेटा सीमाएँ एक बड़ी बाधा हैं। यहाँ प्रत्येक के कुछ प्रमुख अनुप्रयोग दिए गए हैं।
कस्टम ऑब्जेक्ट डिटेक्शन में फ्यू-शॉट लर्निंग
कस्टम ऑब्जेक्ट डिटेक्शन में फ्यू-शॉट लर्निंग उपयोगी साबित होती है, जहाँ दुर्लभ या विशेषीकृत वस्तुओं की पहचान के लिए मॉडलों को केवल मुट्ठीभर लेबल युक्त उदाहरणों से सीखना पड़ सकता है।
औद्योगिक सेटिंग्स में, विनिर्माण प्रक्रिया में दोषों का पता लगाने में दोष की बहुत कम घटनाएँ हो सकती हैं। फ्यू-शॉट लर्निंग का लाभ उठाकर, सामान्य ऑब्जेक्ट डिटेक्शन कार्यों पर प्री-ट्रेन मॉडल को न्यूनतम अतिरिक्त प्रशिक्षण डेटा के साथ इन विशिष्ट वस्तुओं का पता लगाने के लिए तेजी से अनुकूलित किया जा सकता है।
LMs में सेल्फ-सुपरवाइज्ड लर्निंग
सेल्फ-सुपरवाइज्ड लर्निंग ने GPT और BERT जैसे मॉडलों के माध्यम से नैचुरल लैंग्वेज प्रोसेसिंग में क्रांति ला दी है। ये मॉडल सामान्य-उद्देश्य भाषा रिप्रेज़ेंटेशन सीखते हैं, जिन्हें अपेक्षाकृत छोटे लेबल युक्त डेटासेट के साथ विशिष्ट कार्यों के लिए फाइन-ट्यून किया जा सकता है। उदाहरण के लिए, SSL से प्री-ट्रेन किया गया भाषा मॉडल भाव विश्लेषण, टेक्स्ट वर्गीकरण या सारांशण जैसे कार्य करने के लिए फाइन-ट्यून किया जा सकता है और अक्सर अत्याधुनिक परिणाम देता है।
उन्नत ट्रांसफर लर्निंग तकनीकों का व्यावहारिक कार्यान्वयन
मशीन लर्निंग लाइब्रेरी और फ्रेमवर्क उन्नत ट्रांसफर लर्निंग तरीकों के कार्यान्वयन को काफी सरल बना सकते हैं। PyTorch, TensorFlow और Hugging Face Transformers जैसे टूल आवश्यक लचीलापन और प्री-बिल्ट कॉम्पोनेंट प्रदान करते हैं, जो विकास प्रक्रिया को तेज करते हैं।
फ्रेमवर्क और टूल
जो पेशेवर उन्नत ट्रांसफर लर्निंग तकनीकों को लागू करना चाहते हैं, उनके लिए कई लाइब्रेरी और फ्रेमवर्क व्यापक समर्थन प्रदान करते हैं:
- PyTorch: शोध और व्यावहारिक मशीन-लर्निंग प्रोजेक्ट्स के लिए व्यापक रूप से उपयोग होने वाला लचीला, उपयोगकर्ता-अनुकूल फ्रेमवर्क। PyTorch का डायनेमिक कम्प्यूटेशनल ग्राफ मेटा-लर्निंग और मल्टी-टास्क लर्निंग जैसे कार्यों के लिए आदर्श है।
- TensorFlow: एक अन्य लोकप्रिय डीप लर्निंग फ्रेमवर्क, TensorFlow अपने उच्च-स्तरीय API Keras के माध्यम से ट्रांसफर लर्निंग और डोमेन एडेप्टेशन के लिए मजबूत समर्थन देता है। TensorFlow का tensorflow_hub भी प्री-ट्रेंड मॉडल प्रदान करता है जिन्हें नए कार्यों के लिए फाइन-ट्यून किया जा सकता है।
- Hugging Face Transformers: नैचुरल लैंग्वेज प्रोसेसिंग कार्यों के लिए आदर्श लाइब्रेरी, जो BERT, GPT और T5 जैसे अनेक प्री-ट्रेंड मॉडल उपलब्ध कराती है, जिन्हें कम प्रयास में विशिष्ट डाउनस्ट्रीम कार्यों के लिए फाइन-ट्यून किया जा सकता है।
चुनौतियाँ और विचार
उन्नत ट्रांसफर लर्निंग तकनीकों को लागू करना चुनौतीपूर्ण है, और कुछ महत्वपूर्ण कारक हैं जिन्हें हमें ध्यान में रखना चाहिए।
कैटस्ट्रॉफिक फॉरगेटिंग
नए कार्यों पर फाइन-ट्यूनिंग करने से मॉडल पहले सीखे हुए ज्ञान को "भूल" सकते हैं। Elastic Weight Consolidation (EWC) जैसी तकनीकें प्री-ट्रेंड मॉडल के वज़नों—अर्थात् पूर्व ज्ञान—को संरक्षित करने में मदद कर सकती हैं।
कम्प्यूटेशनल जटिलता का प्रबंधन
डोमेन एडेप्टेशन और मल्टी-टास्क लर्निंग जैसी तकनीकें कम्प्यूटेशनल आवश्यकताओं को काफी बढ़ा सकती हैं। एडवर्सेरियल डोमेन एडेप्टेशन मॉडल या मल्टी-टास्क आर्किटेक्चर को प्रशिक्षित करने में अतिरिक्त जटिलता के कारण अधिक संसाधन लग सकते हैं। हमें अपने मॉडल को ऑप्टिमाइज़ करना चाहिए और बड़े मॉडलों को कुशलता से संभालने के लिए मिक्स्ड प्रिसीजन ट्रेनिंग जैसे टूल का उपयोग करना चाहिए।
निष्पक्षता और बायस शमन सुनिश्चित करना
बायस्ड डेटा पर प्री-ट्रेन किए गए ट्रांसफर लर्निंग मॉडल नए कार्यों में इन बायस को बनाए रख सकते हैं या बढ़ा भी सकते हैं, जिससे पक्षपाती पूर्वानुमान हो सकते हैं। यह जोखिम हेल्थकेयर और फाइनेंस जैसे संवेदनशील क्षेत्रों में महत्वपूर्ण है। निष्पक्षता सुनिश्चित करने के लिए, हमें नियमित रूप से मॉडल आउटपुट का बायस के लिए मूल्यांकन करना चाहिए और रिवेटिंग, एडवर्सेरियल डी-बायसिंग या फेयर रिप्रेज़ेंटेशन लर्निंग जैसी शमन तकनीकें लागू करनी चाहिए।
उद्योग से उदाहरण
उन्नत ट्रांसफर लर्निंग तरीकों का उपयोग विभिन्न उद्योगों में किया जा रहा है, जो जटिल वास्तविक समस्याओं के लिए नवाचारी समाधान प्रदान कर रहे हैं। नीचे कुछ प्रमुख अनुप्रयोग और उद्योग उदाहरण दिए गए हैं जो दिखाते हैं कि ये तकनीकें AI में प्रगति कैसे ला रही हैं।
OpenAI: GPT मॉडल द्वारा फ्यू-शॉट लर्निंग
OpenAI का GPT-4o मॉडल फ्यू-शॉट लर्निंग का अग्रणी उदाहरण है, जिसने केवल कुछ उदाहरणों के साथ नए कार्यों में अनुकूलित होने की क्षमता प्रदर्शित की है। विशाल पाठ डेटा पर प्री-ट्रेन GPT-4o अनुवाद, सारांशण और प्रश्नोत्तर जैसे विभिन्न कार्य बिना टास्क-विशिष्ट फाइन-ट्यूनिंग के कर सकता है।
इसके बजाय, उपयोगकर्ता वांछित कार्य के कुछ उदाहरण प्रदान करते हैं, और मॉडल वहाँ से सामान्यीकरण कर लेता है। यह फ्यू-शॉट लर्निंग क्षमता बड़े भाषा मॉडलों के अनुप्रयोग दायरे को रचनात्मक लेखन से लेकर संवादात्मक एजेंटों तक विस्तृत कर चुकी है।
DeepMind: हेल्थकेयर AI में मल्टी-टास्क लर्निंग
AI अनुसंधान में अग्रणी DeepMind ने मेडिकल इमेजिंग से कई स्थितियों के निदान में सहायता करने वाले हेल्थकेयर मॉडल विकसित करने के लिए मल्टी-टास्क लर्निंग का उपयोग किया है। उदाहरण के लिए, रेटिना स्कैन से नेत्र रोगों का पता लगाने वाला उनका AI सिस्टम एक ही मॉडल का उपयोग करके डायबेटिक रेटिनोपैथी और आयु-संबंधित मैक्युलर डिजनरेशन सहित कई स्थितियों का निदान कर सकता है।
यह MTL दृष्टिकोण प्रत्येक स्थिति के लिए अलग-अलग मॉडलों की आवश्यकता को कम करता है, जिससे हेल्थकेयर प्रदाताओं को अपने डायग्नोस्टिक प्रोसेस को सुव्यवस्थित करने और तेज़, अधिक सटीक रोगी देखभाल प्रदान करने में मदद मिलती है।
Waymo: स्वायत्त ड्राइविंग में डोमेन एडेप्टेशन
Waymo (Google की सेल्फ-ड्राइविंग कार परियोजना) विभिन्न ड्राइविंग परिवेशों में अपने स्वायत्त वाहन मॉडलों के सामान्यीकरण में सुधार करने के लिए डोमेन एडेप्टेशन तकनीकों का उपयोग करता है। कंपनी अपने मॉडलों को सिम्युलेटेड वातावरण में प्रशिक्षित करती है और फिर उन्हें विभिन्न शहरों और मौसम स्थितियों में वास्तविक-विश्व परिनियोजन के लिए अनुकूलित करती है।
यह प्रक्रिया सुनिश्चित करती है कि सेल्फ-ड्राइविंग कारें अलग-अलग शहरी परिदृश्यों—सैन फ्रांसिस्को की भीड़भाड़ वाली सड़कों से लेकर एरिज़ोना के खुले हाईवे तक—की बारीकियों को बिना हर स्थान के लिए व्यापक पुनःप्रशिक्षण के संभाल सकें।
उन्नत ट्रांसफर लर्निंग में भविष्य की प्रवृत्तियाँ
शोधकर्ता लगातार सीमाओं को आगे बढ़ा रहे हैं—मॉडल को अधिक अनुकूलनीय, निष्पक्ष और जटिल वास्तविक-विश्व कार्यों को संभालने में सक्षम बनाने के साथ-साथ आवश्यक डेटा और प्रशिक्षण समय को घटाने का प्रयास कर रहे हैं।
कंटिनुअल लर्निंग
कंटिनुअल या लाइफलॉन्ग लर्निंग उन मॉडलों के विकास पर केंद्रित है जो नए डेटा से लगातार सीख सकें, जबकि पहले सीखे गए कार्यों का ज्ञान बनाए रखें। पारंपरिक ट्रांसफर लर्निंग के विपरीत, जहाँ फाइन-ट्यूनिंग के बाद मॉडल स्थिर हो जाते हैं, कंटिनुअल लर्निंग नई जानकारी के लिए निरंतर अनुकूलन की अनुमति देती है।
यह रोबोटिक्स और स्वायत्त प्रणालियों जैसे गतिशील परिवेशों के लिए अनिवार्य है, जहाँ नए परिदृश्य नियमित रूप से सामने आते रहते हैं। इस संदर्भ में, मेमोरी-आधारित रणनीतियाँ पिछले ज्ञान को संरक्षित रखने और नई कुशलताओं को समाहित करने की ज़रूरत के बीच संतुलन बनाने में मदद करती हैं। भविष्य का विकास अधिक जटिल डोमेन तक कंटिनुअल लर्निंग का विस्तार करने का लक्ष्य रखता है, ताकि मॉडल पहले के प्रदर्शन से समझौता किए बिना कुशलता से अपडेट हो सकें।
निष्पक्षता और बायस शमन
जैसे-जैसे हेल्थकेयर, फाइनेंस और क़ानून-प्रवर्तन जैसे उद्योगों में ट्रांसफर लर्निंग का इस्तेमाल बढ़ रहा है, निष्पक्षता और बायस को संबोधित करने की आवश्यकता को नज़रअंदाज़ नहीं किया जा सकता।
बड़े, विविध डेटासेट पर प्री-ट्रेन मॉडल अक्सर अंतर्निहित बायस लेकर आते हैं, जो नए अनुप्रयोगों में तिरछे परिणाम दे सकते हैं। इसका मुकाबला करने के लिए, शोधकर्ता एडवर्सेरियल डी-बायसिंग, रिवेटिंग और फेयर रिप्रेज़ेंटेशन लर्निंग जैसी तकनीकों का अन्वेषण कर रहे हैं ताकि इन बायस का पता लगाया जा सके और उन्हें कम किया जा सके।
निष्पक्षता सुनिश्चित करना ट्रांसफर लर्निंग अनुसंधान का केंद्रीय फोकस बना रहेगा, विशेषकर संवेदनशील डोमेन में जहाँ पक्षपाती पूर्वानुमानों के वास्तविक प्रभाव हो सकते हैं।
हाइब्रिड ट्रांसफर लर्निंग
हाइब्रिड ट्रांसफर लर्निंग सुपरवाइज्ड, अनसुपरवाइज्ड और सेल्फ-सुपरवाइज्ड तरीकों को जोड़ती है ताकि प्रत्येक की ताकतों का लाभ उठाया जा सके। आमतौर पर मॉडल को सामान्य रिप्रेज़ेंटेशन सीखने के लिए अनसुपरवाइज्ड या सेल्फ-सुपरवाइज्ड दृष्टिकोणों से प्री-ट्रेन किया जाता है और फिर विशिष्ट कार्यों के लिए लेबल युक्त डेटा के साथ फाइन-ट्यून किया जाता है।
यह हाइब्रिड रणनीति ट्रांसफरेबिलिटी बढ़ाती है और बड़े लेबल युक्त डेटासेट पर निर्भरता घटाती है, जिससे यह दुर्लभ रोग निदान या विशेष औद्योगिक अनुप्रयोगों जैसे सीमित एनोटेटेड डेटा वाले क्षेत्रों में विशेष रूप से उपयोगी बनती है।
ट्रांसफर लर्निंग में रिइनफोर्समेंट लर्निंग
ट्रांसफर लर्निंग में रिइनफोर्समेंट लर्निंग (RL) भी प्रगति कर रही है, जहाँ एक वातावरण में प्रशिक्षित एजेंटों को संबंधित सेटिंग्स में उपयोग के लिए अनुकूलित किया जाता है। इससे एजेंटों को नए कार्यों में दक्ष होने के लिए आवश्यक समय और डेटा घटता है, और जटिल, बहु-चरणीय समस्याओं को सुलझाने में उनकी क्षमता बढ़ती है।
उदाहरण के लिए, किसी विशिष्ट प्रकार की रोबोटिक प्रणाली में नेविगेट करने के लिए प्रशिक्षित RL एजेंट न्यूनतम पुनःप्रशिक्षण के साथ किसी नए लेकिन समान सेटअप पर अपना ज्ञान लागू कर सकता है, जिससे RL सिस्टम की बहुमुखी प्रतिभा और स्केलेबिलिटी में उल्लेखनीय वृद्धि होती है।
निष्कर्ष
इस लेख में, हमने उन्नत ट्रांसफर लर्निंग तकनीकों का अन्वेषण किया। हमने डेटा वितरण के अंतर से निपटने के लिए डोमेन एडेप्टेशन, साझा ज्ञान के उपयोग के लिए मल्टी-टास्क लर्निंग, और सीमित लेबल युक्त डेटा वाले परिदृश्यों के लिए फ्यू-शॉट और सेल्फ-सुपरवाइज्ड लर्निंग की समीक्षा की।
ये तकनीकें चुनौतियों का समाधान करने और मॉडल प्रदर्शन में सुधार लाने के लिए प्रभावी रणनीतियाँ प्रदान कर सकती हैं। जैसे-जैसे AI आगे बढ़ता है, इन तकनीकों से परिचित होना प्रतिस्पर्धी बने रहने के लिए आवश्यक होगा।

हाल ही में स्नातकोत्तर (MSc) उत्तीर्ण, विशेषता: कृत्रिम बुद्धिमत्ता
ट्रांसफर लर्निंग मशीन लर्निंग में बहुत महत्वपूर्ण हो गई है, जहाँ पहले से प्रशिक्षित मॉडलों को नए, संबंधित कार्यों के लिए अनुकूलित किया जाता है ताकि समय और संसाधन बचाए जा सकें। यह रणनीति कंप्यूटर विज़न, नैचुरल लैंग्वेज प्रोसेसिंग और स्पीच रिकग्निशन जैसे क्षेत्रों में अत्यंत प्रभावी है, जहाँ बड़े पैमाने पर प्री-ट्रेंड डेटा प्रचुर मात्रा में उपलब्ध है।
लोकप्रिय होने के बावजूद, फाइन-ट्यूनिंग—जो एक सामान्य ट्रांसफर लर्निंग दृष्टिकोण है—अक्सर ओवरफिटिंग या प्री-ट्रेंड मॉडल के डोमेन और लक्षित डेटा के बीच असंगति जैसी बाधाओं का सामना करती है, जिसे डोमेन शिफ्ट कहा जाता है। बुनियादी ट्रांसफर लर्निंग जटिल कार्यों या सीमित डेटा के साथ कठिनाइयों का सामना कर सकती है, जिससे अपर्याप्त अनुकूलन होता है।
इन चुनौतियों को दूर करने के लिए, उन्नत ट्रांसफर लर्निंग तकनीकों की एक नई लहर उभरी है, जो डोमेन असमानताओं, डेटा की कमी और कुशल मॉडल अनुकूलन की जरूरत को संबोधित करती है। इस लेख में, मैं इन उन्नत ट्रांसफर लर्निंग रणनीतियों में से कुछ की पड़ताल करूंगा।