
Lộ trình
Phát triển các ứng dụng trí tuệ nhân tạo
21 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleCác cách tiếp cận truyền thống, như tiền huấn luyện trên một bộ dữ liệu lớn rồi fine-tune trên bộ dữ liệu chuyên biệt cho nhiệm vụ, là nền tảng nhưng đôi khi chưa đủ. Nhiều phương pháp nâng cao đã xuất hiện để xử lý những sắc thái của dịch chuyển miền, khan hiếm dữ liệu và học đa nhiệm.
Các phương pháp nâng cao đưa vào những lớp phức tạp và linh hoạt bổ sung. Những kỹ thuật này nhằm cải thiện hiệu suất mô hình trong các bối cảnh mà cách tiếp cận truyền thống có thể không đáp ứng được.
Các kỹ thuật thích nghi miền được thiết kế để xử lý chênh lệch giữa miền nguồn (tiền huấn luyện) và miền đích (fine-tuning). Việc fine-tune truyền thống thường cho kết quả dưới mức tối ưu khi các mô hình tiền huấn luyện gặp dữ liệu khác biệt đáng kể so với dữ liệu huấn luyện của chúng. Kỹ thuật thích nghi miền giảm sự lệch này bằng cách căn chỉnh phân phối dữ liệu, giúp mô hình khái quát hóa tốt hơn trong các bối cảnh mới.
MTL cho phép mô hình học đồng thời trên nhiều nhiệm vụ có liên quan. Bằng cách chia sẻ tri thức giữa các nhiệm vụ, mô hình có thể tận dụng điểm chung và cải thiện hiệu suất trên tất cả. Chiến lược này đặc biệt hiệu quả khi các nhiệm vụ bổ trợ cho nhau, như học đồng thời phân loại văn bản và phân tích cảm xúc trong xử lý ngôn ngữ tự nhiên. MTL tăng cường khả năng khái quát hóa và giảm nguy cơ quá khớp bằng cách định hướng mô hình tập trung vào các mẫu chung.
Một kỹ thuật chủ chốt khác là học few-shot, được thiết kế để huấn luyện mô hình với lượng dữ liệu gán nhãn tối thiểu. Trong khi cách tiếp cận truyền thống cần lượng lớn dữ liệu gán nhãn, kỹ thuật few-shot cho phép mô hình chuyển giao tri thức chỉ với vài ví dụ. Các phương pháp như meta-learning và mạng nguyên mẫu (prototypical networks) có thể giúp thích nghi nhanh với nhiệm vụ mới, hữu ích trong các lĩnh vực như gợi ý cá nhân hóa hoặc phân loại ảnh ngách.
SSL sử dụng dữ liệu không gán nhãn để huấn luyện mô hình, trở thành công cụ mạnh mẽ khi dữ liệu gán nhãn khan hiếm hoặc không có. Kỹ thuật này tạo tín hiệu giám sát từ chính dữ liệu, giải các nhiệm vụ tiền văn bản như dự đoán phần bị thiếu của ảnh hoặc tái tạo văn bản bị xáo trộn. Các mô hình tiền huấn luyện bằng SSL đã chứng minh khả năng chuyển giao cao trên nhiều ứng dụng.
Học zero-shot tiến thêm một bước khi cho phép mô hình xử lý các nhiệm vụ hoàn toàn mới mà không cần dữ liệu gán nhãn. Điều này đạt được thông qua thông tin bổ trợ như quan hệ ngữ nghĩa hoặc mô tả nhiệm vụ, cho phép mô hình khái quát hóa ngay cả khi đối mặt với danh mục mới. Năng lực này rất phù hợp với những lĩnh vực năng động nơi các danh mục mới thường xuyên xuất hiện, chẳng hạn như trong NLP xử lý từ mới hoặc tiếng lóng.
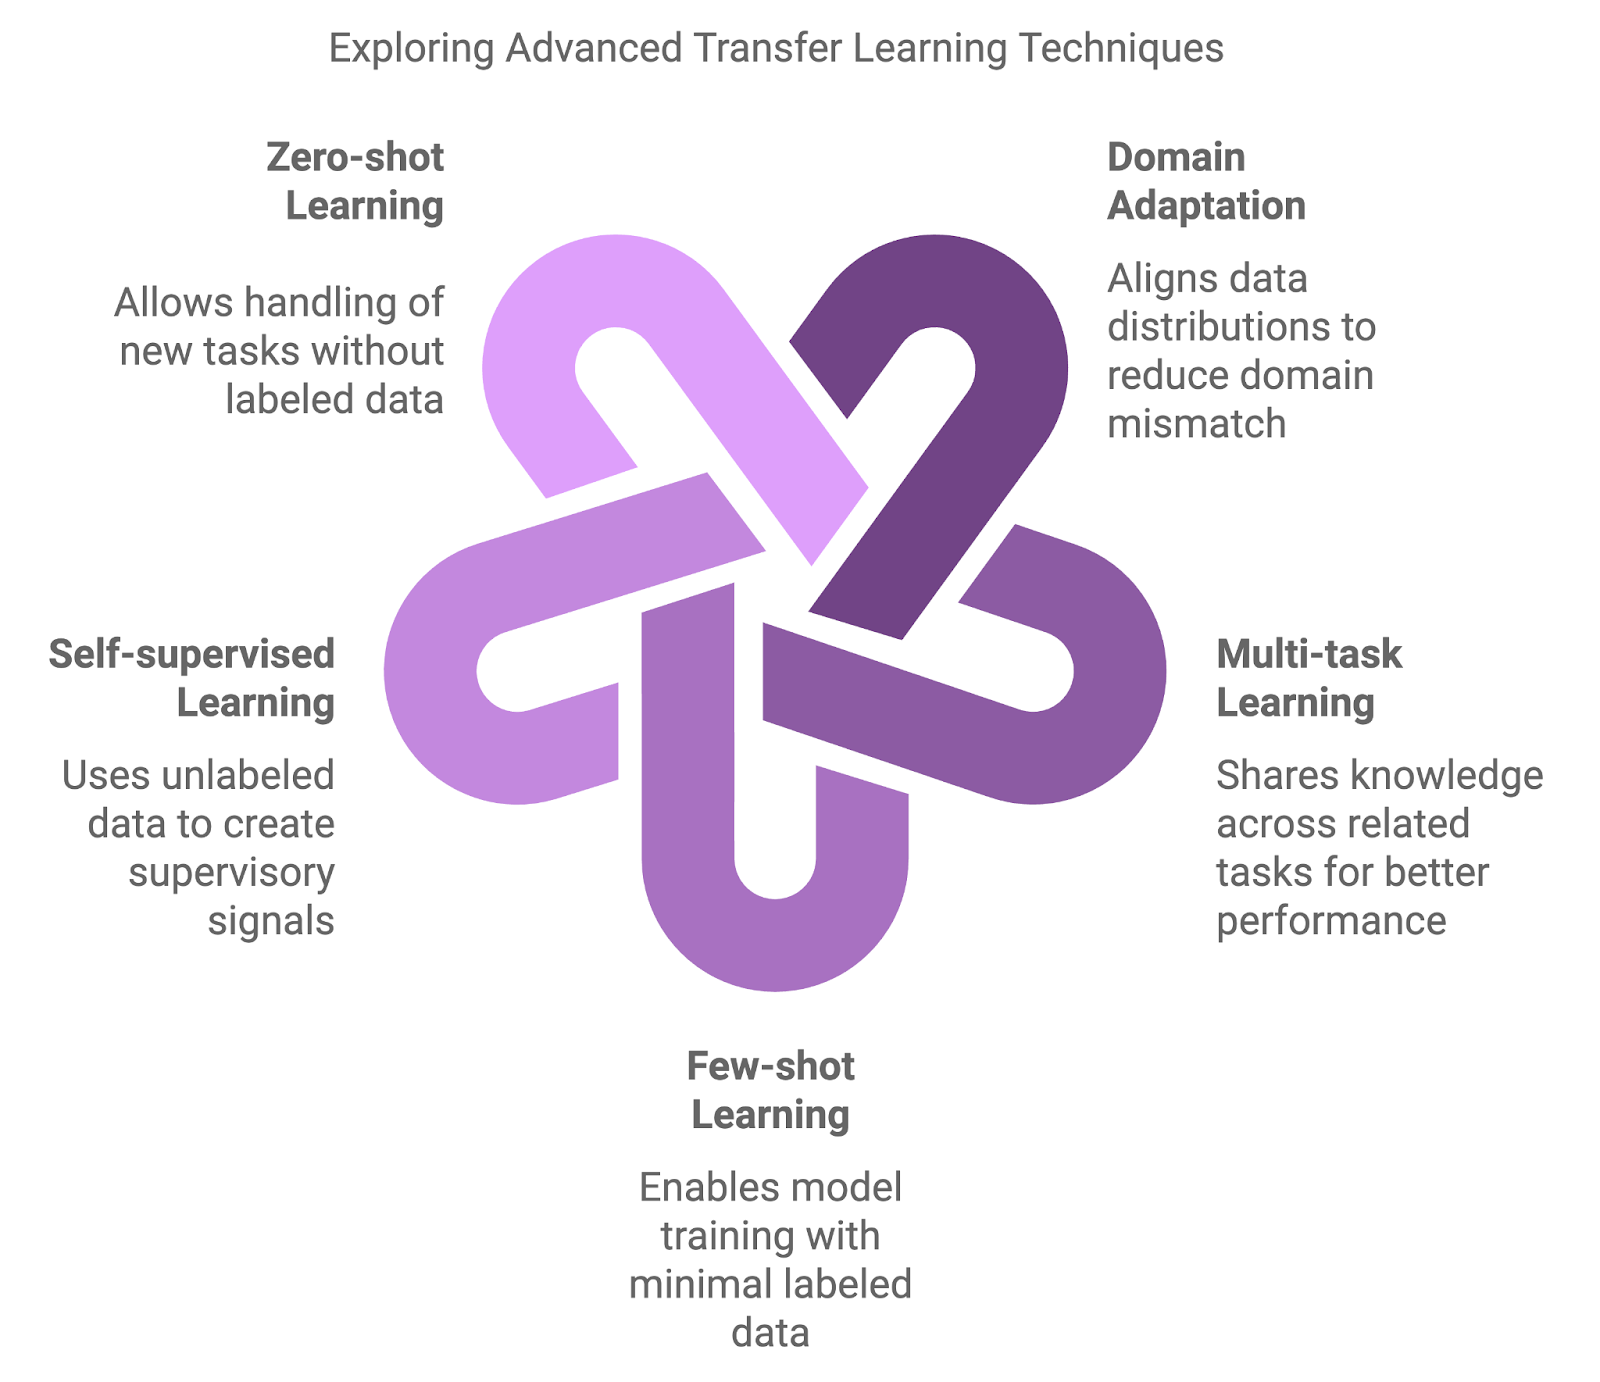
Sơ đồ được tạo bằng napkin.ai
Như đã đề cập ngắn gọn trước đó, thích nghi miền là một phân nhánh của học chuyển giao, tập trung vào xử lý các tình huống có sự khác biệt đáng kể, hay "dịch chuyển miền", giữa dữ liệu dùng để huấn luyện mô hình và dữ liệu nơi mô hình được triển khai.
Trong học chuyển giao điển hình, giả định rằng miền nguồn và miền đích có đặc điểm tương đồng, nhưng trong nhiều kịch bản thực tế, các miền này khác biệt đáng kể. Cuối cùng, điều này có thể làm suy giảm hiệu suất, vì các mô hình được huấn luyện trên một tập dữ liệu gặp khó khi khái quát hóa sang điều kiện mới.
Các kỹ thuật thích nghi miền được thiết kế để lấp đầy khoảng cách này, cho phép mô hình huấn luyện ở một miền hoạt động hiệu quả ở miền khác bằng cách giảm thiểu độ chênh giữa phân phối dữ liệu nguồn và đích. Vì vậy, thích nghi miền càng trở nên giá trị trong bối cảnh dữ liệu gán nhãn dồi dào ở một miền nhưng khan hiếm hoặc không có ở miền khác.
Nhiều kỹ thuật đã được phát triển để giải quyết thách thức thích nghi miền—hai cách tiếp cận phổ biến nhất là phương pháp đối kháng và học đặc trưng bất biến miền.
Một kỹ thuật được sử dụng rộng rãi cho thích nghi miền là học đối kháng. Trong ngữ cảnh này, một mô hình được huấn luyện để học các đặc trưng hữu ích cho nhiệm vụ đích đồng thời đảm bảo các đặc trưng này khó phân biệt giữa miền nguồn và miền đích.
Ta có thể đạt được điều này bằng một bộ phân biệt, tức là một mạng nơ-ron có nhiệm vụ phân biệt dữ liệu miền nguồn và miền đích. Mô hình được huấn luyện theo cách đối kháng để học cách "đánh lừa" bộ phân biệt, khiến biểu diễn đặc trưng trở nên bất biến theo miền. Nếu điều này nghe quen, đó là vì kỹ thuật này lấy cảm hứng từ Mạng Đối kháng Sinh (GAN), sử dụng thiết lập tương tự để sinh dữ liệu tổng hợp chân thực.
Một cách tiếp cận khác tập trung vào việc học biểu diễn không bị ảnh hưởng bởi các biến thiên đặc thù miền. Cách này biến đổi dữ liệu đầu vào từ cả hai miền vào một không gian đặc trưng chung, nơi miền nguồn và đích được căn chỉnh chặt chẽ hơn. Các kỹ thuật như MMD (Maximum Mean Discrepancy) và CORAL (Correlation Alignment) giúp giảm thiểu khác biệt thống kê trong không gian này, đảm bảo mô hình có thể khái quát hiệu quả hơn khi áp dụng cho miền đích.
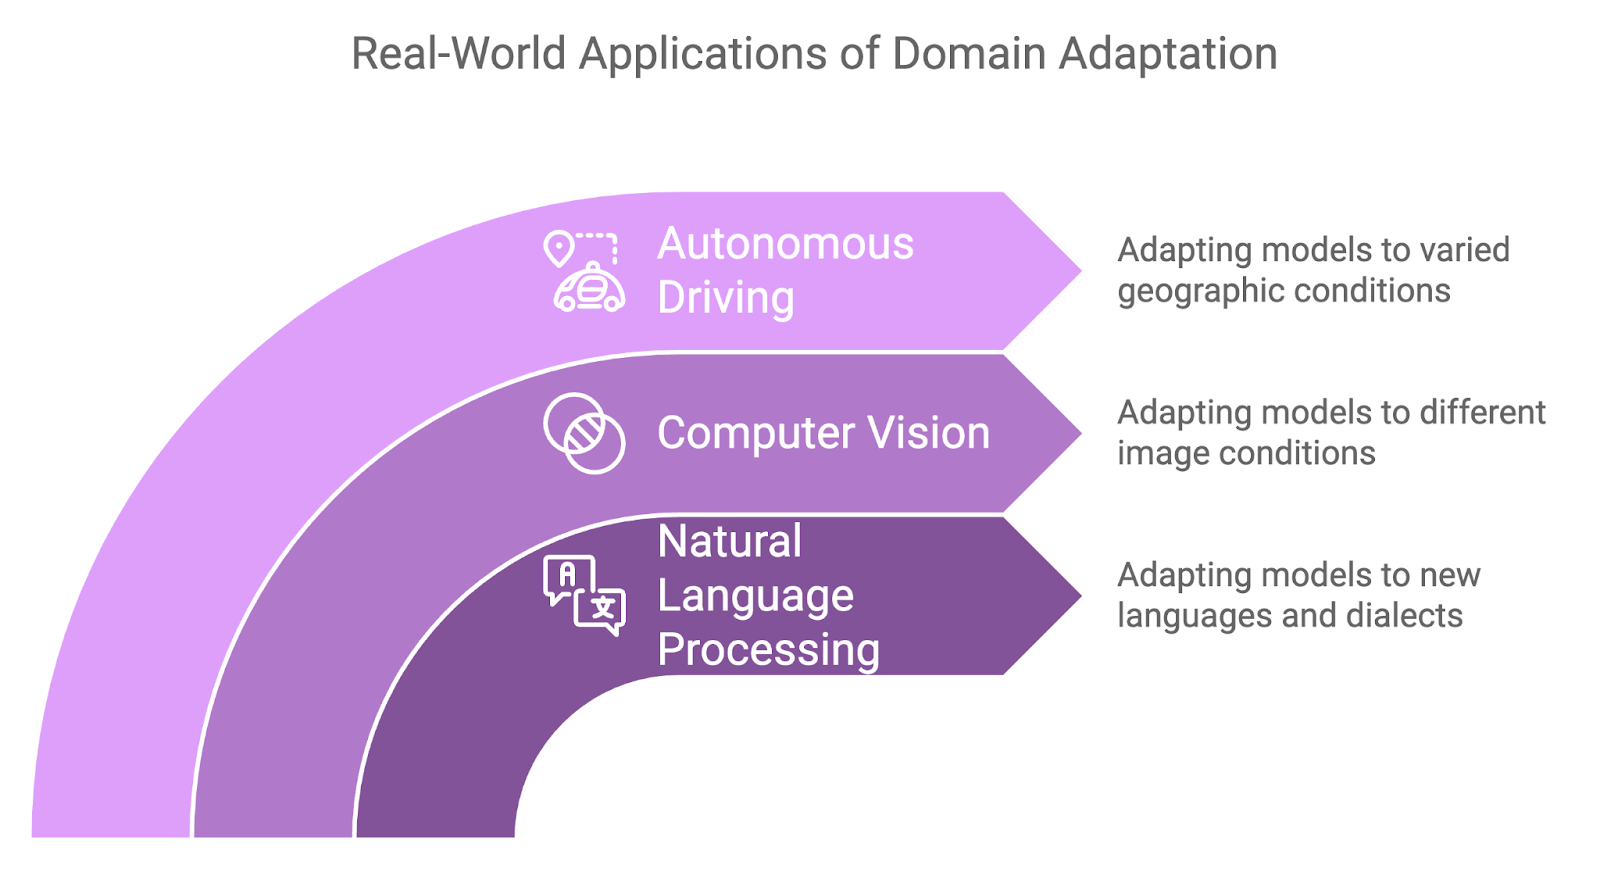
Thích nghi miền tỏ ra hữu ích trong nhiều ứng dụng thực tế nơi dịch chuyển miền là không thể tránh:
Khi các nhiệm vụ học máy ngày càng phức tạp, khả năng giải quyết đồng thời nhiều vấn đề liên quan có thể cải thiện đáng kể hiệu suất và hiệu quả của mô hình. MTL giải quyết điều này bằng cách huấn luyện mô hình thực hiện nhiều nhiệm vụ cùng lúc, thay vì tập trung vào một nhiệm vụ riêng lẻ.
Sức mạnh của MTL nằm ở khả năng tận dụng các mối quan hệ và cấu trúc chung giữa các nhiệm vụ, cho phép mô hình học biểu diễn đặc trưng phong phú hơn. Hiểu biết thu được từ một nhiệm vụ giúp cải thiện hiệu suất ở nhiệm vụ khác, dẫn đến hiệu quả học tổng thể cao hơn.
Trong MTL, hai chiến lược chính thường được sử dụng:
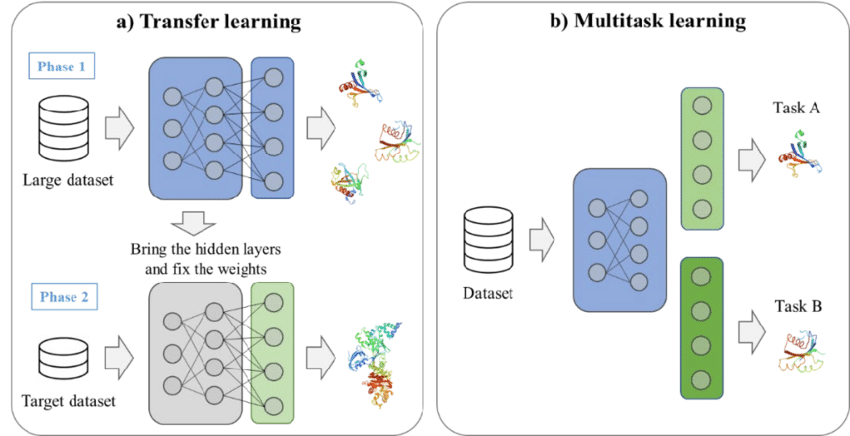
Ví dụ về học chuyển giao và học đa nhiệm. Nguồn: Kim et al., 2021
MTL mang lại nhiều lợi thế khiến nó trở thành cách tiếp cận giá trị cho các kịch bản học máy phức tạp.
Bằng cách học trên nhiều nhiệm vụ, mô hình được tiếp xúc với dải dữ liệu rộng hơn và học các biểu diễn tổng quát hơn. Điều này thường dẫn đến hiệu suất tốt hơn cho mỗi nhiệm vụ, đặc biệt khi các nhiệm vụ có liên quan.
Với MTL, mô hình tận dụng dữ liệu sẵn có tốt hơn, đặc biệt trong tình huống dữ liệu gán nhãn khan hiếm. Vì mô hình học từ nhiều nhiệm vụ, nó có thể dùng hiểu biết từ các nhiệm vụ liên quan để cải thiện hiệu suất. Việc học chéo nhiệm vụ này tăng tốc quá trình học và giảm phụ thuộc vào các bộ dữ liệu lớn cho từng nhiệm vụ.
Thay vì huấn luyện các mô hình riêng cho từng nhiệm vụ, MTL hợp nhất việc học vào một mô hình duy nhất. Điều này giảm chi phí tính toán và bộ nhớ, giúp triển khai hiệu quả hơn trong môi trường tài nguyên hạn chế.
MTL đã được áp dụng thành công trên nhiều lĩnh vực, với các trường hợp sử dụng nổi bật trong NLP và thị giác máy tính.
Trong xử lý ngôn ngữ tự nhiên, MTL thường được dùng để huấn luyện mô hình trên nhiều nhiệm vụ liên quan. Ví dụ, một mô hình ngôn ngữ có thể được huấn luyện để vừa dịch máy vừa phân loại văn bản đồng thời. Bằng cách chia sẻ các biểu diễn học được giữa những nhiệm vụ này, mô hình có thể cải thiện hiểu biết về cấu trúc và ngữ cảnh ngôn ngữ, mang lại lợi ích cho cả hai.
Trong thị giác máy tính, MTL có thể áp dụng cho các nhiệm vụ như phát hiện vật thể và phân đoạn ảnh. Ta có thể huấn luyện một mô hình nhận diện các vật thể trong ảnh đồng thời học cách phân loại chúng. Quá trình học chung này cho phép mô hình nhận biết cả vị trí và loại vật thể, giúp linh hoạt và hiệu quả hơn.
Trong các bối cảnh dữ liệu gán nhãn khan hiếm hoặc không có, học few-shot và SSL đã nổi lên như những kỹ thuật mạnh mẽ để khắc phục hạn chế của phương pháp có giám sát truyền thống.
Những cách tiếp cận này mang đến các phương thức mới để điều chỉnh mô hình cho nhiệm vụ mới với tối thiểu dữ liệu gán nhãn hoặc bằng cách sử dụng lượng lớn dữ liệu không gán nhãn, khiến chúng trở thành công cụ thiết yếu trong lĩnh vực học chuyển giao nâng cao.
Như ta đã biết, học few-shot được thiết kế để cho phép mô hình nhanh chóng thích nghi với nhiệm vụ mới chỉ bằng vài ví dụ gán nhãn.
Tuy nhiên, việc thu thập các bộ dữ liệu lớn là không thực tế trong nhiều ứng dụng, như chẩn đoán bệnh hiếm hoặc nhận dạng sản phẩm ngách. Học few-shot giải quyết điều này bằng cách chuyển giao tri thức từ các nhiệm vụ liên quan và fine-tune mô hình để hoạt động tốt với lượng dữ liệu mới tối thiểu.
Dưới đây, chúng ta thảo luận hai chiến lược then chốt trong học few-shot.
Còn gọi là "học cách học", meta-learning liên quan đến việc huấn luyện một mô hình để thích nghi nhanh với nhiệm vụ mới với dữ liệu tối thiểu. Ý tưởng là huấn luyện mô hình trên nhiều nhiệm vụ để nó có thể khái quát hóa việc học và nhanh chóng điều chỉnh cho nhiệm vụ chưa từng thấy.
Các khuôn khổ meta-learning như MAML (Model-Agnostic Meta-Learning) cho phép mô hình học một tập tham số tối ưu có thể fine-tune cho nhiệm vụ mới chỉ với vài ví dụ.
Một cách tiếp cận phổ biến khác là mạng nguyên mẫu, được thiết kế để phân loại điểm dữ liệu bằng cách tính khoảng cách giữa chúng trong không gian đặc trưng đã học. Trong thiết lập này, mỗi lớp được biểu diễn bởi một nguyên mẫu (trung bình của các ví dụ thuộc lớp đó trong không gian đặc trưng).
Các điểm dữ liệu mới sau đó được phân loại dựa trên độ gần với các nguyên mẫu này. Mạng nguyên mẫu hiệu quả trong học few-shot vì chỉ cần số ví dụ tối thiểu cho mỗi lớp để tạo nguyên mẫu có ý nghĩa cho phân loại.
SSL cho phép mô hình trích xuất biểu diễn ý nghĩa từ lượng lớn dữ liệu không gán nhãn bằng cách tạo tín hiệu giám sát, bỏ qua nhu cầu nhãn thủ công. Khi mô hình đã học từ dữ liệu không gán nhãn, nó có thể được fine-tune trên một bộ dữ liệu gán nhãn nhỏ hơn, đạt hiệu suất mạnh trên các nhiệm vụ hạ nguồn.
Một trong những kỹ thuật SSL có tác động lớn là học tương phản (contrastive learning), huấn luyện mô hình bằng cách so sánh các cặp điểm dữ liệu dương và âm. Mục tiêu là kéo các điểm tương tự (cặp dương) lại gần nhau trong không gian đặc trưng, đồng thời đẩy các điểm không tương tự (cặp âm) ra xa.
Trong xử lý ngôn ngữ tự nhiên, một phương pháp SSL phổ biến là mô hình hóa ngôn ngữ che mặt (masked language modeling), được dùng trong các mô hình như BERT. Ở đây, một phần đầu vào bị che, và mô hình được huấn luyện để dự đoán phần bị thiếu dựa vào ngữ cảnh xung quanh. Chiến lược tiền huấn luyện này giúp mô hình học các biểu diễn bền vững, đa dụng có thể fine-tune cho nhiều nhiệm vụ NLP.
Học few-shot và học tự giám sát được dùng rộng rãi trong các lĩnh vực nơi hạn chế dữ liệu là rào cản lớn. Dưới đây là một vài ứng dụng chính của mỗi kỹ thuật.
Học few-shot tỏ ra giá trị trong phát hiện vật thể tùy biến, nơi việc nhận dạng các vật thể hiếm hoặc chuyên biệt có thể yêu cầu mô hình học chỉ từ một số ít ví dụ gán nhãn.
Trong bối cảnh công nghiệp, phát hiện lỗi trong quy trình sản xuất có thể chỉ có rất ít trường hợp lỗi. Bằng cách tận dụng học few-shot, một mô hình tiền huấn luyện trên nhiệm vụ phát hiện vật thể chung có thể nhanh chóng được điều chỉnh để phát hiện các vật thể cụ thể này với tối thiểu dữ liệu huấn luyện bổ sung.
Học tự giám sát đã cách mạng hóa xử lý ngôn ngữ tự nhiên thông qua các mô hình như GPT và BERT. Những mô hình này học các biểu diễn ngôn ngữ đa dụng có thể fine-tune cho nhiệm vụ cụ thể với bộ dữ liệu gán nhãn tương đối nhỏ. Ví dụ, một mô hình ngôn ngữ tiền huấn luyện bằng SSL có thể được fine-tune để thực hiện các nhiệm vụ như phân tích cảm xúc, phân loại văn bản hoặc tóm tắt, thường đạt kết quả hàng đầu.
Các thư viện và khung học máy có thể đơn giản hóa đáng kể việc triển khai các phương pháp học chuyển giao nâng cao. Các công cụ như PyTorch, TensorFlow và Hugging Face Transformers cung cấp sự linh hoạt và các thành phần dựng sẵn cần thiết để tăng tốc quá trình phát triển.
Đối với người thực hành muốn triển khai các kỹ thuật học chuyển giao nâng cao, nhiều thư viện và khung cung cấp hỗ trợ phong phú:
Triển khai các kỹ thuật học chuyển giao nâng cao là thách thức, và có một số yếu tố then chốt cần ghi nhớ.
Fine-tune trên nhiệm vụ mới có thể khiến mô hình "quên" những gì đã học từ các nhiệm vụ trước. Các kỹ thuật như Elastic Weight Consolidation (EWC) có thể giúp bảo toàn trọng số của mô hình tiền huấn luyện, điều then chốt cho tri thức sẵn có.
Các kỹ thuật như thích nghi miền và học đa nhiệm có thể làm tăng đáng kể yêu cầu tính toán. Huấn luyện các mô hình thích nghi miền đối kháng hoặc kiến trúc đa nhiệm có thể cần nhiều tài nguyên do độ phức tạp bổ sung. Cần tối ưu hóa mô hình và sử dụng các công cụ như huấn luyện độ chính xác hỗn hợp (mixed precision) để xử lý hiệu quả các mô hình lớn.
Các mô hình học chuyển giao được tiền huấn luyện trên dữ liệu thiên lệch có thể duy trì hoặc thậm chí khuếch đại các thiên lệch này ở nhiệm vụ mới, dẫn đến dự đoán lệch lạc. Rủi ro này rất nghiêm trọng trong các lĩnh vực nhạy cảm như y tế và tài chính. Để đảm bảo công bằng, chúng ta nên thường xuyên đánh giá đầu ra mô hình về thiên lệch và áp dụng các kỹ thuật giảm thiểu như tái trọng số, khử thiên lệch đối kháng hoặc học biểu diễn công bằng.
Các phương pháp học chuyển giao nâng cao đang được áp dụng trên nhiều ngành, mang lại giải pháp sáng tạo cho những thách thức thực tế phức tạp. Dưới đây là một số ứng dụng và ví dụ nổi bật minh họa cách các kỹ thuật này thúc đẩy tiến bộ AI.
Mô hình GPT-4o của OpenAI, một ví dụ hàng đầu về few-shot learning trong thực tế, đã thể hiện khả năng thích nghi với nhiệm vụ mới chỉ bằng vài ví dụ. GPT-4o, được tiền huấn luyện trên lượng lớn dữ liệu văn bản, có thể thực hiện nhiều nhiệm vụ như dịch thuật, tóm tắt và hỏi đáp mà không cần fine-tune chuyên biệt theo từng nhiệm vụ.
Thay vào đó, người dùng cung cấp một vài ví dụ về nhiệm vụ mong muốn, và mô hình khái quát từ đó. Năng lực few-shot này đã mở rộng phạm vi ứng dụng của các mô hình ngôn ngữ lớn, từ sáng tác nội dung đến trợ lý hội thoại.
DeepMind, đơn vị dẫn đầu nghiên cứu AI, đã sử dụng học đa nhiệm để phát triển các mô hình y tế hỗ trợ chẩn đoán nhiều tình trạng bệnh từ ảnh y khoa. Chẳng hạn, hệ thống AI của họ để phát hiện bệnh về mắt từ ảnh võng mạc có thể chẩn đoán nhiều tình trạng, bao gồm bệnh võng mạc do tiểu đường và thoái hóa điểm vàng do tuổi tác, chỉ với một mô hình.
Cách tiếp cận MTL này giảm nhu cầu xây dựng mô hình riêng cho từng bệnh, cho phép các nhà cung cấp dịch vụ y tế tinh gọn quy trình chẩn đoán và cung cấp chăm sóc bệnh nhân nhanh hơn, chính xác hơn.
Waymo (dự án xe tự lái của Google) sử dụng các kỹ thuật thích nghi miền để cải thiện khả năng khái quát hóa của mô hình xe tự hành trên nhiều môi trường lái xe khác nhau. Công ty huấn luyện mô hình trong môi trường mô phỏng rồi điều chỉnh cho triển khai thực tế ở các thành phố và điều kiện thời tiết khác nhau.
Quy trình này đảm bảo xe tự lái có thể xử lý các sắc thái của những cảnh quan đô thị khác nhau, từ đường phố đông đúc ở San Francisco đến các xa lộ rộng ở Arizona, mà không cần huấn luyện lại quá nhiều cho từng địa điểm.
Các nhà nghiên cứu không ngừng mở rộng giới hạn, nỗ lực khiến mô hình thích nghi hơn, công bằng hơn và có khả năng xử lý các nhiệm vụ thực tế phức tạp, đồng thời giảm lượng dữ liệu và thời gian huấn luyện cần thiết.
Học liên tục hay học suốt đời tập trung phát triển các mô hình có thể liên tục học từ dữ liệu mới trong khi vẫn giữ tri thức từ nhiệm vụ đã học trước đó. Trái với học chuyển giao truyền thống, nơi mô hình tĩnh sau khi fine-tune, học liên tục cho phép thích nghi liên tục với thông tin mới.
Điều này rất quan trọng cho môi trường năng động, như robot và hệ thống tự hành, nơi các kịch bản mới chắc chắn sẽ xuất hiện thường xuyên. Trong bối cảnh này, các chiến lược dựa trên bộ nhớ giúp cân bằng giữa việc bảo tồn tri thức cũ và tiếp thu kỹ năng mới. Các phát triển tương lai hướng tới mở rộng học liên tục sang những miền phức tạp hơn, đảm bảo mô hình có thể cập nhật hiệu quả mà không làm ảnh hưởng hiệu suất trước đó.
Khi học chuyển giao trở nên phổ biến trong các ngành như y tế, tài chính và thực thi pháp luật, nhu cầu giải quyết vấn đề công bằng và thiên lệch là điều không thể bỏ qua.
Các mô hình tiền huấn luyện trên bộ dữ liệu lớn, đa dạng thường mang sẵn thiên lệch, có thể dẫn đến kết quả lệch lạc trong ứng dụng mới. Để đối phó, các nhà nghiên cứu đang khám phá những kỹ thuật như khử thiên lệch đối kháng, tái trọng số và học biểu diễn công bằng để phát hiện và giảm thiểu các thiên lệch này.
Đảm bảo công bằng sẽ vẫn là trọng tâm trong nghiên cứu học chuyển giao, đặc biệt ở các lĩnh vực nhạy cảm nơi dự đoán thiên lệch có thể gây hệ lụy thực tế.
Học AI với những khóa học này!
Lộ trình
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
