
Tipi di tecniche avanzate di transfer learning
Gli approcci tradizionali, come il pre-addestramento su un grande dataset seguito dal fine-tuning su un dataset specifico per il compito, sono fondamentali ma talvolta insufficienti. Sono emersi metodi più avanzati per affrontare le sfumature dei domain shift, della scarsità di dati e del multi-task learning.
I metodi avanzati introducono ulteriori livelli di complessità e flessibilità. Queste tecniche puntano a migliorare le prestazioni del modello in scenari in cui gli approcci tradizionali potrebbero non essere adeguati.
Adattamento di dominio
Le tecniche di adattamento di dominio sono progettate per gestire le discrepanze tra i domini di origine (pre-addestramento) e di destinazione (fine-tuning). Il fine-tuning tradizionale spesso produce risultati subottimali quando i modelli pre-addestrati incontrano dati che divergono significativamente dai dati su cui sono stati addestrati. Le tecniche di adattamento di dominio riducono questo disallineamento allineando le distribuzioni dei dati, consentendo al modello di generalizzare meglio in contesti nuovi.
Multi-task learning (MTL)
L’MTL consente a un modello di apprendere contemporaneamente su più compiti correlati. Condividendo la conoscenza tra i compiti, il modello può sfruttare le comunilità e migliorare le prestazioni su tutti i compiti. Questa strategia è particolarmente efficace quando i compiti sono complementari, come l’apprendimento congiunto di classificazione del testo e analisi del sentiment nell’elaborazione del linguaggio naturale. L’MTL migliora la generalizzazione e riduce il rischio di overfitting guidando il modello a concentrarsi su schemi condivisi.
Few-shot learning
Un’altra tecnica chiave è il few-shot learning, progettata per addestrare modelli con dati etichettati minimi. Mentre gli approcci tradizionali richiedono grandi quantità di dati etichettati, le tecniche few-shot consentono ai modelli di trasferire conoscenza usando solo pochi esempi. Metodi come il meta-learning e le prototypical networks portano a un rapido adattamento a nuovi compiti, rendendoli preziosi in ambiti come raccomandazioni personalizzate o classificazioni di immagini di nicchia.
Self-supervised learning (SSL)
L’SSL utilizza dati non etichettati per addestrare i modelli, affermandosi come uno strumento potente quando i dati etichettati sono scarsi o assenti. Questa tecnica costruisce segnali di supervisione a partire dai dati stessi, risolvendo compiti pretest come prevedere parti mancanti di un’immagine o ricostruire testo rimescolato. I modelli pre-addestrati con SSL hanno dimostrato un’elevata trasferibilità in un’ampia gamma di applicazioni.
Zero-shot learning
Lo zero-shot learning fa un ulteriore passo avanti, consentendo ai modelli di gestire compiti completamente nuovi senza alcun dato etichettato. Ciò è ottenuto tramite informazioni ausiliarie come relazioni semantiche o descrizioni dei compiti, permettendo al modello di generalizzare anche di fronte a categorie inedite. Questa capacità è molto rilevante in campi dinamici dove emergono frequentemente nuove categorie, ad esempio nelle applicazioni NLP che gestiscono neologismi o slang.
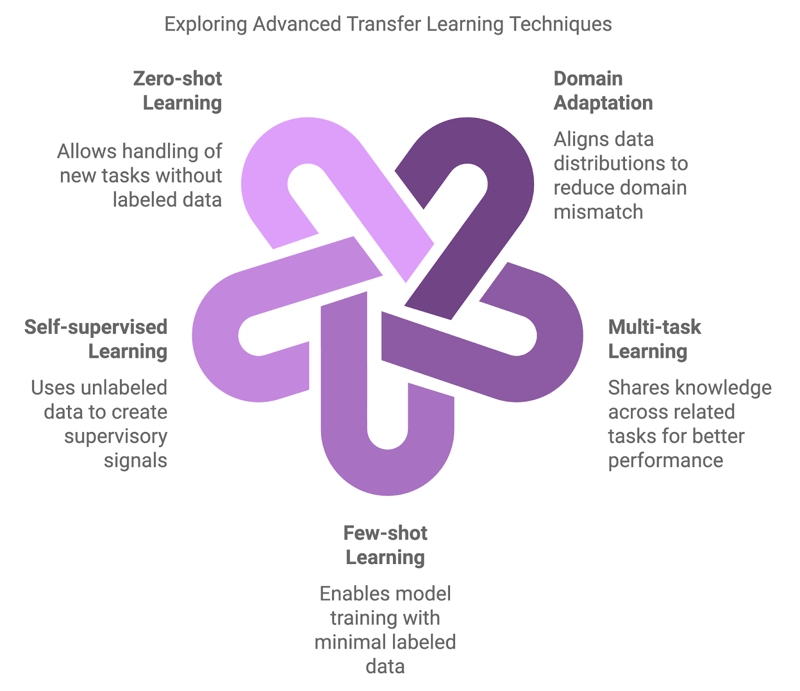
Diagramma generato con napkin.ai
Tecniche di adattamento di dominio
Come accennato in precedenza, l’adattamento di dominio è un sottoinsieme del transfer learning focalizzato sulla gestione di situazioni in cui c’è una differenza significativa, o “domain shift”, tra i dati usati per addestrare un modello e i dati in cui il modello viene impiegato.
Nel transfer learning tipico si assume che i domini di origine e destinazione condividano caratteristiche simili, ma in molti scenari reali questi domini differiscono in modo sostanziale. Questo può degradare le prestazioni, poiché i modelli addestrati su un set di dati faticano a generalizzare a nuove condizioni.
Le tecniche di adattamento di dominio sono pensate per colmare questo divario, consentendo a un modello addestrato in un dominio di funzionare efficacemente in un altro minimizzando la discrepanza tra le distribuzioni dei dati di origine e di destinazione. Di conseguenza, l’adattamento di dominio è ancora più prezioso quando i dati etichettati sono abbondanti in un dominio ma scarsi o assenti in un altro.
Sono state sviluppate diverse tecniche per affrontare la sfida dell’adattamento di dominio: due degli approcci più comuni sono i metodi avversari e l’apprendimento di caratteristiche invarianti al dominio.
Adattamento di dominio avversario
Una tecnica ampiamente usata per l’adattamento di dominio prevede l’apprendimento avversario. In questo contesto, un modello è addestrato a imparare caratteristiche utili per il compito target assicurando al contempo che queste caratteristiche siano indistinguibili tra i domini di origine e di destinazione.
Possiamo ottenere ciò usando un discriminatore, ovvero una rete neurale incaricata di distinguere tra dati dei domini di origine e di destinazione. Il modello è addestrato in modo avversario così da “ingannare” il discriminatore, rendendo le rappresentazioni delle caratteristiche invarianti al dominio. Se questo suona familiare è perché la tecnica è ispirata alle Generative Adversarial Networks (GAN), che usano un impianto simile per generare dati sintetici realistici.
Apprendimento di caratteristiche invarianti al dominio
Un altro approccio si concentra sull’apprendimento di rappresentazioni non influenzate da variazioni specifiche del dominio. Questo trasforma i dati in ingresso di entrambi i domini in uno spazio di caratteristiche condiviso dove i domini di origine e destinazione risultano maggiormente allineati. Tecniche come Maximum Mean Discrepancy (MMD) e CORAL (Correlation Alignment) aiutano a minimizzare le differenze statistiche in questo spazio, garantendo una generalizzazione più efficace quando il modello viene applicato al dominio target.
Casi d’uso
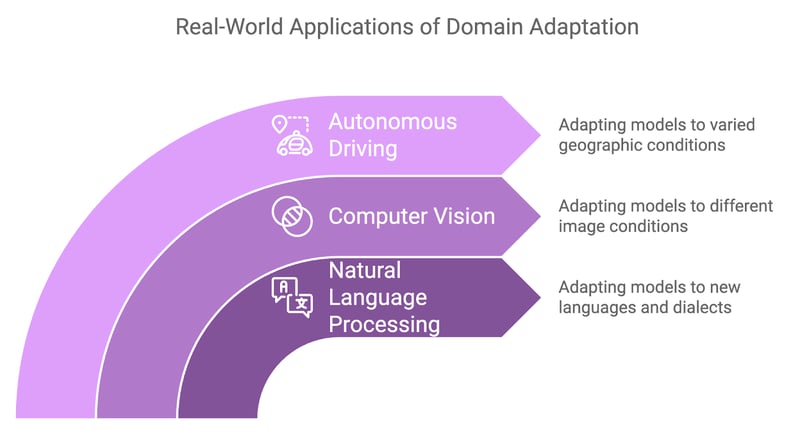
L’adattamento di dominio si è rivelato utile in diverse applicazioni reali in cui i domain shift sono inevitabili:
- L’adattamento di dominio è spesso applicato nell’NLP quando si trasferiscono modelli addestrati in una lingua o dialetto a un’altra.
- Ad esempio, un modello di analisi del sentiment addestrato in inglese potrebbe dover essere adattato per funzionare con un dialetto regionale della stessa lingua, oppure un modello addestrato su testo formale potrebbe dover essere adattato a linguaggio informale e colloquiale, ad es. dati dei social media.
- Nella visione artificiale, l’adattamento di dominio è spesso usato quando ci sono differenze nelle caratteristiche delle immagini tra i dati di addestramento e quelli target.
- Per esempio, un modello addestrato su immagini di oggetti in condizioni di luce naturale potrebbe dover essere adattato per funzionare in condizioni di luce scarsa o artificiale.
- I sistemi di guida autonoma richiedono prestazioni solide a prescindere dalle regioni geografiche incontrate, e anche qui l’adattamento di dominio è molto utile.
- Un modello addestrato a riconoscere segnali stradali, pedoni o veicoli in un paese potrebbe dover adattarsi a condizioni stradali, meteo o persino regole del traffico leggermente diverse in un’altra regione.
Sinergia tra multi-task learning e transfer learning
Con l’aumentare della complessità dei compiti di machine learning, la capacità di affrontare simultaneamente più problemi correlati può migliorare significativamente le prestazioni e l’efficienza di un modello. L’MTL risponde a questa esigenza addestrando i modelli a svolgere più compiti alla volta, invece di concentrarsi su un singolo compito isolato.
Che cos’è il multi-task learning?
La forza dell’MTL risiede nella capacità di sfruttare le relazioni e le strutture condivise tra compiti, permettendo ai modelli di apprendere rappresentazioni di caratteristiche più ricche. Le intuizioni acquisite da un compito migliorano le prestazioni del modello su un altro, portando a una maggiore efficienza complessiva dell’apprendimento.
Nell’MTL, si utilizzano comunemente due strategie principali:
- Hard parameter sharing: con questo approccio, il modello condivide la maggior parte dei parametri tra i compiti, con solo strati specifici per compito indipendenti. Ciò riduce l’overfitting spingendo il modello a imparare rappresentazioni che generalizzano bene tra compiti.
- Soft parameter sharing: qui ogni compito ha il proprio set di parametri, ma una qualche forma di regolarizzazione assicura che questi parametri siano simili, favorendo l’apprendimento condiviso senza una completa sovrapposizione dei parametri.
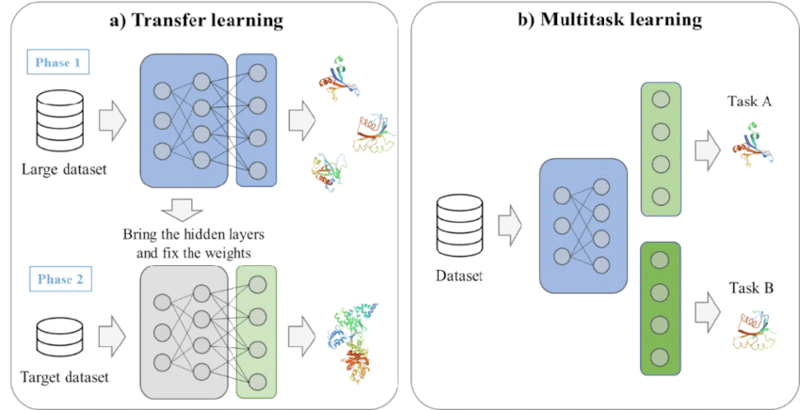
Un esempio di transfer learning e multitask learning. Fonte: Kim et al., 2021
Vantaggi del multi-task learning
L’MTL offre diversi vantaggi che lo rendono un approccio prezioso per scenari di machine learning complessi.
Migliore generalizzazione
Imparando su più compiti, il modello è esposto a una gamma più ampia di dati e apprende rappresentazioni più generali. Questo spesso porta a prestazioni migliori su ciascun compito, soprattutto quando i compiti sono correlati.
Efficienza dei dati
Con l’MTL, i modelli sfruttano meglio i dati disponibili, specialmente quando i dati etichettati sono scarsi. Poiché il modello apprende da più compiti, può utilizzare le intuizioni dei compiti correlati per migliorare le prestazioni. Questo apprendimento inter-compito accelera il processo e riduce la dipendenza da grandi dataset per ogni singolo compito.
Efficienza del modello
Invece di addestrare modelli separati per ogni compito, l’MTL consolida l’apprendimento in un unico modello. Ciò riduce il costo computazionale e l’occupazione di memoria, rendendolo più efficiente per la distribuzione in ambienti con risorse limitate.
Applicazioni del multi-task learning
L’MTL è stato applicato con successo in vari domini, con casi d’uso notevoli in NLP e visione artificiale.
Elaborazione del linguaggio naturale
Nell’elaborazione del linguaggio naturale, l’MTL è comunemente usato per addestrare modelli su più compiti correlati. Ad esempio, un modello linguistico può essere addestrato per svolgere contemporaneamente traduzione automatica e classificazione del testo. Condividendo le rappresentazioni apprese tra questi compiti, il modello può migliorare la comprensione della struttura e del contesto linguistico, a beneficio di entrambi i compiti.
Visione artificiale
Nella visione artificiale, l’MTL può essere applicato a compiti come il rilevamento di oggetti e la segmentazione di immagini. Possiamo addestrare un modello a identificare gli oggetti all’interno di un’immagine imparando contemporaneamente anche a classificare quegli oggetti. Questo processo di apprendimento condiviso consente al modello di riconoscere sia la posizione che la categoria degli oggetti, rendendolo più versatile ed efficiente.
Few-shot e self-supervised learning
In scenari in cui i dati etichettati sono scarsi o assenti, il few-shot learning e l’SSL sono emersi come tecniche potenti per superare i limiti dei metodi supervisionati tradizionali.
Questi approcci offrono modi innovativi per adattare i modelli a nuovi compiti con dati etichettati minimi o utilizzando grandi quantità di dati non etichettati, rendendoli strumenti essenziali nell’ambito del transfer learning avanzato.
Few-shot learning
Come ormai sappiamo, il few-shot learning è progettato per consentire ai modelli di adattarsi rapidamente a nuovi compiti con solo pochi esempi etichettati.
Tuttavia, raccogliere grandi dataset è impraticabile in molte applicazioni, come la diagnosi di malattie rare o l’identificazione di prodotti di nicchia. Il few-shot learning risolve questo problema trasferendo conoscenza da compiti correlati e mettendo a punto i modelli per ottenere buone prestazioni con dati nuovi minimi.
Di seguito, analizziamo due strategie chiave nel few-shot learning.
Meta-learning
Conosciuto anche come “imparare a imparare”, il meta-learning consiste nell’addestrare un modello ad adattarsi rapidamente a nuovi compiti con dati minimi. L’idea è addestrare il modello su una varietà di compiti affinché possa generalizzare l’apprendimento e adattarsi rapidamente a compiti mai visti.
Framework di meta-learning come Model-Agnostic Meta-Learning (MAML) consentono al modello di apprendere un insieme ottimale di parametri che può essere perfezionato su nuovi compiti con solo pochi esempi.
Prototypical networks
Un altro approccio comune sono le prototypical networks, progettate per classificare i punti dati calcolando le distanze tra di essi in uno spazio di caratteristiche appreso. In questo impianto, ogni classe è rappresentata da un prototipo (la media degli esempi di quella classe nello spazio delle caratteristiche).
I nuovi punti dati vengono poi classificati in base alla loro vicinanza a questi prototipi. Le prototypical networks possono essere efficaci nel few-shot learning poiché richiedono solo un numero minimo di esempi per classe per generare prototipi significativi per la classificazione.
Self-supervised learning
L’SSL consente ai modelli di estrarre rappresentazioni significative da grandi quantità di dati non etichettati generando segnali di supervisione, aggirando la necessità di etichette manuali. Una volta che il modello ha imparato dai dati non etichettati, può essere poi perfezionato su un piccolo dataset etichettato, ottenendo prestazioni elevate sui compiti downstream.
Una delle tecniche SSL più incisive è il contrastive learning, che addestra i modelli confrontando coppie positive e negative di punti dati. L’obiettivo è avvicinare nello spazio delle caratteristiche i punti dati simili (coppie positive) e allontanare quelli dissimili (coppie negative).
Nel natural language processing, un metodo SSL popolare è il masked language modeling, usato in modelli come BERT. Qui parti dell’input vengono oscurate e il modello è addestrato a prevedere gli elementi mancanti usando il contesto circostante. Questa strategia di pre-addestramento aiuta il modello a imparare rappresentazioni robuste e generali che possono essere perfezionate per vari compiti di NLP.
Applicazioni
Il few-shot e il self-supervised learning sono ampiamente utilizzati in campi in cui le limitazioni dei dati rappresentano una barriera significativa. Ecco alcune applicazioni chiave di ciascuno.
Few-shot learning nel rilevamento di oggetti personalizzati
Il few-shot learning è prezioso nel rilevamento di oggetti personalizzati, dove l’identificazione di oggetti rari o specializzati può richiedere che i modelli apprendano da solo una manciata di esempi etichettati.
In contesti industriali, rilevare difetti in un processo produttivo può coinvolgere pochissimi casi del difetto. Sfruttando il few-shot learning, un modello pre-addestrato su compiti generali di object detection può essere rapidamente adattato per rilevare questi oggetti specifici con dati di addestramento aggiuntivi minimi.
Self-supervised learning nei LM
Il self-supervised learning ha rivoluzionato l’elaborazione del linguaggio naturale con modelli come GPT e BERT. Questi modelli apprendono rappresentazioni linguistiche generali che possono essere perfezionate per compiti specifici con dataset etichettati relativamente piccoli. Ad esempio, un modello linguistico pre-addestrato tramite SSL può essere perfezionato per svolgere compiti come analisi del sentiment, classificazione del testo o sintesi, spesso raggiungendo risultati allo stato dell’arte.
Implementazione pratica delle tecniche avanzate di transfer learning
Librerie e framework di machine learning possono semplificare significativamente l’implementazione di metodi avanzati di transfer learning. Strumenti come PyTorch, TensorFlow e Hugging Face Transformers offrono la flessibilità e i componenti predefiniti necessari per accelerare lo sviluppo.
Framework e strumenti
Per chi vuole implementare tecniche avanzate di transfer learning, diverse librerie e framework forniscono un ampio supporto:
- PyTorch: un framework flessibile e intuitivo, ampiamente usato per ricerca e progetti pratici di machine learning. Il grafo computazionale dinamico di PyTorch è ideale per compiti come meta-learning e multi-task learning.
- TensorFlow: un altro popolare framework di deep learning, TensorFlow offre un solido supporto per il transfer learning e l’adattamento di dominio tramite la sua API di alto livello, Keras. tensorflow_hub di TensorFlow fornisce inoltre modelli pre-addestrati che possono essere perfezionati per nuovi compiti.
- Hugging Face Transformers: una libreria ideale per compiti di elaborazione del linguaggio naturale, offre vari modelli pre-addestrati come BERT, GPT e T5 che possono essere perfezionati per compiti downstream specifici con il minimo sforzo.
Sfide e considerazioni
Implementare tecniche avanzate di transfer learning è impegnativo e ci sono fattori critici da tenere a mente.
Catastrophic forgetting
Il fine-tuning su nuovi compiti può portare i modelli a “dimenticare” quanto appreso in precedenza. Tecniche come Elastic Weight Consolidation (EWC) possono aiutare a preservare i pesi del modello pre-addestrato, cruciali per la conoscenza pregressa.
Gestione della complessità computazionale
Tecniche come l’adattamento di dominio e il multi-task learning possono aumentare significativamente i requisiti computazionali. Addestrare modelli di adattamento di dominio avversario o architetture multi-task può richiedere più risorse a causa della complessità aggiuntiva. Dobbiamo ottimizzare il nostro modello e utilizzare strumenti come il mixed precision training per gestire in modo efficiente modelli di grandi dimensioni.
Garantire equità e mitigazione dei bias
I modelli di transfer learning pre-addestrati su dati distorti possono propagare o addirittura amplificare questi bias in nuovi compiti, portando a previsioni alterate. Questo rischio è critico in settori sensibili come sanità e finanza. Per garantire equità, dovremmo valutare regolarmente le uscite del modello alla ricerca di bias e applicare tecniche di mitigazione come reweighting, debiasing avversario o fair representation learning.
Esempi dal settore
I metodi avanzati di transfer learning vengono applicati in vari settori, offrendo soluzioni innovative a complesse sfide reali. Di seguito alcuni esempi e applicazioni che mostrano come queste tecniche stiano spingendo in avanti l’AI.
OpenAI: modelli GPT con few-shot learning
Il modello GPT-4o di OpenAI, un esempio di punta di few-shot learning in azione, ha dimostrato la capacità di adattarsi a nuovi compiti con solo pochi esempi. GPT-4o, pre-addestrato su enormi quantità di dati testuali, può svolgere vari compiti come traduzione, sintesi e question answering senza bisogno di fine-tuning specifico per il compito.
Invece, gli utenti forniscono pochi esempi del compito desiderato e il modello generalizza a partire da lì. Questa capacità di few-shot learning ha ampliato il ventaglio di applicazioni dei large language model, dalla scrittura creativa agli agenti conversazionali.
DeepMind: multi-task learning nell’AI per la sanità
DeepMind, leader nella ricerca AI, ha utilizzato il multi-task learning per sviluppare modelli sanitari in grado di assistere nella diagnosi di più condizioni a partire da immagini mediche. Ad esempio, il loro sistema di AI per rilevare malattie oculari da scansioni retiniche è in grado di diagnosticare diverse condizioni, tra cui retinopatia diabetica e degenerazione maculare legata all’età, usando un unico modello.
Questo approccio MTL riduce la necessità di modelli separati per ciascuna condizione, consentendo ai professionisti sanitari di snellire i processi diagnostici e fornire cure più rapide e accurate.
Waymo: adattamento di dominio nella guida autonoma
Waymo (il progetto di auto a guida autonoma di Google) utilizza tecniche di adattamento di dominio per migliorare la generalizzazione dei suoi modelli di veicoli autonomi in vari ambienti di guida. L’azienda addestra i propri modelli in ambienti simulati e poi li adatta per l’uso reale in diverse città e condizioni meteo.
Questo processo assicura che le auto a guida autonoma possano gestire le peculiarità di diversi paesaggi urbani, dalle strade congestionate di San Francisco alle autostrade ampie dell’Arizona, senza richiedere un ampio riaddestramento per ogni località.
Tendenze future nel transfer learning avanzato
I ricercatori spingono costantemente i confini, cercando di rendere i modelli più adattabili, equi e capaci di gestire compiti reali complessi riducendo al contempo la quantità di dati e il tempo di addestramento richiesti.
Apprendimento continuo
L’apprendimento continuo o lifelong learning si concentra sullo sviluppo di modelli che possono apprendere continuamente da nuovi dati mantenendo la conoscenza dei compiti precedentemente appresi. A differenza del transfer learning tradizionale, in cui i modelli sono statici una volta effettuato il fine-tuning, l’apprendimento continuo consente un adattamento costante a nuove informazioni.
Questo è vitale per ambienti dinamici, come robotica e sistemi autonomi, dove nuovi scenari emergono regolarmente. In questo contesto, strategie basate sulla memoria aiutano a bilanciare l’esigenza di preservare la conoscenza passata mentre si incorporano nuove abilità. Gli sviluppi futuri puntano a estendere l’apprendimento continuo a domini più complessi, assicurando che i modelli possano aggiornarsi in modo efficiente senza compromettere le prestazioni precedenti.
Equità e mitigazione dei bias
Man mano che il transfer learning diventa più diffuso in settori come sanità, finanza e forze dell’ordine, l’esigenza di affrontare equità e bias è impossibile da ignorare.
I modelli pre-addestrati su grandi dataset diversificati spesso portano con sé bias intrinseci, che possono condurre a risultati distorti nelle nuove applicazioni. Per contrastare ciò, i ricercatori stanno esplorando tecniche come debiasing avversario, reweighting e fair representation learning per individuare e mitigare questi bias.
Garantire l’equità rimarrà un tema centrale nella ricerca sul transfer learning, specialmente in domini sensibili dove previsioni distorte possono avere implicazioni reali.
Transfer learning ibrido
Il transfer learning ibrido combina metodi supervisionati, non supervisionati e self-supervised per sfruttare i punti di forza di ciascuno. I modelli vengono in genere pre-addestrati con approcci non supervisionati o self-supervised per apprendere rappresentazioni generali e poi perfezionati con dati etichettati per compiti specifici.
Questa strategia ibrida migliora la trasferibilità e riduce la dipendenza da grandi dataset etichettati, risultando particolarmente utile in settori con dati annotati limitati, come la diagnosi di malattie rare o applicazioni industriali specializzate.
Reinforcement learning nel transfer learning
Il transfer learning sta facendo progressi anche nel reinforcement learning (RL), dove agenti addestrati in un ambiente vengono adattati per l’uso in contesti correlati. Questo riduce il tempo e i dati necessari perché gli agenti padroneggino nuovi compiti, migliorando l’efficienza nel risolvere problemi complessi e multi-step.
Per esempio, un agente RL addestrato a navigare in un certo tipo di sistema robotico può applicare la propria conoscenza a un setup nuovo ma simile con un riaddestramento minimo, aumentando notevolmente versatilità e scalabilità dei sistemi RL.
Conclusione
In questo articolo abbiamo esplorato tecniche avanzate di transfer learning. Abbiamo esaminato l’adattamento di dominio per gestire le differenze di distribuzione dei dati, il multi-task learning per sfruttare la conoscenza condivisa e il few-shot e il self-supervised learning per scenari con dati etichettati limitati.
Queste tecniche offrono strategie efficaci per affrontare le sfide e migliorare le prestazioni dei modelli. Con l’avanzare dell’AI, familiarizzare con queste tecniche sarà essenziale per restare competitivi.

Neolaureato magistrale specializzato in Intelligenza Artificiale





Il transfer learning è diventato molto importante nel machine learning, dove modelli pre-addestrati vengono adattati a nuovi compiti correlati per risparmiare tempo e risorse. Questa strategia è molto efficace in ambiti come la visione artificiale, l’elaborazione del linguaggio naturale e il riconoscimento vocale, dove sono disponibili grandi quantità di dati pre-addestrati.
Nonostante la sua popolarità, il fine-tuning, un approccio comune nel transfer learning, incontra spesso ostacoli come overfitting o disallineamenti tra il dominio del modello pre-addestrato e i dati target, un fenomeno noto come domain shift. Il transfer learning di base può faticare con compiti complessi o dati limitati, portando a un adattamento inadeguato.
Per superare queste sfide, è emersa una nuova ondata di tecniche avanzate di transfer learning, in grado di affrontare discrepanze di dominio, scarsità di dati e l’esigenza di un adattamento efficiente dei modelli. In questo articolo esplorerò alcune di queste strategie di transfer learning avanzato.