
Soorten geavanceerde transfer learning-technieken
Traditionele benaderingen, zoals pre-training op een grote dataset en vervolgens fine-tuning op een taakspecifieke dataset, zijn fundamenteel maar soms onvoldoende. Meer geavanceerde methoden zijn ontstaan om de nuances van domeinverschuivingen, dataschaarste en multi-task learning aan te pakken.
Geavanceerde methoden voegen extra lagen van complexiteit en flexibiliteit toe. Deze technieken zijn gericht op het verbeteren van de modelprestaties in scenario’s waar traditionele benaderingen mogelijk niet toereikend zijn.
Domeinaanpassing
Technieken voor domeinaanpassing zijn ontworpen om discrepanties tussen de bron- (pre-training) en doel- (fine-tuning) domeinen aan te pakken. Traditionele fine-tuning levert vaak suboptimale resultaten op wanneer voorgetrainde modellen data tegenkomen die sterk afwijkt van hun trainingsdata. Domeinaanpassingstechnieken verminderen deze mismatch door datadistributies op elkaar af te stemmen, zodat het model beter kan generaliseren in nieuwe omgevingen.
Multi-task learning (MTL)
MTL stelt een model in staat om meerdere verwante taken tegelijk te leren. Door kennis tussen taken te delen, kan het model overeenkomsten benutten en de prestaties over alle taken verbeteren. Deze strategie is vooral effectief wanneer taken complementair zijn, zoals gezamenlijk leren van tekstclassificatie en sentimentanalyse in natural language processing. MTL verbetert de generalisatie en verkleint het risico op overfitting door het model te sturen naar gedeelde patronen.
Few-shot learning
Een andere sleuteltechniek is few-shot learning, ontworpen om modellen te trainen met minimale gelabelde data. Terwijl traditionele aanpakken enorme hoeveelheden gelabelde data vereisen, stellen few-shot-technieken modellen in staat kennis over te dragen met slechts enkele voorbeelden. Methoden zoals meta-learning en prototypische netwerken zorgen voor snelle adaptatie aan nieuwe taken, wat ze onmisbaar maakt in domeinen als gepersonaliseerde aanbevelingen of niche-beeldclassificaties.
Self-supervised learning (SSL)
SSL gebruikt ongelabelde data om modellen te trainen en is daarmee een krachtig hulpmiddel wanneer gelabelde data schaars of niet beschikbaar is. Deze techniek construeert supervisiesignalen vanuit de data zelf door pretext-taken op te lossen, zoals het voorspellen van ontbrekende delen van een afbeelding of het reconstrueren van verhusselde tekst. Modellen die met SSL zijn voorgetraind, hebben een hoge overdraagbaarheid getoond over uiteenlopende toepassingen.
Zero-shot learning
Zero-shot learning gaat een stap verder door modellen in staat te stellen volledig nieuwe taken aan te kunnen zonder enige gelabelde data. Dit wordt bereikt via aanvullende informatie zoals semantische relaties of taakbeschrijvingen, waardoor het model kan generaliseren, zelfs bij nieuwe categorieën. Deze vaardigheid is zeer relevant in dynamische velden waar vaak nieuwe categorieën ontstaan, zoals in NLP-toepassingen die nieuwe termen of slang verwerken.
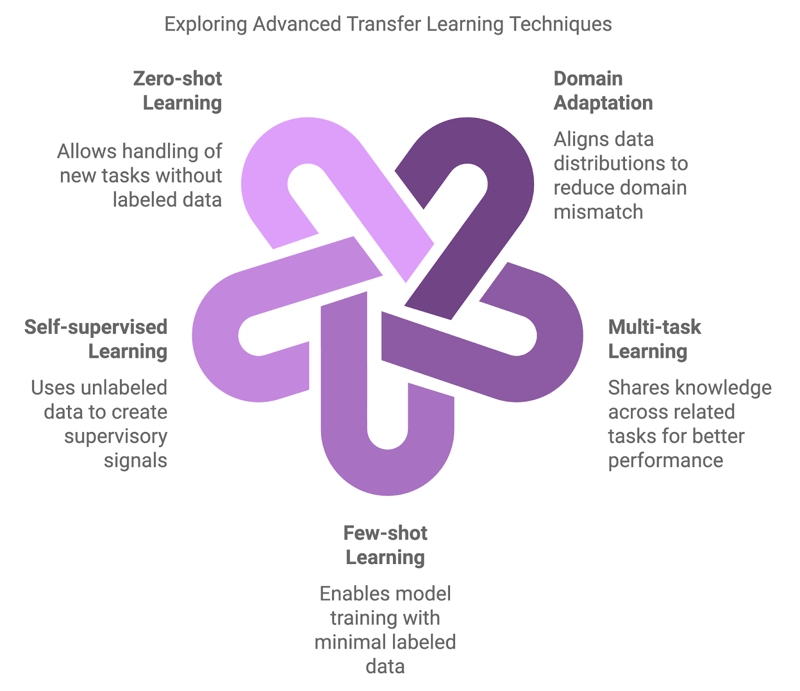
Diagram gegenereerd met napkin.ai
Technieken voor domeinaanpassing
Zoals eerder kort besproken is domeinaanpassing een subveld van transfer learning dat zich richt op situaties met een significant verschil, ofwel "domeinverschuiving", tussen de data waarop een model is getraind en de data waarop het model wordt ingezet.
Bij typische transfer learning wordt aangenomen dat bron- en doeldomein vergelijkbare kenmerken delen, maar in veel realistische scenario’s wijken deze domeinen sterk af. Uiteindelijk kan dit de prestaties aantasten, omdat modellen die op één dataset zijn getraind moeite hebben om te generaliseren naar nieuwe omstandigheden.
Domeinaanpassingstechnieken zijn ontwikkeld om deze kloof te overbruggen, zodat een in het ene domein getraind model effectief kan presteren in een ander domein door de discrepantie tussen bron- en doeldistributies te minimaliseren. Daardoor is domeinaanpassing extra waardevol wanneer gelabelde data overvloedig is in het ene domein maar schaars of afwezig in een ander.
Er zijn verschillende technieken ontwikkeld om de uitdaging van domeinaanpassing aan te pakken—twee van de meest voorkomende benaderingen zijn adversariële methoden en domeinonafhankelijke feature learning.
Adversariële domeinaanpassing
Een veelgebruikte techniek voor domeinaanpassing betreft adversarial learning. In deze context wordt een model getraind om features te leren die nuttig zijn voor de doeltaak en tegelijkertijd ervoor te zorgen dat deze features ononderscheidbaar zijn tussen bron- en doeldomeinen.
Dit kunnen we bereiken met een discriminator, i.e. een neuraal netwerk dat tot taak heeft bron- van doeldomeindata te onderscheiden. Het model wordt adversarieel getraind zodat het leert de discriminator te "misleiden", waardoor de featurerepresentaties domeinonafhankelijk worden. Als dit bekend klinkt, komt dat doordat deze techniek is geïnspireerd op Generative Adversarial Networks (GANs), die een vergelijkbare opzet gebruiken om realistische synthetische data te genereren.
Domeinonafhankelijk feature learning
Een andere benadering richt zich op het leren van representaties die niet worden beïnvloed door domeinspecifieke variaties. Dit transformeert inputdata uit beide domeinen naar een gedeelde featurespace waar bron en doel beter op elkaar aansluiten. Technieken zoals Maximum Mean Discrepancy (MMD) en CORAL (Correlation Alignment) helpen statistische verschillen in deze ruimte te minimaliseren, zodat het model effectiever kan generaliseren bij toepassing in het doeldomein.
Use-cases
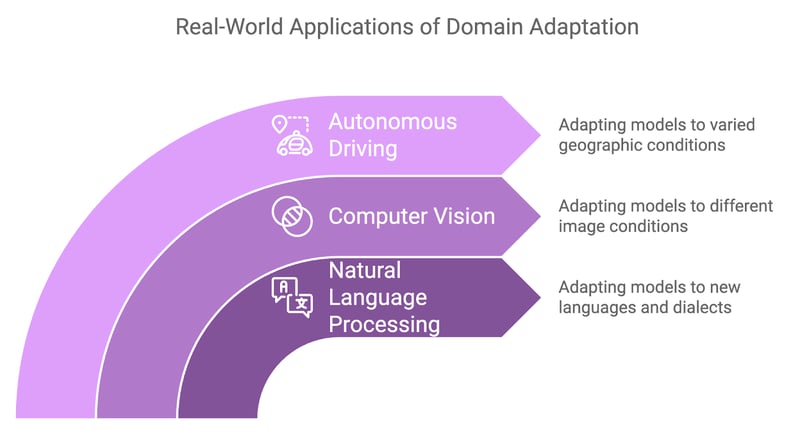
Domeinaanpassing blijkt nuttig in diverse toepassingen in de echte wereld waar domeinverschuivingen onvermijdelijk zijn:
- Domeinaanpassing wordt vaak toegepast in NLP bij het overzetten van modellen die in de ene taal of dialect zijn getraind naar een andere.
- Zo moet een sentimentanalysemodel dat in het Engels is getraind mogelijk worden aangepast voor een regionaal dialect van dezelfde taal, of een model dat op formele tekst is getraind aan informele, spreektaal leren wennen, zoals socialmediadata.
- In computer vision wordt domeinaanpassing vaak gebruikt wanneer beeldkenmerken verschillen tussen de trainings- en doeldata.
- Een model dat is getraind op afbeeldingen van objecten bij natuurlijk licht moet bijvoorbeeld worden aangepast om te werken bij zwak of kunstlicht.
- Autonome rijsystemen moeten sterk presteren ongeacht de geografische regio, en hier bewijst domeinaanpassing opnieuw zijn nut.
- Een model dat verkeersborden, voetgangers of voertuigen in het ene land herkent, moet zich kunnen aanpassen aan net andere wegomstandigheden, weerspatronen of zelfs verkeersregels in een andere regio.
Synergie tussen multi-task learning en transfer learning
Naarmate machine learning-taken complexer worden, kan het vermogen om meerdere verwante problemen gelijktijdig aan te pakken de prestaties en efficiëntie van een model aanzienlijk verbeteren. MTL speelt hierop in door modellen te trainen om meerdere taken tegelijk uit te voeren, in plaats van zich op één taak in isolatie te richten.
Wat is multi-task learning?
De kracht van MTL ligt in het benutten van relaties en gedeelde structuren tussen taken, waardoor modellen rijkere featurerepresentaties leren. Inzichten uit de ene taak verbeteren de prestaties van het model op een andere taak, wat leidt tot grotere leerefficiëntie in het algemeen.
Binnen MTL worden twee hoofdstrategieën vaak gebruikt:
- Harde parameterdeling: Bij deze aanpak deelt het model het merendeel van zijn parameters over taken, met alleen taakspecifieke lagen als onafhankelijk. Dit vermindert overfitting doordat het model wordt gestimuleerd representaties te leren die goed generaliseren over taken.
- Zachte parameterdeling: Hierbij heeft elke taak zijn eigen set parameters, maar een vorm van regularisatie zorgt ervoor dat deze parameters op elkaar lijken, wat gedeeld leren aanmoedigt zonder volledige parameteroverlap.
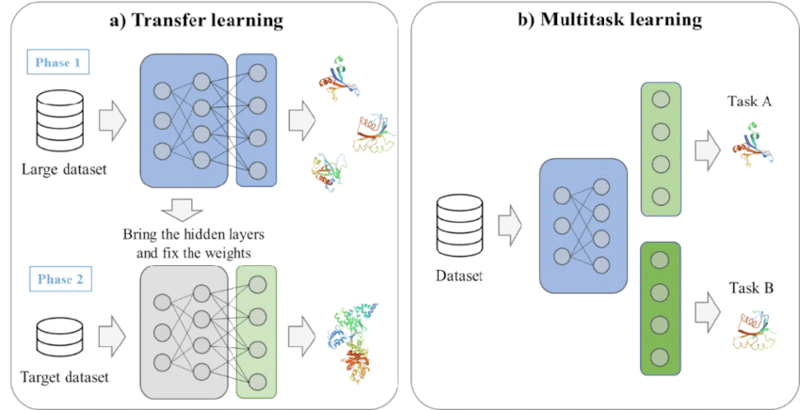
Een voorbeeld van transfer learning en multitask learning. Bron: Kim et al., 2021
Voordelen van multi-task learning
MTL biedt verschillende voordelen die het een waardevolle aanpak maken voor complexe machine learning-situaties.
Verbeterde generalisatie
Door over meerdere taken te leren, wordt het model blootgesteld aan een breder scala aan data en leert het meer algemene representaties. Dit leidt vaak tot betere prestaties op elke taak, vooral wanneer die taken verwant zijn.
Data-efficiëntie
Met MTL maken modellen beter gebruik van beschikbare data, vooral wanneer gelabelde data schaars is. Omdat het model leert van meerdere taken, kan het inzichten uit verwante taken gebruiken om de prestaties te verbeteren. Dit leren over taken heen versnelt het leerproces en vermindert de afhankelijkheid van grote datasets per taak.
Model-efficiëntie
In plaats van aparte modellen voor elke taak te trainen, bundelt MTL het leren in één model. Dit verlaagt de rekentijd en het geheugengebruik, waardoor implementatie in omgevingen met beperkte middelen efficiënter wordt.
Toepassingen van multi-task learning
MTL is met succes toegepast in verschillende domeinen, met opmerkelijke use-cases in NLP en computer vision.
Natural language processing
In natural language processing wordt MTL vaak gebruikt om modellen op meerdere verwante taken te trainen. Zo kan een taalmodel tegelijk worden getraind op machinevertaling en tekstclassificatie. Door geleerde representaties over deze taken te delen, kan het model zijn begrip van taalstructuur en context verbeteren, wat beide taken ten goede komt.
Computer vision
In computer vision kan MTL worden toegepast op taken zoals objectdetectie en beeldsegmentatie. We kunnen een model trainen om objecten in een afbeelding te lokaliseren terwijl het tegelijkertijd leert die objecten te classificeren. Dit gedeelde leerproces stelt het model in staat zowel de locatie als de categorie van objecten te herkennen, waardoor het veelzijdiger en efficiënter wordt.
Few-shot en self-supervised learning
In scenario’s waar gelabelde data schaars of niet beschikbaar is, zijn few-shot learning en SSL naar voren gekomen als krachtige technieken om de beperkingen van traditionele supervised-methoden te omzeilen.
Deze benaderingen bieden innovatieve manieren om modellen aan te passen aan nieuwe taken met minimale gelabelde data of door grote hoeveelheden ongelabelde data te gebruiken, wat ze tot essentiële tools maakt binnen geavanceerde transfer learning.
Few-shot learning
Zoals we inmiddels weten, is few-shot learning ontworpen om modellen snel te laten aanpassen aan nieuwe taken met slechts enkele gelabelde voorbeelden.
Het verzamelen van grote datasets is echter in veel toepassingen onpraktisch, zoals bij de diagnose van zeldzame ziekten of de identificatie van nicheproducten. Few-shot learning lost dit op door kennis uit verwante taken over te dragen en modellen te fine-tunen om goed te presteren met minimale nieuwe data.
Hieronder bespreken we twee kernstrategieën binnen few-shot learning.
Meta-learning
Ook wel "leren om te leren" genoemd: meta-learning traint een model zodat het zich snel kan aanpassen aan nieuwe taken met minimale data. Het idee is om het model over een verscheidenheid aan taken te trainen, zodat het zijn leren kan generaliseren en zich snel kan aanpassen aan onzichtbare taken.
Meta-learning-raamwerken zoals Model-Agnostic Meta-Learning (MAML) stellen het model in staat een optimale set parameters te leren die met slechts enkele voorbeelden kan worden fijn-afgesteld voor nieuwe taken.
Prototypische netwerken
Een andere veelvoorkomende aanpak zijn prototypische netwerken, ontworpen om datapunten te classificeren door afstanden tussen hen te berekenen in een geleerde featurespace. In deze opzet wordt elke klasse gerepresenteerd door een prototype (het gemiddelde van de voorbeelden uit die klasse in de featurespace).
Nieuwe datapunten worden vervolgens geclassificeerd op basis van hun nabijheid tot deze prototypen. Prototypische netwerken kunnen effectief zijn in few-shot learning omdat ze slechts een minimaal aantal voorbeelden per klasse nodig hebben om zinvolle prototypen voor classificatie te genereren.
Self-supervised learning
SSL stelt modellen in staat betekenisvolle representaties te extraheren uit grote hoeveelheden ongelabelde data door supervisiesignalen te genereren, waarmee de noodzaak voor handmatige labels wordt omzeild. Zodra het model van de ongelabelde data heeft geleerd, kan het vervolgens worden fijn-afgesteld op een kleinere gelabelde dataset, wat sterke prestaties oplevert op downstream-taken.
Een van de meest impactvolle SSL-technieken is contrastief leren, waarbij modellen worden getraind door positieve en negatieve paren datapunten te vergelijken. Het doel is om vergelijkbare datapunten (positieve paren) dichter bij elkaar te trekken in de featurespace en onvergelijkbare (negatieve paren) verder uit elkaar te duwen.
In natural language processing is masked language modeling, gebruikt in modellen zoals BERT, een populaire SSL-methode. Hierbij worden delen van de input gemaskeerd en wordt het model getraind om de ontbrekende elementen te voorspellen op basis van de omliggende context. Deze pre-trainingstrategie helpt het model robuuste, algemene representaties te leren die kunnen worden fijn-afgesteld voor uiteenlopende NLP-taken.
Toepassingen
Few-shot en self-supervised learning worden veel gebruikt in domeinen waar datalimieten een belangrijk obstakel vormen. Hier zijn enkele sleuteltoepassingen van elk.
Few-shot learning bij aangepaste objectdetectie
Few-shot learning is waardevol bij aangepaste objectdetectie, waar het identificeren van zeldzame of gespecialiseerde objecten kan vereisen dat modellen leren van slechts een handvol gelabelde voorbeelden.
In industriële omgevingen kan het detecteren van defecten in een productieproces bijvoorbeeld slechts zeer weinig gevallen van het defect omvatten. Door few-shot learning te benutten kan een model dat is voorgetraind op algemene objectdetectietaken snel worden aangepast om deze specifieke objecten te detecteren met minimale extra trainingsdata.
Self-supervised learning in LMs
Self-supervised learning heeft natural language processing gerevolutioneerd met modellen als GPT en BERT. Deze modellen leren algemene taalrepresentaties die met relatief kleine gelabelde datasets kunnen worden fijn-afgesteld voor specifieke taken. Zo kan een taalmodel dat met SSL is voorgetraind, worden fijn-afgesteld voor taken als sentimentanalyse, tekstclassificatie of samenvatten, vaak met state-of-the-art resultaten.
Praktische implementatie van geavanceerde transfer learning-technieken
Machine learning-bibliotheken en -frameworks kunnen de implementatie van geavanceerde transfer learning-methoden sterk vereenvoudigen. Tools zoals PyTorch, TensorFlow en Hugging Face Transformers bieden de nodige flexibiliteit en kant-en-klare componenten om het ontwikkelproces te versnellen.
Frameworks en tools
Voor praktijkmensen die geavanceerde transfer learning-technieken willen implementeren, bieden verschillende bibliotheken en frameworks uitgebreide ondersteuning:
- PyTorch: Een flexibel, gebruiksvriendelijk framework dat veel wordt gebruikt voor onderzoek en praktijkprojecten in machine learning. De dynamische computationele graaf van PyTorch maakt het ideaal voor taken als meta-learning en multi-task learning.
- TensorFlow: Een ander populair deep learning-framework, met robuuste ondersteuning voor transfer learning en domeinaanpassing via de high-level API Keras. TensorFlows tensorflow_hub biedt ook voorgetrainde modellen die je kunt fine-tunen voor nieuwe taken.
- Hugging Face Transformers: Een ideale bibliotheek voor natural language processing-taken, met diverse voorgetrainde modellen zoals BERT, GPT en T5 die met minimale inspanning kunnen worden fijn-afgesteld voor specifieke downstream-taken.
Uitdagingen en aandachtspunten
Het implementeren van geavanceerde transfer learning-technieken is uitdagend, en er zijn enkele cruciale factoren om in gedachten te houden.
Catastrofale vergetelheid
Fine-tuning op nieuwe taken kan ertoe leiden dat modellen vergeten wat ze eerder hebben geleerd. Technieken zoals Elastic Weight Consolidation (EWC) kunnen helpen de gewichten van het voorgetrainde model te behouden, wat cruciaal is voor eerdere kennis.
Omgaan met computationele complexiteit
Technieken zoals domeinaanpassing en multi-task learning kunnen de rekenvereisten aanzienlijk verhogen. Het trainen van adversariële domeinaanpassingsmodellen of multitask-architecturen kan meer resources vergen door de extra complexiteit. We moeten ons model optimaliseren en tools zoals mixed precision training gebruiken om grote modellen efficiënt te verwerken.
Waarborgen van eerlijkheid en biasmitigatie
Transfer learning-modellen die zijn voorgetraind op bevooroordeelde data kunnen deze biases in nieuwe taken doorgeven of zelfs versterken, wat leidt tot scheve voorspellingen. Dit risico is cruciaal in gevoelige domeinen zoals gezondheidszorg en financiën. Om eerlijkheid te waarborgen, zouden we modeluitvoer regelmatig op bias moeten evalueren en mitigerende technieken toepassen, zoals herweging, adversariële de-biasing of fair representation learning.
Voorbeelden uit de industrie
Geavanceerde transfer learning-methoden worden toegepast in diverse sectoren en bieden innovatieve oplossingen voor complexe uitdagingen uit de praktijk. Hieronder enkele belangrijke toepassingen en industrievoorbeelden die laten zien hoe deze technieken AI-vooruitgang stimuleren.
OpenAI: GPT-modellen met few-shot learning
OpenAI’s GPT-4o-model, een toonaangevend voorbeeld van few-shot learning in de praktijk, heeft laten zien dat het met slechts enkele voorbeelden kan aanpassen aan nieuwe taken. GPT-4o, voorgetraind op enorme hoeveelheden tekstdata, kan diverse taken uitvoeren zoals vertalen, samenvatten en vraagbeantwoording zonder taakspecifieke fine-tuning.
In plaats daarvan geven gebruikers enkele voorbeelden van de gewenste taak, waarna het model daarvan generaliseert. Deze few-shot learning-capaciteit heeft het toepassingsgebied van grote taalmodellen verbreed, van creatief schrijven tot conversatie-agents.
DeepMind: Multi-task learning in healthcare-AI
DeepMind, een koploper in AI-onderzoek, heeft multi-task learning gebruikt om zorgmodellen te ontwikkelen die kunnen helpen bij het diagnosticeren van meerdere aandoeningen op basis van medische beeldvorming. Zo kan hun AI-systeem voor het opsporen van oogziekten op netvliesscans met één model een reeks aandoeningen diagnosticeren, waaronder diabetische retinopathie en leeftijdsgebonden maculadegeneratie.
Deze MTL-aanpak vermindert de noodzaak van afzonderlijke modellen per aandoening, waardoor zorgverleners hun diagnostische proces kunnen stroomlijnen en sneller, accurater zorg kunnen leveren.
Waymo: Domeinaanpassing bij autonoom rijden
Waymo (Google’s zelfrijdende auto-project) gebruikt technieken voor domeinaanpassing om de generalisatie van zijn autonome voertuigmodellen over verschillende rijomgevingen te verbeteren. Het bedrijf traint zijn modellen in gesimuleerde omgevingen en past ze vervolgens aan voor inzet in de echte wereld in verschillende steden en weersomstandigheden.
Dit proces zorgt ervoor dat zelfrijdende auto’s de nuances van verschillende stedelijke landschappen aankunnen, van drukke straten in San Francisco tot brede snelwegen in Arizona, zonder uitgebreide hertraining per locatie.
Toekomsttrends in geavanceerde transfer learning
Onderzoekers verleggen voortdurend de grenzen om modellen adaptiever, eerlijker en beter geschikt te maken voor complexe, realistische taken, terwijl de hoeveelheid data en trainingstijd wordt verminderd.
Continu leren
Continu of levenslang leren richt zich op het ontwikkelen van modellen die continu van nieuwe data kunnen leren, terwijl kennis uit eerder geleerde taken behouden blijft. In tegenstelling tot traditionele transfer learning, waarbij modellen statisch zijn na fine-tuning, maakt continu leren doorlopende aanpassing aan nieuwe informatie mogelijk.
Dit is essentieel voor dynamische omgevingen, zoals robotica en autonome systemen, waar regelmatig nieuwe scenario’s ontstaan. In deze context helpen geheugen-gebaseerde strategieën het evenwicht te bewaren tussen het behouden van eerdere kennis en het opnemen van nieuwe vaardigheden. Toekomstige ontwikkelingen zullen zich richten op uitbreiding van continu leren naar complexere domeinen, zodat modellen efficiënt kunnen updaten zonder in te leveren op eerdere prestaties.
Eerlijkheid en biasmitigatie
Nu transfer learning vaker wordt toegepast in sectoren als gezondheidszorg, financiën en wetshandhaving, is de noodzaak om eerlijkheid en bias aan te pakken niet te negeren.
Modellen die zijn voorgetraind op grote, diverse datasets dragen vaak inherente biases met zich mee, wat in nieuwe toepassingen tot scheve uitkomsten kan leiden. Om dit tegen te gaan, onderzoeken onderzoekers technieken zoals adversariële de-biasing, herweging en fair representation learning om deze biases te detecteren en te mitigeren.
Het waarborgen van eerlijkheid zal een centrale focus blijven binnen transfer learning-onderzoek, vooral in gevoelige domeinen waar bevooroordeelde voorspellingen gevolgen in de echte wereld kunnen hebben.
Hybride transfer learning
Hybride transfer learning combineert supervised, unsupervised en self-supervised methoden om de sterke punten van elk te benutten. Modellen worden doorgaans voorgetraind met unsupervised of self-supervised benaderingen om algemene representaties te leren en daarna met gelabelde data fijn-afgesteld voor specifieke taken.
Deze hybride strategie vergroot de overdraagbaarheid en vermindert de afhankelijkheid van grote gelabelde datasets, wat het bijzonder nuttig maakt in domeinen met beperkte geannoteerde data, zoals de diagnose van zeldzame ziekten of gespecialiseerde industriële toepassingen.
Reinforcement learning binnen transfer learning
Transfer learning boekt ook vooruitgang in reinforcement learning (RL), waar agents die in de ene omgeving zijn getraind, worden aangepast voor gebruik in verwante settings. Dit vermindert de tijd en data die nodig zijn om nieuwe taken onder de knie te krijgen, waardoor hun efficiëntie bij het oplossen van complexe, meerstapsproblemen verbetert.
Een RL-agent die is getraind om een specifiek type robotsysteem te navigeren, kan bijvoorbeeld zijn kennis toepassen op een nieuwe, maar vergelijkbare, opzet met minimale hertraining, wat de veelzijdigheid en schaalbaarheid van RL-systemen aanzienlijk vergroot.
Conclusie
In dit artikel hebben we geavanceerde transfer learning-technieken verkend. We hebben domeinaanpassing bekeken voor het omgaan met verschillen in datadistributie, multi-task learning voor het benutten van gedeelde kennis, en few-shot en self-supervised learning voor scenario’s met beperkte gelabelde data.
Deze technieken bieden effectieve strategieën om uitdagingen aan te pakken en de modelprestaties te verbeteren. Naarmate AI verder evolueert, is vertrouwd zijn met deze technieken essentieel om competitief te blijven.

Recent afgestudeerde MSc met een specialisatie in kunstmatige intelligentie


Transfer learning is erg belangrijk geworden in de machine learning, waarbij voorgetrainde modellen worden aangepast voor nieuwe, verwante taken om tijd en middelen te besparen. Deze strategie is zeer effectief in vakgebieden als computer vision, natural language processing en spraakherkenning, waar grootschalige voorgetrainde data ruim beschikbaar is.
Ondanks de populariteit ervan stuit fine-tuning, een veelgebruikte transfer learning-aanpak, vaak op obstakels zoals overfitting of mismatch tussen het domein van het voorgetrainde model en de doeldata, een fenomeen dat domeinverschuiving wordt genoemd. Basis- transfer learning kan moeite hebben met complexe taken of beperkte data, wat leidt tot onvoldoende aanpassing.
Om deze uitdagingen te overwinnen, is een nieuwe golf van geavanceerde transfer learning-technieken ontstaan die domeinverschillen, dataschaarste en de behoefte aan efficiënte modelaanpassing aanpakken. In dit artikel verken ik enkele van deze geavanceerde transfer learning-strategieën.