
Program
Pengembangan Aplikasi Kecerdasan Buatan
21 jam
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GooglePendekatan tradisional, seperti pra-pelatihan pada dataset besar lalu fine-tuning pada dataset spesifik tugas, bersifat fundamental tetapi terkadang tidak cukup. Metode yang lebih maju telah muncul untuk mengatasi nuansa pergeseran domain, kelangkaan data, dan pembelajaran multi-tugas.
Metode lanjutan memperkenalkan lapisan kompleksitas dan fleksibilitas tambahan. Teknik-teknik ini bertujuan meningkatkan kinerja model dalam skenario di mana pendekatan tradisional mungkin tidak memadai.
Teknik adaptasi domain dirancang untuk menangani perbedaan antara domain sumber (pra-pelatihan) dan domain target (fine-tuning). Fine-tuning tradisional sering menghasilkan hasil suboptimal ketika model pra-latih menghadapi data yang sangat berbeda dari data pelatihannya. Teknik adaptasi domain mengurangi ketidakcocokan ini dengan menyelaraskan distribusi data, memastikan model dapat melakukan generalisasi lebih baik dalam konteks baru.
MTL memungkinkan model belajar lintas beberapa tugas terkait secara simultan. Dengan berbagi pengetahuan antar tugas, model dapat memanfaatkan kesamaan dan meningkatkan kinerja di semua tugas. Strategi ini sangat efektif ketika tugas-tugasnya saling melengkapi, seperti pembelajaran gabungan klasifikasi teks dan analisis sentimen dalam pemrosesan bahasa alami. MTL meningkatkan generalisasi dan mengurangi risiko overfitting dengan mengarahkan model untuk fokus pada pola bersama.
Teknik kunci lainnya adalah few-shot learning, yang dirancang untuk melatih model dengan data berlabel minimal. Sementara pendekatan tradisional memerlukan banyak data berlabel, teknik few-shot memungkinkan model mentransfer pengetahuan hanya dengan beberapa contoh. Metode seperti meta-learning dan prototypical networks dapat menghasilkan adaptasi cepat ke tugas baru, menjadikannya sangat berharga di bidang seperti rekomendasi personal atau klasifikasi gambar ceruk.
SSL menggunakan data tanpa label untuk melatih model, menjadikannya alat yang kuat saat data berlabel langka atau tidak tersedia. Teknik ini membangun sinyal supervisi dari data itu sendiri, menyelesaikan tugas pratekstual seperti memprediksi bagian gambar yang hilang atau merekonstruksi teks yang diacak. Model yang dipra-latih menggunakan SSL telah menunjukkan transferabilitas tinggi di berbagai aplikasi.
Zero-shot learning melangkah lebih jauh dengan memungkinkan model menangani tugas yang benar-benar baru tanpa data berlabel sama sekali. Ini dicapai melalui informasi tambahan seperti relasi semantik atau deskripsi tugas, memungkinkan model melakukan generalisasi bahkan saat menghadapi kategori baru. Kapabilitas ini sangat relevan di bidang dinamis di mana kategori baru sering muncul, seperti pada aplikasi NLP yang menangani istilah atau slang yang baru diciptakan.
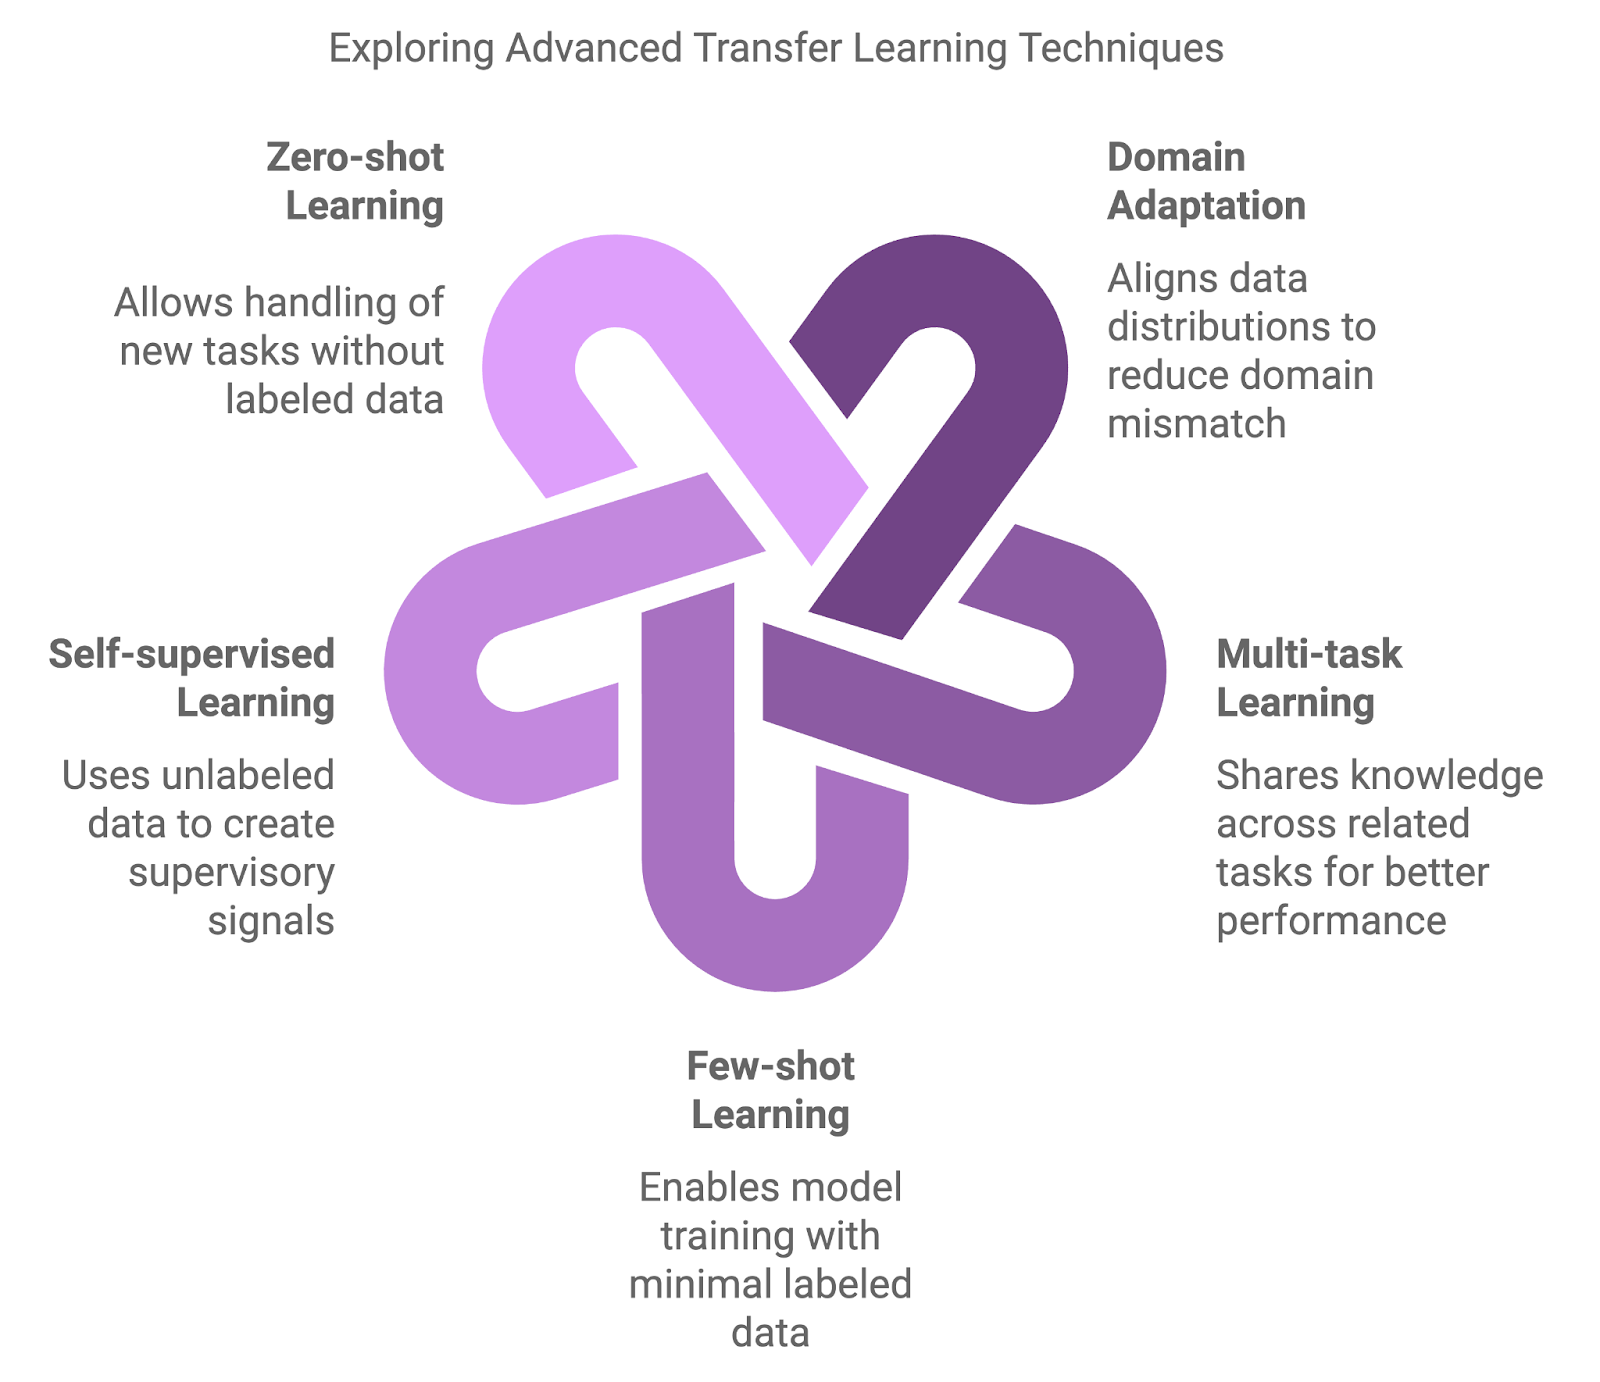
Diagram dibuat dengan napkin.ai
Seperti disinggung sebelumnya, adaptasi domain adalah subbidang transfer learning yang berfokus pada penanganan situasi ketika terdapat perbedaan signifikan, atau "pergeseran domain", antara data yang digunakan untuk melatih model dan data tempat model diterapkan.
Dalam transfer learning tipikal, diasumsikan bahwa domain sumber dan target memiliki karakteristik serupa, tetapi dalam banyak skenario dunia nyata, domain-domain ini sangat berbeda. Pada akhirnya, ini dapat menurunkan kinerja, karena model yang dilatih pada satu set data kesulitan melakukan generalisasi ke kondisi baru.
Teknik adaptasi domain dirancang untuk menjembatani kesenjangan ini, memungkinkan model yang dilatih di satu domain berkinerja efektif di domain lain dengan meminimalkan perbedaan antara distribusi data sumber dan target. Akibatnya, adaptasi domain semakin berharga dalam situasi di mana data berlabel melimpah di satu domain tetapi langka atau tidak tersedia di domain lain.
Beberapa teknik telah dikembangkan untuk mengatasi tantangan adaptasi domain—dua pendekatan yang paling umum adalah metode adversarial dan pemelajaran fitur yang invarian domain.
Salah satu teknik yang banyak digunakan untuk adaptasi domain melibatkan pembelajaran adversarial. Dalam konteks ini, model dilatih untuk mempelajari fitur yang berguna bagi tugas target sekaligus memastikan fitur tersebut tidak dapat dibedakan antara domain sumber dan target.
Kita dapat mewujudkannya menggunakan sebuah diskriminator, yaitu sebuah jaringan saraf yang ditugaskan membedakan data domain sumber dan target. Model dilatih secara adversarial sehingga belajar "mengakali" diskriminator, menjadikan representasi fitur invarian domain. Jika ini terdengar familier, itu karena teknik ini terinspirasi oleh Generative Adversarial Networks (GAN), yang menggunakan pengaturan serupa untuk menghasilkan data sintetis yang realistis.
Pendekatan lain berfokus pada pembelajaran representasi yang tidak terpengaruh oleh variasi spesifik domain. Ini mentransformasikan data masukan dari kedua domain ke dalam ruang fitur bersama di mana domain sumber dan target lebih selaras. Teknik seperti Maximum Mean Discrepancy (MMD) dan CORAL (Correlation Alignment) membantu meminimalkan perbedaan statistik di ruang ini, memastikan model dapat melakukan generalisasi lebih efektif saat diterapkan pada domain target.
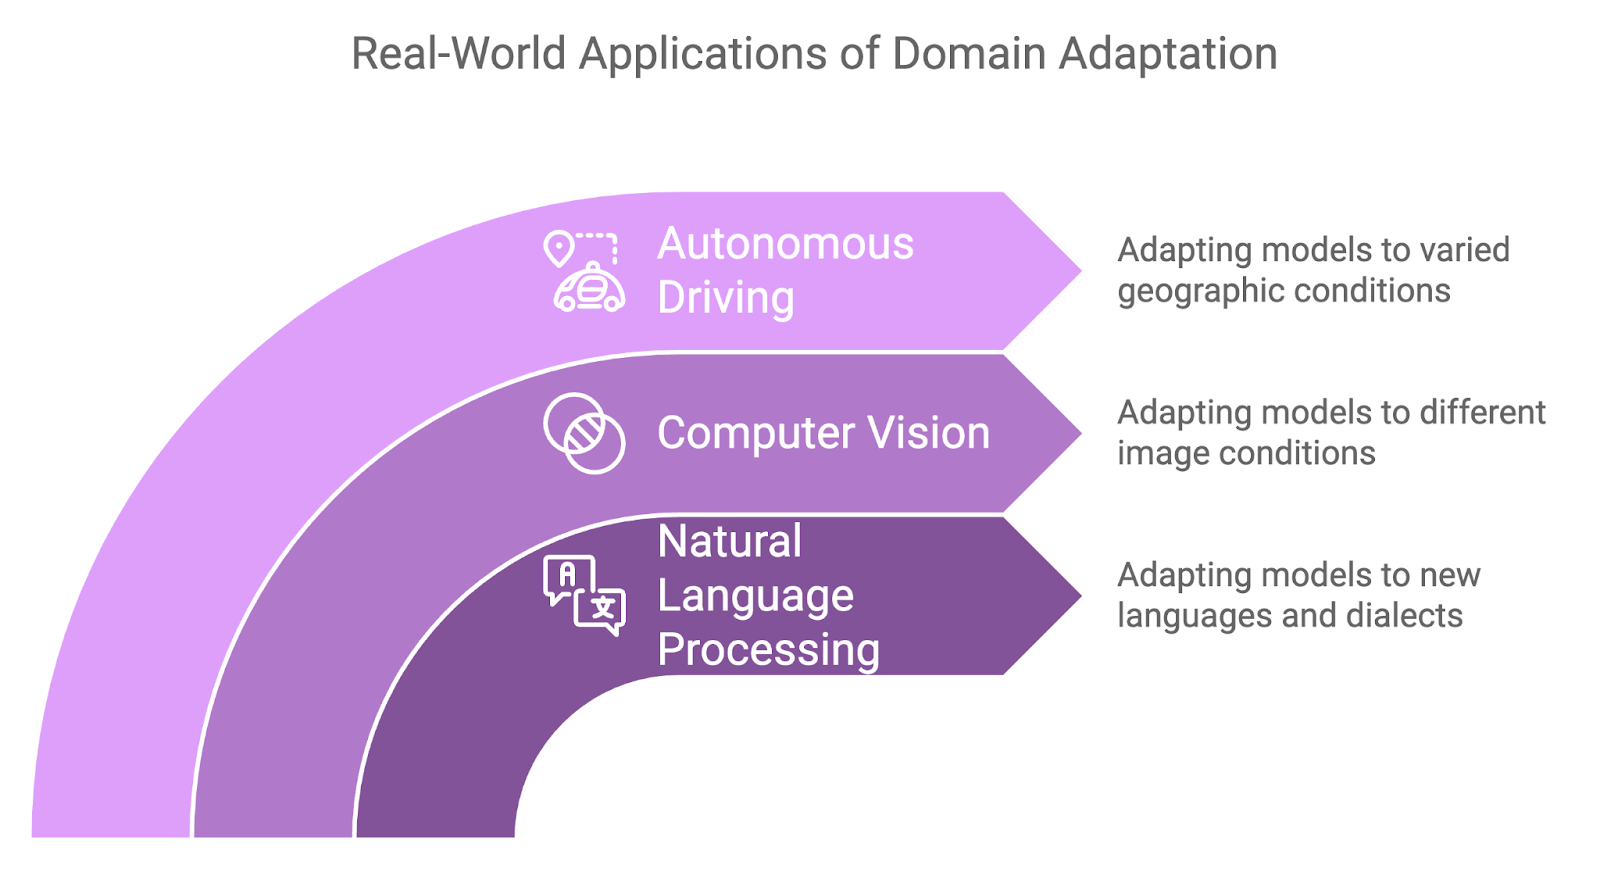
Adaptasi domain terbukti berguna dalam berbagai aplikasi dunia nyata di mana pergeseran domain tidak terelakkan:
Seiring tugas machine learning menjadi semakin kompleks, kemampuan untuk menangani beberapa masalah terkait secara bersamaan dapat sangat meningkatkan kinerja dan efisiensi model. MTL mengatasinya dengan melatih model untuk melakukan banyak tugas sekaligus, alih-alih berfokus pada satu tugas secara terpisah.
Kekuatan MTL terletak pada kemampuannya memanfaatkan relasi dan struktur bersama antar tugas, sehingga model dapat mempelajari representasi fitur yang lebih kaya. Wawasan yang diperoleh dari satu tugas meningkatkan kinerja model pada tugas lain, menghasilkan efisiensi pembelajaran keseluruhan yang lebih besar.
Dalam MTL, dua strategi utama yang umum digunakan:
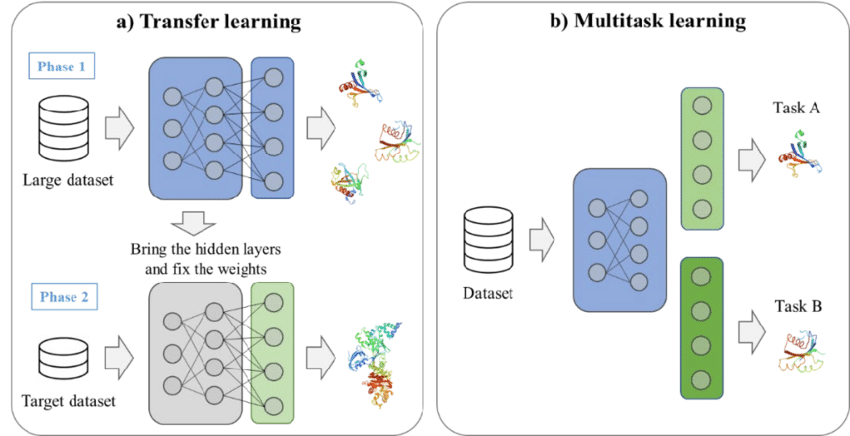
Contoh transfer learning dan multitask learning. Sumber: Kim et al., 2021
MTL menawarkan beberapa keunggulan yang menjadikannya pendekatan berharga untuk skenario machine learning yang kompleks.
Dengan belajar di banyak tugas, model terpapar pada rentang data yang lebih luas dan mempelajari representasi yang lebih umum. Ini sering menghasilkan kinerja yang lebih baik pada setiap tugas, terutama ketika tugas-tugas tersebut saling terkait.
Dengan MTL, model memanfaatkan data yang tersedia dengan lebih baik, khususnya saat data berlabel terbatas. Karena model belajar dari banyak tugas, model dapat menggunakan wawasan dari tugas terkait untuk meningkatkan kinerja. Pembelajaran lintas tugas ini mempercepat proses pembelajaran dan mengurangi ketergantungan pada dataset besar untuk setiap tugas.
Alih-alih melatih model terpisah untuk setiap tugas, MTL mengkonsolidasikan pembelajaran ke dalam satu model. Ini mengurangi biaya komputasi dan jejak memori, sehingga lebih efisien untuk diterapkan di lingkungan dengan sumber daya terbatas.
MTL telah berhasil diterapkan di berbagai domain, dengan kasus penggunaan menonjol di NLP dan visi komputer.
Dalam pemrosesan bahasa alami, MTL umum digunakan untuk melatih model pada beberapa tugas terkait. Misalnya, sebuah model bahasa dapat dilatih untuk melakukan terjemahan mesin dan klasifikasi teks secara bersamaan. Dengan berbagi representasi yang dipelajari di seluruh tugas ini, model dapat meningkatkan pemahamannya tentang struktur dan konteks bahasa, menguntungkan keduanya.
Dalam visi komputer, MTL dapat diterapkan pada tugas seperti deteksi objek dan segmentasi gambar. Kita dapat melatih model untuk mengidentifikasi objek dalam gambar sambil secara simultan juga belajar mengklasifikasikan objek tersebut. Proses pembelajaran bersama ini memungkinkan model mengenali baik lokasi maupun kategori objek, menjadikannya lebih serbaguna dan efisien.
Dalam skenario di mana data berlabel langka atau tidak tersedia, few-shot learning dan SSL muncul sebagai teknik yang kuat untuk mengatasi keterbatasan metode terawasi tradisional.
Pendekatan-pendekatan ini menawarkan cara inovatif untuk mengadaptasi model ke tugas baru dengan data berlabel minimal atau dengan menggunakan sejumlah besar data tanpa label, menjadikannya alat penting dalam ranah transfer learning lanjutan.
Seperti yang kini kita ketahui, few-shot learning dirancang agar model cepat beradaptasi dengan tugas baru hanya dengan beberapa contoh berlabel.
Namun, mengumpulkan dataset besar tidak praktis dalam banyak aplikasi, seperti diagnosis penyakit langka atau identifikasi produk ceruk. Few-shot learning menyelesaikannya dengan mentransfer pengetahuan dari tugas terkait dan melakukan fine-tuning model agar berkinerja baik dengan data baru yang minimal.
Di bawah ini, kami membahas dua strategi kunci dalam few-shot learning.
Juga dikenal sebagai "belajar untuk belajar", meta-learning melibatkan pelatihan model agar cepat beradaptasi dengan tugas baru dengan data minimal. Idenya adalah melatih model di berbagai tugas sehingga dapat menggeneralisasi pembelajarannya dan cepat menyesuaikan diri dengan tugas yang belum terlihat.
Kerangka meta-learning seperti Model-Agnostic Meta-Learning (MAML) memungkinkan model mempelajari seperangkat parameter optimal yang dapat di-fine-tune untuk tugas baru hanya dengan beberapa contoh.
Pendekatan umum lainnya adalah prototypical networks, yang dirancang untuk mengklasifikasikan titik data dengan menghitung jarak di antara mereka dalam ruang fitur yang dipelajari. Dalam pengaturan ini, setiap kelas direpresentasikan oleh sebuah prototipe (rata-rata contoh dari kelas tersebut dalam ruang fitur).
Titik data baru kemudian diklasifikasikan berdasarkan kedekatannya dengan prototipe ini. Prototypical networks dapat efektif dalam few-shot learning karena hanya memerlukan sejumlah kecil contoh per kelas untuk menghasilkan prototipe yang bermakna bagi klasifikasi.
SSL memungkinkan model mengekstraksi representasi bermakna dari sejumlah besar data tanpa label dengan menghasilkan sinyal supervisi, sehingga tidak memerlukan label manual. Setelah model belajar dari data tanpa label, model kemudian dapat di-fine-tune pada dataset berlabel yang lebih kecil, mencapai kinerja kuat pada tugas hilir.
Salah satu teknik SSL yang paling berdampak adalah contrastive learning, yang melatih model dengan membandingkan pasangan titik data positif dan negatif. Tujuannya adalah menarik titik data serupa (pasangan positif) lebih dekat dalam ruang fitur sambil mendorong yang tidak serupa (pasangan negatif) lebih jauh.
Dalam pemrosesan bahasa alami, metode SSL populer adalah masked language modeling, yang digunakan pada model seperti BERT. Di sini, bagian-bagian masukan ditutupi, dan model dilatih untuk memprediksi elemen yang hilang menggunakan konteks sekitarnya. Strategi pra-pelatihan ini membantu model mempelajari representasi yang tangguh dan serbaguna yang dapat di-fine-tune untuk berbagai tugas NLP.
Few-shot dan self-supervised learning banyak digunakan di bidang yang keterbatasan data menjadi hambatan signifikan. Berikut beberapa aplikasi kunci dari masing-masing.
Few-shot learning sangat berharga dalam deteksi objek kustom, di mana mengidentifikasi objek langka atau khusus mungkin mengharuskan model belajar hanya dari segelintir contoh berlabel.
Di lingkungan industri, mendeteksi cacat dalam proses manufaktur mungkin hanya melibatkan sangat sedikit kejadian cacat. Dengan memanfaatkan few-shot learning, model yang dipra-latih pada tugas deteksi objek umum dapat dengan cepat diadaptasi untuk mendeteksi objek spesifik ini dengan data pelatihan tambahan yang minimal.
Self-supervised learning merevolusi pemrosesan bahasa alami melalui model seperti GPT dan BERT. Model-model ini mempelajari representasi bahasa serbaguna yang dapat di-fine-tune untuk tugas spesifik dengan dataset berlabel yang relatif kecil. Misalnya, model bahasa yang dipra-latih menggunakan SSL dapat di-fine-tune untuk melakukan tugas seperti analisis sentimen, klasifikasi teks, atau peringkasan, sering kali mencapai hasil mutakhir.
Pustaka dan kerangka kerja machine learning dapat sangat menyederhanakan implementasi metode transfer learning lanjutan. Alat seperti PyTorch, TensorFlow, dan Hugging Face Transformers menyediakan fleksibilitas dan komponen siap pakai yang diperlukan untuk mempercepat proses pengembangan.
Bagi praktisi yang ingin menerapkan teknik transfer learning lanjutan, beberapa pustaka dan kerangka kerja menyediakan dukungan luas:
Menerapkan teknik transfer learning lanjutan menantang, dan ada beberapa faktor krusial yang perlu kita ingat.
Fine-tuning pada tugas baru dapat menyebabkan model "melupakan" apa yang telah dipelajari dari tugas sebelumnya. Teknik seperti Elastic Weight Consolidation (EWC) dapat membantu mempertahankan bobot model pra-latih, yang penting bagi pengetahuan sebelumnya.
Teknik seperti adaptasi domain dan multi-task learning dapat meningkatkan kebutuhan komputasi secara signifikan. Melatih model adaptasi domain adversarial atau arsitektur multi-tugas mungkin memerlukan lebih banyak sumber daya karena kompleksitas tambahan. Kita perlu mengoptimalkan model dan menggunakan alat seperti pelatihan presisi campuran untuk menangani model besar secara efisien.
Model transfer learning yang dipra-latih pada data bias dapat menyebarkan atau bahkan memperkuat bias ini pada tugas baru, yang mengarah pada prediksi yang menyimpang. Risiko ini krusial di bidang sensitif seperti layanan kesehatan dan keuangan. Untuk memastikan keadilan, kita harus secara rutin mengevaluasi keluaran model terhadap bias dan menerapkan teknik mitigasi seperti pembobotan ulang, debiasing adversarial, atau pembelajaran representasi yang adil.
Metode transfer learning lanjutan diterapkan di berbagai industri, memberikan solusi inovatif untuk tantangan dunia nyata yang kompleks. Di bawah ini beberapa aplikasi kunci dan contoh industri yang menyoroti bagaimana teknik-teknik ini mendorong kemajuan AI.
Model GPT-4o dari OpenAI, contoh terdepan few-shot learning dalam praktik, menunjukkan kemampuan untuk beradaptasi dengan tugas baru hanya dengan beberapa contoh. GPT-4o, yang dipra-latih pada jumlah besar data teks, dapat melakukan berbagai tugas seperti penerjemahan, peringkasan, dan tanya jawab tanpa perlu fine-tuning spesifik tugas.
Sebagai gantinya, pengguna memberikan beberapa contoh tugas yang diinginkan, dan model melakukan generalisasi dari sana. Kapabilitas few-shot learning ini telah memperluas jangkauan aplikasi model bahasa besar, dari penulisan kreatif hingga agen percakapan.
DeepMind, pemimpin riset AI, telah memanfaatkan multi-task learning untuk mengembangkan model kesehatan yang dapat membantu mendiagnosis berbagai kondisi dari citra medis. Misalnya, sistem AI mereka untuk mendeteksi penyakit mata dari pemindaian retina mampu mendiagnosis berbagai kondisi, termasuk retinopati diabetik dan degenerasi makula terkait usia, menggunakan satu model.
Pendekatan MTL ini mengurangi kebutuhan akan model terpisah untuk setiap kondisi, memungkinkan penyedia layanan kesehatan merampingkan proses diagnostik dan memberikan perawatan pasien yang lebih cepat dan akurat.
Waymo (proyek mobil swa-kemudi Google) menggunakan teknik adaptasi domain untuk meningkatkan generalisasi model kendaraan otonomnya di berbagai lingkungan berkendara. Perusahaan melatih modelnya di lingkungan simulasi dan kemudian mengadaptasinya untuk penerapan dunia nyata di berbagai kota dan kondisi cuaca.
Proses ini memastikan mobil swa-kemudi dapat menangani nuansa lanskap perkotaan yang berbeda, dari jalan-jalan padat di San Francisco hingga jalan tol luas di Arizona, tanpa memerlukan pelatihan ulang ekstensif untuk setiap lokasi.
Para peneliti terus mendorong batas, berupaya membuat model lebih adaptif, adil, dan mampu menangani tugas dunia nyata yang kompleks sambil mengurangi jumlah data dan waktu pelatihan yang dibutuhkan.
Continual learning atau lifelong learning berfokus pada pengembangan model yang dapat terus belajar dari data baru sambil mempertahankan pengetahuan dari tugas yang telah dipelajari sebelumnya. Berbeda dengan transfer learning tradisional, di mana model bersifat statis setelah di-fine-tune, continual learning memungkinkan adaptasi berkelanjutan terhadap informasi baru.
Ini vital untuk lingkungan dinamis, seperti robotika dan sistem otonom, di mana skenario baru pasti muncul secara reguler. Dalam konteks ini, strategi berbasis memori membantu menyeimbangkan kebutuhan untuk mempertahankan pengetahuan masa lalu sambil menggabungkan keterampilan baru. Perkembangan mendatang bertujuan memperluas continual learning ke domain yang lebih kompleks, memastikan model dapat memperbarui diri secara efisien tanpa mengorbankan kinerja sebelumnya.
Seiring transfer learning menjadi lebih lazim di industri seperti layanan kesehatan, keuangan, dan penegakan hukum, kebutuhan untuk menangani keadilan dan bias tidak bisa diabaikan.
Model yang dipra-latih pada dataset besar dan beragam sering membawa bias bawaan, yang dapat menyebabkan hasil yang menyimpang dalam aplikasi baru. Untuk mengatasinya, para peneliti mengeksplorasi teknik seperti debiasing adversarial, pembobotan ulang, dan pembelajaran representasi yang adil untuk mendeteksi dan mengurangi bias ini.
Memastikan keadilan akan tetap menjadi fokus utama dalam riset transfer learning, terutama di domain sensitif di mana prediksi yang bias dapat memiliki implikasi dunia nyata.
Pelajari AI dengan kursus-kursus ini!
Program
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




