

Amazon Athena का उपयोग करने के लाभ
ऊपर बताई गई विशेषताओं को ध्यान में रखते हुए, यहाँ Athena के फायदों का संक्षिप्त सार दिया गया है:
|
लाभ |
विशेषता |
विवरण |
|
लागत-कुशलता |
प्रति-क्वेरी भुगतान मॉडल |
आप केवल उसी डेटा के लिए भुगतान करते हैं जिसके साथ आपकी क्वेरी इंटरैक्ट करती है; कोई अग्रिम लागत या जटिल लाइसेंस नहीं; विभाजन, डेटा कंप्रेशन और कॉलमनर फॉर्मेट्स के साथ लागत अनुकूलन संभव। |
|
उपयोग में आसानी |
सर्वरलेस और मानक SQL |
इंफ्रास्ट्रक्चर सेट अप या प्रबंधन की आवश्यकता नहीं; उपयोगकर्ता परिचित SQL सिंटैक्स का उपयोग करके कुछ ही मिनटों में डेटा क्वेरी करना शुरू कर सकते हैं, जिससे यह सुलभ और सरल हो जाता है। |
|
लचीलापन |
मल्टी-फॉर्मेट समर्थन |
यह डेटा के व्यापक फॉर्मेट्स (जैसे, CSV, JSON, Parquet) का समर्थन करता है, जिससे उपयोगकर्ता S3 से सीधे अपने मूल फॉर्मेट में डेटा क्वेरी कर सकते हैं, और ETL प्रक्रियाओं की आवश्यकता नहीं पड़ती। |
|
त्वरित इनसाइट्स |
तेज़ विश्लेषण और सीधे S3 क्वेरी |
यह सर्वरलेस आर्किटेक्चर के साथ तुरंत डेटा विश्लेषण सक्षम करता है, S3 में संग्रहीत डेटा से सीधे तेज़ी से इनसाइट्स निकालने की सुविधा देता है, और डेटा-आधारित निर्णयों के लिए समय-से-मूल्य घटाता है। |
Amazon Athena के सामान्य उपयोग-केस
हमने Athena को परिभाषित किया और इसकी विशेषताओं व लाभों का उल्लेख किया, लेकिन इसका उपयोग किन कार्यों में होता है? इस खंड में, हम कुछ सबसे लोकप्रिय उपयोग-केस की समीक्षा करेंगे।
लॉग विश्लेषण
Amazon Athena का अक्सर लॉग विश्लेषण के लिए उपयोग किया जाता है, विशेष रूप से Amazon S3 में संग्रहीत लॉग्स पर क्वेरी और विश्लेषण के लिए। संगठन प्रायः विभिन्न स्रोतों—जैसे एप्लिकेशन लॉग, सर्वर लॉग, और एक्सेस लॉग—से भारी मात्रा में लॉग डेटा उत्पन्न करते हैं।
इन लॉग्स को S3 में संग्रहीत करके और Athena के माध्यम से क्वेरी कर, उपयोगकर्ता जल्दी से रुझान पहचान सकते हैं, समस्याओं का निदान कर सकते हैं, और जटिल सेटअप की आवश्यकता के बिना सिस्टम प्रदर्शन की निगरानी कर सकते हैं।
- उदाहरण: कोई कंपनी S3 में संग्रहीत वेब सर्वर लॉग्स का Athena से विश्लेषण कर सकती है, जिससे उपयोगकर्ता व्यवहार के पैटर्न की पहचान, ट्रैफ़िक में अप्रत्याशित स्पाइक्स जैसी विसंगतियों का पता लगाना, या वास्तविक समय में त्रुटियों का निदान करना संभव होता है।
ऐड-हॉक डेटा एक्सप्लोरेशन
Athena का सर्वरलेस आर्किटेक्चर और मानक SQL का समर्थन इसे ऐड-हॉक डेटा एक्सप्लोरेशन के लिए उत्कृष्ट टूल बनाता है। चाहे आप डेटा साइंटिस्ट हों, एनालिस्ट हों, या इंजीनियर—Athena आपको पारंपरिक डेटाबेस में डेटा लोड किए बिना S3 में संग्रहीत डेटा पर जल्दी क्वेरी चलाने देता है।
- उदाहरण: कोई डेटा एनालिस्ट S3 में अभी-अभी इनजेस्ट किए गए नए डेटासेट का Athena से एक्सप्लोर कर सकता/सकती है, ताकि विस्तृत विश्लेषण से पहले डेटा की संरचना समझी जा सके, विसंगतियों का पता लगाया जा सके, या विशिष्ट मीट्रिक्स पहचाने जा सकें।
डेटा लेक्स पर क्वेरी करना
जैसे-जैसे संगठन बड़े पैमाने पर कच्चे और प्रोसेस्ड डेटा को स्टोर करने हेतु डेटा लेक्स अपनाते जा रहे हैं, Athena इन डेटा लेक्स के लिए एक शक्तिशाली क्वेरी इंजन का काम करता है। यह S3 में संग्रहीत डेटा पर सीधे एनालिटिक्स करने देता है, जिससे यह आधुनिक डेटा लेक आर्किटेक्चर का अभिन्न अंग बन जाता है।
- उदाहरण: कोई संगठन ग्राहक लेन-देन डेटा, उत्पाद जानकारी, और बिक्री रिकॉर्ड्स वाले डेटा लेक पर Athena से क्वेरी चला सकता है, जिससे बिजनेस यूज़र्स बिना डेटा वेयरहाउस के रिपोर्ट्स और इनसाइट्स जनरेट कर सकते हैं।
बिज़नेस इंटेलिजेंस रिपोर्टिंग
Athena का उपयोग अक्सर बिज़नेस इंटेलिजेंस (BI) स्टैक के हिस्से के रूप में भी किया जाता है, जहाँ यह Amazon QuickSight जैसे BI टूल्स से एकीकृत होकर डेटा विज़ुअलाइज़ेशन और रिपोर्टिंग सक्षम करता है। S3 में डेटा पर Athena से क्वेरी कर और उसे QuickSight में विज़ुअलाइज़ करके, संगठन निर्णय लेने हेतु इंटरैक्टिव डैशबोर्ड्स और रिपोर्ट्स बना सकते हैं।
- उदाहरण: कोई कंपनी S3 में संग्रहीत बिक्री डेटा पर Athena से क्वेरी चला सकती है और फिर उसे QuickSight से जोड़कर ऐसा डैशबोर्ड बना सकती है जो मासिक बिक्री प्रदर्शन, ग्राहक अधिग्रहण लागत, और अन्य महत्त्वपूर्ण मीट्रिक्स को ट्रैक करता है।
Amazon Athena बनाम Redshift
यदि आप Amazon Redshift से परिचित हैं, तो आप सोच रहे होंगे कि यह Athena से कैसे भिन्न है।
हालाँकि Athena और Redshift दोनों डेटासेट्स के साथ काम करते हैं, उनके लक्ष्य भिन्न हैं। Redshift का प्राथमिक उपयोग-केस डेटा वेयरहाउसिंग और बड़े डेटा से जुड़े नियमित एनालिटिक्स हैं। AWS Athena का फोकस S3 में संग्रहीत डेटा पर उपयोगकर्ताओं को ऐड-हॉक विश्लेषण करने देना है।
यहाँ Athena बनाम Redshift की विस्तृत तुलना दी गई है:
|
मानदंड |
Amazon Athena |
Amazon Redshift |
|
आर्किटेक्चर |
सर्वरलेस क्वेरी सेवा; Amazon S3 में संग्रहीत डेटा पर सीधे SQL क्वेरीज चलती हैं, स्वतः स्केलिंग के साथ; इंफ्रास्ट्रक्चर प्रबंधन की आवश्यकता नहीं। |
पूरी तरह से प्रबंधित डेटा वेयरहाउस; समर्पित इंफ्रास्ट्रक्चर वाले डेटा वेयरहाउस क्लस्टर की आवश्यकता; आवश्यकतानुसार स्केल कर सकता है। Redshift Serverless विकल्प उपलब्ध है। |
|
उपयोग-केस |
S3 डेटा पर ऐड-हॉक क्वेरी और एनालिटिक्स के लिए आदर्श; जहाँ बिना डेटा ट्रांसफॉर्मेशन के लचीलापन और लागत-कुशलता प्राथमिकता हो। |
जटिल, बड़े पैमाने के एनालिटिक्स और रिपोर्टिंग के लिए उपयुक्त; ऐसी संरचित डेटा स्थितियों के लिए आदर्श जिनमें बार-बार क्वेरी और ट्रांसफॉर्मेशन की आवश्यकता होती है। |
|
लागत संरचना |
प्रति-क्वेरी भुगतान मॉडल: क्वेरीज द्वारा स्कैन किए गए डेटा के आधार पर चार्ज, जो रुक-रुक कर या बदलते वर्कलोड्स के लिए लागत-प्रभावी है। |
प्राइसिंग क्लस्टर के आकार और उपयोग पर आधारित; अनुमानित, उच्च-वॉल्यूम क्वेरीज के लिए रिज़र्व्ड इंस्टेंस प्राइसिंग उपलब्ध। |
|
प्रदर्शन |
डेटा के आकार और फॉर्मेट पर निर्भर; विभाजन और कंप्रेशन से अनुकूलित; छोटे, कम जटिल क्वेरीज के लिए सर्वोत्तम। |
जटिल क्वेरीज के लिए उच्च प्रदर्शन; कॉलमनर स्टोरेज, समानांतर प्रोसेसिंग और उन्नत अनुकूलन का उपयोग भारी वर्कलोड्स के लिए करता है। |
|
डेटा इंटीग्रेशन |
बिना ट्रांसफॉर्मेशन या लोडिंग के सीधे S3 में डेटा क्वेरी करता है; विभिन्न फॉर्मेट्स और एक्स्टेंसिबल कनेक्टर्स (Redshift सहित) का समर्थन। |
डेटा को वेयरहाउस में लोड करना आवश्यक; AWS सेवाओं से इंटीग्रेट करता है और विभिन्न डेटा इनजेशन तरीकों का समर्थन करता है, पर केवल अपने स्टोर्ड डेटा से ही पढ़ता है। |
AWS Athena सेट अप करना
अब बारी है प्रैक्टिकल होने की—Athena सेट अप करें और कुछ क्वेरीज चलाएँ!
1. AWS अकाउंट बनाना
AWS Athena का उपयोग करने के लिए AWS अकाउंट चाहिए। यदि आपके पास नहीं है, तो आपको एक बनाना होगा। ऐसा करने के लिए, AWS सेट-अप गाइड में दिए निर्देशों का पालन करें।
हालाँकि AWS Athena के लिए कोई फ्री टियर नहीं है, फिर भी आप सिस्टम कैसे काम करता है यह समझने के लिए 2–3 छोटी टेस्ट क्वेरीज (~10MB आकार) चला सकेंगे। पोर्टल पर दिए निर्देशों का पालन करें और अपनी पहचान सत्यापित करें। फिर अपने AWS अकाउंट में लॉग इन करें।
2. परमिशन सेट करना
अन्य सभी Amazon AWS प्रोडक्ट्स की तरह, Athena परमिशन के लिए IAM (आईडेंटिटी और एक्सेस मैनेजमेंट) नीतियों का उपयोग करता है। आप अपने अकाउंट के रूट यूज़र होंगे और अपने S3 बकेट्स पर Athena क्वेरीज चलाने के लिए आवश्यक परमिशन होने चाहिए।
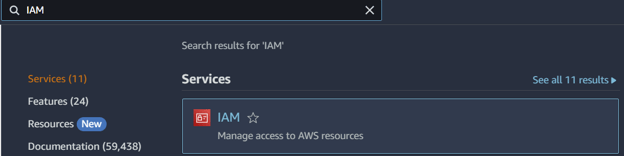
आप अपने AWS होम डैशबोर्ड के शीर्ष सर्च बार में IAM सेवा खोजकर और इस संपूर्ण IAM गाइड का उपयोग करके IAM परमिशन प्रबंधित कर सकते हैं। AWS डॉक्यूमेंटेशन में Athena की विशेष सेटअप जानकारी भी उपलब्ध है।
3. Amazon S3 में डेटा तक पहुँच के लिए Athena कॉन्फ़िगर करना
क्वेरी चलाने से पहले, हमें अपना डेटा स्टोर करने के लिए एक S3 बकेट सेट अप करना होगा।
Amazon S3 का अर्थ है Simple Storage Service और यह क्लाउड वातावरण में AWS द्वारा स्टोरेज और डेटा प्रबंधन का एक महत्त्वपूर्ण घटक है। Amazon S3 बकेट बनाने पर इस अच्छे गाइड का पालन करते हुए, हम अपने डेटा और क्वेरीज के लिए स्टोरेज वातावरण बना सकते हैं।
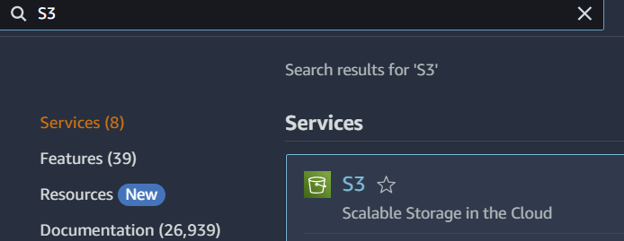
संक्षेप में, S3 होमपेज पर पहुँचने के लिए आप सर्च बार में S3 सेवा खोजेंगे:
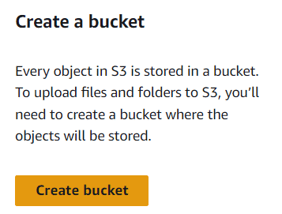
होमपेज के दाएँ साइडबार पर आपको “Create Bucket” बटन दिखाई देगा। इस पेज के निर्देशों का पालन करते हुए, आप ऐसा बकेट बनाएँगे जिसमें आपका Athena सर्विस क्वेरी परिणाम संग्रहीत कर सके।
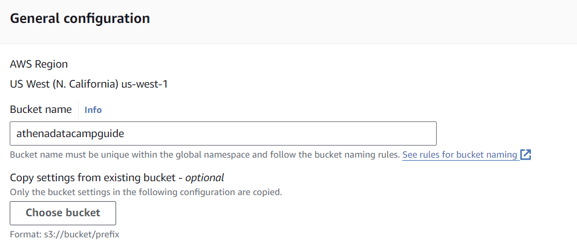
मैं “athenadatacampguide” नाम का बकेट बनाऊँगा/बनाऊँगी और बाकी सभी डिफ़ॉल्ट विकल्प रखूँगा/रखूँगी। क्योंकि बकेट्स को AWS में वैश्विक रूप से यूनिक होना चाहिए, आपको इस ट्यूटोरियल के लिए कोई और नाम चुनना होगा।
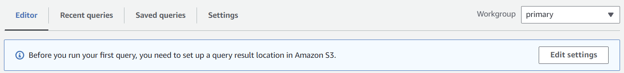
अब, हमें इस बकेट को Athena से जोड़ना है। मैं Athena कंसोल पर जाऊँगा/जाऊँगी और ऊपर के पास मौजूद छोटे नोटिफिकेशन बार में “Edit Settings” पर क्लिक करूँगा/करूँगी।
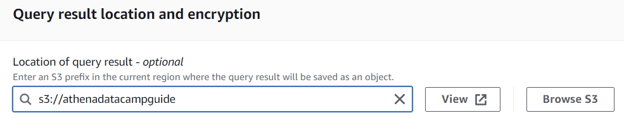
फिर मैं अभी बनाया गया बकेट चुनूँगा/चुनूँगी। अपना बकेट खोजने के लिए दाएँ ओर “Browse S3” बटन का उपयोग करें या नाम के पहले “s3://” लगाकर टाइप करें।
बकेट चयन हो जाने पर, “Save” पर क्लिक करें और शीर्ष टूलबार में Editor पर क्लिक करके वापस एडिटर में लौट आएँ।
4. डेटाबेस बनाना
AWS Athena डेटा को पदानुक्रमित रूप से व्यवस्थित करता है। यह “डेटा कैटलॉग्स” का उपयोग करता है, जो डेटाबेस के समूह होते हैं जिन्हें स्कीमा भी कहा जाता है।
वास्तविक टेबल्स जिन्हें हम क्वेरी करते हैं, वे डेटाबेस के भीतर होती हैं। नया डेटा कैटलॉग बनाने के लिए, आप Amazon Lambda का उपयोग कर किसी बाहरी डेटा स्रोत से जुड़ सकते हैं। फिर डेटा कैटलॉग को Lambda, Hive, या Glue डेटा कैटलॉग के रूप में सहेजा जा सकता है।
AWS पर डिफ़ॉल्ट रूप से Glue सेवा को केंद्रीय डेटा कैटलॉग रिपॉज़िटरी के रूप में उपयोग किया जाता है। हम एक ऐसा डेटाबेस बनाने पर ध्यान देंगे जो हमारी क्वेरीज़ के लिए टेबल्स रखेगा।
एडिटर में, Query Editor पेन पर जाएँ। यहीं हम डेटाबेस बनाने, टेबल्स क्वेरी करने और एनालिटिक्स चलाने के लिए क्वेरी लिखेंगे।
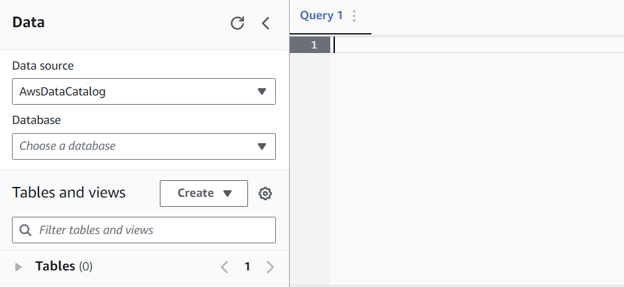
अपना पहला डेटाबेस बनाने के लिए, हम निम्न क्वेरी चलाएँगे:
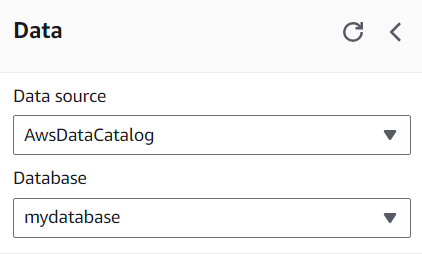
CREATE DATABASE mydatabaseइस क्वेरी को चलाने के बाद आप बाएँ साइडबार पर “Database” के नीचे ड्रॉपडाउन से डेटाबेस चुन सकेंगे।
अब जब हमारे पास एक डेटाबेस है, तो हम एक टेबल बनाने पर फोकस करेंगे ताकि हमारे पास क्वेरी करने के लिए कुछ हो!
अपने डेटाबेस में डेटा लाना आपके AWS सेटअप के आधार पर थोड़ा भिन्न हो सकता है। आप Redshift जैसे डेटा वेयरहाउस में संग्रहीत डेटा का उपयोग कर सकते हैं या AWS Kinesis और Lambda का उपयोग कर स्ट्रीमिंग डेटा से सारणीबद्ध डेटा जनरेट कर सकते हैं।
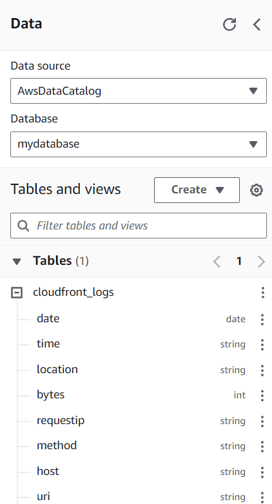
आज, हम नमूना AWS Cloudfront Logs से सैंपल डेटा उपयोग करेंगे। डेटा की जटिलता के कारण, निर्माण प्रक्रिया का एक भाग URL डेटा को कॉलम्स में पार्स करने हेतु RegEx समूहों का उपयोग करता है।
निम्न SQL का उपयोग करके, हम एक टेबल बना सकते हैं। नोट: नीचे “myregion” को अपने AWS रीजन से बदलें।
CREATE EXTERNAL TABLE IF NOT EXISTS cloudfront_logs (
Date DATE,
Time STRING,
Location STRING,
Bytes INT,
RequestIP STRING,
Method STRING,
Host STRING,
Uri STRING,
Status INT,
Referrer STRING,
os STRING,
Browser STRING,
BrowserVersion STRING
)
ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.RegexSerDe'
WITH SERDEPROPERTIES (
"input.regex" = "^(?!#)([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+[^\(]+[\(]([^\;]+).*\%20([^\/]+)[\/](.*)यदि टेबल बाएँ साइडबार पर दिखाई दे, तो आप क्वेरी चलाने के लिए तैयार हैं!
AWS Athena में क्वेरी लिखना और चलाना
Athena में क्वेरी लिखना पारंपरिक SQL में क्वेरी लिखने जैसा ही है। आप बस क्वेरी लिखकर Athena को सबमिट करते हैं, और वांछित परिणाम वापस मिल जाते हैं।
एक अच्छी प्रैक्टिस यह है कि आप अपने FROM स्टेटमेंट्स इस सिंटैक्स में लिखें: “DataSource”.“database”.“table”。 इस तरह, डेटा के स्रोत को लेकर कभी भ्रम नहीं रहता।
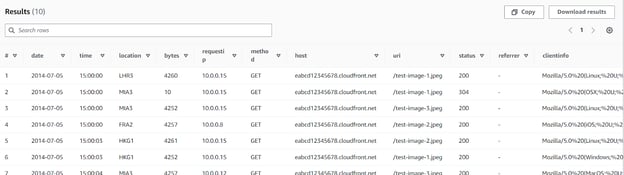
शुरू करने के लिए एक सरल SELECT स्टेटमेंट आज़माएँ।
SELECT *
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
LIMIT 10यह 10 परिणामों वाली एक तालिका लौटाएगा। Athena आपको परिणामों को कॉपी या डाउनलोड करने देता है। साथ ही, ये परिणाम उस S3 बकेट में सेव हो जाते हैं जिसे आपने अपनी Athena सेवा से जोड़ा है।
हम सरल GROUP BY क्वेरीज भी लिख सकते हैं। यह क्वेरी विशेष रूप से बताती है कि विशिष्ट HTTP मेथड्स के साथ कितने requestip (ज़रूरी नहीं कि अद्वितीय) शामिल थे।
SELECT
method,
COUNT(requestip)
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
GROUP BY 1Athena का बेहतरीन उपयोग अधिक जटिल क्वेरीज, जैसे विंडो फ़ंक्शंस, के लिए है। Athena के अनुकूलन के कारण, हम जटिल गणनाएँ अधिक तेज़ी से कर सकते हैं।
उदाहरण के तौर पर, हम Athena का उपयोग प्रत्येक रिकॉर्ड के लिए उनके रीजन और तारीख के आधार पर विभाजित करके, समय के अनुसार अवरोही क्रम में ROW NUMBER() जनरेट करने के लिए कर सकते हैं। फिर हम WHERE फ़िल्टर से पहली पंक्ति चुनकर, प्रत्येक रीजन और तारीख के लिए सबसे हालिया रिकॉर्ड चुन सकते हैं।
SELECT *
FROM (
SELECT
location,
date,
time,
ROW_NUMBER() OVER(PARTITION BY location, date ORDER BY time DESC) row_num
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
)
WHERE row_num = 1
Athena के साथ यह तो बस शुरुआत है। आप कोई भी ऐसी क्वेरी लिख सकते हैं जो आपको Athena की क्षमताओं का लाभ उठाने में मदद करे।
AWS Athena के लिए सर्वोत्तम प्रथाएँ
अन्य किसी भी डेटा प्रोसेसिंग टूल की तरह, AWS Athena के लिए भी कुछ सर्वोत्तम प्रथाएँ हैं। ये प्रथाएँ न केवल आपका काम आसान करेंगी बल्कि इसके प्रदर्शन में भी सुधार करेंगी।
इसके अतिरिक्त, चूँकि AWS एक क्लाउड-आधारित सेवा है और उपयोगकर्ताओं से भंडारण तथा कंप्यूटेशनल कारकों के आधार पर शुल्क लिया जाता है, ये प्रथाएँ काफ़ी लागत बचत भी करा सकती हैं!
डेटा फॉर्मेट्स का अनुकूलन (जैसे, Parquet, ORC)
कुछ डेटा फॉर्मेट्स AWS Athena में उपयोग के लिए अधिक सुविधाजनक होते हैं। चूँकि Athena S3 बकेट से डेटा पढ़ता है, कोई ऐसा फॉर्मेट चुनना जो पढ़ने में आसान और कंप्रेस्ड हो, प्रदर्शन और लागत दोनों में सुधार करेगा।
CSV में संग्रहीत रॉ डेटा भले ही सबसे सीधा लगे, लेकिन यह अक्षम हो सकता है। Parquet या ORC जैसे कंप्रेस्ड फॉर्मेट में डेटा स्टोर करना डेटा रीड लागत बचाएगा।
Parquet और ORC का एक अतिरिक्त लाभ उनका कॉलमनर-आधारित कंप्रेशन है। Athena का ऑप्टिमाइज़र संपूर्ण टेबल पर काम करने के बजाय केवल विशिष्ट डेटा कॉलम देखने देता है।
क्वेरी प्रदर्शन सुधारने के लिए डेटा का विभाजन
डेटा का पार्टिशन करना मतलब किसी विशेष कुंजी—जैसे तारीख—के आधार पर नियमित रूप से डेटासेट को बाँटना। उदाहरण के लिए, हमारे पास दैनिक पार्टिशन्स हो सकते हैं जहाँ डेटा अपने-आप दिनों के हिसाब से विभाजित और संग्रहित होता है।
जब हमारा डेटा पार्टिशन किया जाता है, तो SQL इंजन प्रासंगिक पार्टिशन्स को देखकर बेहतर अनुकूलन कर सकता है। इससे स्कैन किए गए डेटा की मात्रा सीधे घटती है और कुल लागत कम होती है।
क्वेरीज का अनुकूलन कर लागत प्रबंधन
डेटा विश्लेषण करते समय कुछ जटिलता अपेक्षित होती है, लेकिन क्वेरीज का अनुकूलन करने से कंप्यूटेशनल समय और लागत घटाई जा सकती है। कुछ लागतें सीधे Athena से नहीं बल्कि अन्य सेवाओं से आती हैं जिनका Athena उपयोग करता है।
Athena की लागत का मुख्य घटक डेटा स्कैन करना और प्रोसेस करना है, लेकिन यदि आप बहुत बड़े परिणाम सेव करते हैं तो S3 से भी लागत लग सकती है। हम सामान्य SQL सर्वोत्तम प्रथाओं का पालन करते हुए क्वेरीज को अनुकूलित कर प्रदर्शन सुधार सकते हैं और लागत घटा सकते हैं।
उदाहरण के लिए, निम्न सभी अनुकूलन में मदद करेंगे:
- डेटासेट के आकार को घटाने के लिए यथासंभव डेटा फ़िल्टर करें
- अनावश्यक कंप्यूटेशन घटाने के लिए सावधानी से डेटासेट्स जॉइन करें
- जहाँ संभव हो
SELECT *से बचें LIMITका उपयोग कर क्वेरीज का परीक्षण करें
ये सर्वोत्तम प्रथाएँ क्वेरी प्रदर्शन में सुधार लाएँगी और लागत घटाएँगी!
क्वेरी मॉनिटरिंग और ट्रबलशूटिंग
AWS Athena, क्वेरी मेट्रिक्स स्टोर करने के लिए Amazon CloudWatch से जुड़ सकता है। क्वेरी प्रदर्शन लॉग्स देखकर हम अक्षम क्वेरीज या समस्याओं का पता लगा सकते हैं।
AWS Athena का अन्य AWS सेवाओं से एकीकरण
जैसा बताया गया, AWS Athena कई अन्य AWS सेवाओं से एकीकृत होता है, जिससे इसकी डेटा कैटलॉगिंग, विज़ुअलाइज़ेशन, प्रोसेसिंग, और वेयरहाउसिंग क्षमताएँ बेहतर होती हैं।
नीचे बताया गया है कि Athena, AWS Glue, Amazon QuickSight, AWS Lambda, और Amazon Redshift जैसी सेवाओं के साथ कैसे काम करता है।
AWS Glue के साथ डेटा कैटलॉगिंग और ETL
AWS Athena के साथ एकीकृत होने पर, AWS Glue एक केंद्रीय मेटाडेटा रिपॉज़िटरी के रूप में कार्य करता है जो Amazon S3 में डेटा को स्वचालित रूप से कैटलॉग करता है। यह एकीकरण मैनुअल स्कीमा परिभाषाओं की आवश्यकता समाप्त करता है और Athena में डेटा क्वेरी करना आसान बनाता है।
Glue ETL क्षमताएँ भी प्रदान करता है—डेटा कंप्रेशन, पार्टिशनिंग, और फॉर्मेट कन्वर्ज़न जैसे कार्यों को स्वचालित कर डेटा को Athena में सर्वोत्तम क्वेरी के लिए ट्रांसफॉर्म और तैयार करता है—इससे कुशल और प्रभावी डेटा प्रोसेसिंग सुनिश्चित होती है।
Amazon QuickSight के साथ डेटा विज़ुअलाइज़ेशन
Amazon QuickSight, AWS Athena के साथ एकीकृत होकर क्वेरी परिणामों को इंटरैक्टिव डैशबोर्ड्स और रिपोर्ट्स में बदल देता है। यह कनेक्शन आपको सीधे Athena क्वेरीज से डेटा विज़ुअलाइज़ करने देता है, जिससे विज़ुअल इनसाइट्स को जल्दी और आसानी से बनाया जा सकता है।
QuickSight, स्वचालित डेटा रिफ्रेश और उन्नत एनालिटिक्स जैसी सुविधाओं का समर्थन करता है, जो डेटा की खोज और प्रस्तुति के लिए इसे शक्तिशाली टूल बनाता है।
AWS Lambda के साथ सर्वरलेस डेटा प्रोसेसिंग
AWS Lambda सर्वरलेस वातावरण में Athena के साथ डेटा प्रोसेसिंग वर्कफ़्लोज़ को स्वचालित करता है। Lambda फ़ंक्शंस, जैसे S3 में नया डेटा आने पर, इवेंट्स के प्रत्युत्तर में Athena क्वेरीज ट्रिगर कर सकते हैं, जिससे वास्तविक-समय प्रोसेसिंग सक्षम होती है।
Lambda क्वेरी परिणामों के आधार पर आगे की कार्रवाइयों को भी स्वचालित कर सकता है, जिससे बिना मैनुअल हस्तक्षेप के स्केलेबल, इवेंट-ड्रिवन वर्कफ़्लोज़ बनते हैं।
Amazon Redshift के साथ डेटा वेयरहाउसिंग
जहाँ Athena ऐड-हॉक S3 डेटा क्वेरी के लिए आदर्श है, वहीं Amazon Redshift एक सुदृढ़, संरचित और जटिल एनालिटिक्स समाधान प्रदान करता है। आप कच्चे डेटा के त्वरित विश्लेषण के लिए Athena और अधिक गहन, उच्च-प्रदर्शन क्वेरीज के लिए Redshift का उपयोग कर सकते हैं।
यह एकीकरण S3 और Redshift के बीच डेटा मूवमेंट की अनुमति देता है, जिससे एक व्यापक एनालिटिक्स समाधान के लिए दोनों सेवाओं की ताकतों का लाभ उठाया जा सकता है।
निष्कर्ष
AWS Athena, AWS इकोसिस्टम में निहित एक शक्तिशाली क्वेरी इंजन है। S3 बकेट्स में संग्रहीत डेटा तक त्वरित पहुँच और क्वेरी परिणामों को उन्हीं S3 बकेट्स में सहेजने की सुविधा देकर, AWS Athena उपयोगकर्ताओं को अपने डेटा में अधिक लचीलापन के साथ गहराई तक जाने में सक्षम बनाता है। यह सर्वरलेस, स्केलेबल और सरल होने जैसी अन्य AWS सेवाओं के लाभ भी समेटता है।
यदि आप AWS के बारे में और सीखना चाहते हैं, तो DataCamp पर कई संसाधन उपलब्ध हैं:
FAQs
क्या AWS Athena का उपयोग Amazon S3 के बाहर संग्रहीत डेटा के साथ किया जा सकता है?
यद्यपि AWS Athena मुख्य रूप से Amazon S3 में संग्रहीत डेटा को क्वेरी करने के लिए डिज़ाइन किया गया है, इसे AWS Athena Federated Query का उपयोग करके अन्य स्रोतों से डेटा क्वेरी करने हेतु विस्तारित किया जा सकता है। डेटा सोर्स कनेक्टर्स का उपयोग करते हुए, यह सुविधा रिलेशनल डेटाबेस, ऑन-प्रिमाइसेस डेटा स्रोतों, और अन्य क्लाउड सेवाओं जैसे कई डेटा स्टोर्स में डेटा क्वेरी करने देती है।
Athena समय के साथ डेटा में होने वाले स्कीमा परिवर्तनों को कैसे संभालता है?
AWS Athena, AWS Glue Data Catalog के माध्यम से स्कीमा परिवर्तनों को संभालता है, जो स्कीमा वर्ज़निंग और इवोल्यूशन का समर्थन करता है। यह आपको समय के साथ अपने डेटा स्कीमा में होने वाले परिवर्तनों का प्रबंधन और ट्रैक करने देता है, जिससे आपका डेटा स्ट्रक्चर बदलते हुए भी क्वेरीज सुसंगत और सटीक बनी रहती हैं।
क्या किसी एकल अनुरोध में Athena द्वारा क्वेरी किए जाने वाले डेटा आकार की कोई सीमा है?
Athena उस डेटा आकार पर कोई सख्त सीमा नहीं लगाता जिसे वह एक ही अनुरोध में क्वेरी कर सके। हालाँकि, डेटा के आकार और जटिलता के आधार पर क्वेरी का प्रदर्शन भिन्न हो सकता है। विभाजन और कंप्रेशन जैसी सर्वोत्तम प्रथाएँ बड़े डेटासेट्स पर क्वेरी प्रदर्शन को अनुकूलित करने में मदद कर सकती हैं।
AWS Athena, Google BigQuery की तुलना में कैसा है?
AWS Athena और Google BigQuery दोनों बड़े पैमाने पर डेटा विश्लेषण के लिए सर्वरलेस क्वेरी इंजन हैं। हालाँकि इनमें समानताएँ हैं, पर प्रमुख भिन्नताओं में प्राइसिंग मॉडल, अन्य क्लाउड सेवाओं के साथ इंटीग्रेशन, और विभिन्न डेटा फॉर्मेट्स के लिए नैटिव समर्थन शामिल हैं। BigQuery आमतौर पर फ़्लैट-रेट या ऑन-डिमांड प्राइसिंग मॉडल का उपयोग करता है, जबकि Athena प्रति-क्वेरी प्राइसिंग मॉडल का उपयोग करता है। इसके अतिरिक्त, इंटीग्रेशन और उपयोग में सरलता आपके मौजूदा क्लाउड इंफ्रास्ट्रक्चर और आवश्यकताओं पर निर्भर कर सकती है।
क्या मैं AWS Athena में क्वेरीज को स्वचालित रूप से चलने के लिए शेड्यूल कर सकता/सकती हूँ?
आप AWS Lambda और Amazon CloudWatch Events जैसी AWS सेवाओं का उपयोग कर AWS Athena में क्वेरीज को शेड्यूल कर सकते हैं। CloudWatch में एक शेड्यूल्ड इवेंट बनाकर, आप एक Lambda फ़ंक्शन ट्रिगर कर सकते हैं जो परिभाषित अंतराल पर विशिष्ट Athena क्वेरी चलाता है, जिससे स्वचालित और आवर्ती डेटा विश्लेषण कार्य संभव होते हैं।

मैं एक डेटा साइंटिस्ट हूँ, जिसे स्पैटियल विश्लेषण, मशीन लर्निंग और डेटा पाइपलाइनों का अनुभव है। मैंने GCP, Hadoop, Hive, Snowflake, Airflow और अन्य डेटा साइंस/इंजीनियरिंग प्रक्रियाओं के साथ काम किया है।
AWS Athena एक शक्तिशाली, सर्वरलेस क्वेरी सेवा है जो आपको जटिल ETL प्रक्रियाओं या इंफ्रास्ट्रक्चर प्रबंधन के बिना, मानक SQL का उपयोग करके सीधे Amazon S3 में डेटा का विश्लेषण करने में सक्षम बनाती है।
इस ब्लॉग पोस्ट में, हम Athena की विशिष्ट क्षमताओं का अन्वेषण करेंगे, इसकी तुलना Amazon Redshift से करेंगे, इसके प्रमुख फीचर्स और लाभों की रूपरेखा बताएंगे, और आपको चरण-दर-चरण डेटा क्वेरी के लिए इसे सेट अप करना सिखाएंगे!
AWS Athena क्या है?
AWS Athena एक इंटरैक्टिव क्वेरी सेवा है जो उपयोगकर्ताओं को मानक SQL का उपयोग करके सीधे Amazon S3 में डेटा का विश्लेषण करने देती है।
Athena के साथ, आप S3 में संग्रहीत बड़े डेटासेट्स पर जटिल ETL प्रक्रियाओं के बिना SQL क्वेरी चला सकते हैं, जिससे यह त्वरित डेटा एक्सप्लोरेशन और गहन विश्लेषण के लिए एक शक्तिशाली टूल बन जाता है। यह लचीलापन एकल CSV फ़ाइल की जाँच से लेकर बड़े, विभाजित डेटासेट्स पर क्वेरी चलाने तक, तेज़ी से इनसाइट्स निकालने में मदद करता है।
AWS Athena का एक प्रमुख लाभ इसका सर्वरलेस आर्किटेक्चर है, जो अधोस्तरीय इंफ्रास्ट्रक्चर प्रबंधन की आवश्यकता समाप्त कर देता है—ना प्रोविजनिंग, ना स्केलिंग, ना सर्वर प्रबंधन। Athena किसी भी डेटा आकार—गीगाबाइट्स से पेटाबाइट्स तक—के अनुरूप स्वतः स्केल कर सकता है, वह भी बिना मैनुअल हस्तक्षेप के।
यह सर्वरलेस डिज़ाइन ओवरहेड कम करता है और तीव्र प्रयोग तथा परिनियोजन को सरल बनाता है, विशेष रूप से ऐसे वातावरणों में जहाँ वर्कलोड में उतार-चढ़ाव रहता है।
Athena का सर्वरलेस आर्किटेक्चर लागत-कुशल भी है, इसमें कोई अग्रिम लागत नहीं—उपयोगकर्ता केवल उन्हीं क्वेरीज के लिए भुगतान करते हैं जो वे चलाते हैं।
AWS Athena की विशेषताएँ
यहाँ कुछ विशेषताएँ हैं जो Athena को AWS इकोसिस्टम में एक अनूठी सेवा बनाती हैं।
1. सर्वरलेस आर्किटेक्चर
जैसा कि बताया गया, AWS Athena सर्वरलेस आर्किटेक्चर पर काम करता है, यानी आपको सर्वर प्रबंधन या कॉन्फ़िगर करने की ज़रूरत नहीं होती। यह डिज़ाइन Athena को क्वेरीज के आकार और जटिलता के आधार पर स्वतः स्केल करने देता है—छोटे डेटासेट्स से लेकर बड़े, मल्टी-पेटाबाइट वर्कलोड्स तक।
सर्वरलेस मॉडल अग्रिम इंफ्रास्ट्रक्चर लागतों की आवश्यकता समाप्त करता है, और आप केवल निष्पादित क्वेरीज के लिए भुगतान करते हैं—यह इसे लचीला और लागत-प्रभावी बनाता है।
2. AWS Glue और अन्य सेवाओं के साथ एकीकरण
Athena AWS Glue से एकीकृत होता है, जिसमें Glue Data Catalog शामिल है, जो पूरी तरह से प्रबंधित मेटाडेटा रिपॉज़िटरी है।
AWS Glue स्वचालित रूप से डेटा स्रोतों को क्रॉल कर आपके डेटासेट्स की खोज और कैटलॉग बना सकता है, और टेबल परिभाषाएँ, स्कीमा तथा लोकेशन जानकारी Glue Data Catalog में संग्रहीत करता है। यह एकीकरण Athena उपयोगकर्ताओं को बिना स्कीमा मैन्युअली परिभाषित किए या मेटाडेटा प्रबंधित किए, आसानी से डेटासेट्स क्वेरी करने देता है।
Glue Data Catalog वर्ज़निंग, स्कीमा इवोल्यूशन, और डेटा लिनिएज ट्रैकिंग जैसी सुविधाएँ भी प्रदान करता है, जो आपके डेटा एसेट्स की प्रबंधनीयता और ट्रेसबिलिटी बढ़ाती हैं।
इसके अलावा, Athena अन्य AWS सेवाओं से भी एकीकृत होता है, जैसे डेटा विज़ुअलाइज़ेशन के लिए Amazon QuickSight, ऑडिटिंग के लिए AWS CloudTrail, और डेटा स्टोरेज के लिए Amazon S3। यह सघन एकीकरण उपयोगकर्ताओं को AWS इकोसिस्टम के भीतर व्यापक डेटा पाइपलाइंस और एनालिटिक्स समाधान बनाने देता है।
3. मानक SQL का समर्थन
Athena मानक SQL का समर्थन करता है, जिससे आप परिचित SQL सिंटैक्स का उपयोग करके S3 में डेटा क्वेरी कर सकते हैं। इस समर्थन के चलते नए और अनुभवी—दोनों प्रकार के डेटा प्रैक्टिशनर बिना नई भाषा सीखे क्वेरी लिख और चला सकते हैं।
Athena का SQL इंजन Presto पर आधारित है, जो एक ओपन-सोर्स डिस्ट्रीब्यूटेड SQL क्वेरी इंजन है और जटिल जॉइन्स, विंडो फ़ंक्शंस, तथा एरे और मैप डेटा प्रकारों सहित शक्तिशाली व लचीली क्वेरी क्षमताएँ प्रदान करता है।
4. विभिन्न डेटा फॉर्मेट का समर्थन
Athena विभिन्न फॉर्मेट्स में संग्रहीत डेटा क्वेरी कर सकता है, जैसे CSV, JSON, Avro, Parquet, और ORC। Parquet और ORC जैसे कॉलमनर फॉर्मेट्स के समर्थन के जरिए, Athena केवल आवश्यक कॉलम स्कैन कर क्वेरी प्रदर्शन और लागत का अनुकूलन करता है, जिससे प्रोसेस होने वाला डेटा कम होता है।
5. स्केलेबिलिटी, विभाजन और प्रदर्शन
Athena किसी भी आकार के डेटासेट्स पर क्वेरीज को संभालने के लिए बनाया गया है और आपके वर्कलोड की माँग के अनुसार स्वतः स्केल करता है। यह डिफ़ॉल्ट रूप से क्वेरीज को समानांतर में चलाता है, जिससे बड़े पैमाने की क्वेरीज कुशलता से प्रोसेस हो पाती हैं।
Athena आपको S3 में अपने डेटा को पार्टिशन करने देता है, जिससे क्वेरी प्रदर्शन में नाटकीय सुधार होता है और लागत कम होती है। अपने डेटा को पार्टिशन (उदाहरण: तारीख या क्षेत्र के अनुसार) में व्यवस्थित करने से, Athena केवल प्रासंगिक हिस्सों को स्कैन करता है, और प्रोसेस होने वाले डेटा की मात्रा घटाता है।
6. सुरक्षा और अनुपालन फीचर्स
Athena आपके डेटा की सुरक्षा और विभिन्न विनियमों के अनुपालन को सुनिश्चित करने के लिए सशक्त सुरक्षा सुविधाएँ प्रदान करता है। यह एक्सेस कंट्रोल प्रबंधन हेतु AWS Identity and Access Management (IAM) से एकीकृत होता है, जिससे आप परिभाषित कर सकते हैं कि कौन से उपयोगकर्ता विशिष्ट डेटासेट्स और क्वेरी क्षमताओं तक पहुँच सकते हैं।
इसके अलावा, Athena डेटा को स्थिर अवस्था और ट्रांज़िट—दोनों में एन्क्रिप्शन का समर्थन करता है, जिससे आपका डेटा सुरक्षित बना रहता है। यह विभिन्न उद्योग मानकों और विनियमों का भी अनुपालन करता है, जिसके कारण यह सख्त अनुपालन आवश्यकताओं वाले वातावरण में उपयोग के लिए उपयुक्त है।