Apache Hadoop, जिसे अक्सर सिर्फ Hadoop कहा जाता है, एक शक्तिशाली ओपन-सोर्स फ्रेमवर्क है जिसे बड़े पैमाने पर डेटा सेट्स को सस्ती, कमर्शियल हार्डवेयर के क्लस्टर्स में वितरित करके प्रोसेस और स्टोर करने के लिए बनाया गया है। इसकी ताकत स्केलेबिलिटी और लचीलापन है, जो इसे संरचित और असंरचित दोनों प्रकार के डेटा के साथ काम करने में सक्षम बनाती है।
इस पोस्ट में, मैं Hadoop के प्रमुख घटकों से गुजरूँगा—यह बड़े पैमाने पर डेटा को कैसे स्टोर, प्रोसेस और मैनेज करता है। अंत तक, आपको यह स्पष्ट समझ होगी कि यह आधारभूत तकनीक बड़े डेटा इकोसिस्टम में कैसे फिट बैठती है।
Hadoop इकोसिस्टम का अवलोकन
Hadoop कोई एकल टूल नहीं है। यह एक इकोसिस्टम है जिसमें कई मॉड्यूल शामिल हैं जो डेटा स्टोरेज, प्रोसेसिंग और रिसोर्स कोऑर्डिनेशन को मिलकर संभालते हैं।
Hadoop के कोर मॉड्यूल
Hadoop चार बुनियादी मॉड्यूल से बना है:
- HDFS (Hadoop Distributed File System): एक वितरित स्टोरेज सिस्टम जो फाइलों को ब्लॉक्स में विभाजित करता है और उन्हें क्लस्टर में फैलाता है।
- MapReduce: एक प्रोग्रामिंग मॉडल जो नोड्स में समानांतर रूप से डेटा प्रोसेस करता है।
- YARN (Yet Another Resource Negotiator): क्लस्टर में रिसोर्स मैनेज करता है और जॉब्स शेड्यूल करता है।
- Hadoop Common: साझा लाइब्रेरीज़ और यूटिलिटीज़ का सेट जो अन्य मॉड्यूल का समर्थन करता है।
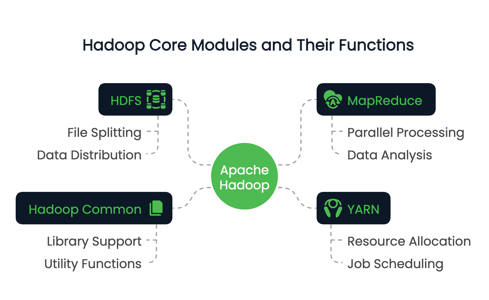
ये मॉड्यूल मिलकर एक वितरित कंप्यूटिंग वातावरण तैयार करते हैं जो पेटाबाइट्स डेटा संभालने में सक्षम है।
यह जानने के लिए कि विभिन्न प्लेटफॉर्म्स पर वितरित डेटा प्रोसेसिंग कैसे तुलना करती है, Big Data Fundamentals with PySpark कोर्स एक हस्त-परिचय देता है जो Hadoop की आपकी समझ को और पूरक करता है।
बड़े डेटा में Hadoop की भूमिका
Hadoop की प्राथमिक भूमिका चुनौती बिग डेटा प्रोसेसिंग में स्केलेबिलिटी की समस्या को सुलझाने में है।
पारंपरिक सिस्टम अक्सर ऐसे डेटा सेट्स के साथ जूझते हैं जो एक अकेली मशीन की स्टोरेज और कंप्यूटिंग क्षमता से अधिक होते हैं। Hadoop इसे कई नोड्स में डेटा वितरित करके और गणनाएँ समानांतर में चलाकर हल करता है।
इस तरह Hadoop टेराबाइट्स या पेटाबाइट्स तक के डेटा को कुशलतापूर्वक प्रोसेस कर सकता है। स्केलेबिलिटी के अलावा, Hadoop में डेटा प्रतिकृति के जरिए गहरा फॉल्ट टॉलरेंस होता है और यह कमर्शियल हार्डवेयर का उपयोग करते हुए किफायती डेटा इन्फ्रास्ट्रक्चर बनाने देता है।
Hadoop की प्रमुख विशेषताएँ
हमने Hadoop की भूमिका और संरचना पर चर्चा की है, अब Hadoop के कुछ सबसे उपयोगी गुणों को देखें। इनमें शामिल हैं:
- वितरित स्टोरेज और प्रोसेसिंग, जो इसे अत्यंत बड़े डेटा सेट्स को स्टोर करने और उन पर क्वेरी चलाने की सुविधा देती है।
- उच्च-स्तरीय मशीनों की आवश्यकता बिना क्षैतिज स्केलेबिलिटी।
- डेटा लोकैलिटी अनुकूलन, यानी गणना को वहाँ ले जाना जहाँ डेटा मौजूद है।
- प्रतिकृति और टास्क के पुनः-निष्पादन के माध्यम से विफलताओं के प्रति लचीलापन।
ये विशेषताएँ Hadoop को बैच डेटा प्रोसेसिंग, लॉग विश्लेषण और ETL पाइपलाइंस के लिए उपयुक्त बनाती हैं। Hadoop वितरित कंप्यूटिंग में एक क्लासिक केस स्टडी है distributed computing, जहाँ दक्षता और स्केल बढ़ाने के लिए कई नोड्स पर गणना होती है।
अब, Hadoop के प्रत्येक कोर मॉड्यूल को विस्तार से देखते हैं।
अपना Hadoop ज्ञान जाँचना या डेटा भूमिका के लिए तैयारी करना चाहते हैं? शुरुआत के लिए यहाँ 2025 के लिए 24 Hadoop इंटरव्यू प्रश्न और उत्तर हैं।
Hadoop Distributed File System (HDFS)
चार मुख्य घटकों में, HDFS Hadoop का प्राथमिक स्टोरेज सिस्टम है। इसे पहले बताए गए मशीनों के क्लस्टर में विशाल मात्रा में डेटा को विश्वसनीय रूप से स्टोर करने के लिए डिज़ाइन किया गया है। इसकी आर्किटेक्चर बड़े डेटा सेट्स तक पहुँच के इस प्रकार के लिए बनाई गई है और फॉल्ट टॉलरेंस, स्केलेबिलिटी और डेटा लोकैलिटी के लिए अनुकूलित है।
आर्किटेक्चर और घटक
HDFS की आर्किटेक्चर एक मास्टर-स्लेव मॉडल के इर्द-गिर्द घूमती है। सबसे ऊपर NameNode होता है, जो मेटाडेटा—असल में फाइल सिस्टम की डायरेक्टरी ट्री और प्रत्येक फाइल के लोकेशन की जानकारी—का प्रबंधन करता है। यह वास्तविक डेटा स्टोर नहीं करता।
DataNodes असली कार्यकर्ता हैं। वे नोड्स से जुड़े स्टोरेज का प्रबंधन करते हैं और क्लाइंट्स से रीड/राइट अनुरोधों को सर्व करते हैं। प्रत्येक DataNode नियमित रूप से NameNode को हार्टबीट और ब्लॉक रिपोर्ट्स भेजता है ताकि स्टेट ट्रैकिंग सुसंगत बनी रहे।
अंत में, HDFS में Secondary NameNode शामिल है, जिसे फेलओवर नोड समझने की गलती न करें। इसका काम समय-समय पर NameNode के मेटाडेटा का चेकपॉइंट बनाना है ताकि स्टार्टअप समय और मेमोरी ओवरहेड कम रहे।
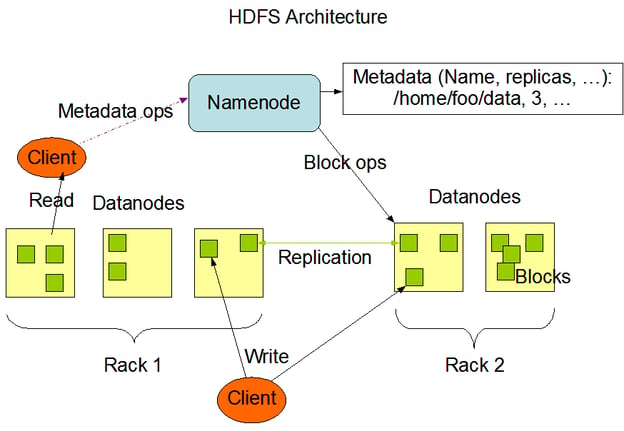
HDFS आर्किटेक्चर। छवि स्रोत: Apache Hadoop दस्तावेज़
HDFS में डेटा कैसे स्टोर होता है
जब कोई फाइल HDFS में लिखी जाती है, तो उसे निश्चित आकार के 64MB ब्लॉक्स में तोड़ा जाता है। प्रत्येक ब्लॉक फिर अलग-अलग DataNodes पर वितरित किया जाता है। यह रणनीति डेटा एक्सेस के दौरान पैरेललिज्म सक्षम करती है और फॉल्ट टॉलरेंस बढ़ाती है।
HDFS में डेटा सिर्फ एक बार स्टोर नहीं होता। प्रत्येक ब्लॉक की प्रतिकृति बनाई जाती है (डिफ़ॉल्ट रूप से तीन कॉपी) और क्लस्टर में फैलाई जाती है। रीड ऑपरेशन के दौरान, सिस्टम उपलब्ध निकटतम रेप्लिका से डेटा खींचता है ताकि थ्रूपुट अधिकतम हो और लैटेंसी न्यूनतम। राइट पहले एक रेप्लिका पर जाती है और फिर अन्य तक फैलती है, जिससे बिना तात्कालिक बाधा के टिकाऊपन सुनिश्चित होता है।
यह ब्लॉक-स्तरीय डिज़ाइन HDFS को क्षैतिज रूप से स्केल करने देता है। क्लस्टर में नए नोड्स जोड़े जा सकते हैं, और सिस्टम अतिरिक्त क्षमता के उपयोग के लिए डेटा को रीबैलेंस कर देगा।
अन्य बड़े डेटा फॉर्मैट्स के साथ तुलना के लिए, जानें कि Apache Parquet कैसे विश्लेषण वर्कलोड के लिए कॉलम-आधारित स्टोरेज को अनुकूलित करता है।
HDFS में फॉल्ट टॉलरेंस
HDFS विफलताओं को ध्यान में रखकर बनाया गया है। बड़े वितरित सिस्टम्स में नोड फेल्यर्स अपेक्षित होते हैं, असाधारण नहीं। HDFS अपनी प्रतिकृति प्रणाली के माध्यम से डेटा उपलब्धता सुनिश्चित करता है। यदि कोई DataNode डाउन हो जाता है, तो NameNode मिस्ड हार्टबीट्स के जरिए विफलता का पता लगाता है और खोए हुए ब्लॉक्स की प्रतिकृति स्वस्थ नोड्स पर शेड्यूल करता है।
साथ ही, सिस्टम लगातार ब्लॉक की सेहत की निगरानी करता है और आवश्यकता पड़ने पर प्रतिकृति शुरू करता है। अतिरिक्त स्टोरेज रणनीति और सक्रिय मॉनिटरिंग के संयोजन से यह सुनिश्चित होता है कि कोई एकल विफलता बिंदु डेटा अखंडता या एक्सेस से समझौता न कर सके।
MapReduce फ्रेमवर्क
अगला है Hadoop का प्रोसेसिंग इंजन, MapReduce। यह बड़े डेटा सेट्स में टास्क्स को छोटे, स्वतंत्र ऑपरेशंस में तोड़कर, जिन्हें समानांतर में चलाया जा सकता है, वितरित गणना सक्षम करता है।
यह मॉडल जटिल डेटा ट्रांसफॉर्मेशन्स को सरल बनाता है और विशेष रूप से वितरित वातावरण में बैच प्रोसेसिंग के लिए उपयुक्त है।
MapReduce का अवलोकन
MapReduce दो-चरणीय प्रोग्रामिंग मॉडल का अनुसरण करता है: Map और Reduce चरण।
Map चरण के दौरान, इनपुट डेटा सेट को छोटे हिस्सों में बाँटा जाता है और प्रत्येक हिस्से को प्रोसेस करके की-वैल्यू जोड़े बनाए जाते हैं। फिर ये इंटरमीडिएट परिणाम Reduce चरण में जाने से पहले शफल और सॉर्ट किए जाते हैं, जहाँ उन्हें एकत्रित या ट्रांसफॉर्म कर अंतिम आउटपुट बनाया जाता है।
यह मॉडल शब्द-आवृत्ति गिनने, लॉग फ़िल्टर करने, या बड़े पैमाने पर डेटा सेट्स को जॉइन करने जैसे कार्यों के लिए अत्यधिक प्रभावी है।
डेवलपर्स map() और reduce() फ़ंक्शंस के जरिए कस्टम लॉजिक लागू करते हैं, जिन्हें फ्रेमवर्क क्लस्टर में ऑर्केस्ट्रेट करता है।
MapReduce जॉब का निष्पादन प्रवाह
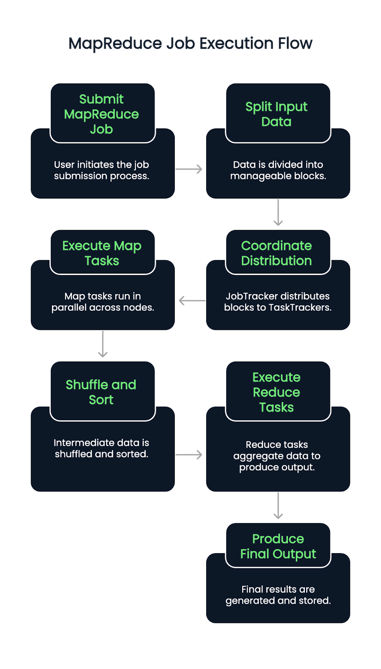
जब कोई MapReduce जॉब सबमिट होता है, तो सबसे पहले इनपुट डेटा को ब्लॉक्स में विभाजित किया जाता है। इसके बाद JobTracker (या YARN-सक्षम वर्ज़न में ResourceManager) इन ब्लॉक्स के वितरण का समन्वय उपलब्ध TaskTrackers या NodeManagers में करता है।
Map टास्क्स नोड्स पर समानांतर में चलते हैं, इनपुट स्प्लिट्स पढ़ते हैं और इंटरमीडिएट की-वैल्यू जोड़े उत्पन्न करते हैं। ये जोड़े स्वतः शफल और सॉर्ट होते हैं। इस चरण के पूर्ण होने पर Reduce टास्क्स शुरू होते हैं, समूहित डेटा लेकर एग्रेगेशन लॉजिक लागू करते हैं और अंतिम आउटपुट बनाते हैं।
यह प्रक्रिया डेटा लोकैलिटी सुनिश्चित करती है, यानी टास्क्स को उस स्थान के निकट असाइन करती है जहाँ डेटा रहता है, जिससे नेटवर्क कंजेशन कम होता है और थ्रूपुट बढ़ता है। टास्क विफलताओं का स्वतः पता चल जाता है और उन्हें पुनः असाइन किया जाता है, जो सिस्टम की लचीलापन बढ़ाता है।
MapReduce के लाभ और सीमाएँ
MapReduce कई स्पष्ट फायदे देता है:
- बड़े पैमाने पर बैच प्रोसेसिंग के लिए उत्कृष्ट पैरेललिज्म
- हज़ारों नोड्स तक स्केलेबिलिटी
- टास्क के पुनः-निष्पादन और चेकपॉइंटिंग के जरिए मजबूत फॉल्ट टॉलरेंस
लेकिन इसके साथ कुछ समझौते भी हैं:
- मॉडल में अधिक लैटेंसी होती है, इसलिए रीयल-टाइम प्रोसेसिंग के लिए कम उपयुक्त है
- कस्टम MapReduce जॉब लिखना मेहनत-भरा हो सकता है और डिबग करना कठिन
- इसमें नए टूल्स जैसे Apache Spark की इंटरैक्टिविटी और लचीलापन नहीं है।
Hadoop और Spark के बीच निर्णय ले रहे हैं? जानें कि कौन-सा Big Data फ्रेमवर्क आपके लिए उपयुक्त है।
YARN: Yet Another Resource Negotiator
YARN Hadoop की रिसोर्स मैनेजमेंट लेयर के रूप में काम करता है। यह जॉब शेड्यूलिंग और रिसोर्स अलोकेशन को प्रोसेसिंग मॉडल से अलग करता है, जिससे Hadoop MapReduce के अलावा कई डेटा प्रोसेसिंग इंजनों का समर्थन कर सकता है।
Hadoop आर्किटेक्चर में भूमिका
YARN क्लस्टर में कंप्यूट रिसोर्सेज को मैनेज करने का केंद्रीय प्लेटफ़ॉर्म है। यह कई एप्लिकेशंस को उपलब्ध सिस्टम रिसोर्सेज आवंटित करता है और निष्पादन का समन्वय करता है। यह जिम्मेदारियों का पृथक्करण Hadoop को कुशलतापूर्वक स्केल करने में मदद करता है और Apache Spark, Hive, और Tez जैसे अन्य फ्रेमवर्क्स के समर्थन का रास्ता खोलता है।
YARN के प्रमुख घटक
YARN तीन घटक पेश करता है:
- ResourceManager: मास्टर डेमन (बैकग्राउंड प्रोग्राम) जो सभी रिसोर्सेज मैनेज करता है और एप्लिकेशंस को शेड्यूल करता है।
- NodeManager: प्रति-नोड एजेंट जो रिसोर्स उपयोग की निगरानी करता है और ResourceManager को रिपोर्ट करता है।
- ApplicationMaster: जॉब-विशिष्ट ऑपरेशन जो ResourceManager से रिसोर्सेज लेकर NodeManagers के साथ निष्पादन का समन्वय करता है।
प्रत्येक एप्लिकेशन (जैसे कोई MapReduce जॉब) का अपना ApplicationMaster होता है, जो बेहतर फॉल्ट आइसोलेशन और जॉब ट्रैकिंग की सुविधा देता है।
YARN रिसोर्स मैनेजमेंट प्रक्रिया
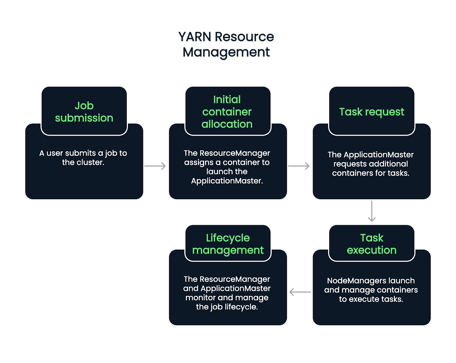
प्रवाह तब शुरू होता है जब कोई यूज़र जॉब सबमिट करता है। ResourceManager जॉब स्वीकार करता है और ApplicationMaster शुरू करने के लिए एक कंटेनर असाइन करता है। वहाँ से, ApplicationMaster वर्तमान वर्कलोड और उपलब्धता के आधार पर टास्क्स चलाने के लिए अधिक कंटेनर्स का अनुरोध करता है।
NodeManagers इन कंटेनर्स को लॉन्च और मैनेज करते हैं, जो व्यक्तिगत टास्क्स चलाते हैं। जॉब के पूरे जीवनचक्र में, ResourceManager और ApplicationMaster मॉनिटरिंग, फेल्योर रिकवरी, और समापन रिपोर्टिंग संभालते हैं। यानी, यह लगभग पाँच-चरणीय प्रक्रिया है।
- जॉब सबमिशन: यूज़र क्लस्टर में जॉब सबमिट करता है।
- प्रारंभिक कंटेनर अलोकेशन: ResourceManager जॉब स्वीकार करता है और ApplicationMaster लॉन्च करने के लिए कंटेनर असाइन करता है।
- टास्क अनुरोध: ApplicationMaster वर्कलोड और उपलब्ध रिसोर्सेज के आधार पर विशिष्ट टास्क्स चलाने के लिए अतिरिक्त कंटेनर्स का अनुरोध करता है।
- टास्क निष्पादन: NodeManagers इन कंटेनर्स को लॉन्च और मैनेज करते हैं, जो टास्क्स को अंजाम देते हैं।
- लाइफसाइकिल मैनेजमेंट: ResourceManager और ApplicationMaster मिलकर जॉब प्रगति की निगरानी करते हैं, विफलताओं को संभालते हैं, और टास्क पूर्णता की पुष्टि करते हैं।जॉब के पूरे जीवनचक्र में, ResourceManager और ApplicationMaster मॉनिटरिंग, फेल्योर रिकवरी, और समापन रिपोर्टिंग संभालते हैं।
Hadoop Common और यूटिलिटीज़
Hadoop के सभी घटकों को जोड़ने वाला गोंद Hadoop Common है। यह लाइब्रेरीज़, कॉन्फ़िग्रेशन फाइल्स और यूटिलिटीज़ का संग्रह है जिसकी सभी मॉड्यूल्स को आवश्यकता होती है।
Hadoop Common क्या है
Hadoop Common वह आधारभूत कोड और टूल्स प्रदान करता है जो HDFS, YARN और MapReduce को संचार और समन्वय करने देते हैं। इसमें Java लाइब्रेरीज़, फाइल सिस्टम क्लायंट्स, और APIs शामिल हैं जिनका उपयोग पूरे इकोसिस्टम में होता है।
यह मॉड्यूल्स के बीच स्थिरता और संगतता भी सुनिश्चित करता है, जिससे डेवलपर्स साझा प्रिमिटिव्स के सेट पर निर्माण कर सकें।
कॉन्फ़िग्रेशन और टूल्स का महत्व
Hadoop का सही कॉन्फ़िग्रेशन अत्यंत महत्वपूर्ण है। Hadoop Common में core-site.xml जैसी कॉन्फ़िग्रेशन फाइल्स होती हैं, जो डिफ़ॉल्ट व्यवहार जैसे फाइल सिस्टम URIs और I/O सेटिंग्स परिभाषित करती हैं।
कमांड-लाइन टूल्स और स्क्रिप्ट्स, जो Hadoop Common में शामिल हैं, सेवाओं को शुरू करने, नोड की सेहत जाँचने और जॉब्स मैनेज करने जैसे कार्यों में मदद करते हैं। सिस्टम एडमिनिस्ट्रेटर्स और डेवलपर्स रोज़मर्रा के क्लस्टर संचालन के लिए अधिकांशतः इन्हीं टूल्स पर निर्भर रहते हैं।
Hadoop के वास्तविक-जीवन अनुप्रयोग
यदि कहीं विशाल डेटा सेट्स, वितरित प्रोसेसिंग या बैच एनालिटिक्स का उपयोग होता है, तो संभावना है कि वहाँ Hadoop इस्तेमाल हो रहा हो। और अधिक विशेष रूप से, Hadoop विभिन्न उद्योगों में संरचित और असंरचित डेटा की भारी मात्रा को प्रोसेस करने के लिए उपयोग होता है। इसका वितरित डिज़ाइन और ओपन-सोर्स लचीलापन इसे डेटा-इंटेंसिव कार्यों के लिए बहुमुखी बनाता है।
Hadoop का लाभ उठाने वाले उद्योग
वित्त, स्वास्थ्य, दूरसंचार, ई-कॉमर्स और सोशल मीडिया की संस्थाएँ नियमित रूप से Hadoop का उपयोग करती हैं। यह बैंकों को रीयल-टाइम में धोखाधड़ी का पता लगाने, स्वास्थ्य सेवा में जीनोमिक अनुसंधान का समर्थन करने, और ऑनलाइन रिटेल में रिकमेंडेशन इंजन्स को सक्षम करने में मदद करता है।
उदाहरण उपयोग मामले
- लॉग प्रोसेसिंग: सर्वर्स और एप्लिकेशंस के लॉग डेटा का संग्रह और विश्लेषण।
- रिकमेंडेशन सिस्टम्स: ऐसे मॉडल बनाना जो कंटेंट या उत्पाद सुझाएँ।
- धोखाधड़ी का पता लगाना: ट्रांज़ैक्शंस में संदिग्ध व्यवहार पैटर्न की पहचान।
ये परिदृश्य बड़े डेटा सेट्स को फॉल्ट टॉलरेंस और पैरेललिज्म के साथ संभालने की Hadoop की क्षमता से लाभान्वित होते हैं।
Hadoop के आधुनिक, क्लाउड-नेटिव विकल्प के लिए, आज़माएँ Introduction to Databricks कोर्स, जो Spark और अन्य स्केलेबल टूल्स का समर्थन करता है।
अन्य टूल्स के साथ एकीकरण
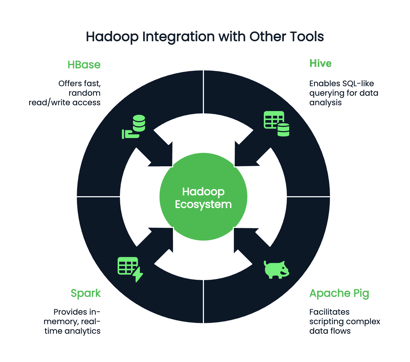
Hadoop शायद ही कभी अलग-थलग काम करता है और सैकड़ों एक्सेसरी प्रोग्राम्स के साथ इंटीग्रेट हो सकता है। आपकी पसंद और कोडिंग वातावरण के अनुसार, आप Hadoop को इनसे जोड़ सकते हैं:
- Hive: SQL-जैसी क्वेरी करने के लिए
- Apache Pig: जटिल डेटा फ्लोज़ के लिए स्क्रिप्टिंग
- Spark: इन-मैमोरी, रीयल-टाइम एनालिटिक्स के लिए
- HBase: बड़े डेटा सेट्स पर तेज़, रैंडम रीड/राइट एक्सेस के लिए
निष्कर्ष
भले ही Hadoop पहले जैसा चर्चा का विषय न रहा हो, यह बड़े डेटा परिदृश्य में एक आधारभूत तकनीक बना हुआ है। बड़े पैमाने के सिस्टम्स के साथ काम करने वाले किसी भी डेटा प्रोफेशनल के लिए Hadoop को समझना आज भी अत्यंत मूल्यवान है। इसके कोर घटक—स्टोरेज के लिए HDFS, प्रोसेसिंग के लिए MapReduce, रिसोर्स मैनेजमेंट के लिए YARN, और आवश्यक यूटिलिटीज़ के लिए Hadoop Common—अब भी डेटा वर्कफ्लोज़ के डिज़ाइन और स्केलिंग को आकार देते हैं।
डिप्लॉयमेंट या ऑप्टिमाइज़ेशन में कूदने से पहले, समय निकालकर समझें कि Hadoop क्लस्टर के भीतर डेटा कैसे वितरित और कॉन्फ़िगर होता है। यह ज्ञान ट्रबलशूटिंग और परफॉर्मेंस ट्यूनिंग को सरल बनाता है और Apache Spark तथा Hive जैसे शक्तिशाली टूल्स को एकीकृत कर उन्नत एनालिटिक्स का रास्ता तैयार करता है।
बड़े डेटा प्रोसेसिंग पर और जानकारी के लिए यह देखें:


Apache Hadoop, जिसे अक्सर सिर्फ Hadoop कहा जाता है, एक शक्तिशाली ओपन-सोर्स फ्रेमवर्क है जिसे बड़े पैमाने पर डेटा सेट्स को सस्ती, कमर्शियल हार्डवेयर के क्लस्टर्स में वितरित करके प्रोसेस और स्टोर करने के लिए बनाया गया है। इसकी ताकत स्केलेबिलिटी और लचीलापन है, जो इसे संरचित और असंरचित दोनों प्रकार के डेटा के साथ काम करने में सक्षम बनाती है।
इस पोस्ट में, मैं Hadoop के प्रमुख घटकों से गुजरूँगा—यह बड़े पैमाने पर डेटा को कैसे स्टोर, प्रोसेस और मैनेज करता है। अंत तक, आपको यह स्पष्ट समझ होगी कि यह आधारभूत तकनीक बड़े डेटा इकोसिस्टम में कैसे फिट बैठती है।
Hadoop इकोसिस्टम का अवलोकन
Hadoop कोई एकल टूल नहीं है। यह एक इकोसिस्टम है जिसमें कई मॉड्यूल शामिल हैं जो डेटा स्टोरेज, प्रोसेसिंग और रिसोर्स कोऑर्डिनेशन को मिलकर संभालते हैं।
Hadoop के कोर मॉड्यूल
Hadoop चार बुनियादी मॉड्यूल से बना है:
ये मॉड्यूल मिलकर एक वितरित कंप्यूटिंग वातावरण तैयार करते हैं जो पेटाबाइट्स डेटा संभालने में सक्षम है।
यह जानने के लिए कि विभिन्न प्लेटफॉर्म्स पर वितरित डेटा प्रोसेसिंग कैसे तुलना करती है, Big Data Fundamentals with PySpark कोर्स एक हस्त-परिचय देता है जो Hadoop की आपकी समझ को और पूरक करता है।
बड़े डेटा में Hadoop की भूमिका
Hadoop की प्राथमिक भूमिका चुनौती बिग डेटा प्रोसेसिंग में स्केलेबिलिटी की समस्या को सुलझाने में है।
पारंपरिक सिस्टम अक्सर ऐसे डेटा सेट्स के साथ जूझते हैं जो एक अकेली मशीन की स्टोरेज और कंप्यूटिंग क्षमता से अधिक होते हैं। Hadoop इसे कई नोड्स में डेटा वितरित करके और गणनाएँ समानांतर में चलाकर हल करता है।
इस तरह Hadoop टेराबाइट्स या पेटाबाइट्स तक के डेटा को कुशलतापूर्वक प्रोसेस कर सकता है। स्केलेबिलिटी के अलावा, Hadoop में डेटा प्रतिकृति के जरिए गहरा फॉल्ट टॉलरेंस होता है और यह कमर्शियल हार्डवेयर का उपयोग करते हुए किफायती डेटा इन्फ्रास्ट्रक्चर बनाने देता है।
Hadoop की प्रमुख विशेषताएँ
हमने Hadoop की भूमिका और संरचना पर चर्चा की है, अब Hadoop के कुछ सबसे उपयोगी गुणों को देखें। इनमें शामिल हैं:
ये विशेषताएँ Hadoop को बैच डेटा प्रोसेसिंग, लॉग विश्लेषण और ETL पाइपलाइंस के लिए उपयुक्त बनाती हैं। Hadoop वितरित कंप्यूटिंग में एक क्लासिक केस स्टडी है distributed computing, जहाँ दक्षता और स्केल बढ़ाने के लिए कई नोड्स पर गणना होती है।
अब, Hadoop के प्रत्येक कोर मॉड्यूल को विस्तार से देखते हैं।
अपना Hadoop ज्ञान जाँचना या डेटा भूमिका के लिए तैयारी करना चाहते हैं? शुरुआत के लिए यहाँ 2025 के लिए 24 Hadoop इंटरव्यू प्रश्न और उत्तर हैं।
Hadoop Distributed File System (HDFS)
चार मुख्य घटकों में, HDFS Hadoop का प्राथमिक स्टोरेज सिस्टम है। इसे पहले बताए गए मशीनों के क्लस्टर में विशाल मात्रा में डेटा को विश्वसनीय रूप से स्टोर करने के लिए डिज़ाइन किया गया है। इसकी आर्किटेक्चर बड़े डेटा सेट्स तक पहुँच के इस प्रकार के लिए बनाई गई है और फॉल्ट टॉलरेंस, स्केलेबिलिटी और डेटा लोकैलिटी के लिए अनुकूलित है।
आर्किटेक्चर और घटक
HDFS की आर्किटेक्चर एक मास्टर-स्लेव मॉडल के इर्द-गिर्द घूमती है। सबसे ऊपर NameNode होता है, जो मेटाडेटा—असल में फाइल सिस्टम की डायरेक्टरी ट्री और प्रत्येक फाइल के लोकेशन की जानकारी—का प्रबंधन करता है। यह वास्तविक डेटा स्टोर नहीं करता।
DataNodes असली कार्यकर्ता हैं। वे नोड्स से जुड़े स्टोरेज का प्रबंधन करते हैं और क्लाइंट्स से रीड/राइट अनुरोधों को सर्व करते हैं। प्रत्येक DataNode नियमित रूप से NameNode को हार्टबीट और ब्लॉक रिपोर्ट्स भेजता है ताकि स्टेट ट्रैकिंग सुसंगत बनी रहे।
अंत में, HDFS में Secondary NameNode शामिल है, जिसे फेलओवर नोड समझने की गलती न करें। इसका काम समय-समय पर NameNode के मेटाडेटा का चेकपॉइंट बनाना है ताकि स्टार्टअप समय और मेमोरी ओवरहेड कम रहे।
HDFS आर्किटेक्चर। छवि स्रोत: Apache Hadoop दस्तावेज़
HDFS में डेटा कैसे स्टोर होता है
जब कोई फाइल HDFS में लिखी जाती है, तो उसे निश्चित आकार के 64MB ब्लॉक्स में तोड़ा जाता है। प्रत्येक ब्लॉक फिर अलग-अलग DataNodes पर वितरित किया जाता है। यह रणनीति डेटा एक्सेस के दौरान पैरेललिज्म सक्षम करती है और फॉल्ट टॉलरेंस बढ़ाती है।
HDFS में डेटा सिर्फ एक बार स्टोर नहीं होता। प्रत्येक ब्लॉक की प्रतिकृति बनाई जाती है (डिफ़ॉल्ट रूप से तीन कॉपी) और क्लस्टर में फैलाई जाती है। रीड ऑपरेशन के दौरान, सिस्टम उपलब्ध निकटतम रेप्लिका से डेटा खींचता है ताकि थ्रूपुट अधिकतम हो और लैटेंसी न्यूनतम। राइट पहले एक रेप्लिका पर जाती है और फिर अन्य तक फैलती है, जिससे बिना तात्कालिक बाधा के टिकाऊपन सुनिश्चित होता है।
यह ब्लॉक-स्तरीय डिज़ाइन HDFS को क्षैतिज रूप से स्केल करने देता है। क्लस्टर में नए नोड्स जोड़े जा सकते हैं, और सिस्टम अतिरिक्त क्षमता के उपयोग के लिए डेटा को रीबैलेंस कर देगा।
अन्य बड़े डेटा फॉर्मैट्स के साथ तुलना के लिए, जानें कि Apache Parquet कैसे विश्लेषण वर्कलोड के लिए कॉलम-आधारित स्टोरेज को अनुकूलित करता है।
HDFS में फॉल्ट टॉलरेंस
HDFS विफलताओं को ध्यान में रखकर बनाया गया है। बड़े वितरित सिस्टम्स में नोड फेल्यर्स अपेक्षित होते हैं, असाधारण नहीं। HDFS अपनी प्रतिकृति प्रणाली के माध्यम से डेटा उपलब्धता सुनिश्चित करता है। यदि कोई DataNode डाउन हो जाता है, तो NameNode मिस्ड हार्टबीट्स के जरिए विफलता का पता लगाता है और खोए हुए ब्लॉक्स की प्रतिकृति स्वस्थ नोड्स पर शेड्यूल करता है।
साथ ही, सिस्टम लगातार ब्लॉक की सेहत की निगरानी करता है और आवश्यकता पड़ने पर प्रतिकृति शुरू करता है। अतिरिक्त स्टोरेज रणनीति और सक्रिय मॉनिटरिंग के संयोजन से यह सुनिश्चित होता है कि कोई एकल विफलता बिंदु डेटा अखंडता या एक्सेस से समझौता न कर सके।
MapReduce फ्रेमवर्क
अगला है Hadoop का प्रोसेसिंग इंजन, MapReduce। यह बड़े डेटा सेट्स में टास्क्स को छोटे, स्वतंत्र ऑपरेशंस में तोड़कर, जिन्हें समानांतर में चलाया जा सकता है, वितरित गणना सक्षम करता है।
यह मॉडल जटिल डेटा ट्रांसफॉर्मेशन्स को सरल बनाता है और विशेष रूप से वितरित वातावरण में बैच प्रोसेसिंग के लिए उपयुक्त है।
MapReduce का अवलोकन
MapReduce दो-चरणीय प्रोग्रामिंग मॉडल का अनुसरण करता है: Map और Reduce चरण।
Map चरण के दौरान, इनपुट डेटा सेट को छोटे हिस्सों में बाँटा जाता है और प्रत्येक हिस्से को प्रोसेस करके की-वैल्यू जोड़े बनाए जाते हैं। फिर ये इंटरमीडिएट परिणाम Reduce चरण में जाने से पहले शफल और सॉर्ट किए जाते हैं, जहाँ उन्हें एकत्रित या ट्रांसफॉर्म कर अंतिम आउटपुट बनाया जाता है।
यह मॉडल शब्द-आवृत्ति गिनने, लॉग फ़िल्टर करने, या बड़े पैमाने पर डेटा सेट्स को जॉइन करने जैसे कार्यों के लिए अत्यधिक प्रभावी है।
डेवलपर्स
map()औरreduce()फ़ंक्शंस के जरिए कस्टम लॉजिक लागू करते हैं, जिन्हें फ्रेमवर्क क्लस्टर में ऑर्केस्ट्रेट करता है।MapReduce जॉब का निष्पादन प्रवाह
जब कोई MapReduce जॉब सबमिट होता है, तो सबसे पहले इनपुट डेटा को ब्लॉक्स में विभाजित किया जाता है। इसके बाद JobTracker (या YARN-सक्षम वर्ज़न में ResourceManager) इन ब्लॉक्स के वितरण का समन्वय उपलब्ध TaskTrackers या NodeManagers में करता है।
Map टास्क्स नोड्स पर समानांतर में चलते हैं, इनपुट स्प्लिट्स पढ़ते हैं और इंटरमीडिएट की-वैल्यू जोड़े उत्पन्न करते हैं। ये जोड़े स्वतः शफल और सॉर्ट होते हैं। इस चरण के पूर्ण होने पर Reduce टास्क्स शुरू होते हैं, समूहित डेटा लेकर एग्रेगेशन लॉजिक लागू करते हैं और अंतिम आउटपुट बनाते हैं।
यह प्रक्रिया डेटा लोकैलिटी सुनिश्चित करती है, यानी टास्क्स को उस स्थान के निकट असाइन करती है जहाँ डेटा रहता है, जिससे नेटवर्क कंजेशन कम होता है और थ्रूपुट बढ़ता है। टास्क विफलताओं का स्वतः पता चल जाता है और उन्हें पुनः असाइन किया जाता है, जो सिस्टम की लचीलापन बढ़ाता है।
MapReduce के लाभ और सीमाएँ
MapReduce कई स्पष्ट फायदे देता है:
लेकिन इसके साथ कुछ समझौते भी हैं:
Hadoop और Spark के बीच निर्णय ले रहे हैं? जानें कि कौन-सा Big Data फ्रेमवर्क आपके लिए उपयुक्त है।
YARN: Yet Another Resource Negotiator
YARN Hadoop की रिसोर्स मैनेजमेंट लेयर के रूप में काम करता है। यह जॉब शेड्यूलिंग और रिसोर्स अलोकेशन को प्रोसेसिंग मॉडल से अलग करता है, जिससे Hadoop MapReduce के अलावा कई डेटा प्रोसेसिंग इंजनों का समर्थन कर सकता है।
Hadoop आर्किटेक्चर में भूमिका
YARN क्लस्टर में कंप्यूट रिसोर्सेज को मैनेज करने का केंद्रीय प्लेटफ़ॉर्म है। यह कई एप्लिकेशंस को उपलब्ध सिस्टम रिसोर्सेज आवंटित करता है और निष्पादन का समन्वय करता है। यह जिम्मेदारियों का पृथक्करण Hadoop को कुशलतापूर्वक स्केल करने में मदद करता है और Apache Spark, Hive, और Tez जैसे अन्य फ्रेमवर्क्स के समर्थन का रास्ता खोलता है।
YARN के प्रमुख घटक
YARN तीन घटक पेश करता है:
प्रत्येक एप्लिकेशन (जैसे कोई MapReduce जॉब) का अपना ApplicationMaster होता है, जो बेहतर फॉल्ट आइसोलेशन और जॉब ट्रैकिंग की सुविधा देता है।
YARN रिसोर्स मैनेजमेंट प्रक्रिया
प्रवाह तब शुरू होता है जब कोई यूज़र जॉब सबमिट करता है। ResourceManager जॉब स्वीकार करता है और ApplicationMaster शुरू करने के लिए एक कंटेनर असाइन करता है। वहाँ से, ApplicationMaster वर्तमान वर्कलोड और उपलब्धता के आधार पर टास्क्स चलाने के लिए अधिक कंटेनर्स का अनुरोध करता है।
NodeManagers इन कंटेनर्स को लॉन्च और मैनेज करते हैं, जो व्यक्तिगत टास्क्स चलाते हैं। जॉब के पूरे जीवनचक्र में, ResourceManager और ApplicationMaster मॉनिटरिंग, फेल्योर रिकवरी, और समापन रिपोर्टिंग संभालते हैं। यानी, यह लगभग पाँच-चरणीय प्रक्रिया है।
Hadoop Common और यूटिलिटीज़
Hadoop के सभी घटकों को जोड़ने वाला गोंद Hadoop Common है। यह लाइब्रेरीज़, कॉन्फ़िग्रेशन फाइल्स और यूटिलिटीज़ का संग्रह है जिसकी सभी मॉड्यूल्स को आवश्यकता होती है।
Hadoop Common क्या है
Hadoop Common वह आधारभूत कोड और टूल्स प्रदान करता है जो HDFS, YARN और MapReduce को संचार और समन्वय करने देते हैं। इसमें Java लाइब्रेरीज़, फाइल सिस्टम क्लायंट्स, और APIs शामिल हैं जिनका उपयोग पूरे इकोसिस्टम में होता है।
यह मॉड्यूल्स के बीच स्थिरता और संगतता भी सुनिश्चित करता है, जिससे डेवलपर्स साझा प्रिमिटिव्स के सेट पर निर्माण कर सकें।
कॉन्फ़िग्रेशन और टूल्स का महत्व
Hadoop का सही कॉन्फ़िग्रेशन अत्यंत महत्वपूर्ण है। Hadoop Common में
core-site.xmlजैसी कॉन्फ़िग्रेशन फाइल्स होती हैं, जो डिफ़ॉल्ट व्यवहार जैसे फाइल सिस्टम URIs और I/O सेटिंग्स परिभाषित करती हैं।कमांड-लाइन टूल्स और स्क्रिप्ट्स, जो Hadoop Common में शामिल हैं, सेवाओं को शुरू करने, नोड की सेहत जाँचने और जॉब्स मैनेज करने जैसे कार्यों में मदद करते हैं। सिस्टम एडमिनिस्ट्रेटर्स और डेवलपर्स रोज़मर्रा के क्लस्टर संचालन के लिए अधिकांशतः इन्हीं टूल्स पर निर्भर रहते हैं।
Hadoop के वास्तविक-जीवन अनुप्रयोग
यदि कहीं विशाल डेटा सेट्स, वितरित प्रोसेसिंग या बैच एनालिटिक्स का उपयोग होता है, तो संभावना है कि वहाँ Hadoop इस्तेमाल हो रहा हो। और अधिक विशेष रूप से, Hadoop विभिन्न उद्योगों में संरचित और असंरचित डेटा की भारी मात्रा को प्रोसेस करने के लिए उपयोग होता है। इसका वितरित डिज़ाइन और ओपन-सोर्स लचीलापन इसे डेटा-इंटेंसिव कार्यों के लिए बहुमुखी बनाता है।
Hadoop का लाभ उठाने वाले उद्योग
वित्त, स्वास्थ्य, दूरसंचार, ई-कॉमर्स और सोशल मीडिया की संस्थाएँ नियमित रूप से Hadoop का उपयोग करती हैं। यह बैंकों को रीयल-टाइम में धोखाधड़ी का पता लगाने, स्वास्थ्य सेवा में जीनोमिक अनुसंधान का समर्थन करने, और ऑनलाइन रिटेल में रिकमेंडेशन इंजन्स को सक्षम करने में मदद करता है।
उदाहरण उपयोग मामले
ये परिदृश्य बड़े डेटा सेट्स को फॉल्ट टॉलरेंस और पैरेललिज्म के साथ संभालने की Hadoop की क्षमता से लाभान्वित होते हैं।
Hadoop के आधुनिक, क्लाउड-नेटिव विकल्प के लिए, आज़माएँ Introduction to Databricks कोर्स, जो Spark और अन्य स्केलेबल टूल्स का समर्थन करता है।
अन्य टूल्स के साथ एकीकरण
Hadoop शायद ही कभी अलग-थलग काम करता है और सैकड़ों एक्सेसरी प्रोग्राम्स के साथ इंटीग्रेट हो सकता है। आपकी पसंद और कोडिंग वातावरण के अनुसार, आप Hadoop को इनसे जोड़ सकते हैं:
निष्कर्ष
भले ही Hadoop पहले जैसा चर्चा का विषय न रहा हो, यह बड़े डेटा परिदृश्य में एक आधारभूत तकनीक बना हुआ है। बड़े पैमाने के सिस्टम्स के साथ काम करने वाले किसी भी डेटा प्रोफेशनल के लिए Hadoop को समझना आज भी अत्यंत मूल्यवान है। इसके कोर घटक—स्टोरेज के लिए HDFS, प्रोसेसिंग के लिए MapReduce, रिसोर्स मैनेजमेंट के लिए YARN, और आवश्यक यूटिलिटीज़ के लिए Hadoop Common—अब भी डेटा वर्कफ्लोज़ के डिज़ाइन और स्केलिंग को आकार देते हैं।
डिप्लॉयमेंट या ऑप्टिमाइज़ेशन में कूदने से पहले, समय निकालकर समझें कि Hadoop क्लस्टर के भीतर डेटा कैसे वितरित और कॉन्फ़िगर होता है। यह ज्ञान ट्रबलशूटिंग और परफॉर्मेंस ट्यूनिंग को सरल बनाता है और Apache Spark तथा Hive जैसे शक्तिशाली टूल्स को एकीकृत कर उन्नत एनालिटिक्स का रास्ता तैयार करता है।
बड़े डेटा प्रोसेसिंग पर और जानकारी के लिए यह देखें: