
{count, plural, one {Kursus} other {Kursus}}
Bekerja dengan OpenAI API
{hours} jam
181K
Misalkan Anda membangun pipeline yang harus menangani penalaran kode multi-langkah yang kompleks dan peringkasan dokumen untuk klien. Model mana yang akan Anda pilih? Itulah jenis pertanyaan yang membuat perbandingan ini berguna, bukan sebagai latihan benchmark, melainkan sebagai keputusan praktis yang menentukan apa yang benar-benar dapat dilakukan sistem Anda.
Berikut perbedaan DeepSeek dan Claude dalam arsitektur, kinerja, dan harga, agar Anda dapat memilih berdasarkan beban kerja sebenarnya.
Jika Anda tertarik dengan model AI terbaru, pastikan juga membaca panduan kami tentang Muse Spark dari Meta.
DeepSeek adalah keluarga model AI yang dikembangkan oleh perusahaan riset Tiongkok Hangzhou DeepSeek Artificial Intelligence, dibangun untuk tugas-tugas dengan penalaran, pengodean, dan logika yang berat. Sebagian besar modelnya tersedia bebas sebagai bobot terbuka di bawah Lisensi MIT, yang menjadi salah satu alasan rilis DeepSeek-R1 pada Januari 2025 begitu diperhatikan. Model ini menyamai kualitas penalaran model proprietary terkemuka dengan biaya pelatihan yang jauh lebih rendah.
Lininya berkembang cepat. DeepSeek-V3 (Desember 2024) menetapkan baseline serbaguna yang solid, sementara R1 memperkenalkan model penalaran khusus yang dilatih dengan reinforcement learning, dirancang untuk mengurai masalah langkah demi langkah sebelum menjawab. DeepSeek-V3.1 hadir dengan arsitektur hibrida yang beralih antara mode "berpikir" dan "non-berpikir" dalam satu deployment. DeepSeek V4 banyak dinantikan sebagai rilis besar berikutnya, dengan laporan awal yang mengarah pada pengodean yang lebih kuat, rekayasa perangkat lunak konteks panjang, dan dukungan multimodal native.
Kekuatan DeepSeek terletak pada rantai logika, presisi penalaran terstruktur, dan inferensi cepat. Ini cocok secara alami untuk pengembang yang mengerjakan tugas analitis atau sarat kode.
Claude adalah keluarga model AI dari Anthropic, dibangun di atas filosofi inti penalaran yang selaras: membuat model yang cakap, konsisten, jujur, dan lebih kecil kemungkinannya menyimpang. Keluarga Claude 4 saat ini mencakup Haiku 4.5 (cepat dan ringan), Sonnet 4.6 (andalan untuk penggunaan sehari-hari), dan Opus 4.6 (unggulan untuk penalaran kompleks dan tugas konteks panjang).
Yang membedakan Claude adalah kefasihan percakapan, kepatuhan instruksi yang bernuansa, dan perilaku berorientasi keamanan. Model Claude bersifat multimodal, menangani teks, gambar, dan dokumen. Opus 4.6 dan Sonnet 4.6 sama-sama mendukung jendela konteks 1 juta token, salah satu yang terbesar pada 2026. Bagi tim yang membangun alat untuk klien atau alur kerja enterprise di mana keandalan penting, prioritas desain tersebut berujung pada manfaat nyata dan praktis.
DeepSeek mendekati kecerdasan dari sudut pandang penalaran terlebih dahulu. Garis keturunan R1-nya dilatih dengan reinforcement learning untuk mengembangkan penalaran chain-of-thought yang eksplisit, sehingga model mengerjakan masalah secara metodis sebelum menjawab. Hal ini tampak jelas pada matematika, logika, dan kode: solusi terstruktur, langkah demi langkah, yang mudah diaudit.
Claude dilatih dengan Constitutional AI, teknik alignment dari Anthropic, yang membentuk penalarannya menuju perilaku yang aman, koheren, dan jujur. Hasilnya adalah generalis yang cakap secara luas alih-alih terspesialisasi sempit. Perbedaan ini juga muncul saat prompt ambigu. DeepSeek cenderung membutuhkan rekayasa prompt yang lebih presisi dalam skenario terbuka, sementara Claude menangani pergeseran percakapan dengan baik dan biasanya menyimpulkan maksud tanpa banyak pengarahan.
Claude Opus 4.6 dan Sonnet 4.6 mendukung jendela 1 juta token dengan harga standar. DeepSeek-V3.1 mendukung hingga 128K token. Dalam inferensi, arsitektur Mixture-of-Experts DeepSeek (671B total parameter, 37B aktif per token) menjaga biaya tetap rendah dengan hanya mengaktifkan sebagian jaringan per permintaan. Arsitektur Claude bersifat proprietary, tetapi kinerjanya di berbagai tugas penalaran, pengodean, dan multimodal telah mapan dalam evaluasi independen.
Perbedaan kinerja memang ada, tetapi bergantung pada tugas. Tidak ada model yang unggul di semua aspek.
DeepSeek sangat terspesialisasi di sini. Model R1-nya dibangun untuk menampilkan langkah penalaran, menjadikannya cocok untuk masalah di mana Anda perlu memverifikasi jalannya, bukan hanya jawabannya: algoritme, bukti, matematika formal. Claude mendekati penalaran melalui lensa generalis, membuatnya lebih kuat untuk sintesis dan tugas berbasis penilaian yang memadukan bukti, konteks, dan nuansa. Jika masalahnya memiliki struktur formal, keluaran chain-of-thought DeepSeek sering lebih mudah diaudit. Jika membutuhkan penimbangan berbagai perspektif, Claude cenderung lebih baik.
DeepSeek secara khusus disesuaikan untuk penalaran kode, dengan hasil kuat pada tantangan algoritmik dan tugas pengodean terisolasi. Claude cenderung unggul dalam pekerjaan rekayasa perangkat lunak yang lebih luas: memahami arsitektur multi-berkas, melakukan refaktor di proyek besar, menalar desain sistem lintas banyak percakapan. Untuk skrip cepat atau debug fungsi spesifik, DeepSeek adalah pilihan solid. Untuk tinjauan kode atau pekerjaan tingkat proyek yang kompleks, koherensi konteks panjang Claude menjadi keunggulan nyata.
Claude diakui luas atas kefasihan bahasa alaminya. Pelatihannya secara eksplisit memberi ganjaran prosa yang koheren dan terstruktur baik, menjadikannya pilihan lebih kuat untuk konten yang menghadap klien, ringkasan yang rapi, atau apa pun yang memerlukan nada tulisan yang tepat. DeepSeek menangani generasi teks dengan baik, tetapi kualitas keluarannya lebih bergantung pada tugas dan cenderung ringkas pada prompt terbuka.
Claude melacak instruksi multi-bagian secara andal sepanjang percakapan panjang, bahkan ketika prompt berkembang atau memuat banyak batasan sekaligus. DeepSeek juga menangani prompt kompleks, tetapi diuntungkan oleh penataan yang lebih eksplisit, terutama dalam pengaturan percakapan atau multi-giliran.
Claude Opus 4.6 dan Sonnet 4.6 mendukung jendela 1 juta token dengan akurasi pengambilan yang kuat di teks panjang. DeepSeek memproses konteks panjang dengan baik dalam jendela 128K miliknya. Untuk sebagian besar beban kerja, keduanya mampu; kesenjangan paling berarti pada ukuran konteks yang sangat besar atau ketika pengambilan "jarum di tumpukan jerami" yang presisi menjadi prioritas.
Skor benchmark yang dipublikasikan berubah antar pembaruan model dan bervariasi signifikan menurut tugas dan gaya prompt. Perlakukan perbandingan spesifik mana pun sebagai sinyal arah, bukan vonis. Uji paling andal adalah menjalankan kedua model pada use case Anda yang sebenarnya.
Pelatihan chain-of-thought eksplisit DeepSeek menjadikannya pilihan kuat untuk tantangan algoritmik, pembuktian matematika, dan debug kode di mana Anda perlu model menampilkan prosesnya. Pengembang yang menginginkan model andal berbiaya rendah untuk tugas analitis akan menemukan API DeepSeek sangat kompetitif.
Claude lebih cocok ketika Anda memerlukan teks yang natural dan fasih: merangkum riset, menyusun komunikasi untuk klien, atau menghasilkan laporan yang akan dibaca audiens nonteknis. Koherensi percakapannya di interaksi multi-giliran juga membuatnya cocok untuk membangun asisten atau chatbot.
Pelatihan Constitutional AI Claude mengurangi kemungkinan keluaran yang berbahaya, bias, atau melenceng. Tim di bidang kesehatan, pendidikan, atau teknologi hukum, di mana perilaku model pada kasus tepi membawa risiko nyata, sebaiknya mempertimbangkan desain keamanan Claude secara serius. Sifat DeepSeek yang terbuka memberi Anda lebih banyak kendali atas fine-tuning dan deployment, tetapi juga menempatkan lebih banyak tanggung jawab pada tim Anda untuk mengelola keselamatan keluaran.
Arsitektur efisien DeepSeek membuat inferensi sangat terjangkau. Bobot berlisensi MIT dapat diunduh dan dijalankan secara lokal. Untuk tugas volume tinggi, proyek dengan anggaran terbatas, atau tim yang ingin self-host, harga dan fleksibilitas deployment DeepSeek sulit ditandingi.
Kedua model mendukung pelengkapan dan generasi kode di berbagai bahasa populer, tetapi kekuatan mereka berbeda pada tingkat tugas. DeepSeek berkinerja baik untuk generasi fokus: menulis fungsi spesifik, mengimplementasikan algoritme, atau menghasilkan unit test. Claude cenderung lebih kuat pada tugas refaktor yang memerlukan pemahaman konteks arsitektur yang lebih luas, seperti menamai ulang pola secara konsisten, mengidentifikasi masalah desain, atau menjelaskan mengapa struktur tertentu akan menimbulkan masalah di hilir.
Untuk integrasi API, Claude memiliki dukungan mendalam di AWS Bedrock, Google Vertex AI, dan Microsoft Foundry. Opus 4.6 dirancang untuk tugas agen multi-langkah berjangka panjang. DeepSeek dapat diakses melalui platform.deepseek.com dan melalui ekosistem penyedia pihak ketiga yang berkembang; bobot terbukanya menjadikannya pilihan populer bagi tim yang membangun tumpukan inferensi self-hosted.
Claude menangani peringkasan dan tanya jawab terbuka dengan baik. Responsnya terorganisasi, peka konteks, dan mudah dibaca, serta secara alami mensintesis banyak sumber menjadi jawaban yang koheren. Pada pengikutan instruksi kompleks, Claude melacak semua persyaratan secara andal pada keluaran yang panjang. DeepSeek berkinerja kompetitif pada tanya jawab terstruktur dan pengambilan fakta, meski diuntungkan oleh penataan langkah demi langkah yang lebih eksplisit pada prompt.
Tentang halusinasi: pelatihan yang selaras dengan keselamatan pada Claude membuatnya lebih mungkin berhati-hati atau menolak ketika tidak yakin, yang mengurangi kesalahan percaya diri tetapi kadang menghasilkan respons yang terlalu berhati-hati. Model penalaran DeepSeek umumnya lebih andal pada tugas dengan jawaban yang dapat diverifikasi, namun masih dapat menghasilkan kesalahan percaya diri di luar data latihannya. Keduanya tidak kebal, dan keduanya diuntungkan dari pengaturan dengan retrieval augmentation saat akurasi faktual krusial.
Claude adalah model sepenuhnya proprietary yang dapat diakses melalui tingkatan langganan Anthropic (gratis, Pro, dan Max) serta API berbasis token yang mencakup Haiku 4.5, Sonnet 4.6, dan Opus 4.6. Akses bisnis tersedia melalui paket Team dan Enterprise. Semua akses berbasis cloud melalui Anthropic atau penyedia mitra; tidak ada bobot terbuka.
DeepSeek menawarkan bobot model secara gratis di bawah Lisensi MIT, sehingga deployment self-hosted layak untuk tim dengan infrastruktur GPU. DeepSeek juga menyediakan API hosted di platform.deepseek.com dengan harga per token, termasuk penghematan signifikan melalui caching prompt, sehingga menarik untuk beban kerja ber-volume tinggi.
Bagi kebanyakan tim, keputusan bermuara pada kebutuhan deployment dan jenis beban kerja. Biaya per token yang rendah dan opsi self-hosting DeepSeek cocok untuk lingkungan dengan anggaran terbatas atau yang mengutamakan privasi. Integrasi cloud mendalam Claude lebih masuk akal saat Anda beroperasi dalam tumpukan enterprise yang ada atau memerlukan SLA uptime terjamin.
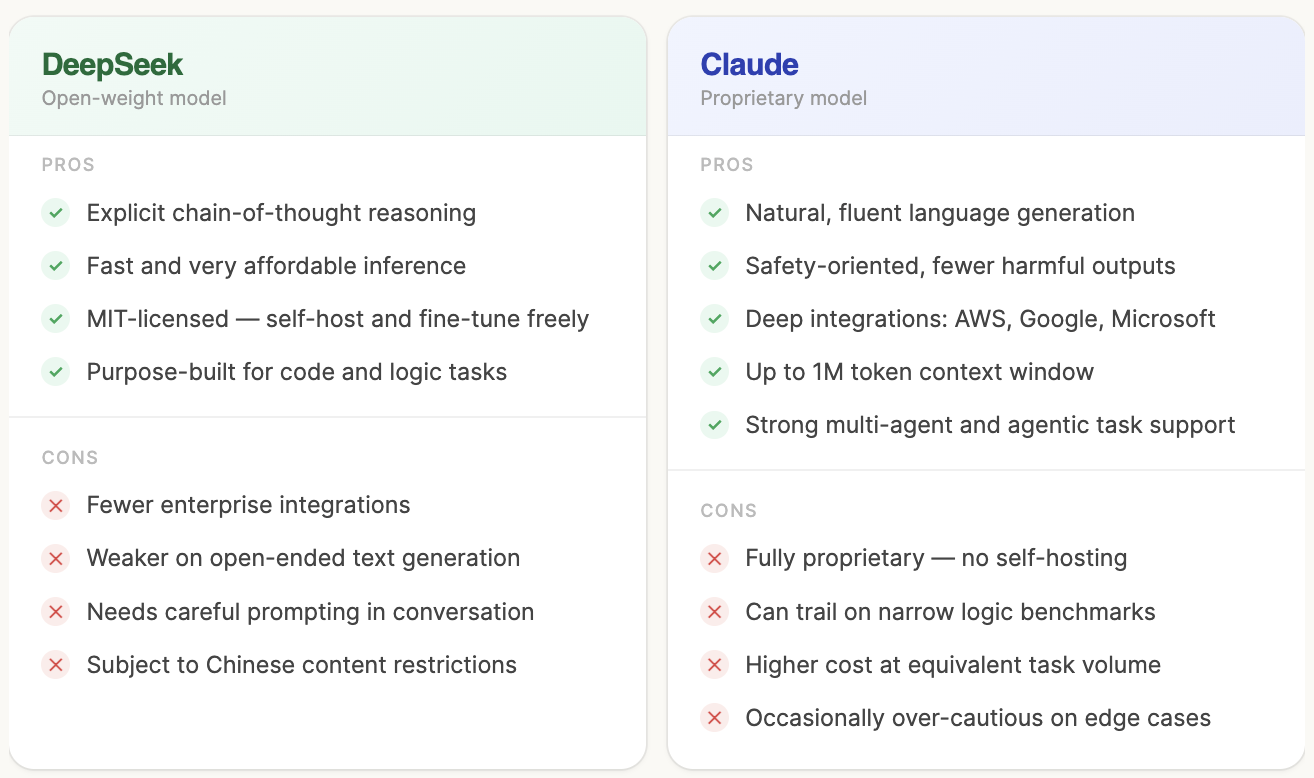
Keduanya adalah model yang andal dan didukung dengan baik, yang melayani kebutuhan berbeda secara bermakna. Lisensi terbuka, inferensi cepat, dan presisi penalaran DeepSeek menjadikannya cocok untuk pengembang yang mengerjakan tugas sarat kode atau intensif logika yang memerlukan infrastruktur berbiaya rendah dan dapat di-host sendiri. Filosofi alignment, kefasihan bahasa, dan ekosistem enterprise Claude menjadikannya pilihan lebih baik untuk aplikasi yang menghadap klien, alur kerja sensitif keselamatan, atau di mana kualitas bahasa alami dan perilaku yang dapat diprediksi sangat berarti.
Pertanyaan yang lebih berguna bukanlah model mana yang lebih baik: melainkan apa yang benar-benar dituntut oleh beban kerja Anda. Dalam banyak arsitektur dunia nyata, ada alasan kuat untuk menggunakan keduanya, merutekan tugas berdasarkan jenisnya alih-alih berkomitmen secara eksklusif pada satu penyedia.
Belajar bersama DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt




