

Khóa học
Làm việc với OpenAI API
3 giờ
183.7K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleGiả sử bạn đang xây dựng một pipeline cần xử lý lập luận mã nhiều bước phức tạp và tóm tắt tài liệu hướng tới khách hàng. Bạn sẽ chọn mô hình nào? Đó là kiểu câu hỏi khiến bài so sánh này hữu ích, không phải như một bài kiểm thử chuẩn, mà như một quyết định thực tiễn định hình những gì hệ thống của bạn thực sự có thể làm được.
Dưới đây là cách DeepSeek và Claude khác nhau về kiến trúc, hiệu năng và giá, để bạn có thể lựa chọn dựa trên khối lượng công việc thực tế.
Nếu bạn quan tâm đến các mô hình AI cập nhật, hãy xem thêm hướng dẫn của chúng tôi về Muse Spark của Meta.
DeepSeek là một họ mô hình AI do công ty nghiên cứu Trung Quốc Hangzhou DeepSeek Artificial Intelligence phát triển, tập trung vào các nhiệm vụ lập luận, viết mã và logic nặng. Hầu hết các mô hình của họ được cung cấp miễn phí dưới dạng trọng số mở theo Giấy phép MIT, đó cũng là lý do đợt phát hành DeepSeek-R1 vào tháng 1/2025 gây tiếng vang lớn. Nó đạt chất lượng lập luận tương đương các mô hình độc quyền hàng đầu với chi phí huấn luyện chỉ bằng một phần nhỏ.
Danh mục sản phẩm tiến hóa rất nhanh. DeepSeek-V3 (tháng 12/2024) thiết lập nền tảng mục đích chung vững chắc, trong khi R1 giới thiệu mô hình lập luận chuyên biệt được huấn luyện bằng học tăng cường, thiết kế để giải quyết vấn đề theo từng bước trước khi trả lời. DeepSeek-V3.1 tiếp nối với kiến trúc lai, chuyển đổi giữa chế độ "suy nghĩ" và "không suy nghĩ" trong một triển khai duy nhất. DeepSeek V4 được kỳ vọng rộng rãi là bản phát hành lớn tiếp theo, với những báo cáo sớm cho thấy khả năng viết mã mạnh hơn, kỹ nghệ phần mềm ngữ cảnh dài và hỗ trợ đa phương thức gốc.
Điểm mạnh của DeepSeek là chuỗi logic, độ chính xác của lập luận có cấu trúc và suy luận nhanh. Đây là lựa chọn tự nhiên cho các nhà phát triển làm việc trên các tác vụ phân tích hoặc nặng về mã.
Claude là họ mô hình AI của Anthropic, được xây dựng dựa trên triết lý cốt lõi về lập luận được căn chỉnh: tạo ra các mô hình có năng lực, nhất quán, trung thực và ít đi chệch hướng hơn. Dòng Claude 4 hiện tại gồm Haiku 4.5 (nhanh và gọn nhẹ), Sonnet 4.6 (lực điền hằng ngày), và Opus 4.6 (đầu bảng cho lập luận phức tạp và tác vụ ngữ cảnh dài).
Điều làm nên khác biệt của Claude là độ trôi chảy hội thoại, khả năng tuân thủ chỉ dẫn tinh tế và hành vi ưu tiên an toàn. Các mô hình Claude là đa phương thức, xử lý văn bản, hình ảnh và tài liệu. Opus 4.6 và Sonnet 4.6 đều hỗ trợ cửa sổ ngữ cảnh 1 triệu token, thuộc hàng lớn nhất vào năm 2026. Với các đội xây dựng công cụ hướng tới khách hàng hoặc quy trình doanh nghiệp nơi độ tin cậy là quan trọng, những ưu tiên thiết kế đó chuyển hóa thành lợi ích thực tế, hữu hình.
DeepSeek tiếp cận trí tuệ theo góc nhìn ưu tiên lập luận. Dòng R1 được huấn luyện bằng học tăng cường để phát triển lập luận chuỗi suy nghĩ rõ ràng, vì vậy mô hình giải quyết vấn đề một cách có phương pháp trước khi trả lời. Bạn có thể thấy điều này rõ ràng trong toán, logic và mã: lời giải có cấu trúc, từng bước, dễ kiểm tra.
Claude được huấn luyện bằng Constitutional AI, kỹ thuật căn chỉnh của Anthropic, định hướng lập luận của mô hình theo an toàn, mạch lạc và tạo phản hồi trung thực. Kết quả là một nhà tổng quát có năng lực rộng thay vì chuyên biệt hẹp. Khác biệt này cũng bộc lộ với các lời nhắc mơ hồ. DeepSeek thường cần kỹ thuật nhắc chính xác hơn trong các kịch bản mở, trong khi Claude xử lý trôi dạt hội thoại tốt và thường suy đoán được ý định mà không cần chỉ dẫn quá chi tiết.
Claude Opus 4.6 và Sonnet 4.6 hỗ trợ cửa sổ 1M token với mức giá tiêu chuẩn. DeepSeek-V3.1 hỗ trợ tối đa 128K token. Về suy luận, kiến trúc Mixture-of-Experts của DeepSeek (671B tham số tổng, 37B kích hoạt mỗi token) giữ chi phí thấp bằng cách chỉ kích hoạt một phần mạng cho mỗi yêu cầu. Kiến trúc của Claude là độc quyền, nhưng hiệu năng của nó trên các tác vụ lập luận, viết mã và đa phương thức đã được khẳng định qua các đánh giá độc lập.
Khác biệt hiệu năng là có thật, nhưng phụ thuộc vào tác vụ. Không mô hình nào dẫn đầu trên mọi phương diện.
DeepSeek rất chuyên sâu ở mảng này. Mô hình R1 được xây để thể hiện các bước lập luận, phù hợp với những vấn đề bạn cần xác minh lộ trình chứ không chỉ đáp án: thuật toán, chứng minh, toán hình thức. Claude tiếp cận lập luận theo lăng kính tổng quát, khiến nó mạnh hơn trong các tác vụ tổng hợp và đánh giá cần pha trộn bằng chứng, bối cảnh và sắc thái. Nếu vấn đề có cấu trúc hình thức, đầu ra chuỗi suy nghĩ của DeepSeek thường dễ kiểm tra hơn. Nếu cần cân nhắc nhiều góc nhìn, Claude thường làm tốt hơn.
DeepSeek được điều chỉnh đặc thù cho lập luận về mã, với kết quả mạnh trên các thử thách thuật toán và tác vụ mã tách biệt. Claude thường vượt trội trong công việc kỹ nghệ phần mềm rộng hơn: hiểu kiến trúc đa tệp, tái cấu trúc trên một dự án lớn, lập luận về thiết kế hệ thống qua nhiều lượt tương tác. Với script nhanh hoặc gỡ lỗi một hàm cụ thể, DeepSeek là lựa chọn vững vàng. Với rà soát mã hoặc công việc cấp độ dự án phức tạp, tính mạch lạc ngữ cảnh dài của Claude trở thành lợi thế thực sự.
Claude được công nhận rộng rãi về độ trôi chảy ngôn ngữ tự nhiên. Việc huấn luyện của nó ưu tiên văn bản mạch lạc, có cấu trúc tốt, khiến nó là lựa chọn mạnh hơn cho nội dung hướng tới khách hàng, bản tóm tắt trau chuốt hoặc bất cứ thứ gì coi trọng giọng điệu. DeepSeek xử lý tạo văn bản tốt, nhưng chất lượng đầu ra phụ thuộc nhiều vào tác vụ và có xu hướng ngắn gọn với các lời nhắc mở.
Claude theo dõi chỉ dẫn nhiều phần một cách đáng tin cậy xuyên suốt các cuộc hội thoại dài, ngay cả khi lời nhắc tiến hóa hoặc mang nhiều ràng buộc đồng thời. DeepSeek cũng xử lý lời nhắc phức tạp, nhưng hưởng lợi từ cấu trúc rõ ràng hơn, đặc biệt trong bối cảnh hội thoại hoặc nhiều lượt.
Claude Opus 4.6 và Sonnet 4.6 hỗ trợ cửa sổ 1M token với độ chính xác truy xuất mạnh trên văn bản dài. DeepSeek xử lý ngữ cảnh dài tốt trong cửa sổ 128K của mình. Với hầu hết khối lượng công việc, cả hai đều đủ năng lực; khoảng cách quan trọng nhất ở kích thước ngữ cảnh rất lớn hoặc khi ưu tiên truy xuất chính xác kiểu “mò kim đáy bể”.
Điểm số công bố trên các bài kiểm thử chuẩn thay đổi giữa các bản cập nhật mô hình và khác biệt đáng kể theo tác vụ và phong cách lời nhắc. Hãy coi mọi so sánh cụ thể như tín hiệu định hướng, không phải phán quyết. Bài kiểm tra đáng tin cậy nhất là chạy cả hai mô hình trên trường hợp sử dụng thực tế của bạn.
Huấn luyện chuỗi suy nghĩ rõ ràng của DeepSeek khiến nó là lựa chọn mạnh cho thử thách thuật toán, chứng minh toán học và gỡ lỗi mã nơi bạn cần mô hình “trình bày cách làm”. Các nhà phát triển muốn một mô hình có năng lực, chi phí thấp cho tác vụ phân tích sẽ thấy API DeepSeek rất cạnh tranh.
Claude phù hợp hơn khi bạn cần văn bản tự nhiên, trôi chảy: tóm tắt nghiên cứu, soạn thông điệp cho khách hàng hoặc tạo báo cáo cho độc giả không chuyên. Tính mạch lạc hội thoại qua nhiều lượt cũng khiến Claude rất phù hợp để xây dựng trợ lý hoặc chatbot.
Huấn luyện theo Constitutional AI của Claude giảm khả năng tạo đầu ra gây hại, thiên kiến hoặc lệch mục tiêu. Các đội trong y tế, giáo dục hoặc công nghệ pháp lý, nơi hành vi mô hình ở các tình huống biên mang rủi ro thực, nên cân nhắc nghiêm túc thiết kế an toàn của Claude. Tính mở của DeepSeek cho bạn nhiều quyền kiểm soát hơn về tinh chỉnh và triển khai, nhưng cũng đặt nhiều trách nhiệm hơn lên đội ngũ để quản lý an toàn đầu ra.
Kiến trúc hiệu quả của DeepSeek khiến chi phí suy luận rất phải chăng. Trọng số theo giấy phép MIT có thể tải xuống và chạy cục bộ. Với các tác vụ khối lượng lớn, dự án hạn chế ngân sách hoặc đội muốn tự lưu trữ, giá và linh hoạt triển khai của DeepSeek rất khó vượt qua.
Cả hai mô hình đều hỗ trợ hoàn thành và tạo mã trên các ngôn ngữ phổ biến, nhưng điểm mạnh khác nhau ở cấp tác vụ. DeepSeek thể hiện tốt ở tạo có trọng tâm: viết một hàm cụ thể, hiện thực thuật toán hoặc tạo bài kiểm thử đơn vị. Claude thường mạnh hơn ở tác vụ tái cấu trúc đòi hỏi hiểu bối cảnh kiến trúc rộng hơn, như đổi tên mẫu nhất quán, xác định vấn đề thiết kế hoặc giải thích vì sao một cấu trúc cụ thể sẽ gây vấn đề về sau.
Về tích hợp API, Claude có hỗ trợ sâu trên AWS Bedrock, Google Vertex AI và Microsoft Foundry. Opus 4.6 được thiết kế cho tác vụ tác tử đa bước, tầm nhìn dài. DeepSeek có thể truy cập qua platform.deepseek.com và thông qua hệ sinh thái nhà cung cấp bên thứ ba đang phát triển; trọng số mở khiến nó phổ biến với các đội xây dựng cụm suy luận tự lưu trữ.
Claude xử lý tóm tắt và Hỏi-Đáp mở tốt. Phản hồi được tổ chức, nhận biết bối cảnh và dễ đọc, và tự nhiên tổng hợp nhiều nguồn thành câu trả lời mạch lạc. Với theo dõi chỉ dẫn phức tạp, Claude bám sát mọi yêu cầu đáng tin cậy xuyên suốt đầu ra dài. DeepSeek thể hiện cạnh tranh ở Hỏi-Đáp có cấu trúc và truy xuất thực tế, dù hưởng lợi từ việc cấu trúc từng bước rõ ràng hơn trong lời nhắc.
Về ảo giác: huấn luyện căn chỉnh an toàn của Claude khiến nó có xu hướng dè dặt hoặc từ chối khi không chắc chắn, giúp cắt giảm lỗi tự tin nhưng đôi khi tạo phản hồi quá thận trọng. Các mô hình lập luận của DeepSeek nhìn chung đáng tin cậy hơn ở tác vụ có đáp án kiểm chứng được, nhưng vẫn có thể tạo lỗi tự tin ngoài dữ liệu huấn luyện. Không mô hình nào miễn nhiễm, và cả hai đều hưởng lợi từ thiết lập tăng cường truy xuất khi độ chính xác thực tế là tối quan trọng.
Claude là mô hình hoàn toàn độc quyền, truy cập qua các gói đăng ký của Anthropic (miễn phí, Pro và Max) và API tính phí theo token bao gồm Haiku 4.5, Sonnet 4.6 và Opus 4.6. Truy cập doanh nghiệp qua gói Team và Enterprise. Tất cả truy cập đều dựa trên đám mây thông qua Anthropic hoặc đối tác; không có trọng số mở.
DeepSeek cung cấp trọng số mô hình miễn phí theo Giấy phép MIT, cho phép triển khai tự lưu trữ khả thi với các đội có hạ tầng GPU. Họ cũng cung cấp API lưu trữ tại platform.deepseek.com với giá tính theo token, tiết kiệm đáng kể nhờ bộ nhớ đệm prompt, hấp dẫn cho khối lượng công việc lớn.
Với hầu hết các đội, quyết định phụ thuộc vào nhu cầu triển khai và loại khối lượng công việc. Chi phí mỗi token thấp và lựa chọn tự lưu trữ của DeepSeek phù hợp với môi trường hạn chế ngân sách hoặc ưu tiên quyền riêng tư. Tích hợp đám mây sâu của Claude hợp lý hơn khi bạn vận hành trong hạ tầng doanh nghiệp sẵn có hoặc cần SLA thời gian hoạt động được đảm bảo.
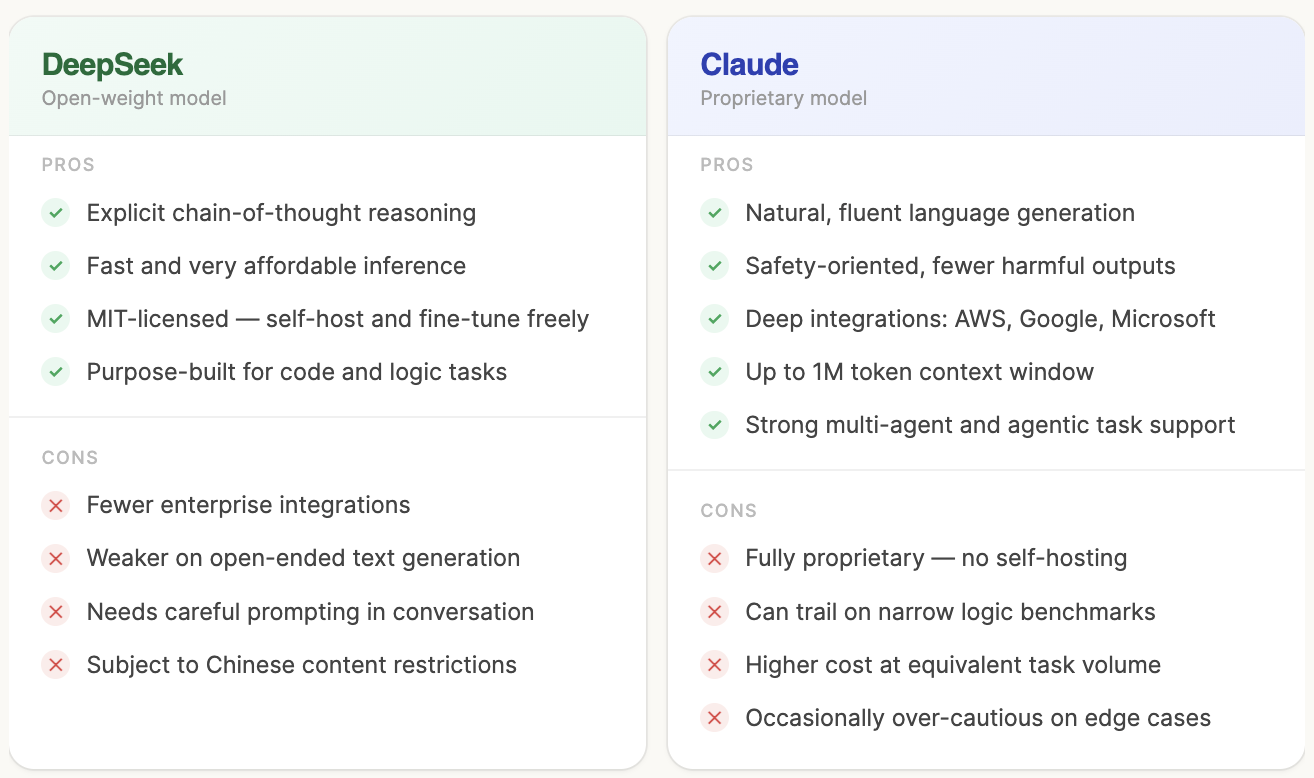
Cả hai đều là mô hình mạnh, được hỗ trợ tốt và phục vụ những nhu cầu khác nhau một cách có ý nghĩa. Giấy phép mở, suy luận nhanh và độ chính xác lập luận của DeepSeek khiến nó phù hợp với nhà phát triển làm việc trên nhiệm vụ nặng về mã hoặc logic, cần hạ tầng chi phí thấp, có thể tự lưu trữ. Triết lý căn chỉnh, độ trôi chảy ngôn ngữ và hệ sinh thái doanh nghiệp của Claude khiến nó là lựa chọn tốt hơn cho ứng dụng hướng tới khách hàng, quy trình nhạy cảm về an toàn, hoặc bất cứ nơi nào chất lượng ngôn ngữ tự nhiên và hành vi có thể dự đoán mang trọng lượng thực sự.
Câu hỏi hữu ích hơn không phải mô hình nào tốt hơn, mà là khối lượng công việc của bạn thực sự đòi hỏi gì. Trong nhiều kiến trúc thực tế, có lý do vững chắc để dùng cả hai, định tuyến tác vụ theo loại thay vì cam kết độc quyền với một nhà cung cấp.
Học cùng DataCamp
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
