
कोर्स
OpenAI API के साथ काम करना
3 घंटा
179.5K
मान लीजिए आप एक ऐसी पाइपलाइन बना रहे हैं जिसे जटिल बहु‑चरणीय कोड तर्क और क्लाइंट‑उन्मुख दस्तावेज़ सारांशण संभालना है। आप किस मॉडल को चुनेंगे? ऐसे ही प्रश्न इस तुलना को उपयोगी बनाते हैं—बेंचमार्क अभ्यास के रूप में नहीं, बल्कि एक व्यावहारिक निर्णय के रूप में जो तय करता है कि आपका सिस्टम वास्तव में क्या कर सकता है।
यहाँ बताया गया है कि वास्तुकला, प्रदर्शन, और मूल्य निर्धारण में DeepSeek और Claude कैसे अलग हैं, ताकि आप अपने वास्तविक वर्कलोड के आधार पर चुन सकें।
यदि आप नवीनतम AI मॉडलों में रुचि रखते हैं, तो Meta के Muse Spark पर हमारी गाइड भी देखें।
DeepSeek चीनी अनुसंधान कंपनी Hangzhou DeepSeek Artificial Intelligence द्वारा विकसित AI मॉडलों का एक परिवार है, जिसे उन्नत तर्क, कोडिंग, और तर्क‑प्रधान कार्यों के लिए बनाया गया है। इसके अधिकांश मॉडल MIT लाइसेंस के अंतर्गत ओपन वेट्स के रूप में निःशुल्क उपलब्ध हैं, और यही कारण है कि जनवरी 2025 में DeepSeek-R1 की रिलीज़ इतनी महत्वपूर्ण रही—इसने प्रशिक्षण लागत के एक छोटे हिस्से में अग्रणी स्वामित्व वाले मॉडलों की तर्क गुणवत्ता की बराबरी की।
लाइनअप तेज़ी से विकसित हुआ है। DeepSeek-V3 (दिसंबर 2024) ने एक सुदृढ़ सामान्य‑उद्देश्यीय आधार रेखा स्थापित की, जबकि R1 ने सुदृढ़ीकरण शिक्षण के साथ प्रशिक्षित एक समर्पित तर्क मॉडल पेश किया, जिसे उत्तर देने से पहले समस्याओं को चरण दर चरण हल करने के लिए डिज़ाइन किया गया है। DeepSeek-V3.1 इसके बाद एक हाइब्रिड आर्किटेक्चर के साथ आया जो एक ही डिप्लॉयमेंट में "सोचने" और "नॉन‑थिंकिंग" मोड के बीच स्विच करता है। अगली बड़ी रिलीज़ के रूप में DeepSeek V4 से व्यापक उम्मीदें हैं, शुरुआती रिपोर्टों के अनुसार इसमें बेहतर कोडिंग, लंबी संदर्भ वाली सॉफ्टवेयर इंजीनियरिंग, और मूल मल्टीमोडल सपोर्ट की ओर इशारा है।
DeepSeek की ताकतें हैं लॉजिक चेन, संरचित तर्क की शुद्धता, और तेज़ इन्फ़रेंस। यह विश्लेषणात्मक या कोड‑प्रधान कार्यों पर काम करने वाले डेवलपर्स के लिए स्वाभाविक रूप से उपयुक्त है।
Claude, Anthropic का AI मॉडल परिवार है, जो संरेखित तर्क की मुख्य दर्शनशास्त्र पर आधारित है: ऐसे मॉडल बनाना जो सक्षम, सुसंगत, ईमानदार हों और विषय से भटकने की संभावना कम हो। वर्तमान Claude 4 परिवार में Haiku 4.5 (तेज़ और हल्का), Sonnet 4.6 (दैनिक कार्यों का भरोसेमंद मॉडल), और Opus 4.6 (जटिल तर्क और लंबी संदर्भ वाली टास्क का फ़्लैगशिप) शामिल हैं।
Claude की विशेषता है इसकी वार्तालापीय प्रवाहशीलता, सूक्ष्म निर्देश पालन, और सुरक्षा‑उन्मुख व्यवहार। Claude मॉडल मल्टीमोडल हैं—टेक्स्ट, छवियाँ और दस्तावेज़ संभालते हैं। Opus 4.6 और Sonnet 4.6 दोनों 1 मिलियन टोकन का कॉन्टेक्स्ट विंडो सपोर्ट करते हैं, जो 2026 में उपलब्ध सबसे बड़े विंडो में से एक है। क्लाइंट‑उन्मुख टूल्स या ऐसे एंटरप्राइज़ वर्कफ़्लो बनाने वाली टीमों के लिए, जहाँ विश्वसनीयता मायने रखती है, ये डिज़ाइन प्राथमिकताएँ वास्तविक और व्यावहारिक लाभों में बदल जाती हैं।
DeepSeek बुद्धिमत्ता को reasoning‑first दृष्टिकोण से देखता है। इसकी R1 शृंखला को सुदृढ़ीकरण शिक्षण से स्पष्ट चेन‑ऑफ‑थॉट तर्क विकसित करने हेतु प्रशिक्षित किया गया, इसलिए मॉडल उत्तर देने से पहले व्यवस्थित रूप से समस्याओं पर काम करता है। यह बात गणित, तर्क, और कोड में स्पष्ट दिखती है: संरचित, चरणबद्ध समाधान जो ऑडिट करना आसान हैं।
Claude को Constitutional AI—Anthropic की एलाइनमेंट तकनीक—से प्रशिक्षित किया गया है, जो इसके तर्क को सुरक्षा, सुसंगति, और ईमानदार उत्तर निर्माण की ओर आकार देती है। परिणामस्वरूप यह एक जनरलिस्ट है जो संकीर्ण रूप से विशेषज्ञ होने के बजाय व्यापक रूप से सक्षम है। यह अंतर अस्पष्ट प्रॉम्प्ट्स में भी दिखता है। खुले‑आम परिदृश्यों में DeepSeek को प्रॉम्प्ट इंजीनियरिंग में अधिक सटीकता की ज़रूरत पड़ती है, जबकि Claude वार्तालाप के बहाव को अच्छी तरह संभालता है और आमतौर पर बिना ज़्यादा मार्गदर्शन के आशय का अनुमान लगा लेता है।
Claude Opus 4.6 और Sonnet 4.6 मानक मूल्य पर 1M टोकन विंडो सपोर्ट करते हैं। DeepSeek‑V3.1 अधिकतम 128K टोकन तक सपोर्ट करता है। इन्फ़रेंस पर, DeepSeek की Mixture‑of‑Experts आर्किटेक्चर (कुल 671B पैरामीटर्स, प्रति टोकन 37B सक्रिय) प्रति अनुरोध केवल नेटवर्क का एक हिस्सा सक्रिय कर लागत कम रखती है। Claude की आर्किटेक्चर स्वामित्व वाली है, लेकिन तर्क, कोडिंग, और मल्टीमोडल कार्यों में इसका प्रदर्शन स्वतंत्र मूल्याँकनों में अच्छी तरह स्थापित है।
प्रदर्शन में अंतर वास्तविक हैं, लेकिन वे कार्य‑निर्भर हैं। कोई भी मॉडल हर क्षेत्र में अग्रणी नहीं है।
यहाँ DeepSeek अत्यधिक विशिष्ट है। इसका R1 मॉडल अपने तर्क के चरण दिखाने के लिए बनाया गया था, जिससे यह उन समस्याओं के लिए उपयुक्त हो जाता है जहाँ आपको केवल उत्तर नहीं, बल्कि पहुँचे गए मार्ग का सत्यापन चाहिए—एल्गोरिदम, प्रूफ़, औपचारिक गणित। Claude तर्क को जनरलिस्ट नज़रिए से अपनाता है, जिससे यह ऐसे संश्लेषण और जजमेंट‑आधारित कार्यों में मज़बूत होता है जो साक्ष्य, संदर्भ, और बारीकी का मिश्रण माँगते हैं। यदि समस्या का औपचारिक ढाँचा है, तो DeepSeek का चेन‑ऑफ़‑थॉट आउटपुट अक्सर ऑडिट में आसान पड़ता है। यदि विभिन्न दृष्टिकोणों का भारांकन चाहिए, तो Claude प्रायः बेहतर करता है।
DeepSeek विशेष रूप से कोड तर्क के लिए तैयार किया गया है, और एल्गोरिदमिक चुनौतियों तथा पृथक कोडिंग कार्यों पर मज़बूत परिणाम देता है। व्यापक सॉफ्टवेयर इंजीनियरिंग कार्यों में—मल्टी‑फ़ाइल आर्किटेक्चर समझना, बड़े प्रोजेक्ट में रिफैक्टरिंग, अनेक चरणों में सिस्टम डिज़ाइन पर तर्क करना—Claude आगे निकलता है। त्वरित स्क्रिप्ट्स या किसी विशिष्ट फ़ंक्शन को डीबग करने के लिए DeepSeek ठोस विकल्प है। कोड रिव्यू या जटिल प्रोजेक्ट‑स्तरीय काम में Claude की लंबी संदर्भ सुसंगति वास्तविक बढ़त देती है।
प्राकृतिक भाषा प्रवाहशीलता के लिए Claude व्यापक रूप से पहचाना जाता है। इसका प्रशिक्षण सुसंगत, सुव्यवस्थित गद्य पर स्पष्ट रूप से बल देता है, जिससे यह क्लाइंट‑उन्मुख सामग्री, परिष्कृत सारांश, या किसी भी ऐसे कार्य के लिए बेहतर विकल्प बनता है जहाँ टोन मायने रखता है। DeepSeek टेक्स्ट जनरेशन अच्छी तरह संभालता है, लेकिन आउटपुट गुणवत्ता अधिक कार्य‑निर्भर रहती है और खुले‑आम प्रॉम्प्ट्स पर संक्षिप्तता की ओर झुकती है।
Claude लंबी वार्तालापों में भी बहु‑भाग निर्देशों को विश्वसनीय रूप से ट्रैक करता है, भले ही प्रॉम्प्ट विकसित हों या एक साथ कई बाधाएँ हों। DeepSeek भी जटिल प्रॉम्प्ट्स को संभालता है, लेकिन विशेषकर वार्तालापीय या बहु‑टर्न सेटिंग्स में अधिक स्पष्ट संरचना से लाभ होता है।
Claude Opus 4.6 और Sonnet 4.6 1M टोकन विंडो सपोर्ट करते हैं और लंबे टेक्स्ट में मज़बूत रिट्रीवल सटीकता देते हैं। DeepSeek अपने 128K विंडो के भीतर लंबे संदर्भ अच्छी तरह प्रोसेस करता है। अधिकांश वर्कलोड के लिए दोनों सक्षम हैं; अंतर का असर बहुत बड़े संदर्भ आकारों पर या तब होता है जब अत्यधिक सटीक needle‑in‑a‑haystack रिट्रीवल प्राथमिकता हो।
प्रकाशित बेंचमार्क स्कोर मॉडल अपडेट्स के साथ बदलते रहते हैं और कार्य व प्रॉम्प्ट शैली के अनुसार काफ़ी भिन्न हो सकते हैं। किसी भी विशिष्ट तुलना को अंतिम निर्णय नहीं, बल्कि दिशात्मक संकेत मानें। सबसे विश्वसनीय परीक्षण है—अपने वास्तविक उपयोग मामले पर दोनों मॉडलों को चलाना।
DeepSeek का स्पष्ट चेन‑ऑफ़‑थॉट प्रशिक्षण इसे एल्गोरिदमिक चुनौतियों, गणितीय प्रूफ़, और कोड डीबगिंग के लिए मज़बूत विकल्प बनाता है जहाँ आपको मॉडल से अपना कार्य दिखाने की ज़रूरत होती है। जो डेवलपर्स विश्लेषणात्मक कार्यों के लिए कम लागत पर सक्षम मॉडल चाहते हैं, उन्हें DeepSeek API अत्यधिक प्रतिस्पर्धी लगेगा।
जब आपको स्वाभाविक, प्रवाहपूर्ण टेक्स्ट चाहिए—अनुसंधान का सार तैयार करना, क्लाइंट संचार ड्राफ्ट करना, या गैर‑तकनीकी पाठकों के लिए रिपोर्ट जनरेट करना—तो Claude बेहतर फ़िट है। बहु‑टर्न इंटरेक्शनों में इसकी वार्तालापीय सुसंगति इसे असिस्टेंट्स या चैटबॉट बनाने के लिए भी उपयुक्त बनाती है।
Claude का Constitutional AI प्रशिक्षण हानिकारक, पक्षपाती, या विषय से भटके आउटपुट की संभावना घटाता है। स्वास्थ्य, शिक्षा, या लीगल टेक जैसी टीमों के लिए—जहाँ एज केसों में मॉडल का व्यवहार वास्तविक जोखिम लाता है—Claude की सुरक्षा‑उन्मुख डिज़ाइन पर गंभीरता से विचार करना चाहिए। DeepSeek की ओपन प्रकृति आपको फाइन‑ट्यूनिंग और डिप्लॉयमेंट पर अधिक नियंत्रण देती है, लेकिन आउटपुट सुरक्षा प्रबंधन की ज़िम्मेदारी भी आपकी टीम पर अधिक डालती है।
DeepSeek की कुशल आर्किटेक्चर इन्फ़रेंस को उल्लेखनीय रूप से किफ़ायती बनाती है। इसके MIT‑लाइसेंस्ड वेट्स डाउनलोड कर स्थानीय रूप से चलाए जा सकते हैं। उच्च‑मात्रा वाले कार्यों, सीमित बजट वाले प्रोजेक्ट्स, या स्व‑होस्टिंग चाहने वाली टीमों के लिए DeepSeek की कीमत और डिप्लॉयमेंट लचीलापन बेजोड़ है।
दोनों मॉडल लोकप्रिय भाषाओं में कोड कंप्लीशन और जनरेशन सपोर्ट करते हैं, लेकिन कार्य‑स्तर पर उनकी ताकतें अलग हो जाती हैं। DeepSeek फ़ोकस्ड जनरेशन में अच्छा करता है: कोई विशिष्ट फ़ंक्शन लिखना, कोई एल्गोरिदम लागू करना, या यूनिट टेस्ट जनरेट करना। Claude उन रिफैक्टरिंग कार्यों में मज़बूत होता है जिनमें व्यापक आर्किटेक्चरल संदर्भ समझना आवश्यक हो—जैसे नामकरण पैटर्न को लगातार बदलना, डिज़ाइन समस्याओं की पहचान, या यह समझाना कि कोई संरचना डाउनस्ट्रीम दिक्कतें क्यों पैदा करेगी।
API इंटीग्रेशन के लिए, Claude का AWS Bedrock, Google Vertex AI, और Microsoft Foundry में गहरा सपोर्ट है। Opus 4.6 को लंबी अवधि, बहु‑चरण एजेंट कार्यों के लिए डिज़ाइन किया गया है। DeepSeek platform.deepseek.com के माध्यम से और तृतीय‑पक्ष प्रदाताओं के बढ़ते इकोसिस्टम से सुलभ है; इसके ओपन वेट्स इसे स्व‑होस्टेड इन्फ़रेंस स्टैक्स बनाने वाली टीमों के लिए लोकप्रिय विकल्प बनाते हैं।
Claude सारांशण और खुले‑आम प्रश्नोत्तर को अच्छी तरह संभालता है। प्रतिक्रियाएँ सुव्यवस्थित, संदर्भ‑सचेत, और पढ़ने में आसान होती हैं, और यह स्वाभाविक रूप से कई स्रोतों को एक सुसंगत उत्तर में समेटता है। जटिल निर्देश पालन में, Claude लंबे आउटपुट्स में भी सभी आवश्यकताओं को विश्वसनीय रूप से ट्रैक करता है। DeepSeek संरचित प्रश्नोत्तर और तथ्यात्मक रिट्रीवल पर प्रतिस्पर्धात्मक प्रदर्शन करता है, हालाँकि प्रॉम्प्ट में अधिक स्पष्ट चरणबद्ध संरचना से इसे लाभ होता है।
हैलुसिनेशन पर: Claude का सुरक्षा‑संरेखित प्रशिक्षण संदेह होने पर सतर्क रहने या मना करने की प्रवृत्ति बढ़ाता है, जो आत्मविश्वासी त्रुटियों को कम करता है, लेकिन कभी‑कभी अत्यधिक सतर्क उत्तर दे सकता है। सत्यापनीय उत्तरों वाले कार्यों में DeepSeek के तर्क मॉडल सामान्यतः अधिक विश्वसनीय होते हैं, पर प्रशिक्षण डेटा से बाहर आत्मविश्वासी त्रुटियाँ दे सकते हैं। कोई भी पूर्णतः मुक्त नहीं है, और जब तथ्यात्मक शुद्धता महत्वपूर्ण हो, तो दोनों ही रिट्रीवल‑ऑग्मेंटेड सेटअप से लाभान्वित होते हैं।
Claude पूर्णतः स्वामित्व वाला मॉडल है, जो Anthropic की सब्सक्रिप्शन श्रेणियों (फ्री, Pro, और Max) और टोकन‑आधारित API—Haiku 4.5, Sonnet 4.6, और Opus 4.6—के माध्यम से सुलभ है। बिज़नेस एक्सेस Team और Enterprise प्लान्स से आता है। सारा एक्सेस Anthropic या पार्टनर प्रदाताओं के क्लाउड के माध्यम से है; कोई ओपन वेट्स उपलब्ध नहीं हैं।
DeepSeek अपने मॉडल वेट्स MIT लाइसेंस के अंतर्गत निःशुल्क प्रदान करता है, जिससे GPU इन्फ्रास्ट्रक्चर वाली टीमों के लिए स्व‑होस्टेड डिप्लॉयमेंट व्यवहार्य हो जाते हैं। यह platform.deepseek.com पर एक होस्टेड API भी देता है, जो पे‑पर‑टोकन प्राइसिंग का उपयोग करता है; प्रॉम्प्ट कैशिंग के जरिए उल्लेखनीय बचत के साथ—जिससे यह उच्च‑मात्रा वर्कलोड के लिए आकर्षक बनता है।
अधिकांश टीमों के लिए निर्णय डिप्लॉयमेंट की ज़रूरतों और वर्कलोड के प्रकार पर आकर ठहरता है। DeepSeek की कम प्रति‑टोकन लागत और स्व‑होस्टिंग विकल्प सीमित बजट या प्राइवेसी‑पहले वातावरणों के लिए उपयुक्त हैं। यदि आप मौजूदा एंटरप्राइज़ स्टैक के भीतर काम कर रहे हैं या गारंटीड अपटाइम SLA चाहिए, तो Claude के गहरे क्लाउड इंटीग्रेशन अधिक समझ में आते हैं।
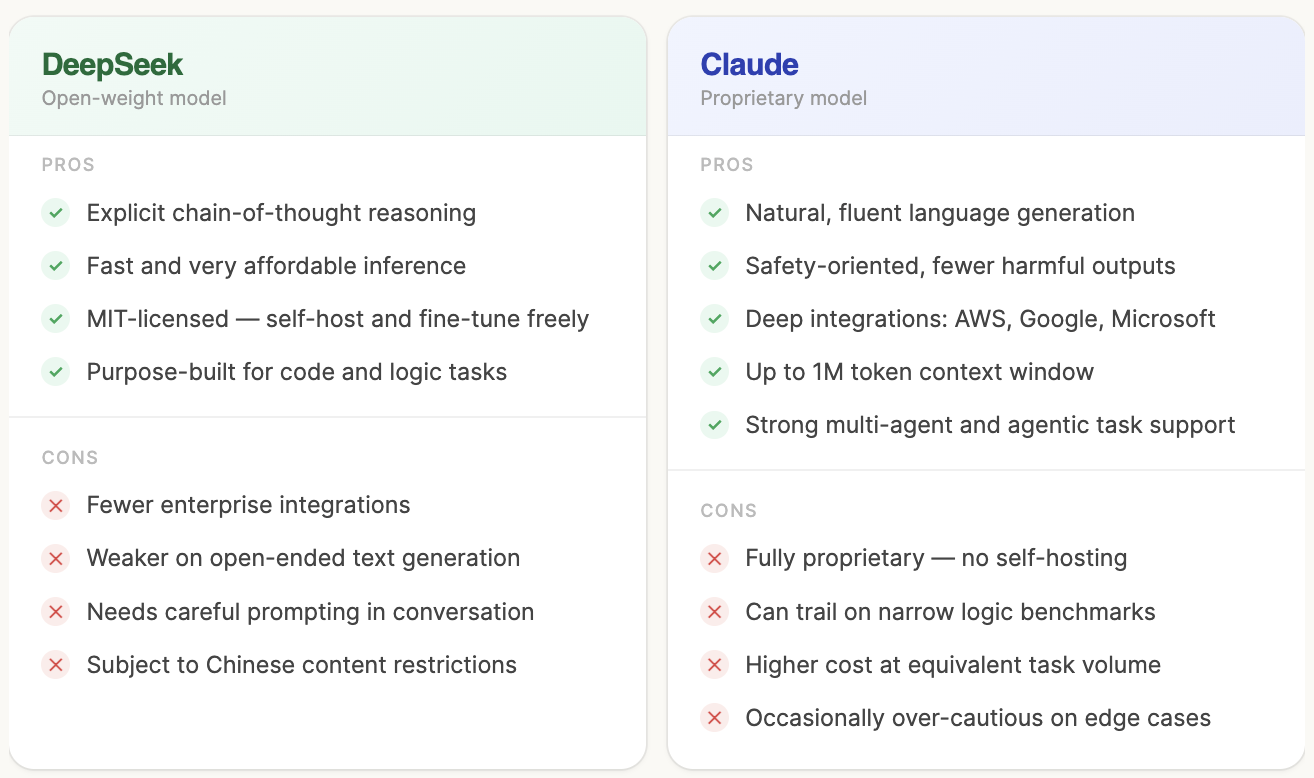
दोनों सक्षम, अच्छी तरह समर्थित मॉडल हैं जो अर्थपूर्ण रूप से अलग ज़रूरतों की पूर्ति करते हैं। DeepSeek का ओपन लाइसेंसिंग, तेज़ इन्फ़रेंस, और तर्क की शुद्धता इसे उन डेवलपर्स के लिए उपयुक्त बनाती है जो कोड‑प्रधान या लॉजिक‑इंटेंसिव कार्यों पर काम कर रहे हैं और जिन्हें कम‑लागत, स्व‑होस्टेबल इन्फ्रास्ट्रक्चर चाहिए। Claude का एलाइनमेंट दर्शन, भाषा प्रवाहशीलता, और एंटरप्राइज़ इकोसिस्टम इसे क्लाइंट‑उन्मुख एप्लिकेशनों, सुरक्षा‑संवेदनशील वर्कफ़्लो, या कहीं भी—जहाँ प्राकृतिक भाषा गुणवत्ता और पूर्वानुमेय व्यवहार का वास्तविक महत्व है—बेहतर विकल्प बनाते हैं।
अधिक उपयोगी प्रश्न यह नहीं है कि कौन‑सा मॉडल बेहतर है; बल्कि यह है कि आपका वर्कलोड वास्तव में क्या माँगता है। कई वास्तविक‑दुनिया आर्किटेक्चर्स में दोनों का उपयोग करने का ठोस कारण है—कार्यों को प्रकार के आधार पर रूट करना, किसी एक प्रदाता से पूरी तरह बँधने के बजाय।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स