
Corso
Lavorare con l'API di OpenAI
3 ore
179.1K
Poniamo che tu stia costruendo una pipeline che deve gestire ragionamento su codice complesso a più fasi e sintesi di documenti per i clienti. A quale modello ti affidi? È questo il tipo di domanda che rende utile questo confronto: non come un esercizio di benchmark, ma come una decisione pratica che determina cosa il tuo sistema può davvero fare.
Ecco come DeepSeek e Claude differiscono per architettura, prestazioni e prezzi, così puoi scegliere in base al tuo carico di lavoro reale.
Se ti interessano i modelli AI aggiornati, dai un'occhiata anche alla nostra guida su Muse Spark di Meta.
DeepSeek è una famiglia di modelli AI sviluppata dalla società di ricerca cinese Hangzhou DeepSeek Artificial Intelligence, progettata per compiti avanzati di ragionamento, coding e logica. La maggior parte dei suoi modelli è disponibile liberamente come pesi open sotto licenza MIT, motivo per cui l'uscita di DeepSeek-R1 a gennaio 2025 ha fatto così rumore. Ha eguagliato la qualità di ragionamento dei principali modelli proprietari a una frazione del costo di training.
La lineup è evoluta rapidamente. DeepSeek-V3 (dicembre 2024) ha stabilito una solida base generalista, mentre R1 ha introdotto un modello di ragionamento dedicato addestrato con reinforcement learning, progettato per risolvere i problemi passo dopo passo prima di rispondere. DeepSeek-V3.1 è seguita con un'architettura ibrida che passa tra modalità "pensante" e "non pensante" in un'unica distribuzione. DeepSeek V4 è molto attesa come la prossima major release, con prime indicazioni che parlano di coding più forte, ingegneria del software a lungo contesto e supporto multimodale nativo.
I punti di forza di DeepSeek sono le catene logiche, la precisione nel ragionamento strutturato e l'inferenza veloce. È una scelta naturale per sviluppatori al lavoro su compiti analitici o con molto codice.
Claude è la famiglia di modelli AI di Anthropic, costruita attorno a una filosofia centrale di ragionamento allineato: creare modelli capaci, coerenti, onesti e meno inclini a deragliare. L'attuale famiglia Claude 4 include Haiku 4.5 (veloce e leggero), Sonnet 4.6 (il cavallo di battaglia quotidiano) e Opus 4.6 (l'ammiraglia per ragionamento complesso e compiti a lungo contesto).
Ciò che distingue Claude è la sua naturalezza conversazionale, la capacità di seguire istruzioni sfumate e un comportamento orientato alla sicurezza. I modelli Claude sono multimodali, gestiscono testo, immagini e documenti. Sia Opus 4.6 che Sonnet 4.6 supportano una finestra di contesto da 1 milione di token, tra le più grandi disponibili nel 2026. Per team che costruiscono strumenti per i clienti o flussi di lavoro enterprise in cui l'affidabilità conta, queste priorità di design si traducono in benefici reali e pratici.
DeepSeek affronta l'intelligenza con un approccio “reasoning-first”. La linea R1 è stata addestrata con reinforcement learning per sviluppare un ragionamento esplicito a catena, così il modello affronta i problemi in modo metodico prima di rispondere. Lo si vede chiaramente in matematica, logica e codice: soluzioni strutturate, passo dopo passo, facili da verificare.
Claude è addestrato con Constitutional AI, la tecnica di allineamento di Anthropic, che orienta il suo ragionamento verso sicurezza, coerenza e risposte oneste. Il risultato è un generalista ampiamente capace, più che uno specialista stretto. Questa differenza emerge anche con prompt ambigui. DeepSeek tende a richiedere prompt engineering più preciso in scenari aperti, mentre Claude gestisce bene le derive conversazionali e di solito inferisce l'intento senza troppo guidarlo.
Claude Opus 4.6 e Sonnet 4.6 supportano finestre da 1M token a prezzi standard. DeepSeek-V3.1 supporta fino a 128K token. In inferenza, l'architettura Mixture-of-Experts di DeepSeek (671B parametri totali, 37B attivati per token) mantiene bassi i costi attivando solo parte della rete per richiesta. L'architettura di Claude è proprietaria, ma le sue prestazioni su compiti di ragionamento, coding e multimodali sono ben consolidate in valutazioni indipendenti.
Le differenze di prestazioni sono reali, ma dipendono dal compito. Nessuno dei due modelli primeggia su tutta la linea.
DeepSeek è altamente specializzato qui. Il suo modello R1 è stato costruito per mostrare i passaggi di ragionamento, rendendolo adatto a problemi in cui devi verificare il percorso, non solo la risposta: algoritmi, dimostrazioni, matematica formale. Claude affronta il ragionamento con una lente generalista, risultando più forte per compiti di sintesi e giudizio che mescolano prove, contesto e sfumature. Se il problema ha una struttura formale, l'output a catena di DeepSeek è spesso più facile da verificare. Se richiede di soppesare prospettive, Claude tende a fare meglio.
DeepSeek è specificamente tarato per il ragionamento sul codice, con risultati solidi su sfide algoritmiche e task di coding isolati. Claude tende a spiccare nel lavoro di ingegneria del software più ampio: comprendere architetture multi-file, fare refactoring su un progetto grande, ragionare sul design di sistema su molti turni. Per script rapidi o il debug di una funzione specifica, DeepSeek è un'ottima scelta. Per code review o lavori complessi a livello di progetto, la coerenza a lungo contesto di Claude diventa un vero vantaggio.
Claude è ampiamente riconosciuto per la sua fluidità nel linguaggio naturale. Il suo training premia esplicitamente una prosa coerente e ben strutturata, rendendolo la scelta più forte per contenuti rivolti ai clienti, sintesi curate o qualsiasi cosa in cui il tono conti. DeepSeek gestisce bene la generazione di testo, ma la qualità dell'output è più dipendente dal compito e tende alla sinteticità con prompt aperti.
Claude segue in modo affidabile istruzioni multi-parte lungo conversazioni estese, anche quando i prompt evolvono o portano vincoli multipli simultaneamente. Anche DeepSeek gestisce prompt complessi, ma trae beneficio da una strutturazione più esplicita, soprattutto in contesti conversazionali o multi-turno.
Claude Opus 4.6 e Sonnet 4.6 supportano finestre da 1M token con forte accuratezza di recupero su testi lunghi. DeepSeek gestisce bene contesti lunghi all'interno della sua finestra da 128K. Per la maggior parte dei carichi di lavoro, entrambi sono all'altezza; il divario conta soprattutto a contesti molto grandi o quando il recupero “ago nel pagliaio” è prioritario.
I punteggi pubblicati nei benchmark cambiano tra gli aggiornamenti dei modelli e variano significativamente per compito e stile di prompt. Considera qualsiasi confronto specifico come un segnale direzionale, non un verdetto. Il test più affidabile è far girare entrambi i modelli sul tuo caso d'uso reale.
Il training esplicito a catena di DeepSeek lo rende una scelta forte per sfide algoritmiche, dimostrazioni matematiche e debug del codice dove vuoi che il modello mostri il lavoro svolto. Gli sviluppatori che cercano un modello capace a basso costo per compiti analitici troveranno l'API DeepSeek molto competitiva.
Claude è più adatto quando serve testo naturale e fluente: sintetizzare ricerche, redigere comunicazioni per i clienti o generare report destinati a lettori non tecnici. La sua coerenza conversazionale su interazioni multi-turno lo rende anche adatto alla creazione di assistenti o chatbot.
Il training con Constitutional AI di Claude riduce la probabilità di output dannosi, faziosi o fuori bersaglio. I team in sanità, istruzione o legal tech, dove il comportamento del modello in casi limite comporta rischi reali, dovrebbero considerare seriamente il design di sicurezza di Claude. La natura open di DeepSeek ti dà più controllo su fine-tuning e deployment, ma pone anche più responsabilità sul tuo team nella gestione della sicurezza degli output.
L'architettura efficiente di DeepSeek rende l'inferenza sorprendentemente conveniente. I suoi pesi con licenza MIT possono essere scaricati ed eseguiti in locale. Per compiti ad alto volume, progetti con budget limitato o team che vogliono self-hosting, i prezzi e la flessibilità di deployment di DeepSeek sono difficili da battere.
Entrambi i modelli supportano completamento e generazione di codice nei linguaggi più popolari, ma i loro punti di forza divergono a livello di task. DeepSeek rende bene nella generazione focalizzata: scrivere una funzione specifica, implementare un algoritmo o generare unit test. Claude tende a essere più forte nei compiti di refactoring che richiedono comprensione del contesto architetturale più ampio, come rinominare pattern in modo coerente, identificare problemi di design o spiegare perché una certa struttura causerà problemi a valle.
Per l'integrazione API, Claude ha un ampio supporto su AWS Bedrock, Google Vertex AI e Microsoft Foundry. Opus 4.6 è progettato per compiti agentici multi-step e a lungo orizzonte. DeepSeek è accessibile tramite platform.deepseek.com e attraverso un ecosistema crescente di provider terzi; i suoi pesi open lo rendono una scelta popolare per i team che costruiscono stack di inferenza self-hosted.
Claude gestisce bene la sintesi e le Q&A aperte. Le risposte sono ordinate, contestuali e facili da leggere, e sintetizza naturalmente più fonti in una risposta coerente. Sull'esecuzione di istruzioni complesse, Claude segue tutti i requisiti in modo affidabile anche su output lunghi. DeepSeek è competitivo su Q&A strutturate e recupero fattuale, anche se beneficia di una strutturazione più esplicita passo passo nel prompt.
Sulle allucinazioni: l'addestramento allineato alla sicurezza di Claude lo rende più propenso a cautelarsi o rifiutare quando è incerto, riducendo gli errori sicuri di sé ma talvolta producendo risposte eccessivamente caute. I modelli di ragionamento di DeepSeek sono in genere più affidabili su compiti con risposte verificabili, ma possono comunque produrre errori sicuri di sé fuori dai loro dati di training. Nessuno dei due è immune, ed entrambi beneficiano di setup con retrieval aumentato quando l'accuratezza fattuale è critica.
Claude è un modello completamente proprietario accessibile tramite i piani di abbonamento di Anthropic (free, Pro e Max) e una API a token che copre Haiku 4.5, Sonnet 4.6 e Opus 4.6. L'accesso business è disponibile con piani Team ed Enterprise. Tutto l'accesso è basato su cloud tramite Anthropic o provider partner; non esistono pesi open.
DeepSeek offre i pesi dei modelli liberamente sotto licenza MIT, rendendo possibili deployment self-hosted per team con infrastruttura GPU. Fornisce anche una API hosted su platform.deepseek.com con pricing pay-per-token, inclusi risparmi significativi tramite prompt caching, rendendola interessante per carichi di lavoro ad alto volume.
Per la maggior parte dei team, la decisione si riduce alle esigenze di deployment e al tipo di carico di lavoro. Il basso costo per token e l'opzione di self-hosting di DeepSeek funzionano bene per ambienti con budget limitato o orientati alla privacy. Le profonde integrazioni cloud di Claude hanno più senso quando operi in uno stack enterprise esistente o hai bisogno di SLA di uptime garantiti.
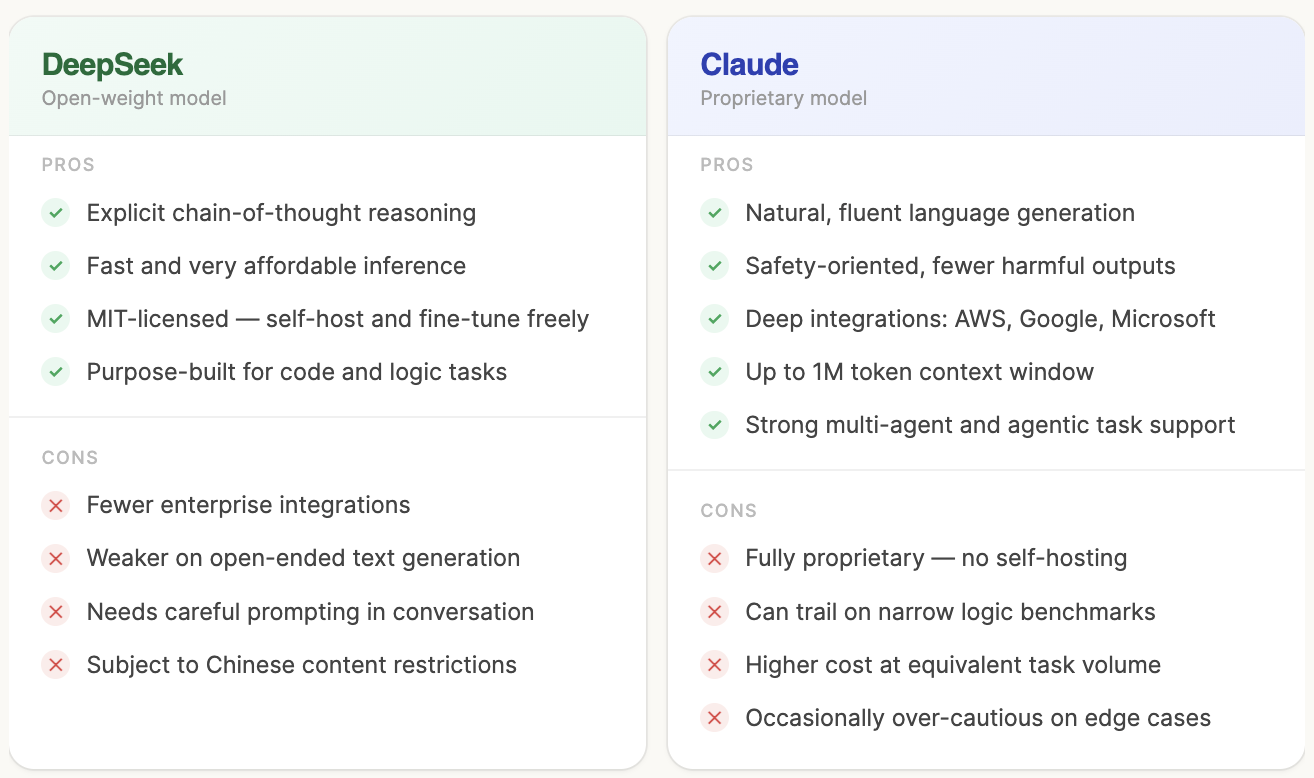
Entrambi sono modelli capaci e ben supportati che rispondono a esigenze significativamente diverse. La licenza open di DeepSeek, l'inferenza veloce e la precisione nel ragionamento lo rendono adatto a sviluppatori impegnati in compiti con molto codice o intensivi di logica che necessitano di un'infrastruttura economica e self-hostabile. La filosofia di allineamento di Claude, la fluidità nel linguaggio e l'ecosistema enterprise lo rendono la scelta migliore per applicazioni rivolte ai clienti, workflow sensibili alla sicurezza o ovunque la qualità del linguaggio naturale e il comportamento prevedibile abbiano un peso reale.
La domanda più utile non è quale modello sia migliore: è cosa richiede davvero il tuo carico di lavoro. In molte architetture reali, c'è un'ottima ragione per usare entrambi, instradando i compiti per tipologia invece di impegnarsi esclusivamente con un solo provider.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



