

课程
使用 OpenAI API
3 小时
183.4K
实践并学习路径你的进步。
使用 Google 继续假设您要搭建一条既能处理复杂的多步代码推理又能进行面向客户的文档摘要的流水线。您会选择哪个模型?这正是本次对比的用处所在——不是单纯跑分,而是做出能决定系统实际能力的务实选择。
以下从架构、性能与定价三方面解析 DeepSeek 与 Claude 的差异,便于您依据真实工作负载作出选择。
如果您关注最新的 AI 模型,也别错过我们关于 Meta 的 Muse Spark 指南。
DeepSeek 是由中国研究公司杭州深度求索人工智能开发的一系列 AI 模型,侧重于高级推理、编程与重逻辑任务。其大多数模型以开源权重形式在 MIT 许可下免费提供,这也是 2025 年 1 月发布的 DeepSeek-R1 影响巨大的原因之一:以极低的训练成本达到了与顶级闭源模型相当的推理质量。
产品线演进迅速。DeepSeek-V3(2024 年 12 月)奠定了扎实的通用基础;R1 则引入了经强化学习训练的专用推理模型,设计为先逐步推导再作答。随后发布的 DeepSeek-V3.1 采用混合架构,可在单一部署中在“思考”和“非思考”模式间切换。DeepSeek V4 被广泛视为下一代重磅版本,早期消息称其在编码能力、长上下文软件工程与原生多模态支持方面会更强。
DeepSeek 的强项在于逻辑链、结构化推理的精确度与快速推理(inference)。它非常适合从事分析类或重代码任务的开发者。
Claude 是 Anthropic 的 AI 模型家族,核心理念是“对齐的推理”:让模型更有能力、更一致、更诚实,且更不易跑偏。当前的 Claude 4 系列包括 Haiku 4.5(快速轻量)、Sonnet 4.6(日常主力)与 Opus 4.6(擅长复杂推理与长上下文任务的旗舰)。
Claude 的独到之处在于会话流畅度、细腻的指令遵循与以安全为导向的行为。Claude 模型是多模态的,可处理文本、图像与文档。Opus 4.6 与 Sonnet 4.6 都支持 100 万 token 的上下文窗口,这是 2026 年可用的最大窗口之一。对于构建面向客户的工具或注重可靠性的企业工作流,这些设计取向能转化为切实的实际收益。
DeepSeek 以“推理优先”的角度看待智能。其 R1 系列通过强化学习训练出显式的思维链,因此模型会在回答前有条不紊地推导。尤其在数学、逻辑与代码任务中尤为明显:结构化、逐步的解题过程,便于审计。
Claude 采用 Anthropic 的 Constitutional AI(宪法式 AI)对齐技术进行训练,将其推理塑造成更安全、更连贯与更诚实。结果是一个广泛胜任的通才,而非狭义专精者。这也体现在含糊的提示上:在开放式场景中,DeepSeek 往往需要更精确的提示工程,而 Claude 则更能处理会话漂移,通常无需过多引导便能揣摩意图。
Claude Opus 4.6 与 Sonnet 4.6 以标准定价支持 100 万 token 窗口。DeepSeek-V3.1 支持最高 128K token。就推理而言,DeepSeek 的混合专家(MoE)架构(总参数 671B,每 token 激活 37B)通过每次请求仅激活部分网络来降低成本。Claude 的架构为专有,但其在推理、编码与多模态任务上的表现已在独立评估中得到充分验证。
性能差异确实存在,但取决于任务类型。两者都不是在所有方面都领先。
DeepSeek 在此领域高度专长。其 R1 模型旨在展示推理步骤,适合需要验证过程而非仅要答案的任务:算法、证明、形式化数学。Claude 则以通才视角处理推理,更擅长将证据、语境与细微差别融合的综合与判断类任务。若问题具备严格的形式结构,DeepSeek 的思维链输出更便于审计;若需要权衡多种观点,Claude 往往表现更佳。
DeepSeek 专为代码推理而调优,在算法挑战与孤立的编码任务上表现出色。Claude 则常在更广泛的软件工程工作中胜出:理解多文件架构、在大型项目中进行重构、在多轮交互中推理系统设计。若是快速脚本或定位某个函数的 Bug,DeepSeek 是不错之选;若是代码评审或复杂的项目级工作,Claude 的长上下文连贯性就成了显著优势。
Claude 以自然语言流畅度著称。其训练明确奖励连贯、结构良好的行文,因此在面向客户的内容、精加工的摘要,或任何重视语气的场景中更具优势。DeepSeek 的文本生成也不错,但质量更依赖任务类型,对开放式提示的输出趋于简洁。
Claude 能在长对话中稳定跟踪多部分指令,即使提示不断演化或同时包含多重约束。DeepSeek 也能处理复杂提示,但在会话式或多轮场景下,更受益于更明确的结构化提示。
Claude Opus 4.6 与 Sonnet 4.6 以 100 万 token 窗口配合强检索准确率处理长文本。DeepSeek 在其 128K 窗口内也能很好地处理长上下文。对多数工作负载而言,两者都胜任;差距主要体现在极大上下文或需要“海量文本中找针”式精准检索时。
公开基准分数会随模型更新而波动,并在不同任务与提示风格间显著变化。将任何具体对比视为方向性信号,而非最终裁定。最可靠的测试,是把两者都跑在您的真实用例上。
DeepSeek 的显式思维链训练,使其非常适合算法挑战、数学证明与代码调试等需要模型“展示过程”的任务。希望以较低成本处理分析任务的开发者,会发现 DeepSeek 的 API 竞争力很强。
当您需要自然、流畅的文本时,Claude 更合适:研究摘要、撰写客户沟通、或为非技术读者生成报告。其在多轮交互中的会话连贯性,也使其很适合构建助手或聊天机器人。
Claude 的宪法式 AI 训练降低了有害、偏见或跑题输出的可能性。医疗、教育或法律科技等在边界情形下存在真实风险的团队,应认真考虑 Claude 的安全设计。DeepSeek 的开放特性让您在微调与部署上拥有更大控制权,但也意味着需要您的团队更多地承担输出安全管理。
DeepSeek 的高效架构让推理成本极具优势。其 MIT 许可的权重可下载本地运行。对于高吞吐任务、预算受限项目,或希望自托管的团队,DeepSeek 的定价与部署灵活性难以匹敌。
两者都支持主流语言的代码补全与生成,但在任务层面各有所长。DeepSeek 擅长聚焦式生成:编写特定函数、实现算法或生成单元测试。Claude 往往在需要理解更广架构语境的重构任务上更强,如一致地重命名模式、识别设计问题,或解释某种结构为何会引发后续问题。
在 API 集成方面,Claude 深度支持 AWS Bedrock、Google Vertex AI 与 Microsoft Foundry。Opus 4.6 面向长周期的多步代理任务而设计。DeepSeek 可通过 platform.deepseek.com 访问,也可借助日益壮大的第三方生态;其开放权重使其成为构建自托管推理栈团队的热门之选。
Claude 在摘要与开放式问答方面表现出色。其回复组织有序、上下文敏感且易读,能自然而然地将多来源信息综合为连贯答案。在复杂指令遵循上,Claude 能在长输出中稳定追踪全部要求。DeepSeek 在结构化问答与事实检索上表现不俗,但在提示中加入更明确的逐步结构会更有帮助。
关于幻觉:Claude 的安全对齐训练使其在不确定时更倾向于保留或拒答,这减少了“自信错误”,但有时会显得过于谨慎。DeepSeek 的推理模型在可验证答案的任务上通常更可靠,但在其训练数据之外仍可能产生自信错误。两者都非万能,若事实准确性至关重要,都适合结合检索增强。
Claude 为完全专有模型,通过 Anthropic 的订阅层级(免费、Pro 与 Max)与基于 token 的 API(涵盖 Haiku 4.5、Sonnet 4.6、Opus 4.6)提供访问。商务访问通过 Team 与 Enterprise 方案提供。全部访问均通过 Anthropic 或合作方的云端提供;不提供开放权重。
DeepSeek 在 MIT 许可下免费提供模型权重,使具备 GPU 基础设施的团队可自托管部署。其亦在 platform.deepseek.com 提供托管 API,按 token 计费,并可通过提示缓存大幅节省成本,适合高吞吐工作负载。
对多数团队而言,抉择取决于部署需求与工作负载类型。DeepSeek 的低 token 成本与自托管选项,非常适合预算受限或隐私优先的环境。若您已在既有企业云栈中运营,或需要有保障的可用性 SLA,Claude 的深度云集成更合适。
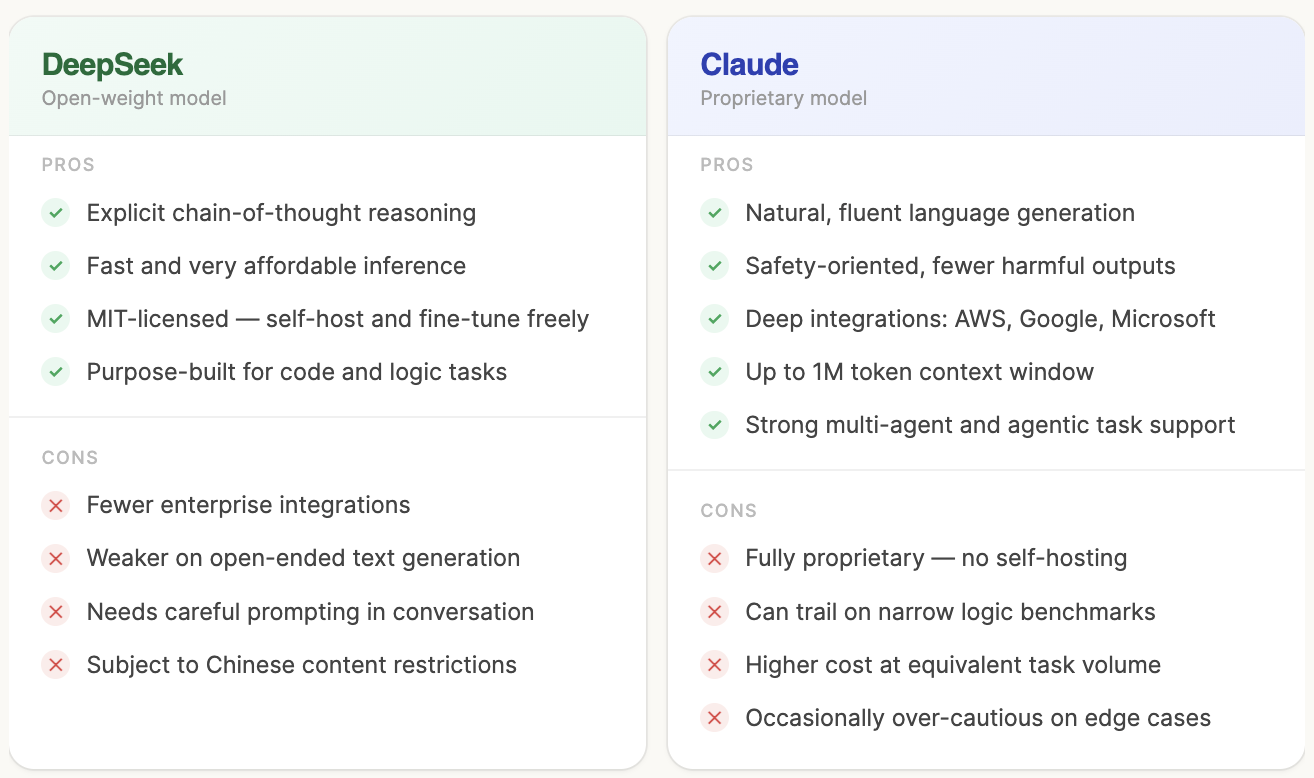
两者都是能力强、支持完善的模型,但服务的需求侧重点不同。DeepSeek 以开放许可、快速推理与精确推理见长,适合从事重代码或强逻辑任务、且需要低成本可自托管基础设施的开发者。Claude 以对齐理念、语言流畅度与企业生态为优势,更适合面向客户的应用、安全敏感的工作流,或任何将自然语言质量与可预期行为视为重中之重的场景。
更有价值的问题不是“哪一个更好”,而是“您的工作负载到底需要什么”。在许多真实世界的架构中,同时使用两者、按任务类型路由,而非绑定单一供应商,往往更有说服力。
与 DataCamp 一起学习
课程
课程
实践并学习路径你的进步。
使用 Google 继续