

Curso
Trabalhar com a API da OpenAI
3 h
183.4K
Pratique e programa seu progresso.
Continuar Com O GoogleImagine que você está construindo um pipeline que precisa lidar com raciocínio de código complexo em várias etapas e sumarização de documentos voltada para o cliente. Qual modelo você escolhe? É esse tipo de pergunta que torna esta comparação útil — não como um exercício de benchmark, mas como uma decisão prática que define o que o seu sistema realmente consegue fazer.
Veja como DeepSeek e Claude diferem em arquitetura, desempenho e preço, para você decidir com base na sua carga de trabalho real.
Se você acompanha os modelos de IA mais recentes, vale conferir também nosso guia sobre o Muse Spark da Meta.
DeepSeek é uma família de modelos de IA desenvolvida pela empresa chinesa Hangzhou DeepSeek Artificial Intelligence, voltada para tarefas de raciocínio avançado, programação e lógica. A maioria dos modelos está disponível gratuitamente como pesos abertos sob a licença MIT — um dos motivos pelos quais o lançamento do DeepSeek-R1 em janeiro de 2025 chamou tanta atenção. Ele igualou a qualidade de raciocínio de modelos proprietários líderes a uma fração do custo de treinamento.
A linha evoluiu rápido. O DeepSeek-V3 (dezembro de 2024) estabeleceu uma base sólida para uso geral, enquanto o R1 apresentou um modelo de raciocínio dedicado treinado com aprendizado por reforço, feito para resolver problemas passo a passo antes de responder. Depois veio o DeepSeek-V3.1 com uma arquitetura híbrida que alterna entre modos "pensante" e "não pensante" em uma única implantação. O DeepSeek V4 é amplamente aguardado como o próximo grande lançamento, com relatos iniciais indicando melhorias em programação, engenharia de software com contexto longo e suporte multimodal nativo.
Os pontos fortes do DeepSeek são cadeias lógicas, precisão em raciocínio estruturado e inferência rápida. É um encaixe natural para desenvolvedores que trabalham com tarefas analíticas ou intensivas em código.
Claude é a família de modelos de IA da Anthropic, construída em torno de uma filosofia central de raciocínio alinhado: modelos capazes, consistentes, honestos e menos propensos a sair do trilho. A atual família Claude 4 inclui o Haiku 4.5 (rápido e leve), o Sonnet 4.6 (o coringa do dia a dia) e o Opus 4.6 (o carro-chefe para raciocínio complexo e tarefas com contexto longo).
O diferencial do Claude é a fluência conversacional, a obediência refinada a instruções e um comportamento voltado para segurança. Os modelos Claude são multimodais, lidando com texto, imagens e documentos. Opus 4.6 e Sonnet 4.6 oferecem janela de contexto de 1 milhão de tokens — uma das maiores disponíveis em 2026. Para times que constroem ferramentas voltadas ao cliente ou fluxos corporativos em que confiabilidade importa, essas prioridades de design trazem benefícios práticos e concretos.
O DeepSeek aborda a inteligência com foco em raciocínio. Sua linhagem R1 foi treinada com aprendizado por reforço para desenvolver um raciocínio explícito em cadeia, fazendo o modelo trabalhar o problema de forma metódica antes de responder. Isso aparece com clareza em matemática, lógica e código: soluções estruturadas, passo a passo, fáceis de auditar.
O Claude é treinado com Constitutional AI, a técnica de alinhamento da Anthropic, que orienta o raciocínio para segurança, coerência e respostas honestas. O resultado é um generalista amplamente capaz, não um especialista estreito. Isso também aparece em prompts ambíguos. Em cenários abertos, o DeepSeek costuma exigir engenharia de prompt mais precisa, enquanto o Claude lida bem com variações na conversa e geralmente infere a intenção sem precisar de tanta condução.
Claude Opus 4.6 e Sonnet 4.6 oferecem janelas de 1M de tokens com preço padrão. DeepSeek-V3.1 suporta até 128K tokens. Na inferência, a arquitetura Mixture-of-Experts do DeepSeek (671B de parâmetros totais, 37B ativados por token) mantém os custos baixos ao ativar apenas parte da rede por requisição. A arquitetura do Claude é proprietária, mas seu desempenho em raciocínio, programação e tarefas multimodais é bem estabelecido em avaliações independentes.
As diferenças de desempenho são reais, mas dependem da tarefa. Nenhum dos dois lidera em tudo.
Aqui, o DeepSeek é altamente especializado. Seu modelo R1 foi construído para mostrar os passos do raciocínio, o que o torna ideal para problemas em que você precisa verificar o caminho, não só a resposta: algoritmos, provas, matemática formal. O Claude aborda o raciocínio com um olhar generalista, o que o torna mais forte em tarefas de síntese e julgamento que combinam evidência, contexto e nuance. Se o problema tem estrutura formal, a cadeia de raciocínio do DeepSeek costuma ser mais fácil de auditar. Se exige ponderar perspectivas, o Claude tende a ir melhor.
O DeepSeek é especificamente ajustado para raciocínio em código, com ótimos resultados em desafios algorítmicos e tarefas isoladas de programação. O Claude tende a se destacar em engenharia de software mais ampla: entender arquitetura multifiles, refatorar um projeto grande, raciocinar sobre design de sistemas ao longo de muitas interações. Para scripts rápidos ou depurar uma função específica, o DeepSeek é uma ótima escolha. Para code review ou trabalho complexo em nível de projeto, a coerência com contexto longo do Claude vira uma vantagem real.
O Claude é amplamente reconhecido pela fluência em linguagem natural. Seu treinamento recompensa explicitamente prosa coesa e bem estruturada, tornando-o a escolha mais forte para conteúdo voltado ao cliente, resumos polidos ou qualquer situação em que o tom importa. O DeepSeek gera texto bem, mas a qualidade do output é mais dependente da tarefa e tende a ser mais concisa em prompts abertos.
O Claude acompanha instruções multipartes de forma confiável ao longo de conversas longas, mesmo quando os prompts evoluem ou trazem múltiplas restrições ao mesmo tempo. O DeepSeek também lida com prompts complexos, mas se beneficia de uma estruturação mais explícita, especialmente em contextos conversacionais ou de múltiplas interações.
Claude Opus 4.6 e Sonnet 4.6 suportam janelas de 1M de tokens com alta precisão de recuperação em textos extensos. O DeepSeek processa contextos longos bem dentro da sua janela de 128K. Para a maioria das cargas, ambos dão conta; a diferença pesa mais em contextos muito grandes ou quando recuperar detalhes precisos em meio a um volume enorme é prioridade.
Scores publicados mudam a cada atualização de modelo e variam muito por tarefa e estilo de prompt. Trate qualquer comparação específica como um indicativo de direção, não um veredito. O teste mais confiável é rodar ambos os modelos no seu caso de uso real.
O treinamento com cadeia de raciocínio explícita do DeepSeek o torna uma ótima escolha para desafios algorítmicos, provas matemáticas e depuração de código em que você precisa que o modelo mostre seu processo. Desenvolvedores que buscam um modelo capaz, de baixo custo, para tarefas analíticas vão achar a API do DeepSeek bastante competitiva.
O Claude é mais indicado quando você precisa de texto natural e fluente: resumir pesquisas, redigir comunicações para clientes ou gerar relatórios para leitores não técnicos. Sua coerência conversacional em várias interações também o torna ideal para construir assistentes ou chatbots.
O treinamento com Constitutional AI do Claude reduz a probabilidade de outputs nocivos, enviesados ou fora do alvo. Times em saúde, educação ou legaltech — onde o comportamento do modelo em casos de borda traz risco real — devem considerar seriamente o design de segurança do Claude. A natureza aberta do DeepSeek dá mais controle para ajuste fino e implantação, mas também coloca mais responsabilidade na sua equipe para gerenciar a segurança do output.
A arquitetura eficiente do DeepSeek torna a inferência notavelmente acessível. Seus pesos licenciados em MIT podem ser baixados e executados localmente. Para tarefas de alto volume, projetos com orçamento apertado ou times que desejam auto-hospedar, o preço e a flexibilidade de implantação do DeepSeek são difíceis de superar.
Ambos oferecem autocompletar e geração de código em linguagens populares, mas seus pontos fortes divergem no nível da tarefa. O DeepSeek vai muito bem em geração focada: escrever uma função específica, implementar um algoritmo ou gerar testes de unidade. O Claude tende a ser mais forte em refatorações que exigem entender o contexto arquitetural mais amplo, como renomear padrões de forma consistente, identificar problemas de design ou explicar por que determinada estrutura vai causar problemas adiante.
Para integração de APIs, o Claude tem suporte profundo no AWS Bedrock, Google Vertex AI e Microsoft Foundry. O Opus 4.6 é projetado para tarefas de agentes com múltiplas etapas e horizonte longo. O DeepSeek é acessível via platform.deepseek.com e por um ecossistema crescente de provedores terceirizados; seus pesos abertos o tornam uma escolha popular para times que constroem pilhas de inferência auto-hospedadas.
O Claude lida bem com sumarização e perguntas e respostas abertas. As respostas são organizadas, contextualizadas e fáceis de ler, e ele sintetiza naturalmente múltiplas fontes em um todo coerente. Em seguimento de instruções complexas, o Claude acompanha todos os requisitos de forma confiável em saídas longas. O DeepSeek tem desempenho competitivo em Q&A estruturado e recuperação factual, embora se beneficie de uma estruturação mais explícita, passo a passo, no prompt.
Sobre alucinações: o treinamento alinhado à segurança do Claude o torna mais propenso a ponderar ou recusar quando está incerto, o que reduz erros confiantes, mas às vezes pode gerar respostas cautelosas demais. Os modelos de raciocínio do DeepSeek costumam ser mais confiáveis em tarefas com respostas verificáveis, mas ainda podem produzir erros confiantes fora de seus dados de treinamento. Nenhum é imune, e ambos se beneficiam de setups com recuperação aumentada quando a precisão factual é crítica.
Claude é totalmente proprietário e acessível pelos planos de assinatura da Anthropic (free, Pro e Max) e por uma API baseada em tokens que abrange Haiku 4.5, Sonnet 4.6 e Opus 4.6. Para empresas, há os planos Team e Enterprise. Todo o acesso é em nuvem via Anthropic ou parceiros; não há pesos abertos.
O DeepSeek oferece pesos de modelo gratuitamente sob a licença MIT, permitindo implantações auto-hospedadas para times com infraestrutura de GPU. Também fornece uma API hospedada em platform.deepseek.com com cobrança por token, incluindo economia relevante via cache de prompt, o que o torna atraente para workloads de alto volume.
Para a maioria dos times, a decisão se resume às necessidades de implantação e ao tipo de carga. O baixo custo por token e a opção de auto-hospedagem do DeepSeek funcionam bem em ambientes com orçamento limitado ou foco em privacidade. As integrações profundas em nuvem do Claude fazem mais sentido quando você opera em um stack corporativo existente ou precisa de SLAs de disponibilidade garantida.
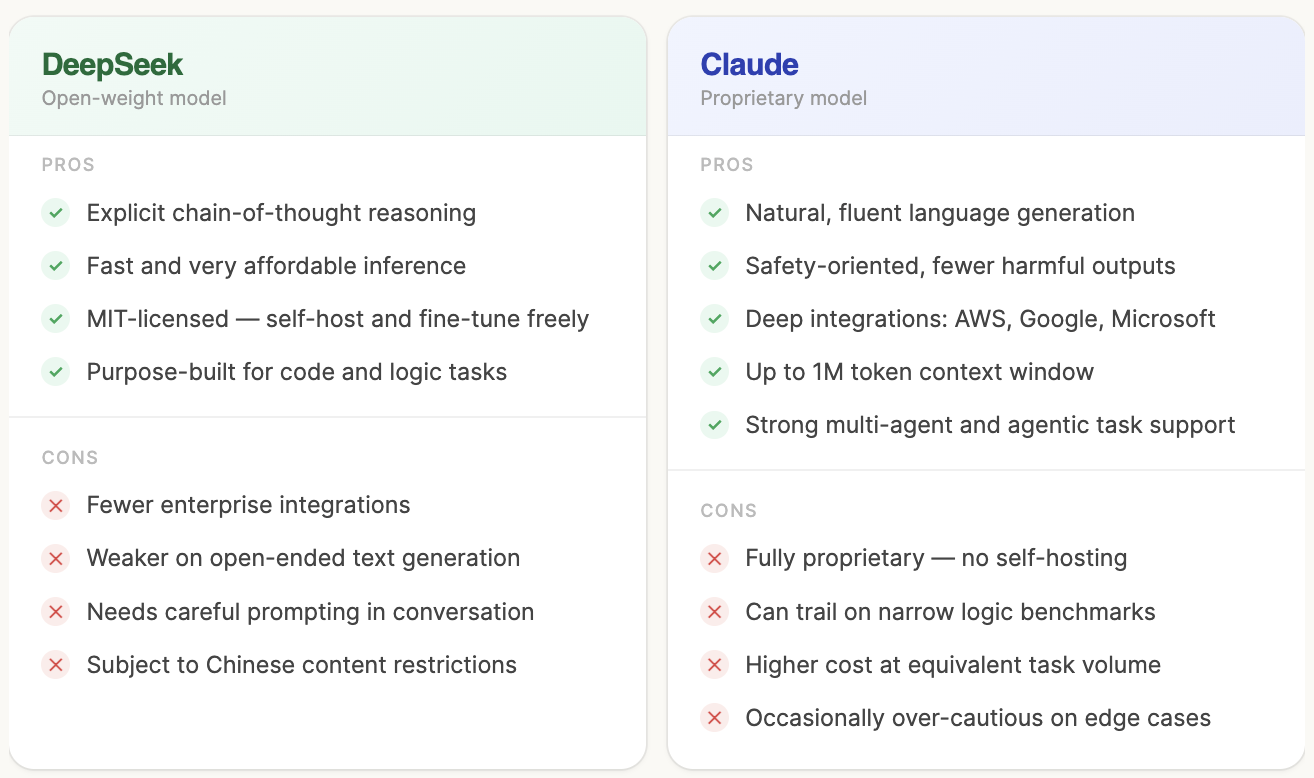
Ambos são modelos capazes e bem suportados, que atendem necessidades significativamente diferentes. A licença aberta, a inferência rápida e a precisão de raciocínio do DeepSeek o tornam uma ótima opção para desenvolvedores em tarefas intensivas em código ou lógica que precisam de infraestrutura de baixo custo e auto-hospedável. A filosofia de alinhamento, a fluência de linguagem e o ecossistema empresarial do Claude fazem dele a melhor escolha para aplicações voltadas ao cliente, fluxos sensíveis à segurança ou qualquer cenário em que qualidade de linguagem natural e comportamento previsível pesem de verdade.
A pergunta mais útil não é qual modelo é melhor, e sim o que a sua carga de trabalho realmente exige. Em muitas arquiteturas do mundo real, faz sentido usar ambos, roteando tarefas por tipo em vez de se comprometer exclusivamente com um único provedor.
Aprenda com a DataCamp
Curso
Curso
Pratique e programa seu progresso.
Continuar Com O Googleblog
Khalid Abdelaty
15 min
blog
Javier Canales Luna
14 min
blog
Richie Cotton
7 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Abid Ali Awan
Tutorial
Zoumana Keita
12 min


