
Cursus
Werken met de OpenAI API
3 uur
179.5K
Stel, je bouwt een pipeline die complexe meerstaps code-redenering én samenvattingen voor klanten moet afhandelen. Voor welk model kies je dan? Dat is het soort vraag dat deze vergelijking nuttig maakt—niet als benchmarkoefening, maar als een praktische keuze die bepaalt wat je systeem daadwerkelijk kan.
Hier zie je hoe DeepSeek en Claude verschillen in architectuur, prestaties en prijs, zodat je kunt kiezen op basis van je daadwerkelijke workload.
Ben je geïnteresseerd in actuele AI-modellen? Bekijk dan ook onze gids over Meta's Muse Spark.
DeepSeek is een AI-modelfamilie ontwikkeld door het Chinese onderzoeksbedrijf Hangzhou DeepSeek Artificial Intelligence, gericht op geavanceerde redenering, coderen en logica-intensieve taken. De meeste modellen zijn vrij beschikbaar als open weights onder de MIT-licentie—een van de redenen waarom de release van DeepSeek-R1 in januari 2025 zo'n grote impact had. Het evenaarde de redeneerkwaliteit van toonaangevende propriëtaire modellen tegen een fractie van de trainingskosten.
De line-up ontwikkelde zich snel. DeepSeek-V3 (december 2024) zette een solide, generalistische basis neer, terwijl R1 een dedicated redeneermodel introduceerde dat is getraind met reinforcement learning, ontworpen om problemen stap voor stap te doorlopen voordat het antwoordt. DeepSeek-V3.1 volgde met een hybride architectuur die in één deployment schakelt tussen "denk"- en "niet-denk"-modi. DeepSeek V4 wordt breed verwacht als de volgende grote release, met vroege signalen van sterker coderen, long-context software engineering en native multimodale ondersteuning.
DeepSeek blinkt uit in logische ketens, precieze gestructureerde redenering en snelle inferentie. Het is een logische keuze voor developers die werken aan analytische of code-intensieve taken.
Claude is de AI-modelfamilie van Anthropic, gebouwd rond een kernfilosofie van afgestemde redenering: modellen maken die capabel, consistent, eerlijk en minder geneigd zijn om ontspoord te raken. De huidige Claude 4-familie omvat Haiku 4.5 (snel en lichtgewicht), Sonnet 4.6 (de dagelijkse werkpaard) en Opus 4.6 (de vlaggendrager voor complexe redenering en long-context-taken).
Wat Claude onderscheidt, is zijn conversatievloeiendheid, genuanceerd instructievolgen en op veiligheid gerichte gedrag. Claude-modellen zijn multimodaal en verwerken tekst, afbeeldingen en documenten. Opus 4.6 en Sonnet 4.6 ondersteunen allebei een contextvenster van 1 miljoen tokens—een van de grootste in 2026. Voor teams die klantgerichte tools of enterprise-workflows bouwen waar betrouwbaarheid telt, vertalen die ontwerpkeuzes zich in concrete, praktische voordelen.
DeepSeek benadert intelligentie vanuit een redenering-first invalshoek. De R1-lijn is getraind met reinforcement learning om expliciete keten-van-gedachte-redenering te ontwikkelen, zodat het model problemen methodisch doorloopt voordat het antwoordt. Dat zie je duidelijk bij wiskunde, logica en code: gestructureerde, stapsgewijze oplossingen die makkelijk te controleren zijn.
Claude is getraind met Constitutional AI, Anthropic's alignment-techniek, die de redenering stuurt richting veiligheid, samenhang en eerlijke antwoorden. Het resultaat is een generalist die breed inzetbaar is in plaats van smal gespecialiseerd. Dit verschil zie je ook bij ambigue prompts. DeepSeek heeft in open-einde-scenario's vaak preciezere prompt-engineering nodig, terwijl Claude conversatiedrift goed opvangt en de intentie meestal zonder veel begeleiding afleidt.
Claude Opus 4.6 en Sonnet 4.6 ondersteunen 1M-tokenvensters tegen standaardprijzen. DeepSeek-V3.1 ondersteunt tot 128K tokens. Qua inferentie houdt DeepSeek's Mixture-of-Experts-architectuur (671B totale parameters, 37B geactiveerd per token) de kosten laag door slechts een deel van het netwerk per request te activeren. De architectuur van Claude is propriëtair, maar de prestaties over redeneren, coderen en multimodale taken zijn goed vastgesteld in onafhankelijke evaluaties.
Prestatieverschillen zijn reëel, maar taakafhankelijk. Geen van beide modellen is overal de beste.
Hier is DeepSeek sterk gespecialiseerd. Het R1-model is gebouwd om zijn redeneerstappen te tonen, waardoor het goed past bij problemen waarbij je het pad wilt verifiëren, niet alleen het antwoord: algoritmen, bewijzen, formele wiskunde. Claude benadert redeneren vanuit een generalistische lens en is sterker in synthese en oordeelsvormingstaken die bewijs, context en nuance combineren. Als het probleem een formele structuur heeft, is DeepSeek's chain-of-thought-uitvoer vaak makkelijker te controleren. Als het gaat om het afwegen van perspectieven, doet Claude het doorgaans beter.
DeepSeek is specifiek afgestemd op coderedenering, met sterke resultaten op algoritmische uitdagingen en geïsoleerde codetaken. Claude loopt vaak voor op bredere software-engineering: het begrijpen van een multibestandsarchitectuur, refactoren over een groot project, redeneren over systeemontwerp over veel interacties. Voor snelle scripts of het debuggen van een specifieke functie is DeepSeek een solide keuze. Voor codereview of complex werk op projectniveau wordt Claude's coherentie in lange contexten een echt voordeel.
Claude staat bekend om zijn natuurlijke taalvloeiendheid. De training beloont expliciet samenhangende, goed gestructureerde tekst, waardoor het de sterkere keuze is voor klantgerichte content, gepolijste samenvattingen of alles waar toon telt. DeepSeek kan tekstgeneratie goed aan, maar de uitvoerkwaliteit is taakafhankelijker en neigt naar beknoptheid bij open prompts.
Claude volgt meerledige instructies betrouwbaar over lange gesprekken, zelfs wanneer prompts evolueren of meerdere beperkingen tegelijk bevatten. DeepSeek verwerkt complexe prompts ook, maar profiteert van explicietere structurering, vooral in conversaties of meerstapsinteracties.
Claude Opus 4.6 en Sonnet 4.6 ondersteunen 1M-tokenvensters met sterke retrievalnauwkeurigheid over lange teksten. DeepSeek verwerkt lange contexten goed binnen zijn 128K-venster. Voor de meeste workloads kunnen beide het aan; het verschil telt vooral bij zeer grote contexten of wanneer exacte naald-in-hooiberg-retrieval prioriteit heeft.
Gepubliceerde benchmarkcijfers verschuiven tussen modelupdates en variëren sterk per taak en promptstijl. Zie elke specifieke vergelijking als richtinggevend, niet als definitief oordeel. De meest betrouwbare test is beide modellen draaien op jouw daadwerkelijke use-case.
DeepSeek's expliciete chain-of-thought-training maakt het een sterke keuze voor algoritmische uitdagingen, wiskundige bewijzen en debuggen van code waarbij je het model zijn werk wilt laten tonen. Developers die een capabel model tegen lage kosten willen voor analytische taken, zullen de DeepSeek API zeer competitief vinden.
Claude past beter wanneer je natuurlijke, vloeiende tekst nodig hebt: onderzoek samenvatten, klantcommunicatie opstellen of rapporten genereren voor niet-technische lezers. Dankzij de conversatiecoherentie over meerdere beurten is het ook zeer geschikt voor het bouwen van assistenten of chatbots.
Claude's Constitutional AI-training verkleint de kans op schadelijke, bevooroordeelde of afwijkende outputs. Teams in de zorg, het onderwijs of legal tech—waar modelgedrag in randgevallen echt risico draagt—zouden Claude's veiligheidsontwerp serieus moeten meewegen. DeepSeek's open karakter geeft je meer controle over fine-tuning en deployment, maar legt ook meer verantwoordelijkheid bij je team om outputveiligheid te managen.
DeepSeek's efficiënte architectuur maakt inferentie opvallend betaalbaar. De MIT-gelicentieerde weights kun je downloaden en lokaal draaien. Voor hoge volumes, projecten met een krap budget of teams die willen self-hosten, zijn DeepSeek's prijsstelling en deploymentflexibiliteit lastig te overtreffen.
Beide modellen ondersteunen codecompletion en -generatie in populaire talen, maar hun sterke punten lopen uiteen op taakniveau. DeepSeek presteert goed bij gefocuste generatie: een specifieke functie schrijven, een algoritme implementeren of unittests genereren. Claude is doorgaans sterker in refactoringtaken die begrip van bredere architecturale context vereisen, zoals patronen consequent hernoemen, ontwerpissues identificeren of uitleggen waarom een bepaalde structuur downstream-problemen veroorzaakt.
Voor API-integratie heeft Claude diepe ondersteuning via AWS Bedrock, Google Vertex AI en Microsoft Foundry. Opus 4.6 is ontworpen voor langetermijn-, meerstaps agent-taken. DeepSeek is toegankelijk via platform.deepseek.com en via een groeiend ecosysteem van derden; de open weights maken het populair bij teams die self-hosted inferentiestacks bouwen.
Claude verwerkt samenvatten en open Q&A goed. Antwoorden zijn geordend, contextbewust en prettig leesbaar, en het model synthesizeert meerdere bronnen vanzelf tot een samenhangend antwoord. Bij complexe instructies volgt Claude alle vereisten betrouwbaar over lange outputs. DeepSeek presteert competitief op gestructureerde Q&A en feitelijke retrieval, al profiteert het van explicietere stapsgewijze structurering in de prompt.
Over hallucinaties: door veiligheidsgerichte training is Claude eerder geneigd te nuanceren of te weigeren bij onzekerheid; dat vermindert zelfverzekerde fouten, maar kan soms te voorzichtige antwoorden opleveren. DeepSeek's redeneermodellen zijn over het algemeen betrouwbaarder bij taken met verifieerbare antwoorden, maar kunnen nog steeds zelfverzekerde fouten maken buiten hun trainingsdata. Geen van beide is immuun; beide profiteren van retrieval-augmented setups wanneer feitelijke nauwkeurigheid cruciaal is.
Claude is volledig propriëtair en toegankelijk via de abonnementstiers van Anthropic (free, Pro en Max) en een token-gebaseerde API voor Haiku 4.5, Sonnet 4.6 en Opus 4.6. Zakelijke toegang verloopt via Team- en Enterprise-plannen. Alle toegang is cloud-based via Anthropic of partners; er zijn geen open weights.
DeepSeek biedt modelweights gratis onder de MIT-licentie, waardoor self-hosted deployments haalbaar zijn voor teams met GPU-infrastructuur. Er is ook een gehoste API op platform.deepseek.com met betalen-per-token, inclusief aanzienlijke besparingen via promptcaching—aantrekkelijk voor workloads met hoog volume.
Voor de meeste teams komt het neer op deploymentbehoeften en het type workload. DeepSeek's lage kosten per token en self-hostingoptie werken goed voor budgetbewuste of privacy-first omgevingen. Claude's diepe cloudintegraties zijn logischer wanneer je binnen een bestaande enterprise-stack opereert of gegarandeerde uptime-SLA's nodig hebt.
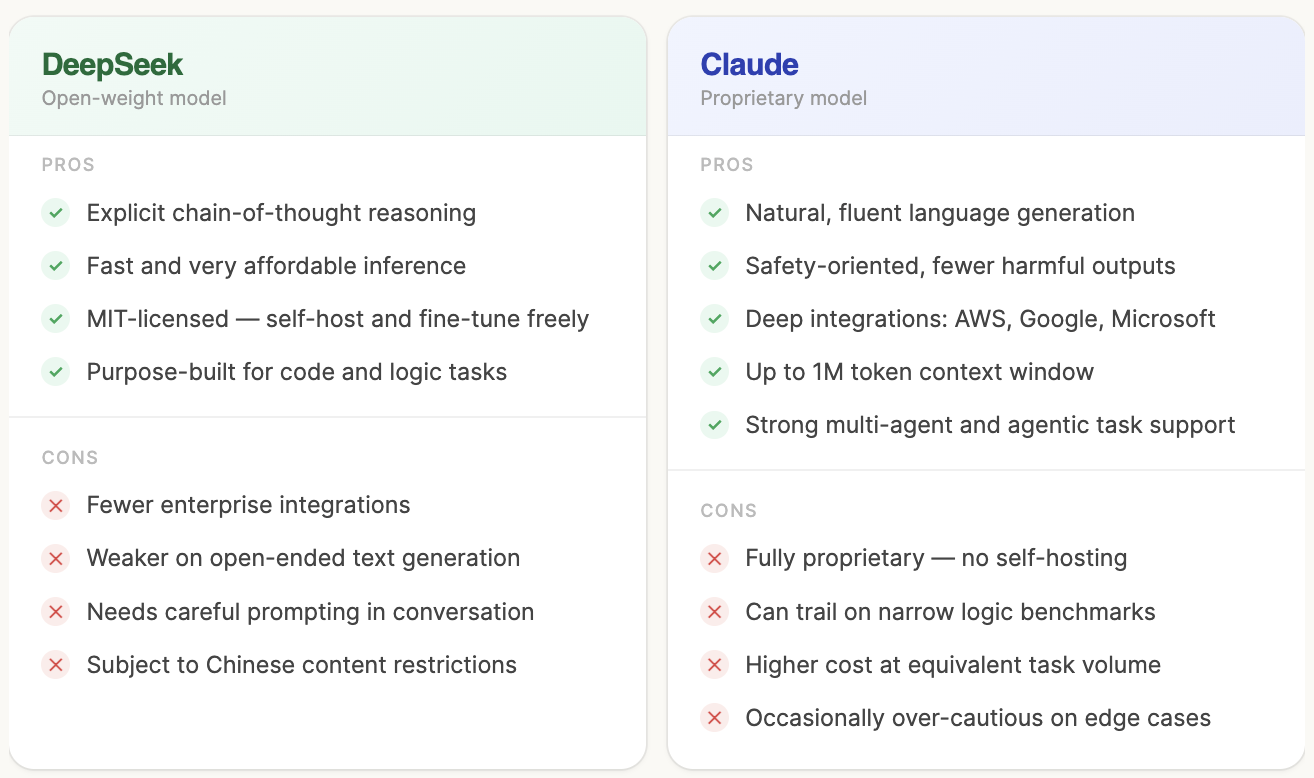
Beide zijn capabele, goed ondersteunde modellen die wezenlijk verschillende behoeften dienen. DeepSeek's open licenties, snelle inferentie en precieze redenering maken het een sterke match voor developers die werken aan code- of logica-intensieve taken en behoefte hebben aan goedkope, self-hostbare infrastructuur. Claude's alignmentfilosofie, taalvloeiendheid en enterprise-ecosysteem maken het de betere keuze voor klantgerichte toepassingen, veiligheidssensitieve workflows of overal waar taalkwaliteit en voorspelbaar gedrag zwaar wegen.
De nuttigere vraag is niet welk model beter is, maar wat jouw workload vraagt. In veel real-world architecturen is er een sterke case om beide te gebruiken, en taken te routeren op type in plaats van je exclusief aan één provider te verbinden.
Leren met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

