

Kurs
Arbeiten mit der OpenAI-API
3 Std.
183.4K
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleAngenommen, du baust eine Pipeline, die komplexes mehrstufiges Code-Reasoning und die Zusammenfassung von kundenrelevanten Dokumenten bewältigen muss. Zu welchem Modell greifst du? Genau für solche Entscheidungen ist dieser Vergleich hilfreich – nicht als Benchmark-Spielerei, sondern als praxisnahe Orientierung dafür, was dein System tatsächlich leisten kann.
So unterscheiden sich DeepSeek und Claude in Architektur, Leistung und Preisgestaltung – damit du anhand deines realen Workloads wählen kannst.
Wenn du dich für aktuelle KI-Modelle interessierst, schau dir auch unseren Guide zu Metas Muse Spark an.
DeepSeek ist eine KI-Modellfamilie des chinesischen Forschungsunternehmens Hangzhou DeepSeek Artificial Intelligence, die auf fortgeschrittenes Reasoning, Coding und logiklastige Aufgaben ausgelegt ist. Die meisten Modelle sind als Open Weights unter der MIT-Lizenz frei verfügbar – einer der Gründe, warum der DeepSeek-R1-Release im Januar 2025 so viel Aufsehen erregt hat. Er erreichte Reasoning-Qualität auf dem Niveau führender proprietärer Modelle bei einem Bruchteil der Trainingskosten.
Die Produktlinie entwickelt sich rasant. DeepSeek-V3 (Dezember 2024) etablierte eine starke General-Purpose-Basis, während R1 ein dediziertes Reasoning-Modell einführte, das mit Reinforcement Learning trainiert wurde und Probleme Schritt für Schritt durchdenkt, bevor es antwortet. DeepSeek-V3.1 folgte mit einer Hybridarchitektur, die in einer einzigen Bereitstellung zwischen „Thinking“- und „Non-Thinking“-Modus wechselt. DeepSeek V4 wird als nächstes großes Release erwartet – frühe Berichte deuten auf stärkeres Coding, Long-Context-Softwareentwicklung und native Multimodalität hin.
DeepSeeks Stärken liegen in Logikketten, präzisem strukturierten Reasoning und schneller Inferenz. Es ist eine natürliche Wahl für Entwicklerinnen und Entwickler, die an analytischen oder codeintensiven Aufgaben arbeiten.
Claude ist Anthropics KI-Modellfamilie, aufgebaut auf der Kernphilosophie des ausgerichteten Reasonings: fähige, konsistente, ehrliche Modelle, die seltener aus der Spur geraten. Die aktuelle Claude-4-Familie umfasst Haiku 4.5 (schnell und schlank), Sonnet 4.6 (der Alltags-Arbeitspferd) und Opus 4.6 (das Flaggschiff für komplexes Reasoning und Long-Context-Aufgaben).
Was Claude auszeichnet, ist seine dialogische Sprachgewandtheit, nuancierte Befolgung von Anweisungen und sicherheitsorientiertes Verhalten. Claude-Modelle sind multimodal und verarbeiten Text, Bilder und Dokumente. Opus 4.6 und Sonnet 4.6 unterstützen jeweils ein Kontextfenster von 1 Million Tokens – eines der größten im Jahr 2026. Für Teams, die kundennahe Tools oder Enterprise-Workflows bauen, in denen Verlässlichkeit zählt, zahlen sich diese Designprioritäten praktisch aus.
DeepSeek nähert sich Intelligenz aus einer Reasoning-First-Perspektive. Die R1-Linie wurde mit Reinforcement Learning trainiert, um explizites Chain-of-Thought-Reasoning zu entwickeln – das Modell arbeitet Probleme methodisch durch, bevor es antwortet. Das zeigt sich klar in Mathe, Logik und Code: strukturierte, schrittweise Lösungen, die sich gut prüfen lassen.
Claude wird mit Constitutional AI trainiert, Anthropics Alignment-Technik, die das Reasoning in Richtung Sicherheit, Kohärenz und ehrliche Antworten formt. Ergebnis ist ein Generalist mit breiter Befähigung statt enger Spezialisierung. Das zeigt sich auch bei mehrdeutigen Prompts. DeepSeek braucht in offenen Szenarien tendenziell präzisere Prompt-Engineering, während Claude mit Gesprächsdrift gut umgeht und Absichten meist ohne viel Handholding erschließt.
Claude Opus 4.6 und Sonnet 4.6 unterstützen 1 Mio. Token-Kontext bei Standardpreisen. DeepSeek-V3.1 unterstützt bis zu 128K Tokens. In der Inferenz hält DeepSeeks Mixture-of-Experts-Architektur (671B Gesamtparameter, 37B pro Token aktiviert) die Kosten niedrig, indem pro Anfrage nur Teile des Netzes aktiviert werden. Claudes Architektur ist proprietär, seine Leistung über Reasoning, Coding und multimodale Aufgaben hinweg ist jedoch in unabhängigen Evaluierungen gut belegt.
Leistungsunterschiede sind real, aber aufgabenabhängig. Kein Modell führt in allen Disziplinen.
Hier ist DeepSeek stark spezialisiert. R1 wurde gebaut, um seine Gedankengänge zu zeigen – ideal für Probleme, bei denen der Weg genauso wichtig ist wie das Ergebnis: Algorithmen, Beweise, formale Mathematik. Claude nähert sich Reasoning als Generalist und ist dadurch stärker in Synthese- und Beurteilungsaufgaben, die Evidenz, Kontext und Nuancen verbinden. Hat das Problem eine formale Struktur, lässt sich DeepSeeks Chain-of-Thought-Ausgabe oft leichter prüfen. Geht es um Abwägungen, liegt Claude häufig vorn.
DeepSeek ist speziell auf Code-Reasoning zugeschnitten und liefert starke Ergebnisse bei algorithmischen Herausforderungen und isolierten Codieraufgaben. Claude punktet eher bei breiter Softwaretechnik: Verständnis von Mehrdatei-Architekturen, Refactoring über große Projekte, Systemdesign über viele Turns hinweg. Für schnelle Skripte oder das Debuggen einer spezifischen Funktion ist DeepSeek eine gute Wahl. Für Code-Reviews oder komplexe Projektarbeit wird Claudes Langkontext-Kohärenz zum echten Vorteil.
Claude ist für seine natürliche Sprachflüssigkeit bekannt. Das Training belohnt explizit kohärente, gut strukturierte Prosa – die bessere Wahl für kundenorientierte Inhalte, polierte Zusammenfassungen oder alles, wo Tonalität zählt. DeepSeek meistert Textgenerierung gut, aber die Qualität ist stärker aufgabenabhängig und bei offenen Prompts eher knapp gehalten.
Claude verfolgt mehrteilige Anweisungen zuverlässig über lange Dialoge hinweg, selbst wenn Prompts sich weiterentwickeln oder mehrere Vorgaben gleichzeitig tragen. DeepSeek bewältigt komplexe Prompts ebenfalls, profitiert aber von expliziterer Struktur – besonders in dialogischen oder mehrstufigen Settings.
Claude Opus 4.6 und Sonnet 4.6 unterstützen 1 Mio. Token mit hoher Retrieval-Genauigkeit über lange Texte. DeepSeek verarbeitet lange Kontexte solide innerhalb seines 128K-Fensters. Für die meisten Workloads sind beide fähig; die Lücke zählt vor allem bei sehr großen Kontexten oder wenn präzises Needle-in-a-Haystack-Retrieval Priorität hat.
Veröffentlichte Benchmark-Scores verschieben sich mit Model-Updates und variieren stark nach Aufgabe und Prompt-Stil. Sieh jeden Vergleich als Richtungsindikator, nicht als Urteil. Am zuverlässigsten ist der Test mit deinem konkreten Use Case.
DeepSeeks explizites Chain-of-Thought-Training macht es stark für algorithmische Herausforderungen, mathematische Beweise und Code-Debugging, bei denen das Modell seine Herleitung zeigen soll. Entwicklerinnen und Entwickler, die für analytische Aufgaben ein leistungsfähiges, kostengünstiges Modell suchen, finden die DeepSeek-API sehr wettbewerbsfähig.
Claude ist die bessere Wahl, wenn du natürliche, flüssige Texte brauchst: Forschungszusammenfassungen, Entwürfe für Kundenkommunikation oder Berichte für nicht-technische Zielgruppen. Die dialogische Kohärenz über viele Turns macht Claude außerdem ideal für Assistenten oder Chatbots.
Claudes Constitutional-AI-Training reduziert die Wahrscheinlichkeit schädlicher, verzerrter oder thematisch verfehlter Ausgaben. Teams im Gesundheitswesen, in der Bildung oder Legal Tech, wo Modellverhalten in Randfällen reale Risiken birgt, sollten Claudes Sicherheitsdesign ernsthaft gewichten. DeepSeeks offene Natur gibt dir mehr Kontrolle über Finetuning und Deployment, überträgt aber auch mehr Verantwortung ans Team, die Outputs abzusichern.
DeepSeeks effiziente Architektur macht Inferenz bemerkenswert günstig. Die MIT-lizenzierten Gewichte können heruntergeladen und lokal betrieben werden. Für hohe Volumina, budgetknappe Projekte oder Teams, die selbst hosten wollen, sind DeepSeeks Preise und Bereitstellungsflexibilität kaum zu schlagen.
Beide Modelle unterstützen Code Completion und -Generierung in gängigen Sprachen, doch ihre Stärken trennen sich auf Aufgabenebene. DeepSeek überzeugt bei fokussierter Generierung: eine spezifische Funktion schreiben, einen Algorithmus implementieren oder Unit-Tests erzeugen. Claude ist tendenziell stärker beim Refactoring mit breiter Architekturperspektive – etwa konsistentes Umbenennen, Designprobleme erkennen oder begründen, warum eine Struktur downstream Probleme verursacht.
Für API-Integration bietet Claude tiefe Unterstützung über AWS Bedrock, Google Vertex AI und Microsoft Foundry. Opus 4.6 ist auf langlaufende, mehrstufige Agentenaufgaben ausgelegt. DeepSeek ist über platform.deepseek.com und ein wachsendes Ökosystem von Drittanbietern zugänglich; die offenen Gewichte machen es zur beliebten Wahl für selbstgehostete Inferenz-Stacks.
Claude meistert Zusammenfassungen und offene Q&A-Aufgaben sehr gut. Antworten sind strukturiert, kontextbewusst und angenehm lesbar; mehrere Quellen werden natürlich zu einer kohärenten Antwort verbunden. Bei komplexer Anweisungsbefolgung hält Claude Anforderungen zuverlässig auch über lange Ausgaben hinweg nach. DeepSeek ist bei strukturiertem Q&A und faktischem Retrieval konkurrenzfähig, profitiert jedoch von expliziter Schritt-für-Schritt-Struktur im Prompt.
Zum Thema Halluzinationen: Claudes sicherheitsorientiertes Training führt eher zu vorsichtigen oder ablehnenden Antworten bei Unsicherheit – das reduziert selbstsichere Fehler, kann aber gelegentlich zu übervorsichtigen Reaktionen führen. DeepSeeks Reasoning-Modelle sind bei Aufgaben mit verifizierbaren Antworten meist zuverlässig, können außerhalb ihrer Trainingsdaten jedoch ebenfalls selbstsichere Fehler produzieren. Keines ist immun; beide profitieren von Retrieval-unterstützten Setups, wenn Faktentreue kritisch ist.
Claude ist vollständig proprietär und über Anthropics Abo-Stufen (Free, Pro, Max) sowie eine tokenbasierte API für Haiku 4.5, Sonnet 4.6 und Opus 4.6 verfügbar. Für Unternehmen gibt es Team- und Enterprise-Pläne. Der Zugriff erfolgt cloudbasiert über Anthropic oder Partner; es gibt keine offenen Gewichte.
DeepSeek stellt Modellgewichte frei unter der MIT-Lizenz bereit, wodurch Self-Hosting für Teams mit GPU-Infrastruktur möglich ist. Zusätzlich gibt es eine gehostete API unter platform.deepseek.com mit Pay-per-Token-Preisen und teils deutlichen Einsparungen durch Prompt-Caching – attraktiv für hohe Volumina.
Für die meisten Teams hängt die Entscheidung von Deployment-Bedarf und Workload ab. DeepSeeks niedrige Tokenkosten und die Option zum Self-Hosting passen gut zu budget- oder datenschutzgetriebenen Umgebungen. Claudes tiefe Cloud-Integrationen sind sinnvoll, wenn du in einem bestehenden Enterprise-Stack arbeitest oder garantierte Uptime-SLAs brauchst.
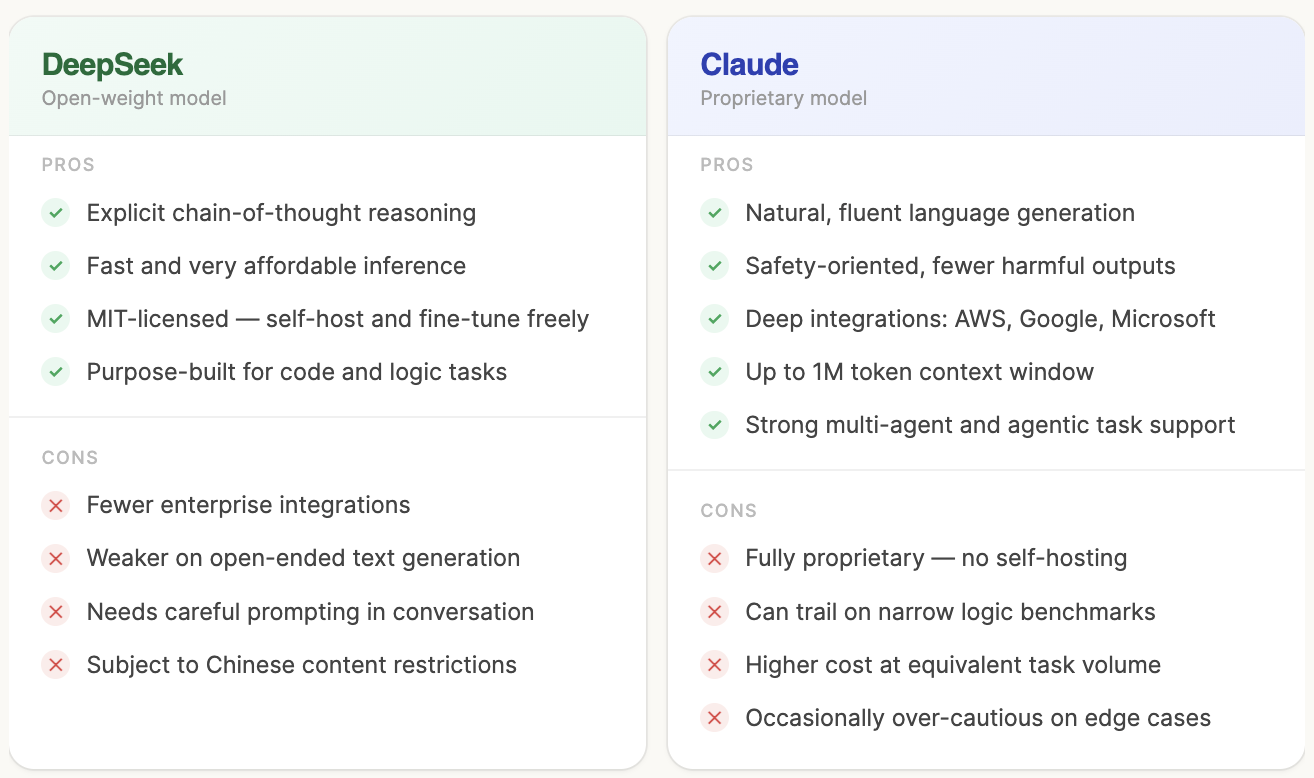
Beide sind leistungsfähige, gut unterstützte Modelle für unterschiedliche Bedürfnisse. DeepSeeks offene Lizenzierung, schnelle Inferenz und präzises Reasoning passen ideal für Entwicklerinnen und Entwickler an code- oder logikintensiven Aufgaben, die günstige, selbsthostbare Infrastruktur brauchen. Claudes Alignment-Philosophie, Sprachflüssigkeit und Enterprise-Ökosystem machen es zur besseren Wahl für kundennahe Anwendungen, sicherheitssensible Workflows oder überall dort, wo Sprachqualität und berechenbares Verhalten entscheidend sind.
Die wirklich hilfreiche Frage ist nicht, welches Modell „besser“ ist, sondern was dein Workload verlangt. In vielen Real-World-Architekturen spricht viel dafür, beide einzusetzen und nach Aufgabentyp zu routen, statt dich exklusiv auf einen Anbieter festzulegen.
Lerne mit DataCamp
Kurs
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Nisha Arya Ahmed
15 Min.
Blog
Zoumana Keita
15 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Josef Waples
8 Min.


