Curso
Trabajar con la API de OpenAI
3 h
178K
Imagina que estás montando un pipeline que debe gestionar razonamiento de código complejo en varios pasos y resúmenes de documentos para clientes. ¿A qué modelo recurres? Este tipo de preguntas hacen útil esta comparativa: no como un simple benchmark, sino como una decisión práctica que determina lo que tu sistema puede hacer de verdad.
Así se diferencian DeepSeek y Claude en arquitectura, rendimiento y precio, para que elijas según tu carga de trabajo real.
Si te interesan los modelos de IA más recientes, no te pierdas también nuestra guía sobre Muse Spark de Meta.
DeepSeek es una familia de modelos de IA desarrollada por la empresa china de investigación Hangzhou DeepSeek Artificial Intelligence, centrada en tareas de razonamiento avanzado, programación y lógica. La mayoría de sus modelos están disponibles como pesos abiertos bajo la licencia MIT, en parte por eso el lanzamiento en enero de 2025 de DeepSeek-R1 fue tan relevante: igualó la calidad de razonamiento de modelos propietarios líderes con una fracción del coste de entrenamiento.
La gama ha evolucionado rápido. DeepSeek-V3 (diciembre de 2024) estableció una base sólida de propósito general, mientras que R1 introdujo un modelo de razonamiento dedicado entrenado con aprendizaje por refuerzo, diseñado para resolver problemas paso a paso antes de responder. DeepSeek-V3.1 llegó después con una arquitectura híbrida que alterna entre modos de "pensamiento" y "no pensamiento" en un único despliegue. DeepSeek V4 es uno de los lanzamientos más esperados, con informes preliminares que apuntan a un mejor rendimiento en programación, ingeniería de software con contextos largos y soporte multimodal nativo.
Los puntos fuertes de DeepSeek son las cadenas lógicas, la precisión en razonamiento estructurado y una inferencia rápida. Es un encaje natural para desarrolladores que trabajan en tareas analíticas o muy orientadas a código.
Claude es la familia de modelos de IA de Anthropic, construida sobre una filosofía de razonamiento alineado: crear modelos capaces, coherentes, honestos y menos propensos a desviarse. La familia Claude 4 actual incluye Haiku 4.5 (rápido y ligero), Sonnet 4.6 (el caballo de batalla del día a día) y Opus 4.6 (el buque insignia para razonamiento complejo y contextos largos).
Claude destaca por su fluidez conversacional, su seguimiento matizado de instrucciones y su comportamiento orientado a la seguridad. Los modelos Claude son multimodales y gestionan texto, imágenes y documentos. Opus 4.6 y Sonnet 4.6 soportan una ventana de contexto de 1 millón de tokens, una de las mayores disponibles en 2026. Para equipos que construyen herramientas de cara al cliente o flujos de trabajo empresariales donde la fiabilidad importa, esas prioridades de diseño se traducen en ventajas prácticas reales.
DeepSeek aborda la inteligencia desde el razonamiento como primer principio. Su linaje R1 se entrenó con aprendizaje por refuerzo para desarrollar cadenas de razonamiento explícitas, de modo que el modelo trabaja los problemas metódicamente antes de contestar. Esto se ve con claridad en matemáticas, lógica y código: soluciones estructuradas, paso a paso, fáciles de auditar.
Claude se entrena con Constitutional AI, la técnica de alineación de Anthropic, que orienta su razonamiento hacia la seguridad, la coherencia y respuestas honestas. El resultado es un generalista ampliamente capaz, no un especialista estrecho. Esta diferencia también aparece con prompts ambiguos. DeepSeek suele requerir una ingeniería de prompts más precisa en escenarios abiertos, mientras que Claude maneja bien la deriva conversacional y suele inferir la intención sin demasiada guía.
Claude Opus 4.6 y Sonnet 4.6 admiten ventanas de 1 M de tokens a precio estándar. DeepSeek-V3.1 soporta hasta 128K tokens. En inferencia, la arquitectura Mixture-of-Experts de DeepSeek (671B parámetros totales, 37B activados por token) mantiene bajos los costes activando solo parte de la red por solicitud. La arquitectura de Claude es propietaria, pero su rendimiento en razonamiento, programación y tareas multimodales está bien establecido en evaluaciones independientes.
Las diferencias de rendimiento existen, pero dependen de la tarea. Ningún modelo lidera en todo.
DeepSeek está muy especializado aquí. Su modelo R1 se diseñó para mostrar los pasos de razonamiento, lo que lo hace idóneo para problemas donde necesitas verificar el camino, no solo la respuesta: algoritmos, demostraciones, matemáticas formales. Claude aborda el razonamiento desde una óptica generalista, por lo que sobresale en síntesis y tareas de juicio que combinan evidencia, contexto y matices. Si el problema tiene estructura formal, la cadena de pensamiento de DeepSeek suele ser más fácil de auditar. Si requiere sopesar perspectivas, Claude tiende a rendir mejor.
DeepSeek está específicamente afinado para el razonamiento de código, con muy buenos resultados en retos algorítmicos y tareas de programación aisladas. Claude suele destacar en ingeniería de software más amplia: comprender arquitecturas multifichero, refactorizar un proyecto grande o razonar sobre el diseño de sistemas a lo largo de muchas interacciones. Para scripts rápidos o depurar una función concreta, DeepSeek es una apuesta segura. Para revisión de código o trabajo complejo a nivel de proyecto, la coherencia en contextos largos de Claude aporta una ventaja real.
Claude es ampliamente reconocido por su fluidez en lenguaje natural. Su entrenamiento premia explícitamente la prosa coherente y bien estructurada, lo que lo convierte en la mejor opción para contenido de cara al cliente, resúmenes pulidos o cualquier cosa donde el tono importe. DeepSeek genera texto correctamente, pero la calidad depende más de la tarea y tiende a ser más conciso en prompts abiertos.
Claude sigue instrucciones multipartes de forma fiable a lo largo de conversaciones largas, incluso cuando los prompts evolucionan o acumulan múltiples restricciones a la vez. DeepSeek también maneja prompts complejos, pero se beneficia de una estructuración más explícita, especialmente en entornos conversacionales o de varios turnos.
Claude Opus 4.6 y Sonnet 4.6 admiten ventanas de 1 M de tokens con buena precisión de recuperación en textos extensos. DeepSeek gestiona bien contextos largos dentro de su ventana de 128K. Para la mayoría de cargas, ambos son capaces; la diferencia importa sobre todo con contextos muy grandes o cuando priorizas recuperar con precisión una "aguja en un pajar".
Los resultados publicados cambian entre versiones y varían mucho según la tarea y el estilo de prompt. Toma cualquier comparativa concreta como una señal orientativa, no como un veredicto. La prueba más fiable es ejecutar ambos modelos en tu caso de uso real.
El entrenamiento de DeepSeek con cadenas de pensamiento explícitas lo hace ideal para retos algorítmicos, demostraciones matemáticas y depuración de código donde necesitas que el modelo muestre su proceso. Los desarrolladores que busquen un modelo potente y de bajo coste para tareas analíticas encontrarán la API de DeepSeek muy competitiva.
Claude encaja mejor cuando necesitas texto natural y fluido: resumir investigaciones, redactar comunicaciones para clientes o generar informes para lectores no técnicos. Su coherencia conversacional en interacciones de varios turnos también lo hace idóneo para crear asistentes o chatbots.
El entrenamiento con Constitutional AI de Claude reduce la probabilidad de salidas dañinas, sesgadas o fuera de lugar. Equipos en salud, educación o legaltech, donde el comportamiento del modelo en casos límite conlleva riesgo real, deberían valorar en serio el diseño de seguridad de Claude. La naturaleza abierta de DeepSeek te da más control sobre el ajuste fino y el despliegue, pero también más responsabilidad para gestionar la seguridad de las salidas.
La arquitectura eficiente de DeepSeek hace que la inferencia sea sorprendentemente asequible. Sus pesos con licencia MIT se pueden descargar y ejecutar en local. Para tareas de alto volumen, proyectos con presupuesto ajustado o equipos que quieran autoalojar, el precio y la flexibilidad de despliegue de DeepSeek son difíciles de superar.
Ambos modelos admiten autocompletado y generación de código en los lenguajes más populares, pero sus puntos fuertes divergen según la tarea. DeepSeek rinde muy bien en generación focalizada: escribir una función concreta, implementar un algoritmo o generar tests unitarios. Claude suele ser más sólido en refactorizaciones que requieren comprender el contexto arquitectónico más amplio, como aplicar patrones de renombrado de forma consistente, identificar problemas de diseño o explicar por qué una determinada estructura causará problemas más adelante.
Para integración por API, Claude tiene soporte profundo en AWS Bedrock, Google Vertex AI y Microsoft Foundry. Opus 4.6 está diseñado para tareas de agentes multietapa y de largo horizonte. DeepSeek es accesible vía platform.deepseek.com y a través de un ecosistema creciente de proveedores terceros; sus pesos abiertos lo convierten en una opción popular para equipos que construyen pilas de inferencia autoalojadas.
Claude gestiona muy bien el resumen y el Q&A abierto. Sus respuestas están organizadas, son conscientes del contexto y se leen con facilidad, y sintetiza de forma natural múltiples fuentes en una respuesta coherente. En seguimiento de instrucciones complejas, Claude mantiene los requisitos de forma fiable en salidas largas. DeepSeek compite bien en Q&A estructurado y recuperación factual, aunque se beneficia de una estructuración paso a paso más explícita en el prompt.
Sobre las alucinaciones: el entrenamiento alineado con seguridad de Claude hace que sea más probable que matice o rechace cuando no está seguro, lo que reduce errores confiados pero a veces puede resultar en respuestas demasiado cautas. Los modelos de razonamiento de DeepSeek suelen ser más fiables en tareas con respuestas verificables, pero aún pueden producir errores confiados fuera de sus datos de entrenamiento. Ninguno es inmune y ambos se benefician de configuraciones con recuperación aumentada cuando la precisión factual es crítica.
Claude es un modelo totalmente propietario accesible a través de los planes de suscripción de Anthropic (gratuito, Pro y Max) y una API por tokens que cubre Haiku 4.5, Sonnet 4.6 y Opus 4.6. El acceso para empresas llega mediante planes Team y Enterprise. Todo el acceso es en la nube a través de Anthropic o socios; no hay pesos abiertos.
DeepSeek ofrece pesos de modelo de forma gratuita bajo la licencia MIT, lo que hace viable el autoalojamiento para equipos con infraestructura GPU. También proporciona una API alojada en platform.deepseek.com con precios por token, con ahorros significativos gracias al caché de prompts, lo que resulta atractivo para cargas de alto volumen.
Para la mayoría de equipos, la decisión depende de las necesidades de despliegue y del tipo de trabajo. El bajo coste por token y la opción de autoalojar de DeepSeek funcionan bien en entornos con presupuesto ajustado o centrados en la privacidad. Las integraciones cloud de Claude tienen más sentido si operas dentro de un stack empresarial existente o necesitas SLAs de disponibilidad garantizada.
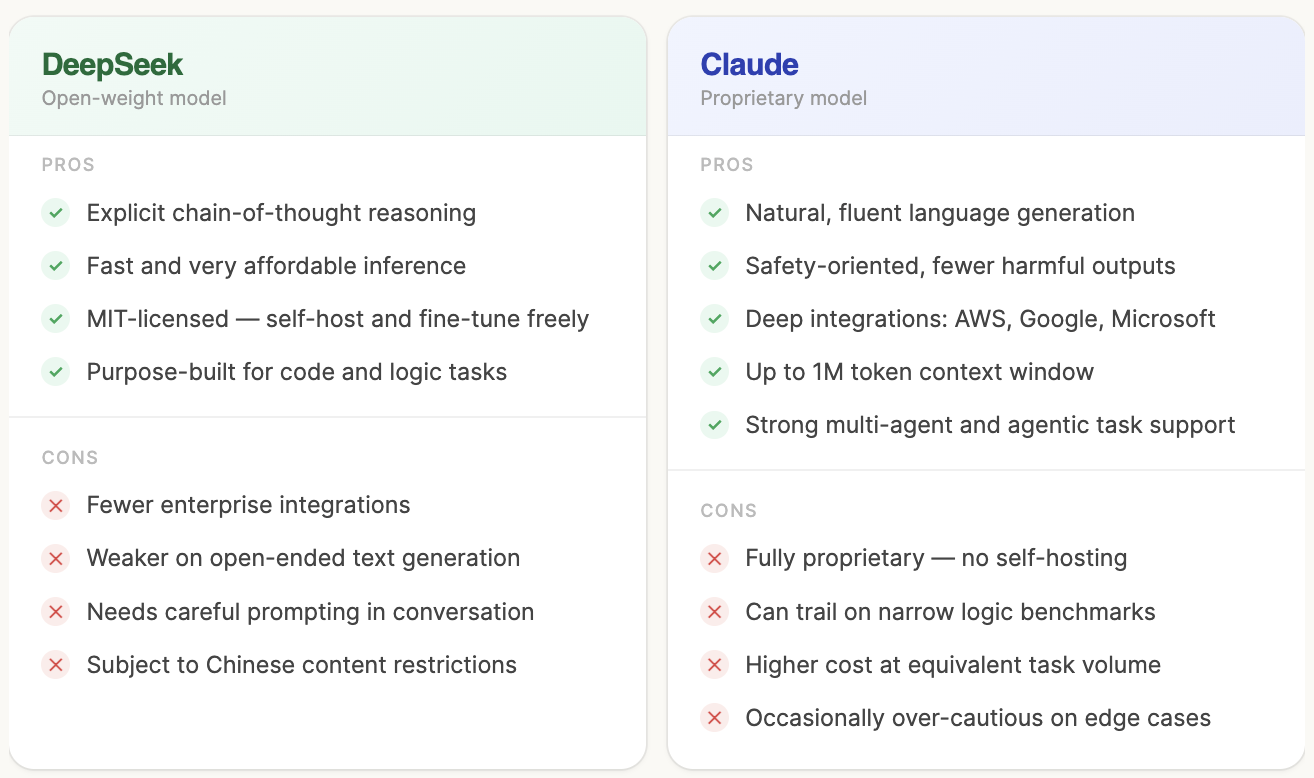
Ambos son modelos capaces y bien soportados que cubren necesidades claramente distintas. La licencia abierta de DeepSeek, su inferencia rápida y su precisión en razonamiento lo convierten en una gran opción para desarrolladores que trabajan en tareas intensivas en código o lógica y necesitan infraestructura de bajo coste y autoalojable. La filosofía de alineación de Claude, su fluidez lingüística y su ecosistema empresarial lo hacen mejor para aplicaciones de cara al cliente, flujos sensibles a la seguridad o cualquier situación donde la calidad del lenguaje y el comportamiento predecible pesen de verdad.
La pregunta útil no es qué modelo es mejor, sino qué exige tu carga de trabajo. En muchas arquitecturas reales, tiene sentido usar ambos y enrutar tareas por tipo en lugar de casarte con un único proveedor.
Aprende con DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
10 min
blog
Ryan Ong
8 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Abid Ali Awan
Tutorial
Zoumana Keita
12 min
Tutorial
Kurtis Pykes
7 min