
Menguji Grok 4
Saya sering menguji model baru, jadi saya cenderung menggunakan kembali beberapa tugas standar untuk melihat perbandingannya. Saya akan melakukan hal yang sama di sini, dengan fokus pada matematika dan pengodean. Ini tidak dimaksudkan sebagai evaluasi menyeluruh terhadap Grok—hanya cara untuk merasakan bagaimana perilakunya dalam pengaturan obrolan khas.
Matematika
Saya ingin mulai dengan perhitungan sederhana: 9,11 - 9,9. Ini mungkin terlihat konyol, tetapi sering membingungkan model bahasa—Claude Sonnet 4, misalnya, salah menjawabnya. Jelas, saya bisa saja menggunakan kalkulator, tetapi tujuan di sini adalah melihat bagaimana model mendekati masalah dan apakah ia dapat mengandalkan alat jika diperlukan atau menyelesaikannya langsung melalui penalaran rantai pemikiran.
Mari lihat bagaimana Grok 4 menjawab:
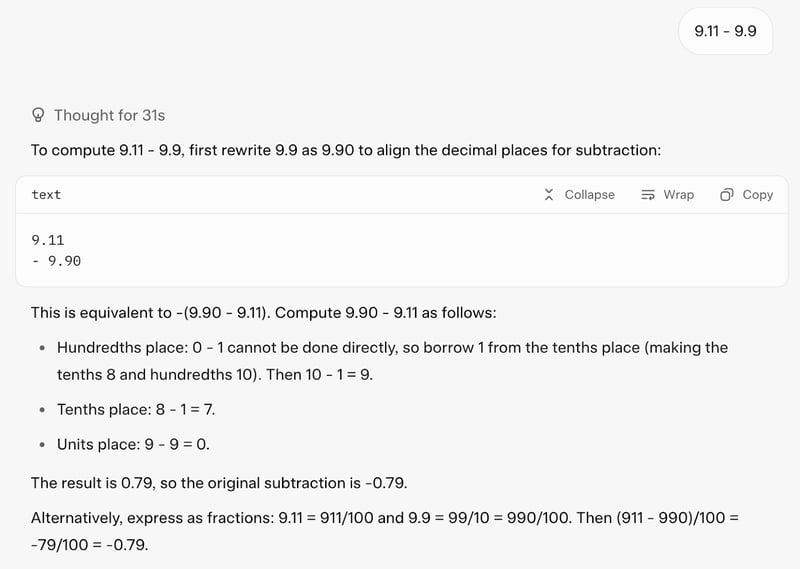
Ia menjawab dengan benar pada percobaan pertama. Ia menemukan jawabannya melalui penalaran rantai pemikiran, dan juga menggunakan alat kode untuk mengonfirmasi jawaban (bagus!).
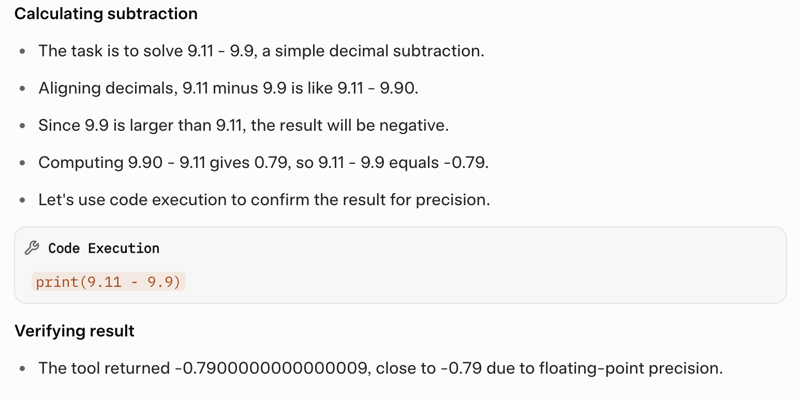
Namun, butuh 31 detik untuk merespons, dan keluarannya terlalu panjang untuk prompt sesederhana itu.
Berikutnya, saya ingin menguji Grok 4 pada masalah matematika yang lebih kompleks yang biasanya dapat mendorong batas jendela konteks model:
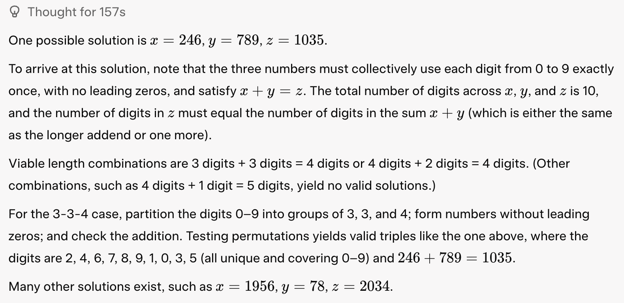
Prompt: Gunakan semua digit dari 0 hingga 9 masing-masing tepat sekali untuk membuat tiga bilangan x, y, z sehingga x + y = z.
Grok 4 mendekati masalah ini dengan cerdas. Pertama, ia menyadari bahwa ia dapat menghasilkan semua 3.628.800 permutasi angka 0–9 hanya dalam beberapa detik menggunakan Python. Lalu ia mencoba skema yang melibatkan dua bilangan 3 digit yang dijumlahkan menjadi bilangan 4 digit, dan membuat kode yang benar-benar menghasilkan 96 solusi valid!
from itertools import permutations
digits = range(10)
solutions = []
for p in permutations(digits):
x_digits = p[0:3]
if x_digits[0] == 0: continue
y_digits = p[3:6]
if y_digits[0] == 0: continue
z_digits = p[6:10]
if z_digits[0] == 0: continue
x = int(''.join(map(str, x_digits)))
y = int(''.join(map(str, y_digits)))
z = int(''.join(map(str, z_digits)))
if x + y == z:
solutions.append((x, y, z))
print(solutions)Kemudian, ia mencoba kombinasi lain (seperti 4 digit ditambah 2 digit sama dengan bilangan 4 digit) dengan pendekatan yang sama. Pada akhirnya, ia mencari di web untuk mempelajari lebih lanjut tentang teka-teki matematika ini dan mengonfirmasi jawabannya. Total butuh 157 detik untuk memberikan jawaban ini:
Pengodean
Untuk tugas pengodean, saya ingin melihat bagaimana perbandingannya dengan Gemini 2.5 Pro dan Claude Opus 4 pada tugas ini:
Prompt: Buatkan saya gim endless runner yang memikat. Instruksi kunci di layar. Adegan p5.js, tanpa HTML. Saya suka dinosaurus bergaya piksel dan latar belakang yang menarik.
Berikut hasilnya:
Kekurangan utamanya adalah gim langsung mulai tanpa memberi pengguna kesempatan untuk memulai sendiri. Dinosaurus pikselnya juga terlihat agak kasar. Meski begitu, instruksi di layar jelas, dan fungsionalitas dasarnya berjalan baik. Saya menyampaikan umpan balik ini ke Grok, dan berikut versi keduanya:
Cukup bagus!
Multimodal konteks panjang
Terakhir, saya ingin melihat seberapa baik Grok 4 menangani tugas multimodal dengan konteks panjang. Saya mengunggah PDF berisi Generative AI Outlook Report (43.087 token) dari Komisi Eropa dan meminta Grok untuk:
Prompt: Analisis seluruh laporan ini dan identifikasi tiga grafik yang paling informatif. Ringkas masing-masing dan beri tahu saya di halaman berapa dalam PDF grafik tersebut muncul.
Mari lihat jawabannya terlebih dahulu, lalu kita uraikan:
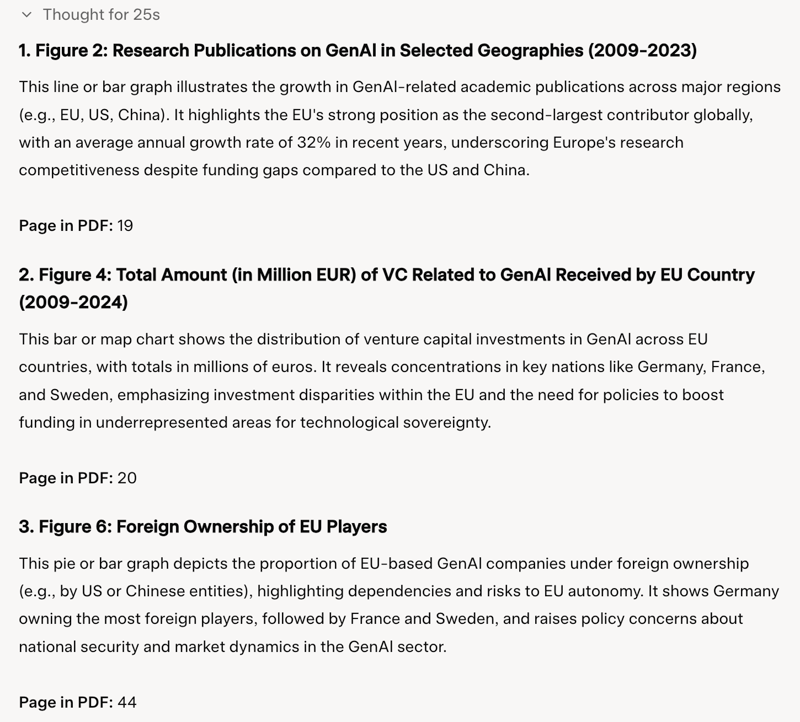
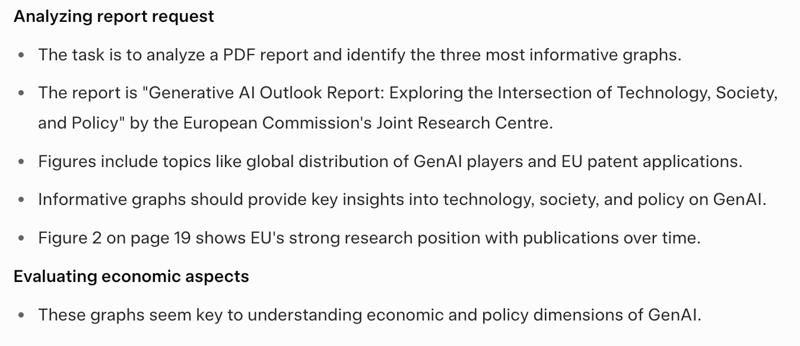
Satu hal yang saya perhatikan adalah model ini berhenti mengejutkan cepat, hanya setelah 25 detik. Ia merekomendasikan grafik dari halaman 19, 20, dan 44 (salah), dan tampaknya mengabaikan sisa dokumen 167 halaman begitu menemukan jawaban yang terlihat memadai. Rantai pemikirannya terasa tidak lengkap dan menunjukkan pendekatan yang cukup dangkal:
Sekarang, ke hasilnya:
- Semua nomor halaman salah.
- Ia tidak bisa mengidentifikasi jenis grafik dengan jelas—mengatakan hal seperti “grafik garis atau batang ini.”
- Jawabannya condong ke 50 halaman pertama dan kemungkinan besar melewatkan bagian penting di akhir laporan.
- Ia salah mengklasifikasikan diagram Sankey (Gambar 6) sebagai “diagram pai atau batang.”
- Ia mengira Gambar 6 sebagai Gambar 7 dan akhirnya menganalisis Gambar 7.
Seperti yang ditunjukkan Elon Musk dalam livestream, pemahaman dan generasi gambar Grok 4 masih belum terlalu canggih. Jika Anda ingin hasil yang konsisten dan andal, saya rasa wajar untuk mengatakan bahwa Grok 4 saat ini pada dasarnya adalah model berbasis teks.
Tolok Ukur Grok 4
Klaim utama Grok 4 adalah performanya di berbagai tolok ukur, dari ujian akademik hingga simulasi bisnis. Menurut xAI, model ini meningkat signifikan dibanding versi sebelumnya terutama berkat komputasi yang lebih besar—baik saat pelatihan maupun inferensi—bukan karena terobosan arsitektur baru.
Humanity’s Last Exam (HLE)
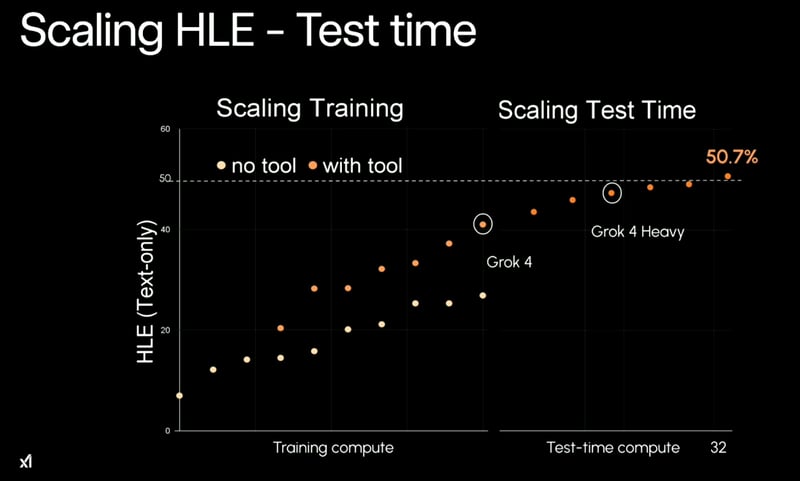
Pola inti di balik performa Grok 4 adalah skala. Ia diuntungkan oleh komputasi pelatihan yang lebih besar dan, yang lebih menarik, dari lebih banyak komputasi saat pengujian. Sederhananya: semakin banyak sumber daya yang Anda berikan, semakin baik performanya. Ini terlihat jelas pada kinerjanya di tugas Humanity’s Last Exam (HLE).
Sumber: xAI
Tanpa penggunaan alat, Grok 4 mencapai plateau sekitar 26,9% akurasi. Dengan alat diaktifkan (mis. eksekusi kode), ia mencapai 41,0%. Dan ketika dijalankan dalam konfigurasi multi-agen “Heavy”, nilainya naik menjadi 50,7%—lompatan besar yang lebih dari dua kali lipat skor model terbaik sebelumnya tanpa alat.
Tolok ukur akademik & STEM
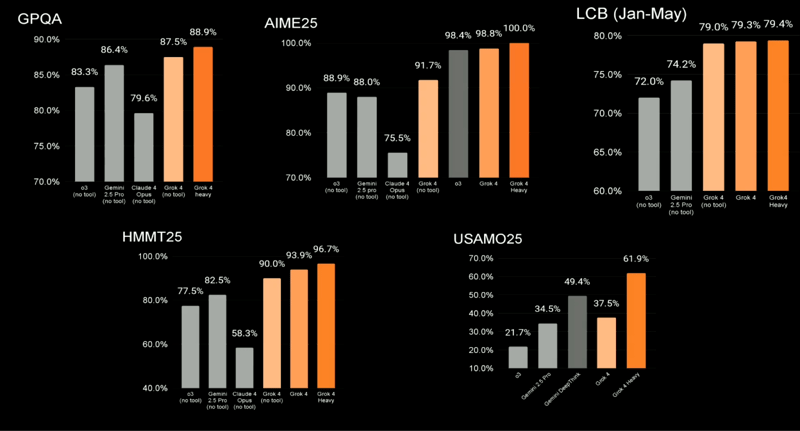
Grok 4 juga tampil baik pada evaluasi tradisional berfokus STEM, banyak di antaranya digunakan di seluruh bidang untuk membandingkan LLM berperforma tinggi. Sorotan meliputi:
|
Tolok Ukur |
Model Pesaing Teratas |
Grok 4 (Tanpa Alat) |
Grok 4 Heavy |
|
GPQA |
79,6–86,4% |
87,5% |
88,9% |
|
AIME25 |
75,5–98,8% |
91,7% |
100,0% |
|
LCB (Jan–Mei) |
72,0–74,2% |
79,0% |
79,4% |
|
HMMT25 |
58,3–82,5% |
90,0% |
96,7% |
|
USAMO25 |
21,7–49,4% |
37,5% |
61,9% |
Ini hasil yang solid. Grok 4 mengungguli Claude Opus, Gemini 2.5 Pro, dan GPT-4 (o3) di sebagian besar kategori, meskipun sebagian pengguna menunjukkan bahwa perbandingan tersebut mungkin melibatkan pemilihan skor dasar yang menguntungkan dari model pesaing.
Sumber: xAI
ARC-AGI (penalaran lanjutan)
Salah satu tolok ukur yang lebih sulit dan tidak transparan adalah ARC-AGI, yang menguji kemampuan model untuk menggeneralisasi di berbagai tugas penalaran abstrak. Pada ARC-AGI v1, Grok 4 mencetak 66,6%, di depan semua rekan yang diketahui. Pada ARC-AGI v2, ia mencetak 15,9%, dibanding 8,6% milik Claude 4 Opus.
Pengujian ini tidak sepenuhnya publik, jadi peringatan biasa berlaku. Namun jika angkanya valid, Grok 4 menunjukkan performa kuat dalam tugas penalaran multilangkah dan sarat logika.
Vending-Bench (simulasi bisnis)
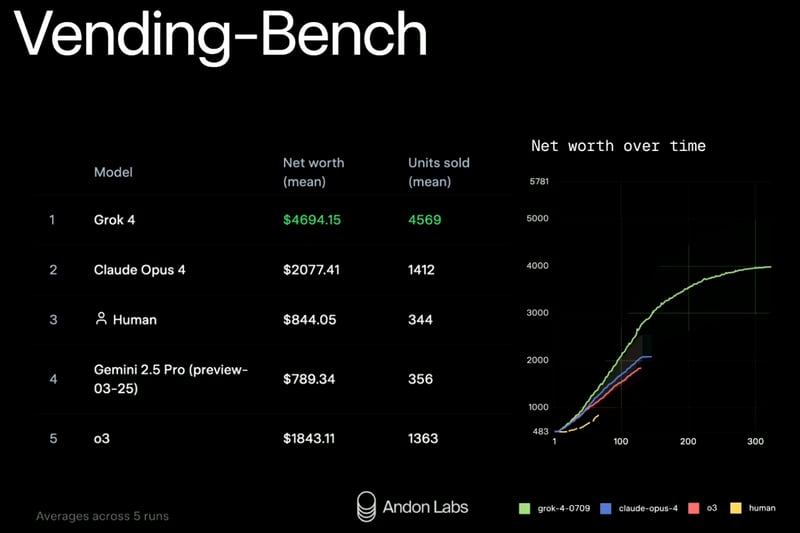
xAI juga menguji Grok 4 dalam simulasi dunia nyata bernama Vending-Bench. Gagasannya adalah melihat apakah model dapat mengelola usaha kecil dari waktu ke waktu: mengisi ulang inventaris, menyesuaikan harga, menghubungi pemasok, dll. Ini tolok ukur yang cukup baru dan mengejutkan cukup menyenangkan. Sebelumnya kami membahas cara kerjanya secara rinci melalui studi kasus Claude Sonnet 3.7 di buletin mingguan kami, The Median.
Hasil (dirata-ratakan dari lima kali jalan):
|
Peringkat |
Model |
Kekayaan Bersih |
Unit Terjual |
|
1 |
Grok 4 |
$4.694 |
4.569 |
|
2 |
Claude Opus 4 |
$2.077 |
1.412 |
|
3 |
Patokan manusia |
$ 844 |
344 |
|
4 |
Gemini 2.5 Pro |
$ 789 |
356 |
|
5 |
GPT-4 (o3) |
$1.843 |
1.363 |
Grok 4 lebih dari dua kali lipat kinerja pesaing terdekatnya dalam pendapatan dan skala. Ia juga mempertahankan performanya secara konsisten selama 300 putaran simulasi—sesuatu yang banyak model kesulitan saat dihadapkan pada perencanaan jangka panjang.
Sumber: xAI
Singkatnya: Grok 4 tampil baik di tempat xAI mengujinya. Namun seperti biasa, Anda harus melihat melampaui papan peringkat. Tolok ukur ini menjanjikan, tetapi tidak menceritakan keseluruhan cerita—terutama jika kasus penggunaan Anda bergantung pada visi, generasi kode, atau interaksi waktu nyata di lingkungan yang berantakan.
Cara Mengakses Grok 4
Grok 4 kini tersedia melalui tiga jalur utama: aplikasi X, xAI API, dan platform grok.com. Baik Anda ingin mengobrol dengan model, membangunnya, atau menguji kemampuan penalarannya secara lebih formal, berikut cara memulai.
Akses chat (via X)
Cara termudah untuk mencoba Grok 4 adalah melalui aplikasi X (sebelumnya Twitter). Ini memberi Anda akses ke Grok dalam antarmuka obrolan, mirip ChatGPT atau Claude.
Untuk menggunakannya:
- Berlangganan X Premium+, paket tingkat teratas.
- Buka aplikasi X (atau kunjungi x.com).
- Ketuk ikon Grok (navigasi bawah di ponsel, sidebar di desktop).
- Mulai mengobrol. Grok 4 adalah model default, tetapi Anda dapat beralih antar versi.
Akses langsung via Grok.com
Anda juga dapat menggunakan Grok 4 langsung melalui grok.com, yang menawarkan antarmuka mandiri yang lebih bersih di luar platform X. Ini ditujukan bagi pengguna yang lebih suka pengaturan tanpa distraksi.
- Kunjungi https://grok.com
- Daftar dan masuk.
- Akses Grok 4 dalam antarmuka obrolan, dengan dukungan untuk alat, kode, dan konteks panjang
xAI API untuk Grok 4
Jika Anda ingin mengintegrasikan Grok ke dalam aplikasi atau alur kerja Anda sendiri, Anda dapat menggunakan xAI API.
Langkah-langkah:
- Kunjungi https://x.ai/api dan minta akses pengembang.
- Setelah disetujui, Anda akan menerima kunci API dan akses ke dokumentasi.
- Pastikan membaca dokumentasinya untuk detail lebih lanjut.
Apa Berikutnya Setelah Grok 4
Dengan Grok 4 yang kini dirilis, xAI memaparkan peta jalan yang jelas (dan ambisius) untuk sisa tahun 2025. Menurut linimasa yang ditampilkan selama livestream, empat rilis besar dijadwalkan dalam tiga bulan ke depan: model pengodean pada Agustus, agen multimodal pada September, dan model generasi video pada Oktober.
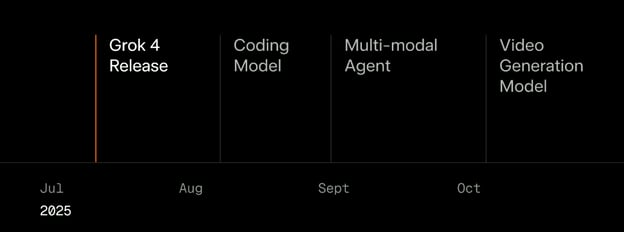
Sumber: xAI
Agustus: Model pengodean spesialis
Tindak lanjut pertama adalah model berfokus pengodean yang diperkirakan hadir pada Agustus. Berbeda dengan Grok 4 yang generalis, ini akan menjadi model khusus yang dirancang untuk menangani kode dengan kecepatan dan akurasi lebih tinggi. xAI menggambarkannya sebagai “cepat dan cerdas,” dilatih khusus untuk meningkatkan latensi dan penalaran dalam alur kerja pengembangan perangkat lunak.
September: Agen multimodal
Pada September, rencananya adalah merilis agen yang benar-benar multimodal. Saat ini, Grok 4 secara teknis mendukung input gambar dan video, tetapi pemahamannya terbatas—selama livestream, tim menggambarkannya seperti “mengerling melalui kaca buram.”
Versi mendatang bertujuan memperbaiki itu, memberi model persepsi yang lebih kuat pada gambar, video, dan audio. Ini akan penting untuk kasus penggunaan di luar teks: pikirkan robotika, permainan, QA video, atau pengikut instruksi visual.
Oktober: Model generasi video
Rilis terakhir dalam linimasa saat ini adalah model generasi video yang dijadwalkan pada Oktober. xAI mengatakan mereka akan melatihnya di lebih dari 100.000 GPU. Berdasarkan pernyataan mereka, sistem ini akan bertujuan menghasilkan konten video berkualitas tinggi, interaktif, dan dapat diedit.
Kesimpulan
Grok 4 adalah langkah besar bagi xAI. Ia mengungguli para pesaing pada sejumlah tolok ukur berkesulitan tinggi, tampil baik dalam evaluasi terstruktur matematika dan sains, dan memperkenalkan sistem multi-agen (Grok 4 Heavy) yang menjanjikan untuk lingkungan riset dan pemikiran jangka panjang.
Meski demikian, ini bukan asisten serbaguna sehari-hari Anda. Ia lebih lambat daripada Grok 3, pemahaman gambar dan videonya masih tahap awal, dan kurang polesan untuk kegunaan harian. Anda perlu mem-prompt dengan hati-hati dan memangkas input karena jendela konteks yang relatif terbatas. Dan jika Anda menginginkan performa terbaik—melalui Grok 4 Heavy—Anda akan membayar mahal untuk itu.
Bagi pengembang dan peneliti, ini layak dieksplorasi. Bagi pengguna kasual, kecepatan dan responsivitas Grok 3 atau model arus utama lainnya lebih cocok. Peta jalannya ambisius, dengan model pengodean, agen multimodal, dan generator video semuanya dijadwalkan sebelum Oktober. Apakah xAI bisa memenuhinya tepat waktu adalah pertanyaan lain. Namun dengan Grok 4, setidaknya mereka telah membuat argumen meyakinkan bahwa mereka ikut dalam persaingan.
FAQs
Apa perbedaan antara Grok 4 dan Grok 4 Heavy?
Grok 4 adalah model agen tunggal—satu instance model memproses input Anda dan mengembalikan jawaban. Grok 4 Heavy menjalankan beberapa agen Grok 4 secara paralel. Setiap agen bekerja secara independen pada tugas yang sama, kemudian mereka membandingkan keluaran dan menyepakati jawaban akhir. Pengaturan multi-agen ini meningkatkan akurasi, terutama pada masalah penalaran kompleks, tetapi juga lebih lambat dan lebih boros sumber daya.
Tugas apa yang cocok untuk Grok 4 Heavy?
Grok 4 Heavy paling cocok digunakan untuk penalaran bentuk panjang, masalah matematika dan sains yang sulit, riset teknis, atau apa pun yang Anda akan mendapat manfaat dari banyak perspektif sebelum tiba pada jawaban akhir. Ini berlebihan untuk obrolan santai atau pencarian sederhana, tetapi unggul dalam tolok ukur, simulasi, dan tugas perencanaan lanjutan.
Bagaimana Grok 4 berbeda dari Grok 3?
Grok 4 adalah model bahasa besar terbaru dari xAI, menawarkan kemampuan penalaran yang ditingkatkan dan performa lebih baik pada tugas kompleks dibanding Grok 3. Ini memperkenalkan sistem multi-agen dalam varian “Heavy”-nya, yang memungkinkan proses penalaran paralel, menghasilkan peningkatan akurasi pada tolok ukur tertentu. Gunakan Grok 3 untuk tugas ringan sehari-hari dan Grok 4 untuk tugas kompleks yang membutuhkan penalaran.
Apakah Grok 4 mendukung input multimodal seperti gambar dan video?
Grok 4 mendukung input multimodal, tetapi kemampuan dan keluarannya terutama berbasis teks. Ada rencana untuk meningkatkan fungsionalitas multimodal, termasuk pemahaman gambar dan video, namun fitur-fitur ini masih dalam pengembangan.
Berapa biaya Grok 4 Heavy?
Akses ke Grok 4 Heavy tersedia melalui paket SuperGrok Heavy milik xAI, yang berharga $300/bulan. Itu memberi Anda akses ke versi multi-agen melalui antarmuka grok.com. Paket ini ditujukan untuk peneliti, pengembang, dan pengguna enterprise—sebagian besar pengguna kasual tidak akan membutuhkannya.
Saya adalah editor dan penulis yang mengulas blog, tutorial, dan berita AI, memastikan semuanya selaras dengan strategi konten yang kuat dan praktik terbaik SEO. Saya telah menulis kursus data science tentang Python, statistik, probabilitas, dan visualisasi data. Saya juga telah menerbitkan novel pemenang penghargaan dan menghabiskan waktu luang untuk menulis skenario serta menyutradarai film.




Setelah menunggu berbulan-bulan untuk Grok 3.5, xAI melewatinya sama sekali dan langsung lompat ke Grok 4. (Per November 2025, Grok 4.1 juga telah diluncurkan).
Apakah lompatan ini dibenarkan oleh performa modelnya?
Ya, jika Anda menilai dari tolok ukur. Saat ini, Grok 4 mungkin adalah model terbaik di dunia di atas kertas.
Namun dengan jendela konteks 128.000 di aplikasi dan 256.000 di API, Anda mungkin akan kesulitan menggunakannya dalam pekerjaan produksi nyata. Model ini tidak sefleksibel Gemini 2.5 Pro, yang memberi Anda satu juta token penuh. Jika Anda ingin menggunakan Grok 4 lebih dari sekadar obrolan singkat, Anda akan memerlukan keterampilan rekayasa konteks yang serius agar dapat bekerja efektif.
Di blog ini, saya akan menyaring hype yang biasa dan memberi Anda gambaran seimbang dengan menjelaskan kekuatan dan kelemahan utama Grok 4, beserta bagaimana performanya dalam pengujian saya sendiri.
Kami terus memberi kabar terbaru tentang AI kepada pembaca melalui The Median, buletin Jumat gratis kami yang mengulas berita kunci pekan ini. Berlangganan dan tetap tajam hanya dalam beberapa menit per minggu:
Grok 4
Keluarga Grok 4 hanya mencakup Grok 4 dan Grok 4 Heavy, dan tidak ada versi mini yang bisa kita gunakan untuk penalaran cepat.
Grok 4 adalah model agen tunggal terbaru dari xAI (berbeda dengan Grok 4 Heavy, yang menggunakan banyak agen—kita akan membahasnya di bagian berikut). Berdasarkan livestream, tidak ada hal yang benar-benar terobosan dari sisi rekayasa. Peningkatan tampaknya berasal dari serangkaian penyetelan kecil dan peningkatan komputasi yang signifikan, kira-kira 10x lebih besar daripada yang digunakan untuk Grok 3.
Sumber: xAI
Perusahaan mengklaim ini adalah model paling cerdas yang tersedia saat ini, dan hasil tolok ukur memang mengarah ke sana. Hasil paling menonjol berasal dari Humanity’s Last Exam, tolok ukur yang terdiri dari 2.500 pertanyaan setara tingkat PhD yang dipilih secara kurasi, mencakup matematika, fisika, kimia, linguistik, dan teknik. Grok 4 (dengan alat) berhasil menyelesaikan sekitar 38,6% masalah.
Sumber: xAI
Jendela konteksnya 128.000 token di aplikasi dan 256.000 di API, yang memberi sedikit ruang untuk penalaran bentuk panjang tetapi tidak terlalu murah hati menurut standar saat ini. Misalnya, Gemini 2.5 Pro menawarkan 1 juta. Jika Anda membangun dengan Grok, kemungkinan Anda perlu meluangkan waktu untuk menyusun dan merapikan konteks secara cermat.
Sebagai klarifikasi, Grok 4 bukan model andalan Anda untuk pertanyaan sehari-hari seperti “Apakah akhir pekan ini akan hujan?” atau “Carikan saya konser di dekat sini.” Untuk itu Anda lebih baik menggunakan Grok 3—model itu lebih cepat dan dibuat untuk tugas serbaguna. Grok 4 lebih cocok untuk riset, prompt teknis, dan pertanyaan sulit di bidang matematika, sains, keuangan, atau alur kerja pengembang yang bergantung pada penalaran murni.
Masih belum jelas bagaimana kinerjanya dalam alur kerja konsumen yang lebih luas atau seberapa baik model ini menangani keamanan dalam skala besar. Namun xAI mengatakan model ini sudah digunakan di laboratorium biomedis, perusahaan keuangan, dan mitra enterprise tahap awal.
Grok 4 Heavy
Grok 4 Heavy adalah versi multi-agen dari Grok 4. Alih-alih menjalankan satu model, sistem ini menyalakan beberapa agen secara paralel, masing-masing bekerja mandiri pada tugas yang sama. Setelah menghasilkan keluaran, mereka membandingkan hasil dan menyepakati jawaban.
Secara teori, ini mirip kelompok belajar—para agen dapat berbagi wawasan atau menutupi titik buta satu sama lain. Dalam praktiknya, pengaturan ini membantu tugas penalaran kompleks di mana satu kali lewat mungkin kurang memadai.
Peningkatannya tampak pada tolok ukur. Pada Humanity’s Last Exam, Grok 4 Heavy dengan penggunaan alat mencetak 44,4%, mengungguli Grok 4 agen tunggal dengan selisih yang terlihat. Arsitektur ini juga tampaknya membantu pada ARC-AGI, di mana Grok 4 menjadi model pertama yang menembus 10% dan mencapai 15,9%—meski belum jelas seberapa besar hasil itu disebabkan khusus oleh pengaturan multi-agen.
Sumber: xAI
Konsekuensinya adalah kecepatan dan biaya. Grok 4 Heavy berjalan lebih lambat (jauh lebih lambat!), dan biayanya sepuluh kali lebih mahal untuk dioperasikan—xAI menawarkan akses melalui tier SuperGrok Heavy seharga $300/bulan.
Sekali lagi, Grok 4 Heavy bukan sesuatu yang ingin Anda gunakan untuk pencarian dasar atau iterasi cepat. Jika Grok 4 saja sudah bersifat khusus, Grok 4 Heavy lebih khusus lagi. Model ini dibuat untuk jenis masalah di mana banyak jalur penalaran dapat menghasilkan hasil yang lebih baik—pikirkan riset ilmiah, pemodelan keuangan, atau apa pun yang melibatkan perencanaan jangka panjang. Namun untuk sebagian besar kasus penggunaan, ini berlebihan.
Untuk demo visual Grok 4, jangan lewatkan video penelusuran kami: