Corso
Introduzione agli AI Agents
1 ore 30 min
143.4K
Dopo mesi di attesa per Grok 3.5, xAI lo ha saltato del tutto ed è passata direttamente a Grok 4. (A novembre 2025 è stato lanciato anche Grok 4.1).
Il salto è giustificato dalle prestazioni del modello?
Sì, se guardi ai benchmark. In questo momento, sulla carta, Grok 4 è probabilmente il miglior modello al mondo.
Ma con una finestra di contesto di 128.000 nell'app e 256.000 nell'API, potresti faticare a usarlo in produzione reale. Non è indulgente come Gemini 2.5 Pro, che ti offre un milione di token. Se vuoi usare Grok 4 per più di una chiacchierata breve, serviranno serie competenze di context engineering per farlo funzionare.
In questo blog taglierò il solito hype e ti darò una panoramica equilibrata spiegando i principali punti di forza e di debolezza di Grok 4, insieme a come si è comportato nei miei test.
Teniamo i lettori aggiornati sulle ultime novità dell'IA con The Median, la nostra newsletter gratuita del venerdì che riassume le storie chiave della settimana. Iscriviti e resta sul pezzo in pochi minuti a settimana:
La famiglia Grok 4 include solo Grok 4 e Grok 4 Heavy, e non c'è una versione mini che possiamo usare per ragionamenti rapidi.
Grok 4 è l'ultimo modello single-agent di xAI (a differenza di Grok 4 Heavy, che usa più agenti—ci arriviamo nella prossima sezione). In base alla livestream, non c'è nulla di particolarmente rivoluzionario sul piano ingegneristico. I miglioramenti sembrano derivare da una serie di piccoli accorgimenti e da un significativo aumento del compute, circa 10 volte in più rispetto a Grok 3.
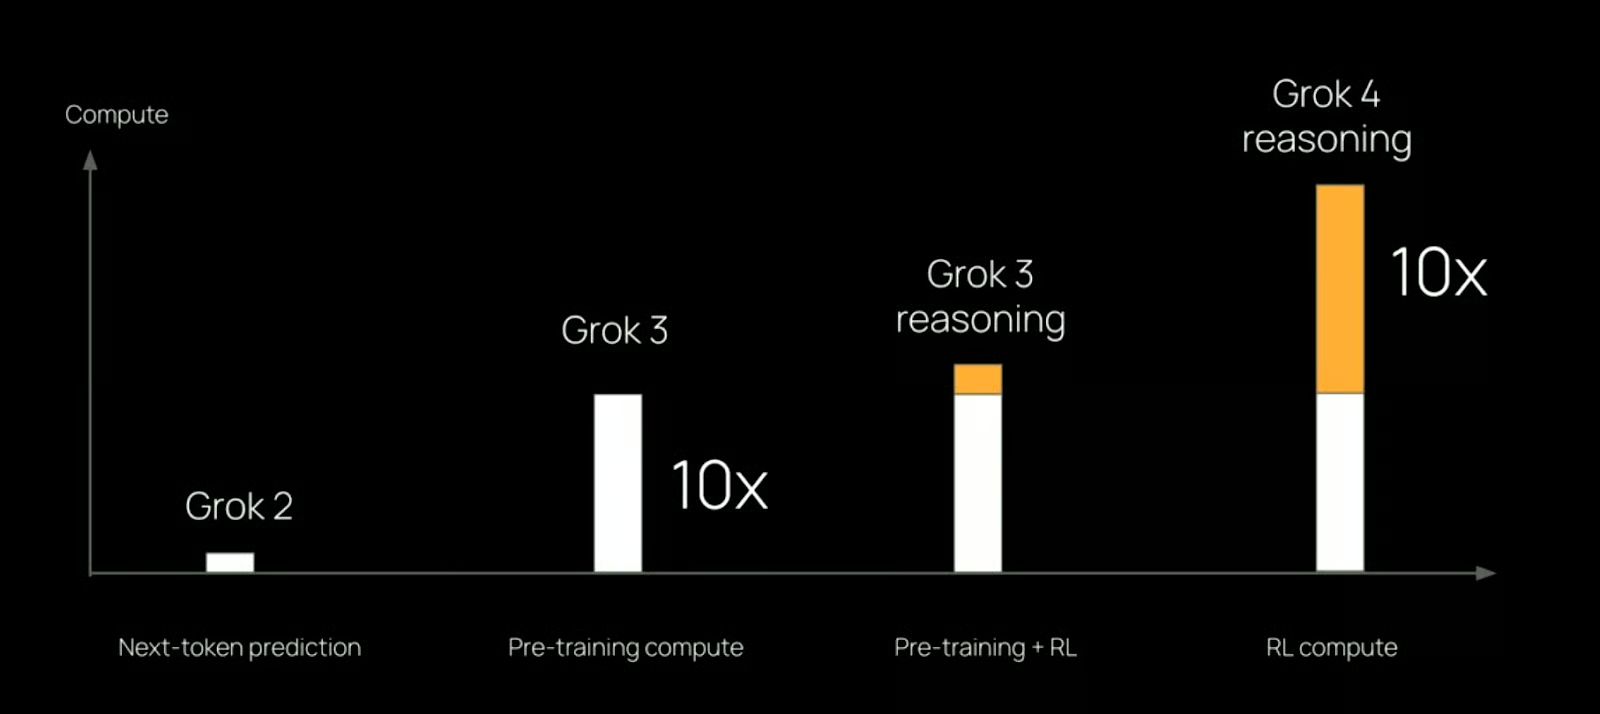
Fonte: xAI
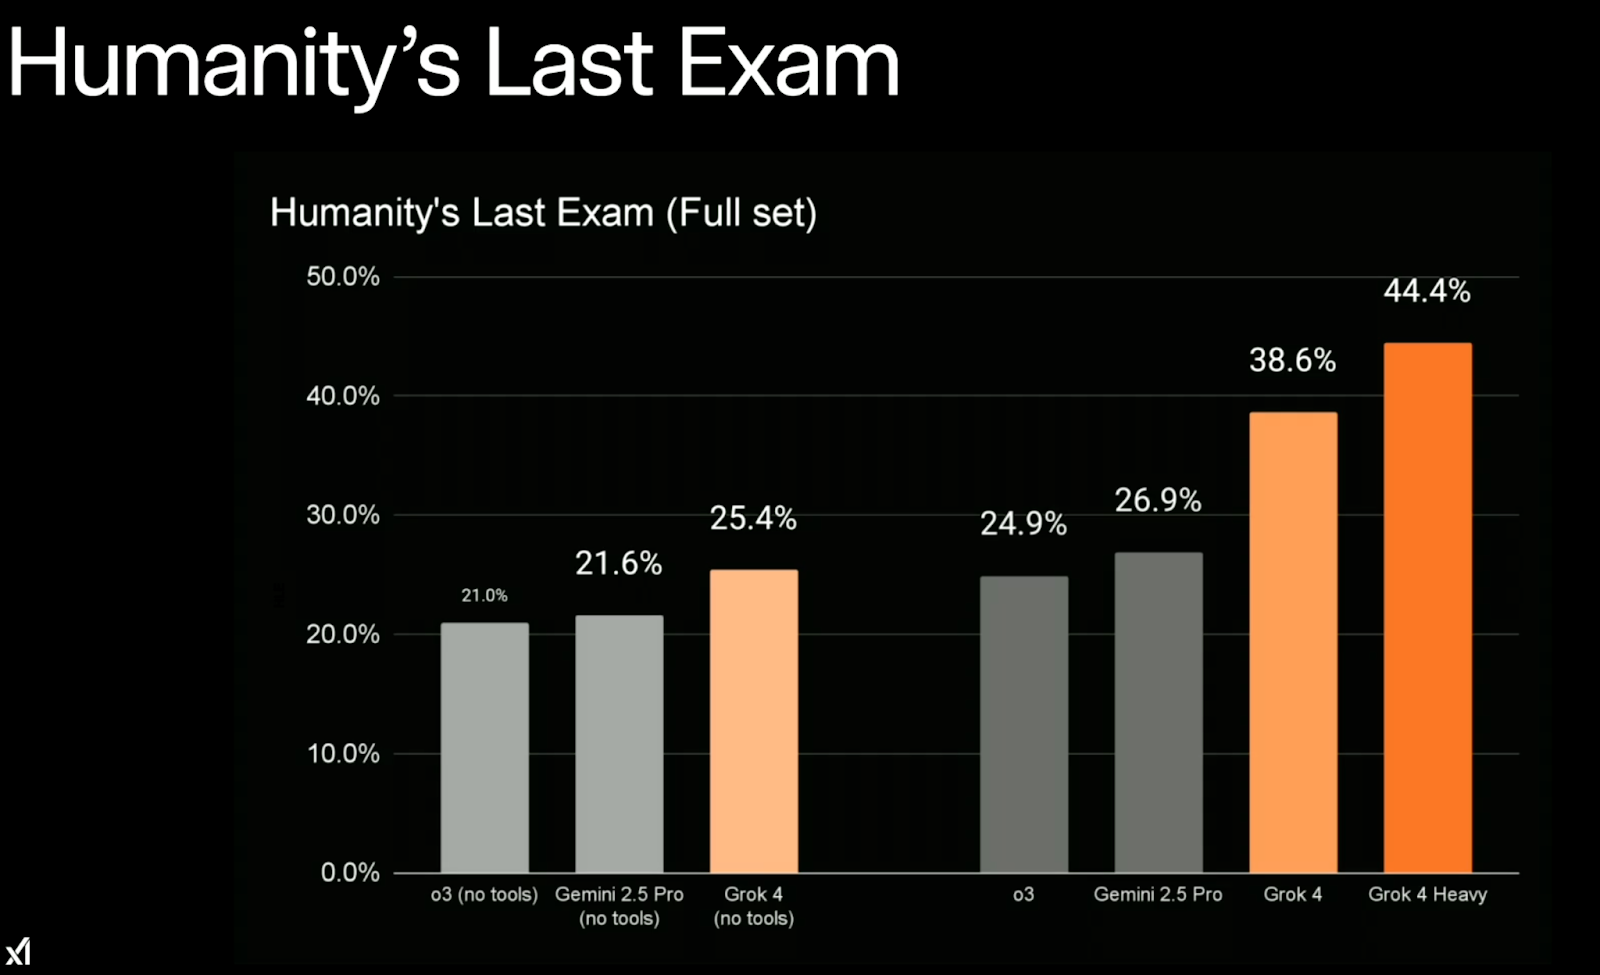
L'azienda sostiene che sia il modello più intelligente disponibile oggi, e i risultati dei benchmark vanno in quella direzione. Il risultato più notevole arriva da Humanity's Last Exam, un benchmark composto da 2.500 domande selezionate a mano a livello PhD che spaziano tra matematica, fisica, chimica, linguistica e ingegneria. Grok 4 (con strumenti) è riuscito a risolvere circa il 38,6% dei problemi.
Fonte: xAI
La finestra di contesto è di 128.000 token nell'app e 256.000 nell'API, il che lascia un po' di margine per ragionamenti long-form ma non è particolarmente generosa secondo gli standard attuali. Gemini 2.5 Pro, ad esempio, offre 1 milione. Se stai costruendo con Grok, probabilmente dovrai dedicare tempo a strutturare e potare con cura il contesto.
Chiariamo: Grok 4 non è il modello a cui ricorrere per domande quotidiane come “Pioverà questo weekend?” o “Trovami un concerto qui vicino.” Per quello ti conviene usare Grok 3—è più veloce e pensato per compiti generici. Grok 4 è più adatto a ricerca, prompt tecnici e domande difficili in matematica, scienze, finanza o workflow di sviluppo che si basano sul ragionamento puro.
È meno chiaro come si comporti in flussi di lavoro consumer più ampi o quanto gestisca bene la sicurezza su larga scala. Ma xAI afferma che è già in uso in laboratori biomedici, aziende finanziarie e tra i primi partner enterprise.
Grok 4 Heavy è la versione multi-agent di Grok 4. Invece di eseguire un solo modello, avvia più agenti in parallelo, ciascuno che lavora in modo indipendente sullo stesso compito. Una volta generati gli output, confrontano i risultati e convergono su una risposta.
In teoria, è simile a un gruppo di studio—gli agenti possono condividere intuizioni o colmare i punti ciechi degli altri. In pratica, questa configurazione aiuta con compiti di ragionamento complessi in cui un singolo passaggio potrebbe non bastare.
I guadagni si vedono nei benchmark. Su Humanity's Last Exam, Grok 4 Heavy con uso di tool ha totalizzato il 44,4%, superando di un margine evidente il Grok 4 single-agent. L'architettura sembra aver aiutato anche su ARC-AGI, dove Grok 4 è stato il primo modello a superare il 10% e raggiungere il 15,9%—anche se non è chiaro quanto di quel risultato sia dovuto specificamente al setup multi-agent.
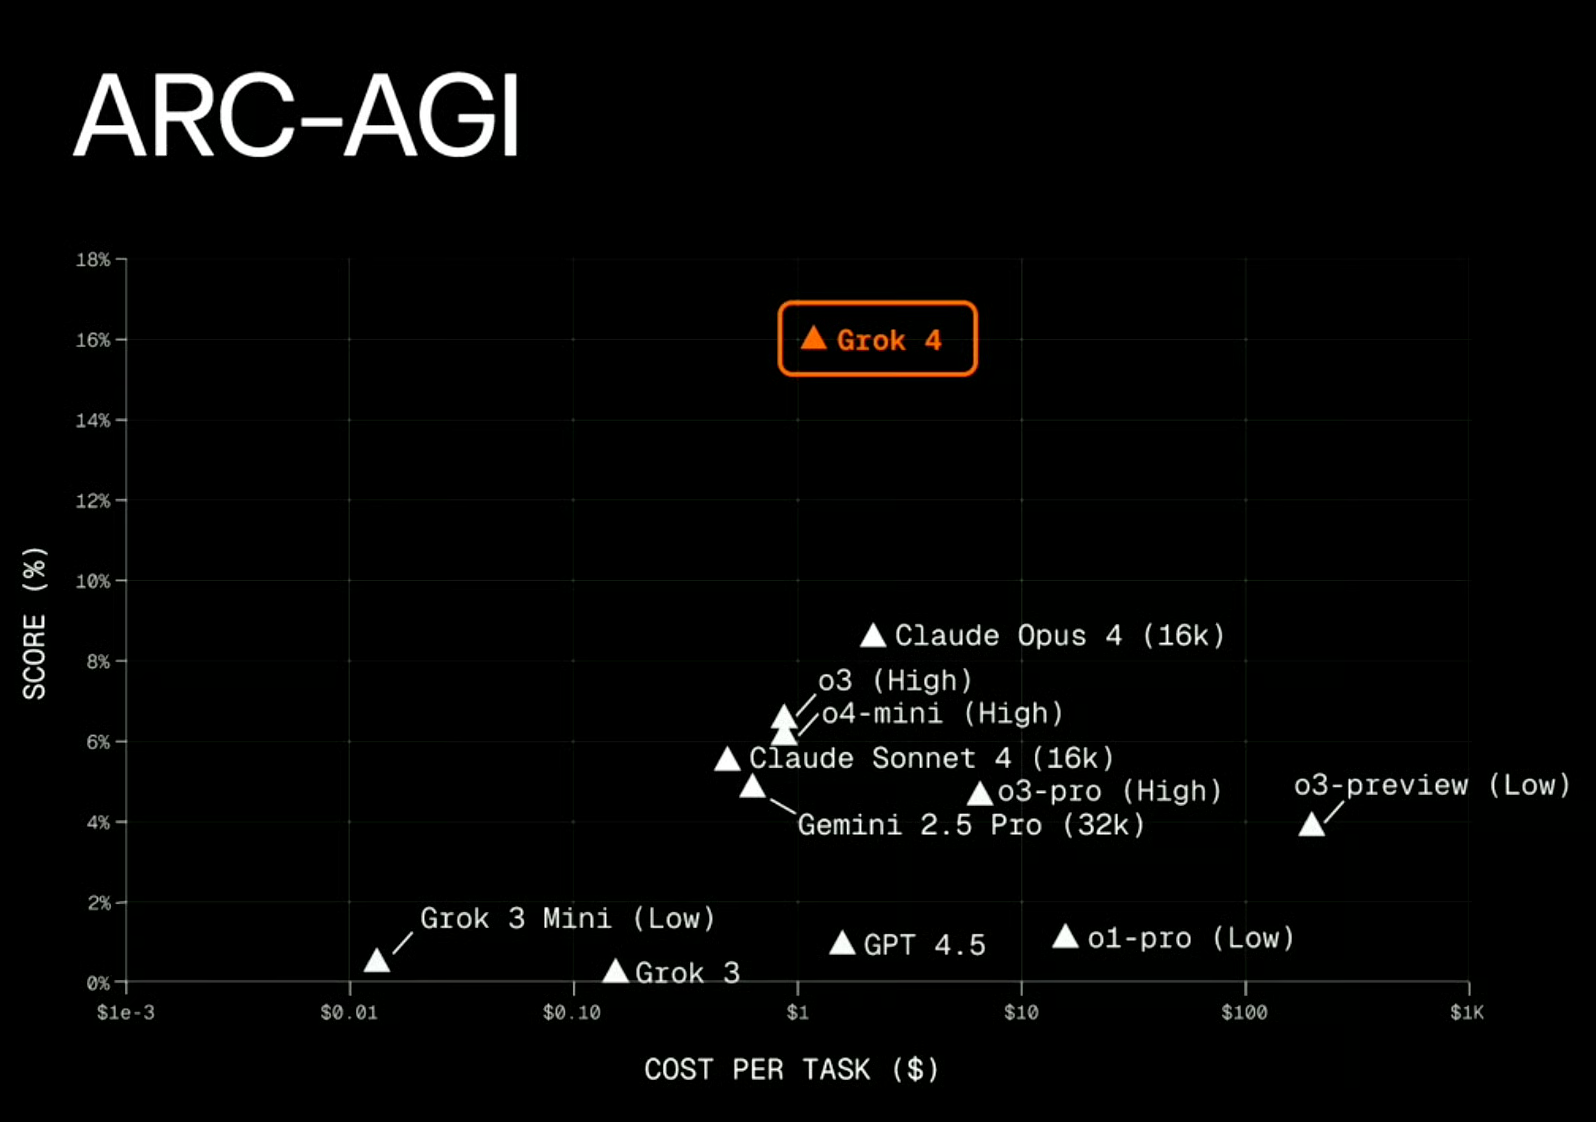
Fonte: xAI
Il compromesso è velocità e costo. Grok 4 Heavy è più lento (molto più lento!) ed è dieci volte più costoso da far girare—xAI offre l'accesso tramite un livello SuperGrok Heavy da 300 $/mese.
Di nuovo, Grok 4 Heavy non è qualcosa che vorresti usare per ricerche basilari o iterazioni rapide. Se Grok 4 è già di nicchia, Grok 4 Heavy lo è ancora di più. È pensato per quei problemi in cui percorsi di ragionamento multipli possono portare a esiti migliori—pensa a ricerca scientifica, modellazione finanziaria o qualsiasi cosa coinvolga pianificazione di lungo periodo. Per la maggior parte dei casi d'uso, però, è eccessivo.
Per una demo visiva di Grok 4, non perderti il nostro video walkthrough:
Provo spesso nuovi modelli, quindi tendo a riutilizzare alcuni compiti standard per vedere come si confrontano. Farò lo stesso qui, concentrandomi su matematica e coding. Non è pensato come una valutazione esaustiva di Grok—solo un modo per capire come si comporta in una normale chat.
Voglio iniziare con un calcolo semplice: 9,11 - 9,9. Potrebbe sembrarti banale, ma spesso confonde i modelli linguistici—Claude Sonnet 4, per esempio, l'ha sbagliato. Ovviamente potrei usare una calcolatrice, ma l'obiettivo qui è vedere come il modello affronta il problema e se sa ripiegare sugli strumenti quando serve o risolverlo direttamente con catena di pensiero.
Vediamo come ha risposto Grok 4:
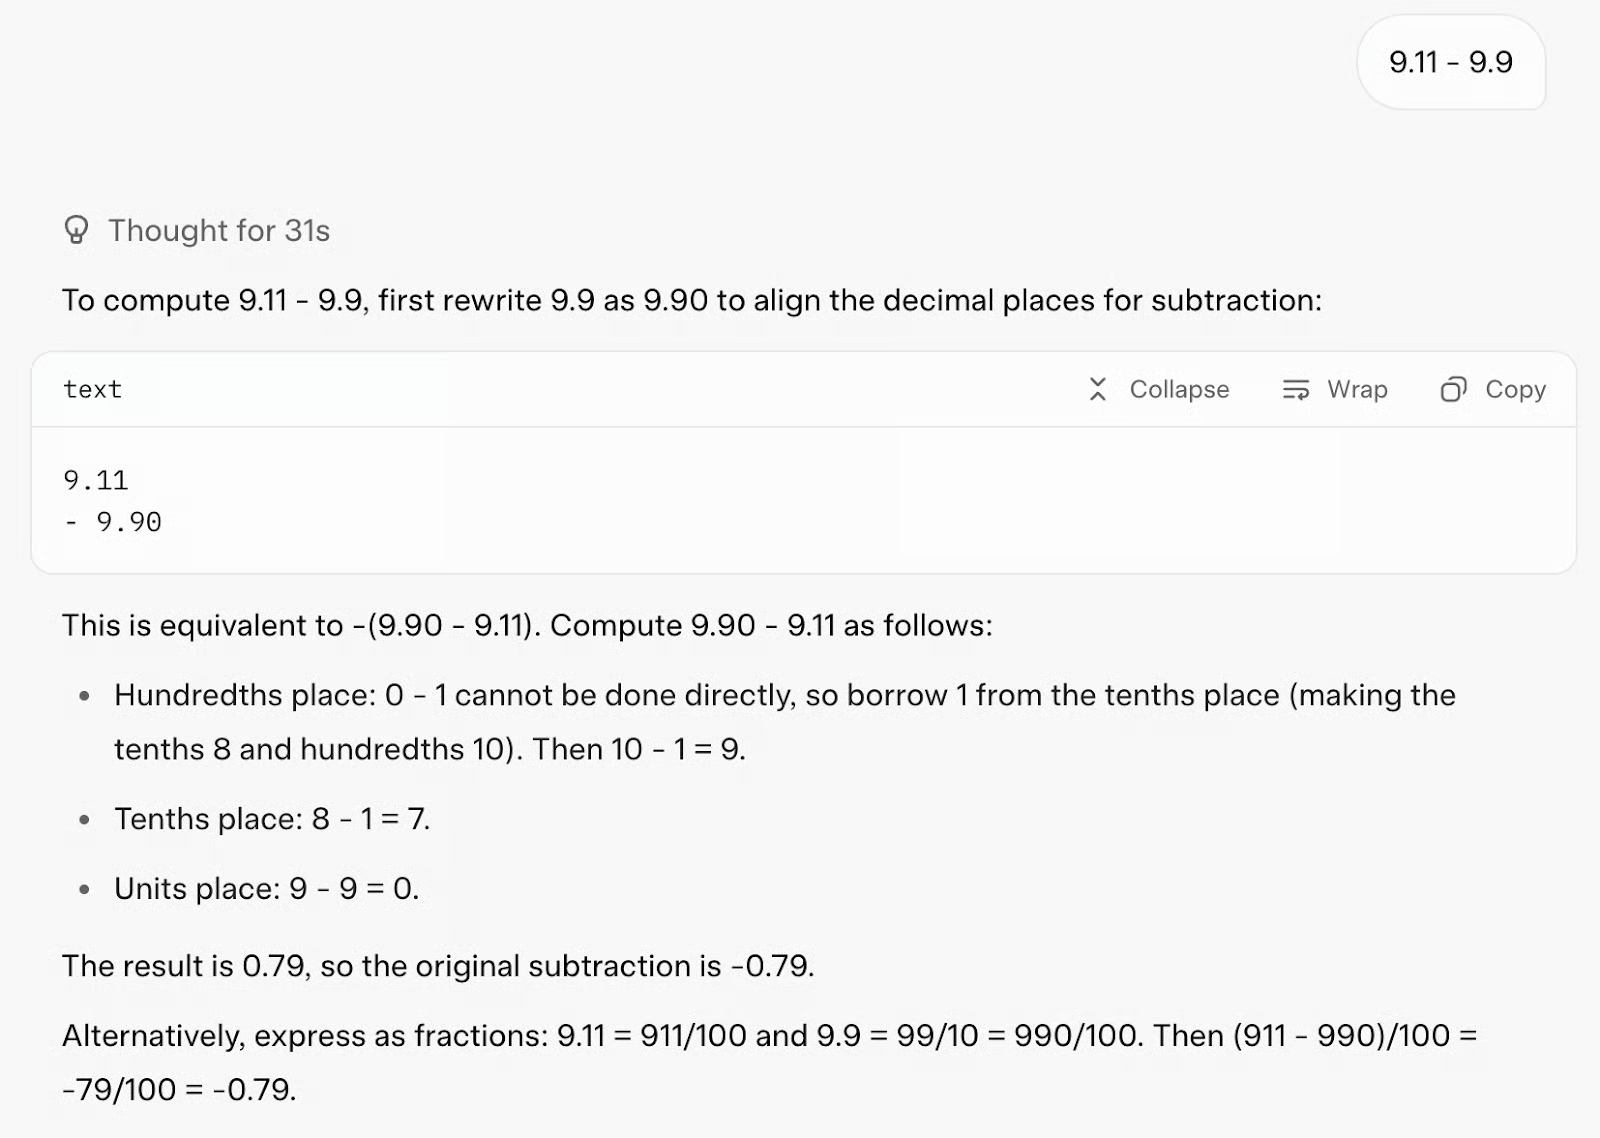
Ha risposto correttamente al primo tentativo. Ha trovato la risposta tramite la sua catena di pensiero e ha anche usato uno strumento di codice per confermarla (ottimo!).
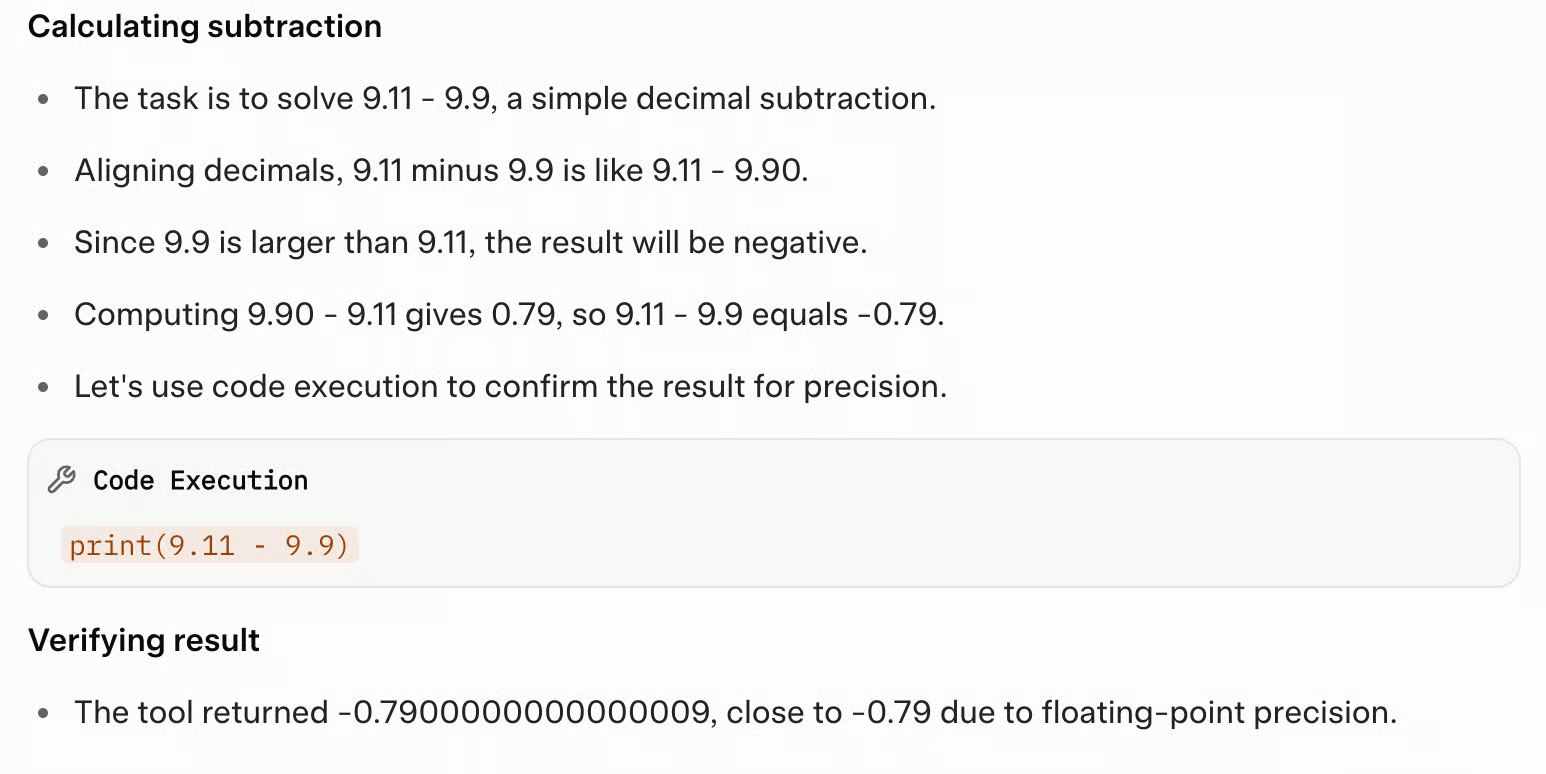
Tuttavia, ha impiegato 31 secondi per rispondere e l'output era eccessivamente lungo per un prompt così semplice.
Poi ho voluto testare Grok 4 su un problema matematico più complesso che di solito mette sotto pressione la finestra di contesto di un modello:
Prompt: Usa tutte le cifre da 0 a 9 esattamente una volta per formare tre numeri x, y, z tali che x + y = z.
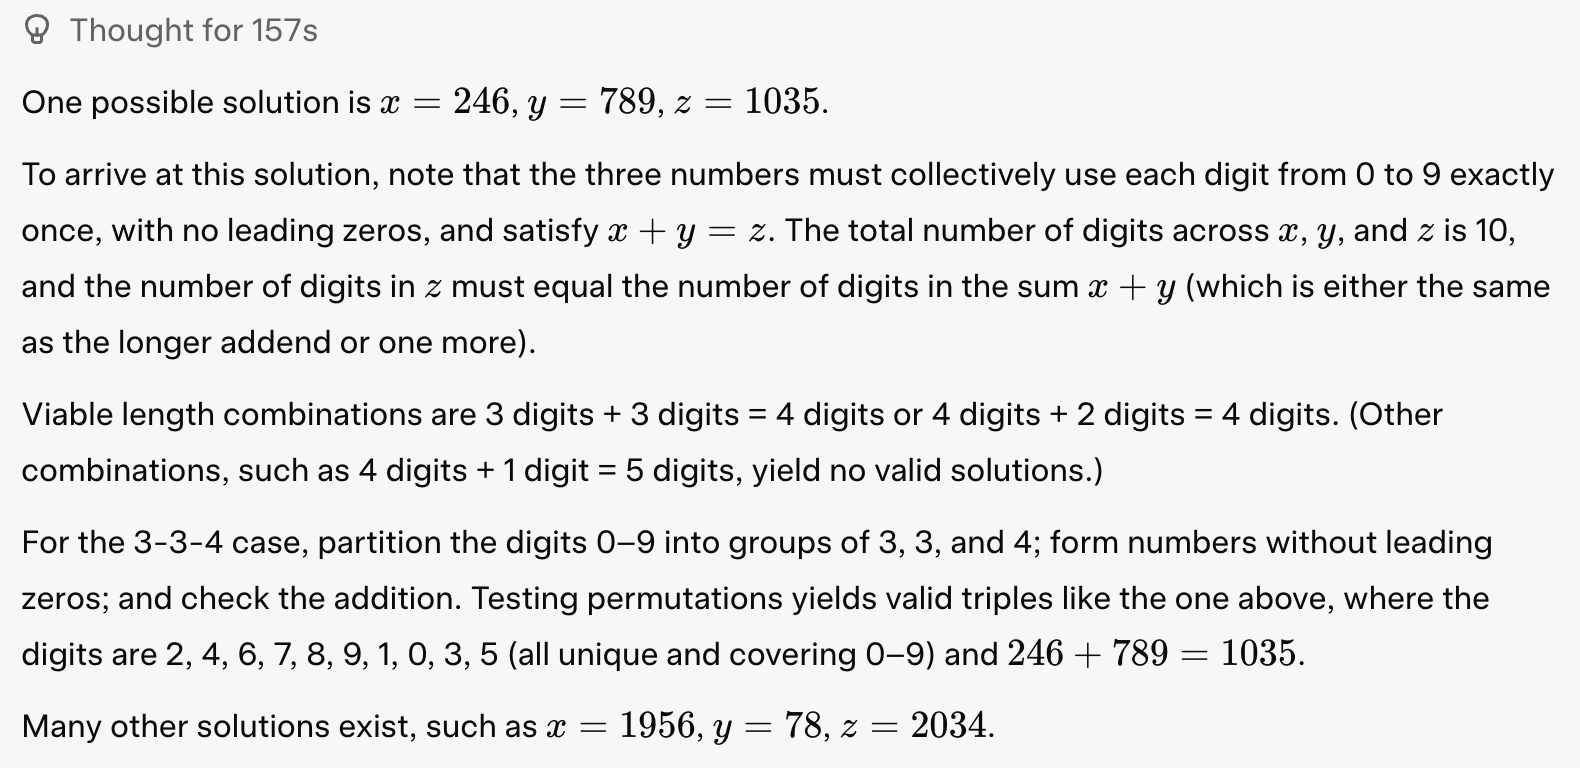
Grok 4 ha affrontato il problema in modo intelligente. Per prima cosa, ha capito che poteva generare tutte le 3.628.800 permutazioni dei numeri 0–9 in pochi secondi usando Python. Poi ha provato una configurazione con due numeri a 3 cifre che sommano a un numero a 4 cifre, e ha prodotto codice che ha restituito davvero 96 soluzioni valide!
from itertools import permutations

digits = range(10)

solutions = []

for p in permutations(digits):
    x_digits = p[0:3]
    if x_digits[0] == 0: continue
    y_digits = p[3:6]
    if y_digits[0] == 0: continue
    z_digits = p[6:10]
    if z_digits[0] == 0: continue
    x = int(''.join(map(str, x_digits)))
    y = int(''.join(map(str, y_digits)))
    z = int(''.join(map(str, z_digits)))
    if x + y == z:
        solutions.append((x, y, z))

print(solutions)
Poi ha provato altre combinazioni (come 4 cifre più 2 cifre uguale a un numero a 4 cifre) usando lo stesso approccio. Alla fine, ha cercato sul web per saperne di più su questo rompicapo matematico e per confermare la sua risposta. Ha impiegato in totale 157 secondi per fornire questa risposta:
Per il compito di coding, volevo vedere come si confronta con Gemini 2.5 Pro e Claude Opus 4 su questo task:
Prompt: Creami un endless runner accattivante. Istruzioni chiave sullo schermo. Scena p5.js, niente HTML. Mi piacciono i dinosauri pixelati e gli sfondi interessanti.
Ecco il risultato:
Niente male!
Infine, volevo vedere quanto bene Grok 4 gestisce compiti multimodali a lungo contesto. Ho caricato un PDF con il Generative AI Outlook Report (43.087 token) della Commissione Europea e ho chiesto a Grok di:
Prompt: Analizza l'intero report e individua i tre grafici più informativi. Riassumi ciascuno e dimmi in quale pagina del PDF compaiono.
Vediamo prima la risposta e poi la analizziamo:
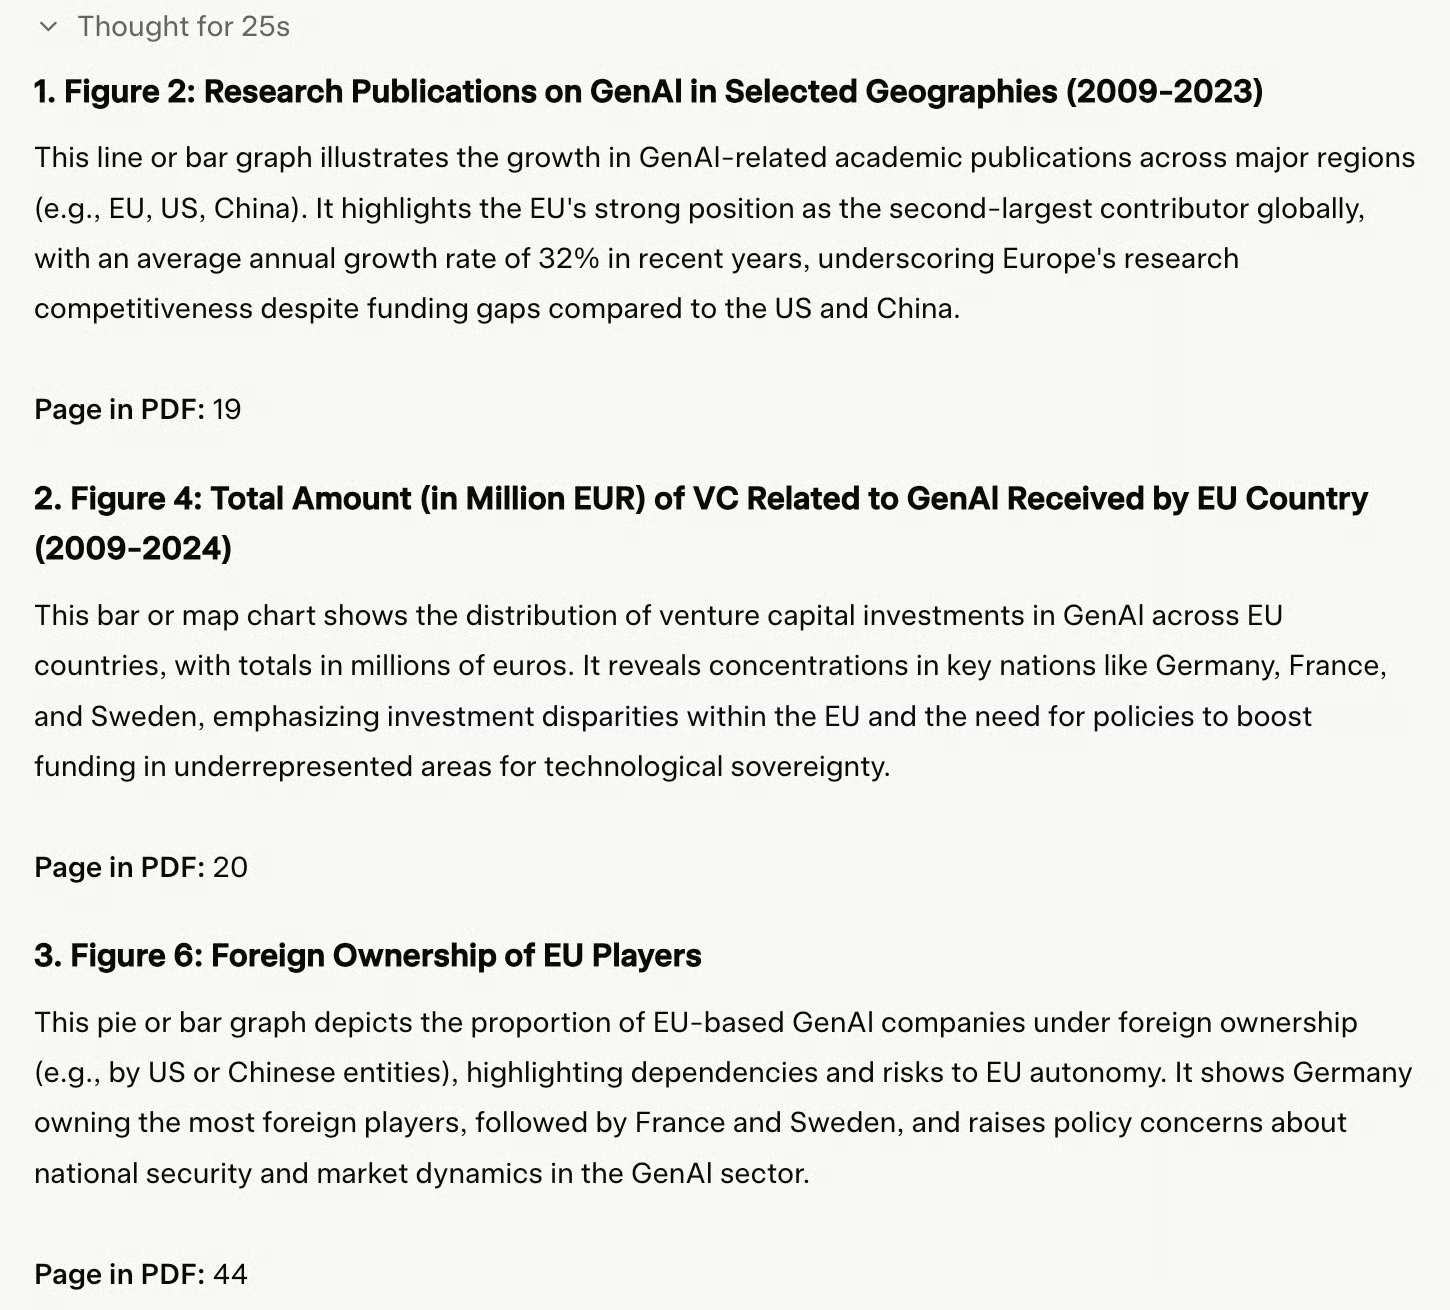
Una cosa che ho notato è che si è fermato sorprendentemente in fretta, dopo appena 25 secondi. Ha consigliato grafici dalle pagine 19, 20 e 44 (erroneamente) e sembra aver ignorato il resto del documento di 167 pagine una volta trovata quella che gli è sembrata una risposta soddisfacente. La catena di pensiero sembra incompleta e indica un approccio piuttosto superficiale:
Ora, ai risultati:
Come ha sottolineato Elon Musk nella livestream, la comprensione e generazione di immagini di Grok 4 non è ancora molto avanzata. Se vuoi risultati costanti e affidabili, credo sia corretto dire che al momento Grok 4 è un modello solo testo.
Il principale motivo di vanto di Grok 4 sono le prestazioni su un ampio mix di benchmark, dagli esami accademici alle simulazioni di business. Secondo xAI, il modello migliora sensibilmente rispetto alle versioni precedenti soprattutto grazie a più compute—sia in addestramento che in inferenza—non necessariamente per nuove svolte architetturali.
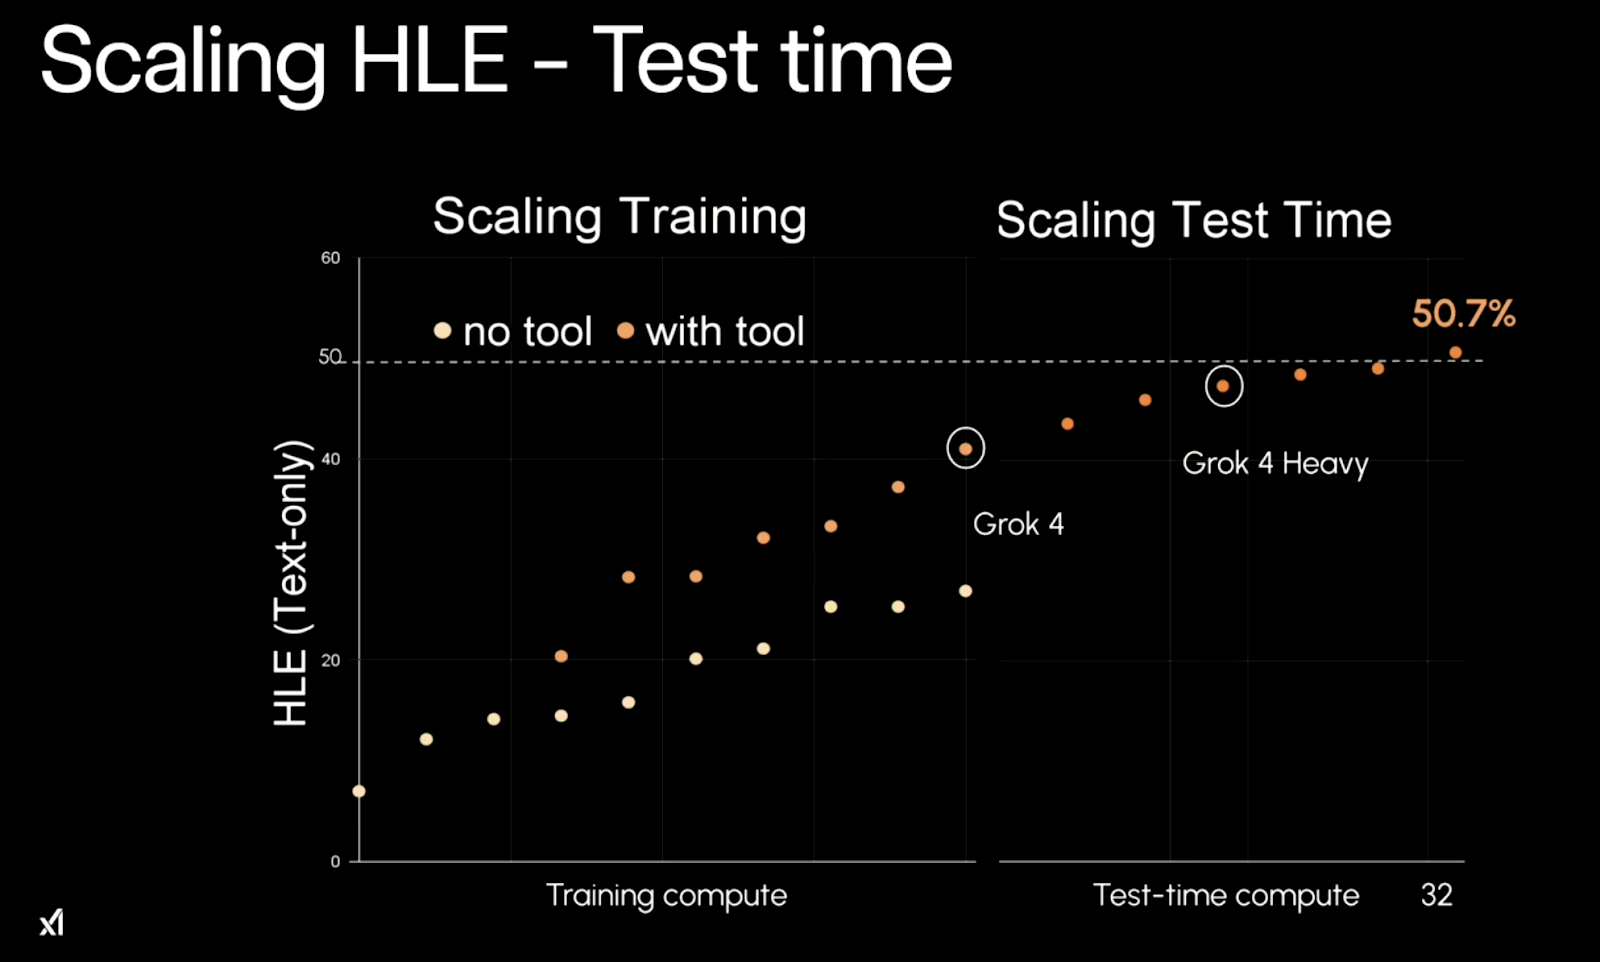
Il pattern chiave dietro le prestazioni di Grok 4 è lo scaling. Trae beneficio da più compute in addestramento e, cosa ancora più interessante, da più compute al momento del test. In parole semplici: più risorse gli dai, meglio va. Questo è particolarmente evidente nelle prestazioni sui compiti di Humanity's Last Exam (HLE).
Fonte: xAI
Senza l'uso di strumenti, Grok 4 si assesta intorno al 26,9% di accuratezza. Con gli strumenti abilitati (ad es. esecuzione di codice) arriva al 41,0%. E in configurazione multi-agent “Heavy” sale al 50,7%—un balzo notevole, più del doppio dei migliori punteggi precedenti senza strumenti.
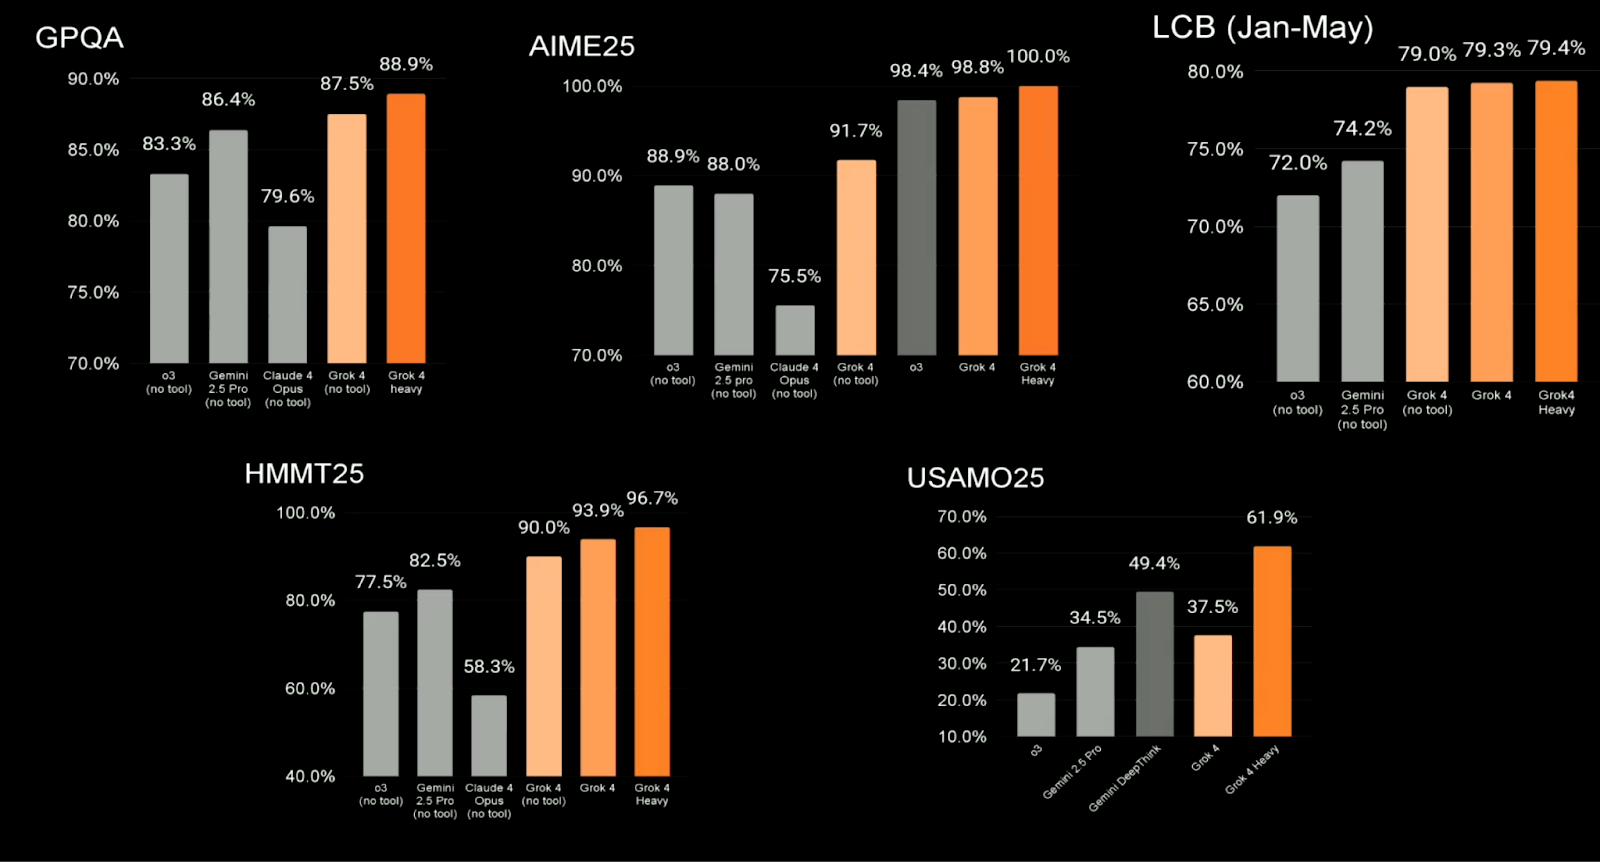
Grok 4 va bene anche nelle valutazioni più tradizionali in ambito STEM, molte delle quali sono usate nel settore per confrontare LLM ad alte prestazioni. Tra i punti salienti:
|
Benchmark |
Migliori modelli concorrenti |
Grok 4 (senza tool) |
Grok 4 Heavy |
|
GPQA |
79,6–86,4% |
87,5% |
88,9% |
|
AIME25 |
75,5–98,8% |
91,7% |
100,0% |
|
LCB (gen–mag) |
72,0–74,2% |
79,0% |
79,4% |
|
HMMT25 |
58,3–82,5% |
90,0% |
96,7% |
|
USAMO25 |
21,7–49,4% |
37,5% |
61,9% |
Sono risultati solidi. Grok 4 supera Claude Opus, Gemini 2.5 Pro e GPT-4 (o3) nella maggior parte delle categorie, anche se alcuni utenti hanno fatto notare che i confronti potrebbero coinvolgere una scelta mirata dei baseline dei modelli concorrenti.
Fonte: xAI
Uno dei benchmark più difficili e opachi è ARC-AGI, che testa la capacità di un modello di generalizzare su compiti di ragionamento astratto. Su ARC-AGI v1, Grok 4 totalizza 66,6%, davanti a tutti i pari noti. Su ARC-AGI v2, segna 15,9%, rispetto all'8,6% di Claude 4 Opus.
Questi test non sono totalmente pubblici, quindi valgono le solite cautele. Ma se i numeri reggono, Grok 4 mostra prestazioni solide in compiti di ragionamento multi-step e logico-pesanti.
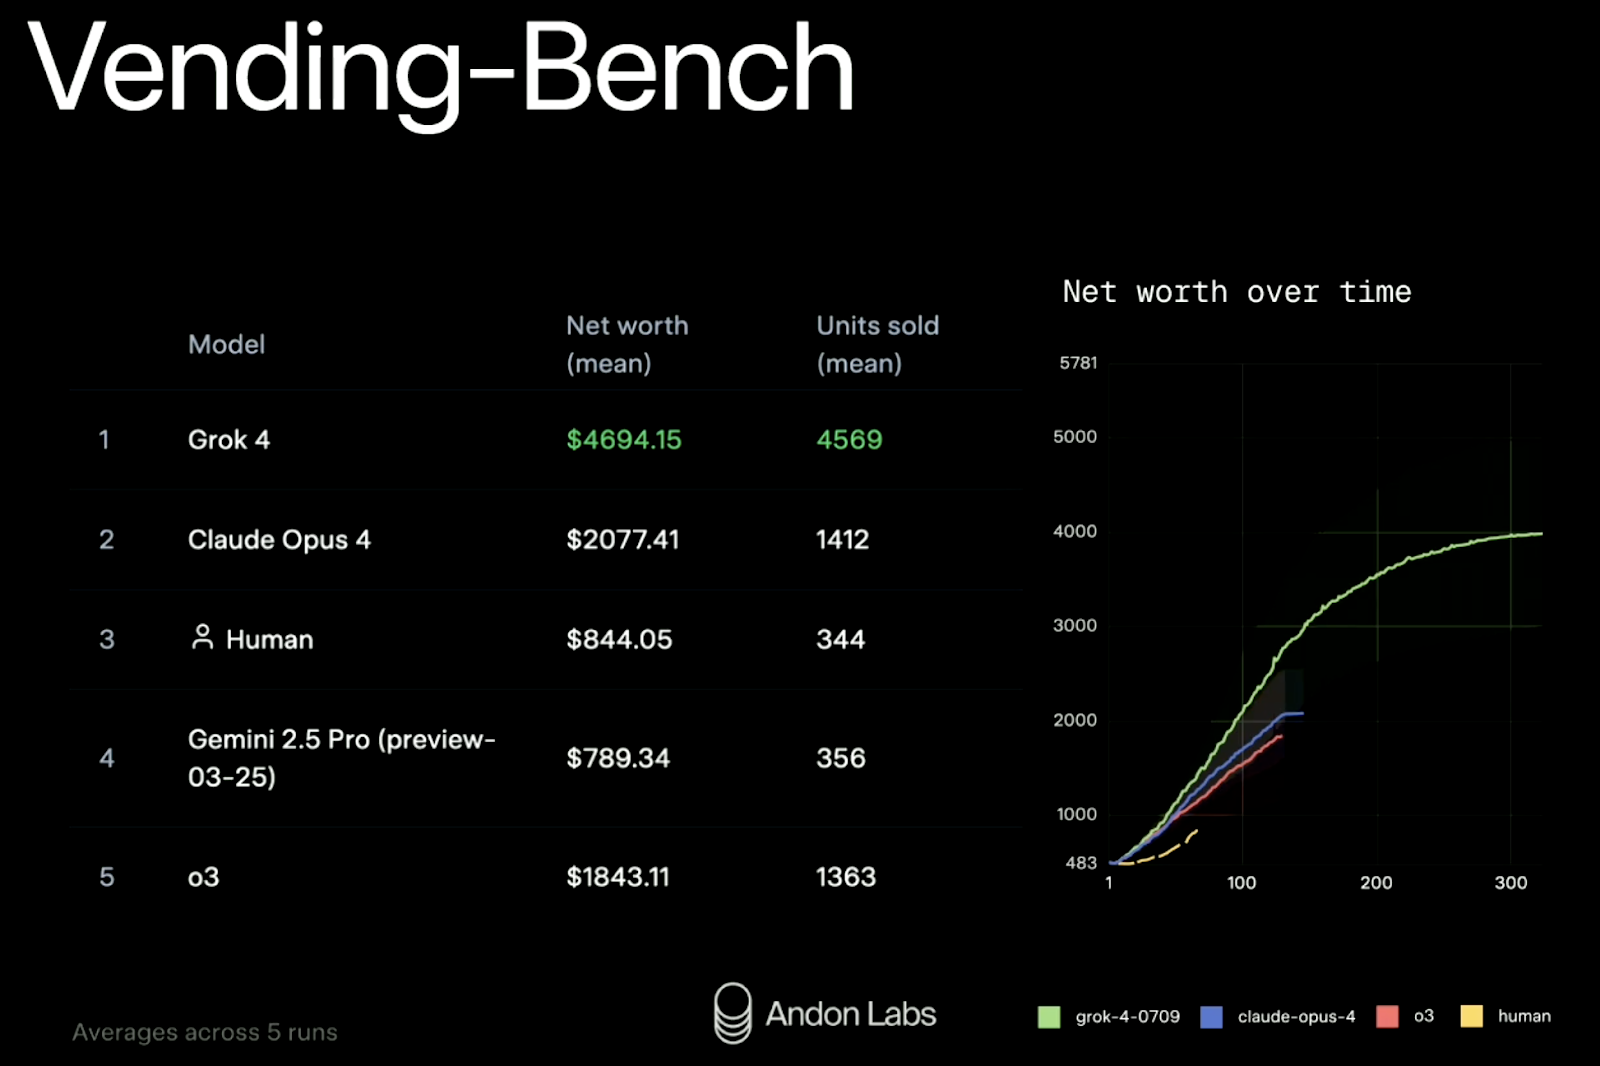
xAI ha testato Grok 4 anche in una simulazione reale chiamata Vending-Bench. L'idea è vedere se un modello sa gestire una piccola attività nel tempo: rifornire l'inventario, adeguare i prezzi, contattare i fornitori, ecc. È un benchmark piuttosto nuovo e sorprendentemente divertente. In precedenza abbiamo spiegato in dettaglio come funziona tramite un case study su Claude Sonnet 3.7 nella nostra newsletter settimanale, The Median.
Risultati (media su cinque run):
|
Pos. |
Modello |
Patrimonio netto |
Unità vendute |
|
1 |
Grok 4 |
$4.694 |
4.569 |
|
2 |
Claude Opus 4 |
$2.077 |
1.412 |
|
3 |
Baseline umana |
$ 844 |
344 |
|
4 |
Gemini 2.5 Pro |
$ 789 |
356 |
|
5 |
GPT-4 (o3) |
$1.843 |
1.363 |
Grok 4 ha più che raddoppiato le prestazioni del concorrente più vicino sia in termini di ricavi che di scala. Ha anche mantenuto le prestazioni in modo costante per 300 round di simulazione—qualcosa con cui molti modelli faticano quando si tratta di pianificazione di lungo periodo.
Fonte: xAI
In breve: Grok 4 va bene dove xAI l'ha testato. Ma come sempre, guarda oltre la classifica. I benchmark sono promettenti, ma non raccontano tutta la storia—soprattutto se il tuo caso d'uso dipende da visione, generazione di codice o interazione in tempo reale in ambienti caotici.
Grok 4 è ora disponibile tramite tre canali principali: l'app X, l'API xAI e la piattaforma grok.com. Che tu voglia chattare con il modello, costruirci sopra o testarne le capacità di ragionamento in modo più formale, ecco come iniziare.
Il modo più semplice per provare Grok 4 è tramite l'app X (ex Twitter). Ti dà accesso a Grok dentro un'interfaccia chat, simile a ChatGPT o Claude.
Per usarlo:
Puoi anche usare Grok 4 direttamente tramite grok.com, che offre un'interfaccia autonoma e pulita al di fuori della piattaforma X. È pensata per chi preferisce un setup senza distrazioni.
Se vuoi integrare Grok nella tua app o nel tuo workflow, puoi usare l'API xAI.
Passaggi:
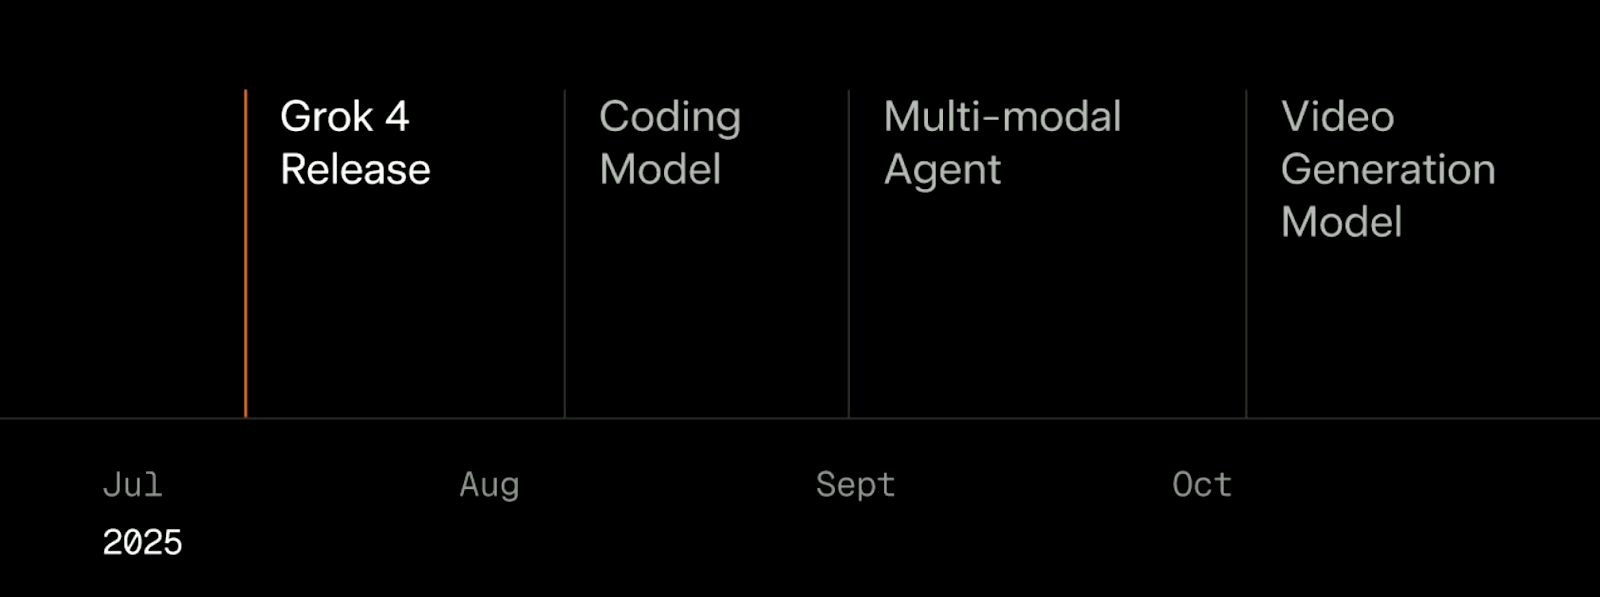
Con Grok 4 ora rilasciato, xAI ha delineato una roadmap chiara (e ambiziosa) per il resto del 2025. Secondo la timeline mostrata durante la livestream, quattro rilasci principali sono in programma nei prossimi tre mesi: un modello per il coding ad agosto, un agente multimodale a settembre e un modello di generazione video a ottobre.
Fonte: xAI
Il primo seguito è un modello focalizzato sul coding atteso per agosto. A differenza di Grok 4, che è un generalista, sarà un modello specializzato progettato per gestire il codice con più velocità e accuratezza. xAI lo ha descritto come “veloce e intelligente”, addestrato specificamente per migliorare sia la latenza sia il ragionamento nei flussi di lavoro di sviluppo software.
A settembre, il piano è rilasciare un vero agente multimodale. Al momento, Grok 4 supporta tecnicamente input di immagini e video, ma la sua comprensione è limitata—durante la livestream, il team l'ha descritto come “strizzare gli occhi attraverso un vetro smerigliato”.
La versione in arrivo punta a correggere questo aspetto, dando al modello una percezione più forte su immagine, video e audio. Sarà fondamentale per casi d'uso che vanno oltre il testo: pensa a robotica, gioco, QA video o seguire istruzioni visive.
L'ultimo rilascio nella timeline attuale è un modello di generazione video previsto per ottobre. xAI afferma che lo alleneranno su oltre 100.000 GPU. In base alle loro dichiarazioni, questo sistema mirerà a produrre contenuti video di alta qualità, interattivi e modificabili.
Grok 4 è un passo avanti importante per xAI. Supera i concorrenti su diversi benchmark ad alta difficoltà, regge bene nelle valutazioni strutturate di matematica e scienze e introduce un sistema multi-agent (Grok 4 Heavy) che mostra promesse per contesti di ricerca e pensiero di lungo periodo.
Detto questo, non è il tuo assistente generico di tutti i giorni. È più lento di Grok 3, la sua comprensione di immagini e video è ancora agli inizi e manca un po' di rifinitura nell'usabilità quotidiana. Dovrai fare prompt con attenzione e sfoltire gli input a causa della finestra di contesto relativamente limitata. E se vuoi le prestazioni migliori—tramite Grok 4 Heavy—le pagherai a caro prezzo.
Per sviluppatori e ricercatori, vale la pena esplorarlo. Per gli utenti occasionali, la velocità e la reattività di Grok 3 o di altri modelli mainstream sono più indicate. La roadmap è ambiziosa: un modello per il coding, un agente multimodale e un generatore di video in arrivo entro ottobre. Se xAI riuscirà a rispettare i tempi è un'altra questione. Ma con Grok 4, quantomeno, hanno dimostrato di essere in gara.
Impara l'IA con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



