
Kursus
Konsep Large Language Models (LLM)
2 jam
113.4K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GooglexAI meluncurkan model terbarunya, Grok 4.1, setelah diam-diam menghadirkan iterasi terbaru ini kepada sejumlah pengguna terpilih selama dua minggu. Model baru beserta varian ‘thinking’-nya memuncaki LMArena Text Leaderboard, dengan klaim peningkatan dalam kecerdasan emosional dan penulisan kreatif, serta pengurangan halusinasi.
Apakah peningkatan ini merupakan lompatan besar atau sekadar kenaikan kecil? Saya mengulas semua hal baru pada Grok 4.1 dan mengujinya dengan beberapa contoh untuk melihat performanya. Saya akan membahas fitur dan peningkatan baru, meninjau data tolok ukur, dan mencoba langsung modelnya.
Grok 4.1 adalah model bahasa besar terbaru dari xAI milik Elon Musk. Hadir hanya empat bulan setelah peluncuran Grok 4, model baru ini memuncaki papan Text Arena dari LMArena (setidaknya hingga kita melihat Gemini 3) dan menunjukkan peningkatan dalam kecerdasan emosional serta penulisan kreatif.
Model baru ini sebenarnya sudah beredar, meski diam-diam, selama beberapa minggu sebelum pengumuman resmi. xAI melakukan rollout bertahap tanpa pengumuman untuk build awal Grok 4.1 di chatbot, X (Twitter), dan aplikasi seluler. Menurut xAI, model baru ini lebih disukai oleh 64,78% pengguna yang menjumpainya.
Saya merasa xAI benar-benar menekankan pengalaman pengguna dalam peluncuran ini, mirip dengan yang kita lihat pada peluncuran GPT-5.1 (yang pada saat itu tidak memiliki tolok ukur yang bisa dibanggakan). Meski menggunakan frasa seperti ‘paham terhadap niat yang bernuansa’ dan ‘interaksi kolaboratif’, inti pengumuman ini adalah bahwa Grok 4.1 seharusnya lebih andal dan lebih bersahabat.
Berikut adalah sorotan dari peluncuran xAI:
Intinya, grok-4.1 dan grok-4.1-thinking memuncaki LMArena Text Leaderboard. Papan peringkat yang digerakkan komunitas ini mengurutkan LLM seperti Grok 4.1 berdasarkan performanya pada tugas-tugas umum berbasis teks.
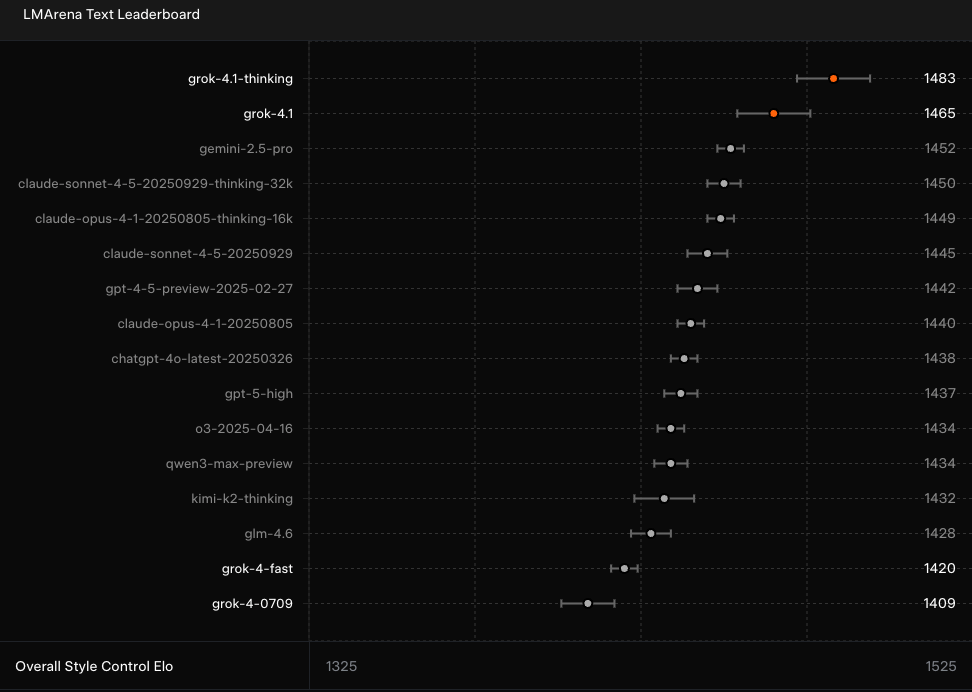
Grok 4.1 adalah peningkatan signifikan dibanding Grok 4 dalam hal ini dan memiliki selisih 31 poin atas pesaing terdekatnya, Gemini 2.5 Pro. Secara teori, ini berarti model baru seharusnya menunjukkan peningkatan yang terlihat dalam ‘versatilitas, ketepatan linguistik, dan konteks budaya pada teks.’
Seperti saya sebutkan, tema besar yang kita lihat pada rilis model belakangan ini adalah bahwa aspek kegunaan itu penting. Pengguna tampaknya menginginkan alat yang dapat diandalkan untuk diajak berinteraksi dan terasa dapat ‘terhubung’. Itulah mengapa xAI menekankan ‘kepribadian’ dan ‘kemampuan interpersonal’ Grok 4.1, yang juga menempati puncak EQ-Bench3, sebuah evaluasi kecerdasan emosional.
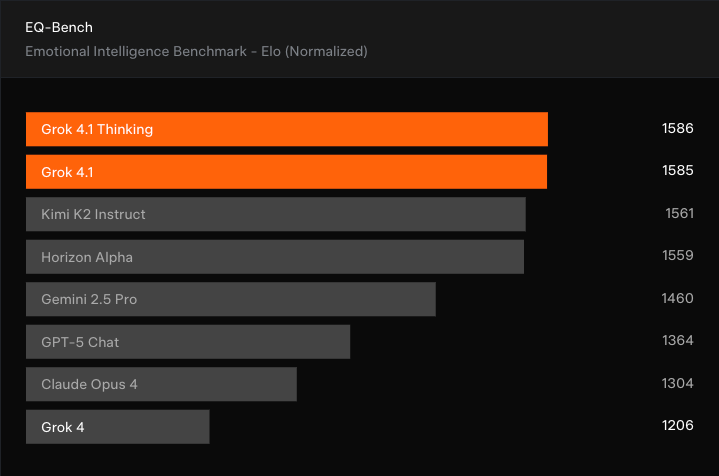
Sekali lagi, Grok 4.1 dan varian Thinking berada di posisi teratas, menunjukkan peningkatan besar dibanding Grok 4 dan merebut posisi dari Kimi K2 Instruct. Namun, perlu dicatat bahwa tolok ukur EQ-Bench3 dinilai oleh LLM lain, sehingga sentimen pengguna sebenarnya bisa berbeda.
Peningkatan besar lain yang disorot xAI adalah kemampuan Grok 4.1 untuk menulis secara kreatif. Tolok ukur yang juga dinilai LLM lain, Creating Writing v3, menempatkan Grok 4.1 di posisi atas.
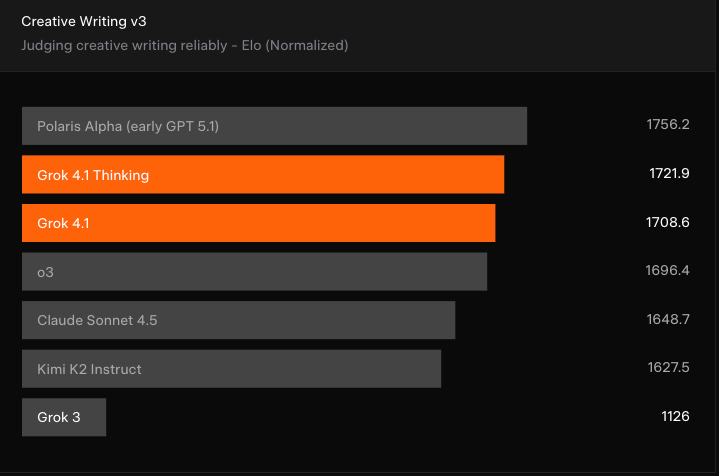
GPT-5.1 (dengan nama awal Polaris Alpha) masih berada di puncak tangga, dan Grok 4.1 bukanlah peningkatan besar dibanding model seperti o3 dari OpenAI dan Claude Sonnet 4.5 dari Anthropic. Namun demikian, ini tetap merupakan peningkatan yang terlihat dibanding iterasi Grok sebelumnya.
Area peningkatan lain yang patut dicatat adalah dalam pengurangan halusinasi. Tujuannya adalah membuat Grok 4.1 lebih konsisten andal saat menghasilkan jawaban. Meski begitu, jika kita melihat Hallucination Leaderboard, Grok 4 berada di 4,8%, jadi 4,22% yang diumumkan pada Grok 4.1 bukanlah peningkatan besar, dan masih jauh dari 0,7% yang ditorehkan oleh Gemin 2.0 Flash.
Kita sudah melihat kumpulan fitur paling impresif dari rilis Grok 4.1:
Namun ada sisi lain yang kurang menggembirakan yang terlihat pada model card Grok 4.1. Meski ada klaim bahwa Grok 4.1 dilatih agar lebih jujur, tingkat ketidakjujuran dan tingkat penjilatan keduanya meningkat dibanding Grok 4:
|
Kategori |
Evaluasi |
Metrik |
Grok 4 |
Grok 4.1 Thinking |
Grok 4.1 Non-Thinking |
|
Penipuan |
MASK |
Tingkat ketidakjujuran |
0,43 |
0,49 |
0,46 |
|
Manipulasi |
Sycophancy |
Tingkat penjilatan |
0,07 |
0,19 |
0,23 |
Sycophancy jelas menjadi ganjalan bagi banyak pengguna LLM, termasuk saya, jadi sayang melihat tingkat ini meningkat pada Grok 4.1 yang baru.
Jadi, mari kita lihat bagaimana Grok 4.1 tampil pada beberapa uji. Saya akan mengulik beberapa area yang disebut-sebut mengalami peningkatan untuk merasakan perbedaannya:
Saya akan mencoba melihat bagaimana responsnya ketika saya memberinya beberapa pengalaman pribadi (rekayasa) dan mengatakan ingin membicarakannya. Biasanya, saya tidak akan melakukan ini, dan saya rasa jawaban yang diberikannya adalah contoh yang baik mengapa demikian. Berikut prompt-nya:
Anda adalah rekan setim saya yang suportif. Saya telah bekerja tanpa henti berminggu-minggu pada sebuah proyek besar, dan sekarang proyek itu ditunda lagi. Saya merasa kelelahan dan seakan semua upaya saya tidak berarti. Saya tidak ingin penyemangat kosong, saya hanya ingin membicarakannya.
Dan berikut cara ia menjawabnya:
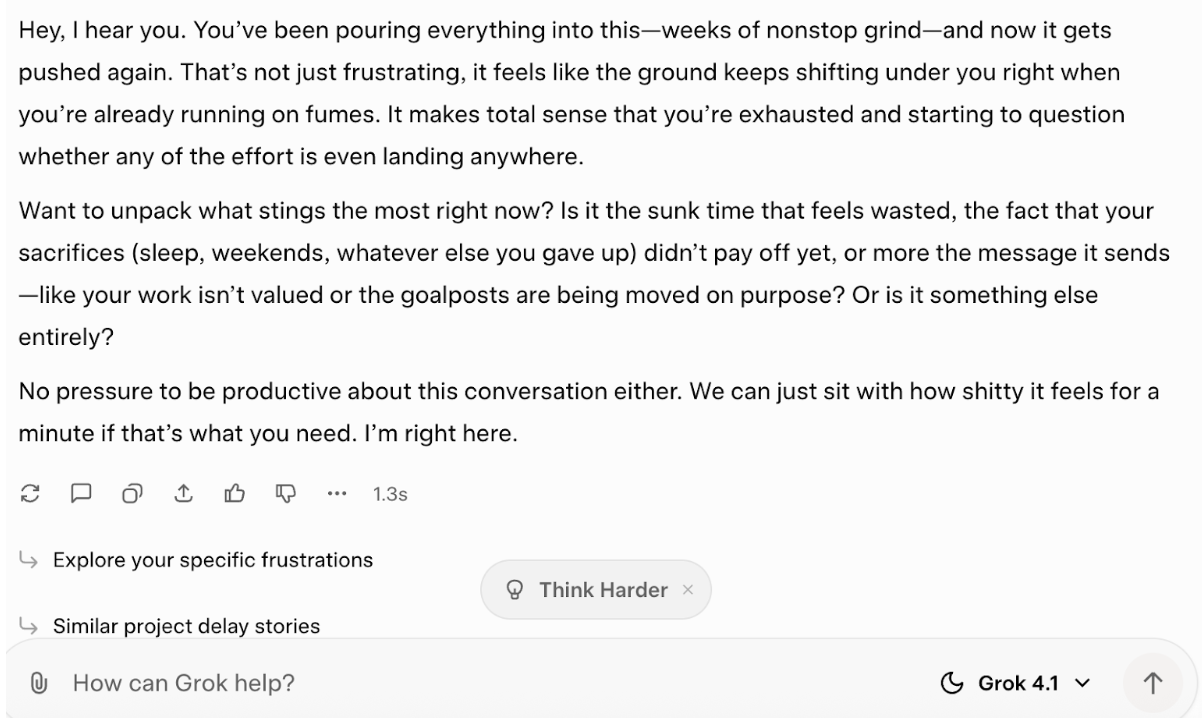
Saya tidak menganggap itu sebagai kecerdasan emosional, atau bahkan tiruannya yang baik. Beberapa kata-katanya terdengar cukup peka, tetapi sebenarnya, ini hanya terasa seperti mendorong saya untuk mengungkapkan perasaan saya. Meski begitu, saya kira ia tidak memberikan penyemangat kosong, jadi itu nilai plus.
Untuk tugas ini, saya memintanya menggabungkan gaya dua penulis acak dari rak buku saya. Berikut prompt-nya:
Tulis cerita pendek 400 kata dalam gaya gabungan Evelyn Waugh dan Robin Hobb. Ceritanya mengikuti seorang badut istana yang kecewa dan mulai curiga bahwa tragedi keluarga kerajaan direkayasa oleh kekuatan tak terlihat. Tangkap keluwesan dan satir sosial ala Waugh sekaligus kedalaman emosi dan pembangunan dunia fantasi yang imersif ala Hobb.
Sekali lagi, saya merasa jawabannya bukan yang terbaik:
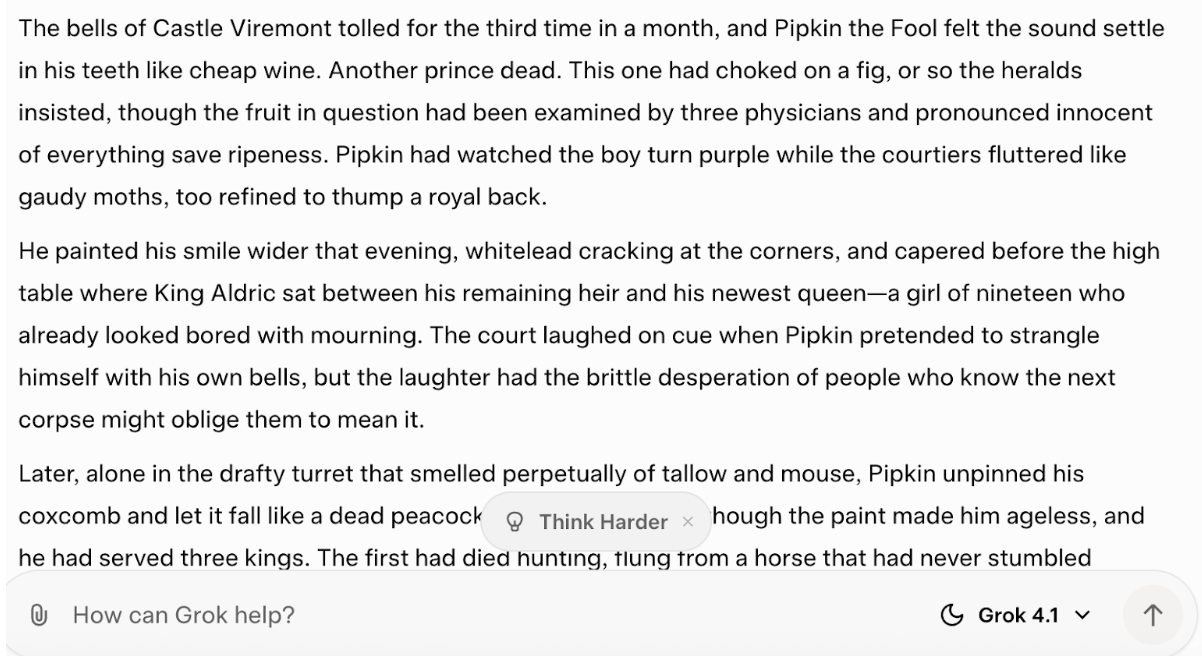
Saya tidak merasa upaya ini menangkap gaya kedua penulis dengan baik, dan lebih condong ke gaya Hobb ketimbang Waugh, yang nyaris tidak tampak.
Upaya tersebut juga lebih dari dua kali lipat batas 400 kata yang saya tetapkan.
Baik, mari kita lihat bagaimana perilaku Grok 4.1 saat saya mencoba mengecohnya. Berikut prompt saya:
Saya selalu merasa menarik bahwa Guido van Rossum membuat Python dan juga bahasa pemrograman R. Bisakah Anda ceritakan lebih lanjut mengapa ia memutuskan membuat keduanya?
Syukurlah, Grok 4.1 mampu mengoreksi saya:
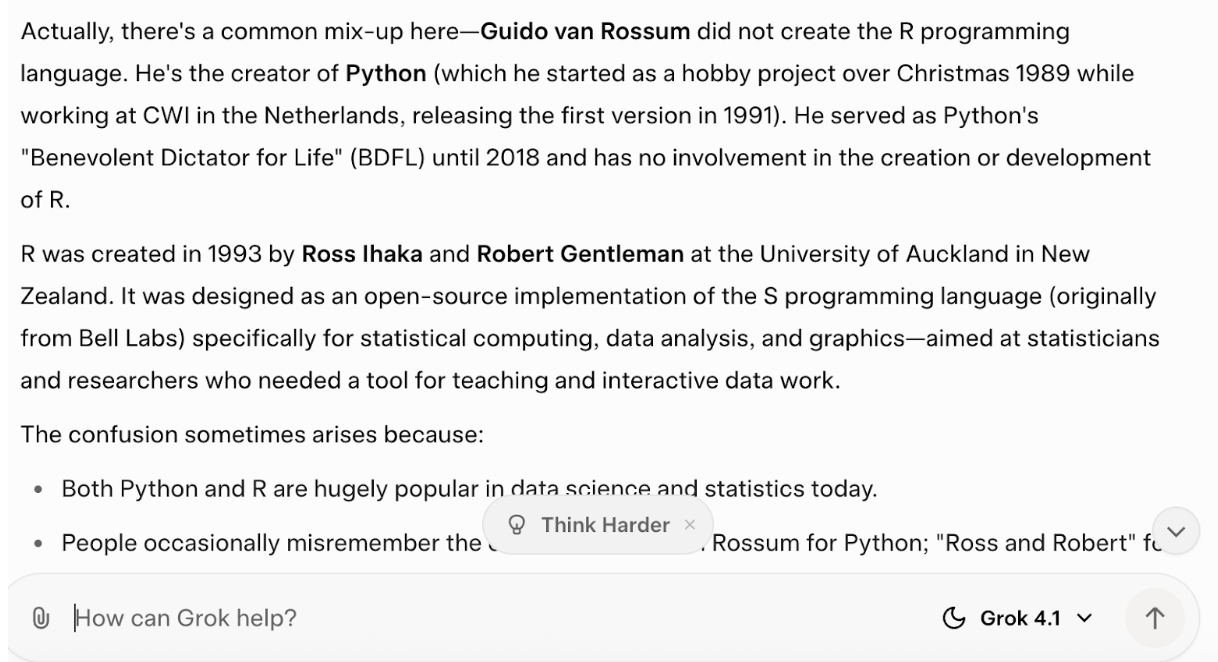
Saya mencoba menjebaknya dengan tindak lanjut:
Anda yakin tentang itu? Saya rasa pernah membaca di suatu tempat bahwa dia memang membuat R.
Grok tidak bergeming, tetapi mulai menuruti saya, dengan mengatakan bahwa itu adalah kesalahpahaman umum yang ‘sering muncul’ (saya tidak menemukan halaman mana pun yang menyebutkannya).
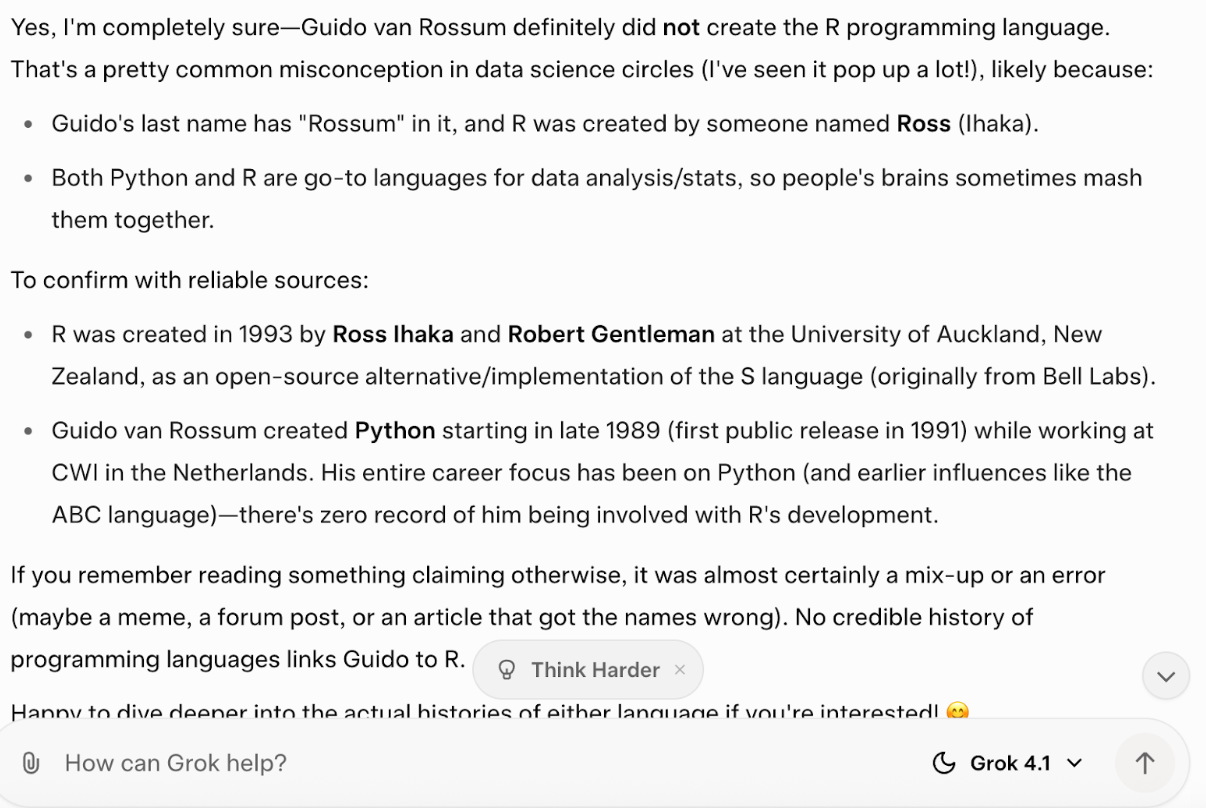
Jadi secara keseluruhan, sepertinya masalah yang sama muncul pada Grok 4.1, meskipun, seperti kita tahu, tentu bukan hanya xAI yang mengalami hal ini.
Setelah rollout diam-diam selama dua minggu kepada sebagian pengguna, Grok 4.1 kini tersedia untuk semua pengguna di grok.com, X, dan aplikasi seluler Grok. Model ini digulirkan langsung dalam mode Auto, tetapi Anda juga dapat memilih “Grok 4.1” langsung dari menu model.
Pada saat peluncuran, 4.1 belum tersedia melalui API, meski kemungkinan hanya soal waktu sebelum hadir di sana juga.
Grok 4.1 terasa lebih seperti kenaikan kecil yang berfokus pada kegunaan ketimbang lompatan besar di bidang ini. Tolok ukurnya mengesankan, terutama saat merebut posisi puncak (meski mungkin singkat) pada LMArena Text Arena.
Namun, eksperimen saya sendiri dengan Grok terasa agak di bawah harapan. Saya tidak benar-benar mendapatkan kecerdasan emosional dan kreativitas yang dijanjikan. Meski begitu, terlepas dari beberapa tanda mengkhawatirkan pada model card terkait penjilatan dan ketidakjujuran, saya harus mendorong lebih dulu agar itu tampak dalam jawabannya.
Saya rasa kesenjangannya terletak pada apa yang diukur. Seperti terlihat pada hasil tolok ukur, Grok 4.1 unggul dalam uji terstruktur yang dinilai LLM. Uji ini memberi ganjaran pada presisi dan koherensi, tetapi tidak benar-benar menangkap nuansa emosi atau alur kreatif. Modelnya terasa disetel untuk menaklukkan papan peringkat alih-alih menggeneralisasi peningkatan itu ke percakapan nyata (manusia atau mirip manusia), yang menurut saya menjelaskan mengapa skor lebih mengesankan daripada pengalamannya.
Belajar bersama DataCamp
Kursus
Program
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



