

Cursus
Inleiding tot AI-agents
1 uur 30 min
147.2K
Oefen en volg je voortgang.
Ga Verder Met GoogleNa maanden wachten op Grok 3.5 sloeg xAI die versie helemaal over en sprong direct naar Grok 4. (Vanaf november 2025 is ook Grok 4.1 gelanceerd).
Is die sprong gerechtvaardigd door de prestaties van het model?
Ja, als je op de benchmarks afgaat. Op papier is Grok 4 op dit moment waarschijnlijk het beste model ter wereld.
Maar met een contextvenster van 128.000 in de app en 256.000 in de API kun je er in echte productie-omgevingen tegenaan lopen. Het is minder vergevingsgezind dan Gemini 2.5 Pro, dat je een volle miljoen tokens geeft. Wil je Grok 4 inzetten voor meer dan een kort gesprek, dan heb je serieuze context engineering skills nodig om het goed te laten werken.
In deze blog snijd ik door de gebruikelijke hype heen en geef ik je een gebalanceerd overzicht door de belangrijkste sterke en zwakke punten van Grok 4 uit te leggen, plus hoe het scoorde in mijn eigen tests.
We houden onze lezers op de hoogte van het laatste AI-nieuws via The Median, onze gratis vrijdagse nieuwsbrief met de belangrijkste verhalen van de week. Abonneer je en blijf scherp in een paar minuten per week:
De Grok 4-familie bestaat alleen uit Grok 4 en Grok 4 Heavy; er is geen mini-versie die we kunnen gebruiken voor snel redeneren.
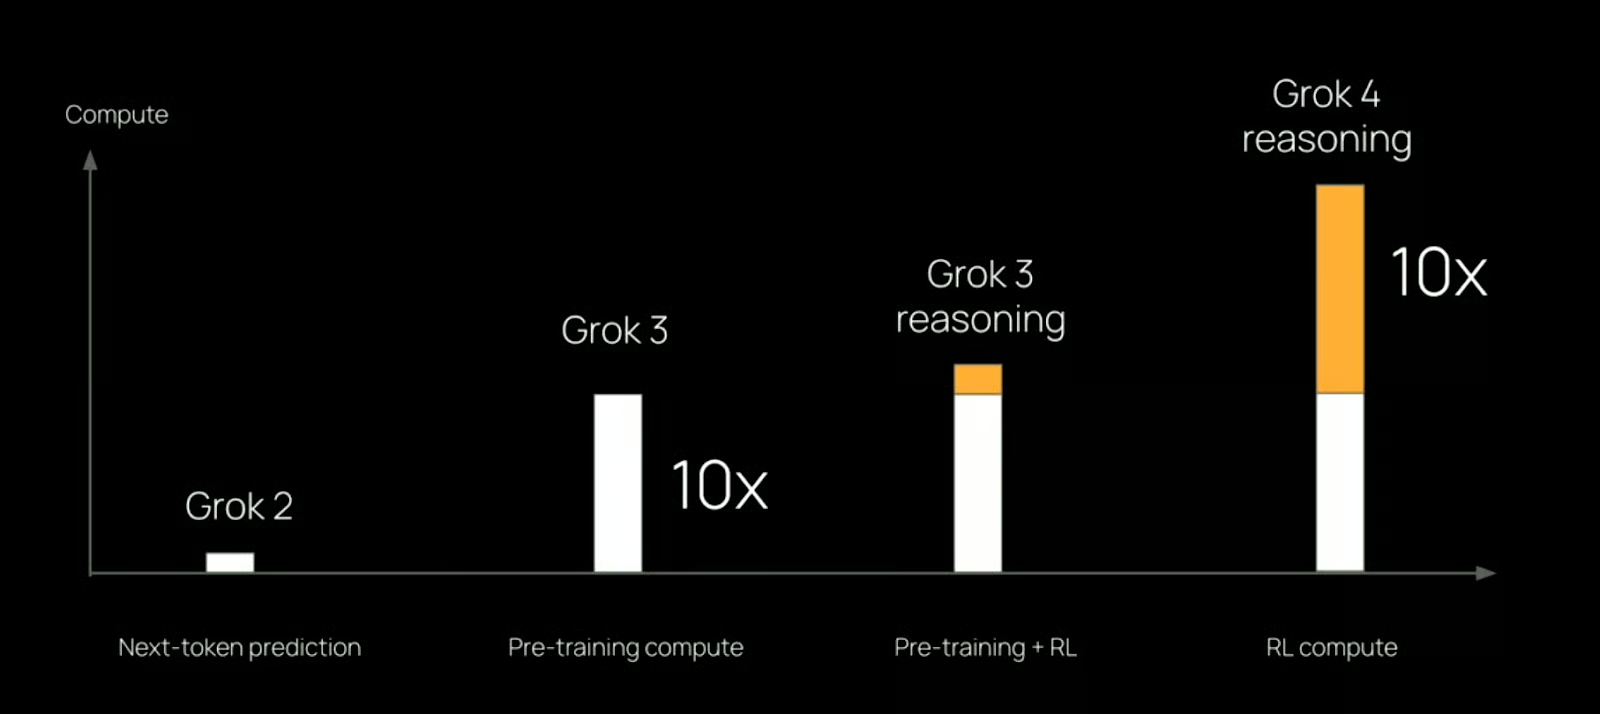
Grok 4 is xAI’s nieuwste single-agentmodel (in tegenstelling tot Grok 4 Heavy, dat meerdere agents gebruikt—daar komen we zo op terug). Op basis van de livestream is er qua engineering niets radicaal baanbrekends. De winst lijkt te komen uit een reeks kleinere tweaks en een forse toename van compute, ongeveer 10x zoveel als voor Grok 3 werd gebruikt.
Bron: xAI
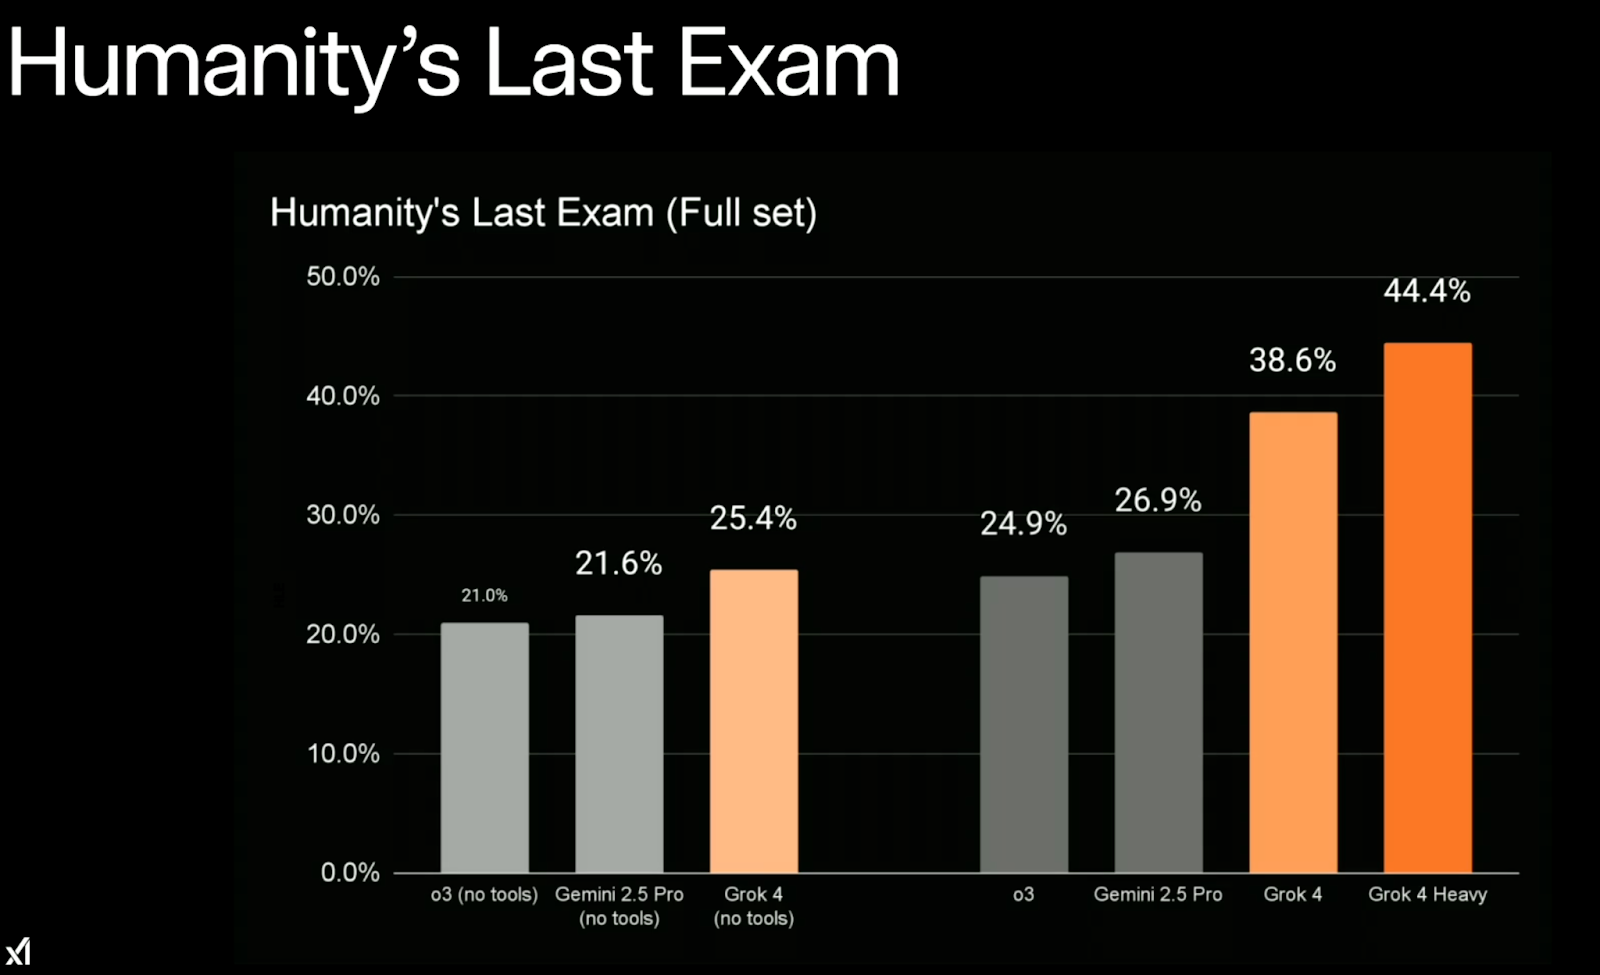
Het bedrijf claimt dat het het meest intelligente model is dat vandaag beschikbaar is, en benchmarkresultaten wijzen inderdaad die kant op. Het meest opvallende resultaat kwam van Humanity’s Last Exam, een benchmark met 2.500 handgeselecteerde vragen op PhD-niveau over wiskunde, natuurkunde, scheikunde, taalkunde en engineering. Grok 4 (met tools) wist ongeveer 38,6% van de problemen op te lossen.
Bron: xAI
Het contextvenster is 128.000 tokens in de app en 256.000 in de API, wat wat ruimte geeft voor lang redeneren maar naar huidige maatstaven niet bijzonder royaal is. Gemini 2.5 Pro biedt bijvoorbeeld 1 miljoen. Als je met Grok bouwt, zul je waarschijnlijk tijd moeten steken in het zorgvuldig structureren en snoeien van je context.
Om het helder te stellen: Grok 4 is niet je model voor alledaagse vragen zoals “Gaat het dit weekend regenen?” of “Zoek een concert in de buurt.” Daar kun je beter Grok 3 voor gebruiken—dat is sneller en gebouwd voor algemene taken. Grok 4 is beter geschikt voor onderzoek, technische prompts en moeilijke vragen in wiskunde, wetenschap, financiën of developer-workflows die draaien op puur redeneren.
Het is minder duidelijk hoe het presteert in bredere consumentgerichte workflows of hoe goed het veiligheid op schaal aan kan. Maar xAI zegt dat het al wordt gebruikt in biomedische labs, financiële bedrijven en vroege enterprise-partners.
Grok 4 Heavy is de multi-agentversie van Grok 4. In plaats van één enkel model te draaien, start het meerdere agents parallel, die elk onafhankelijk aan dezelfde taak werken. Zodra ze output hebben gegenereerd, vergelijken ze de resultaten en komen ze tot een antwoord.
In theorie lijkt het op een studiegroep—agents kunnen inzichten delen of elkaars blinde vlekken opvangen. In de praktijk helpt deze opzet bij complexe redeneertaken waarbij één enkele poging tekort kan schieten.
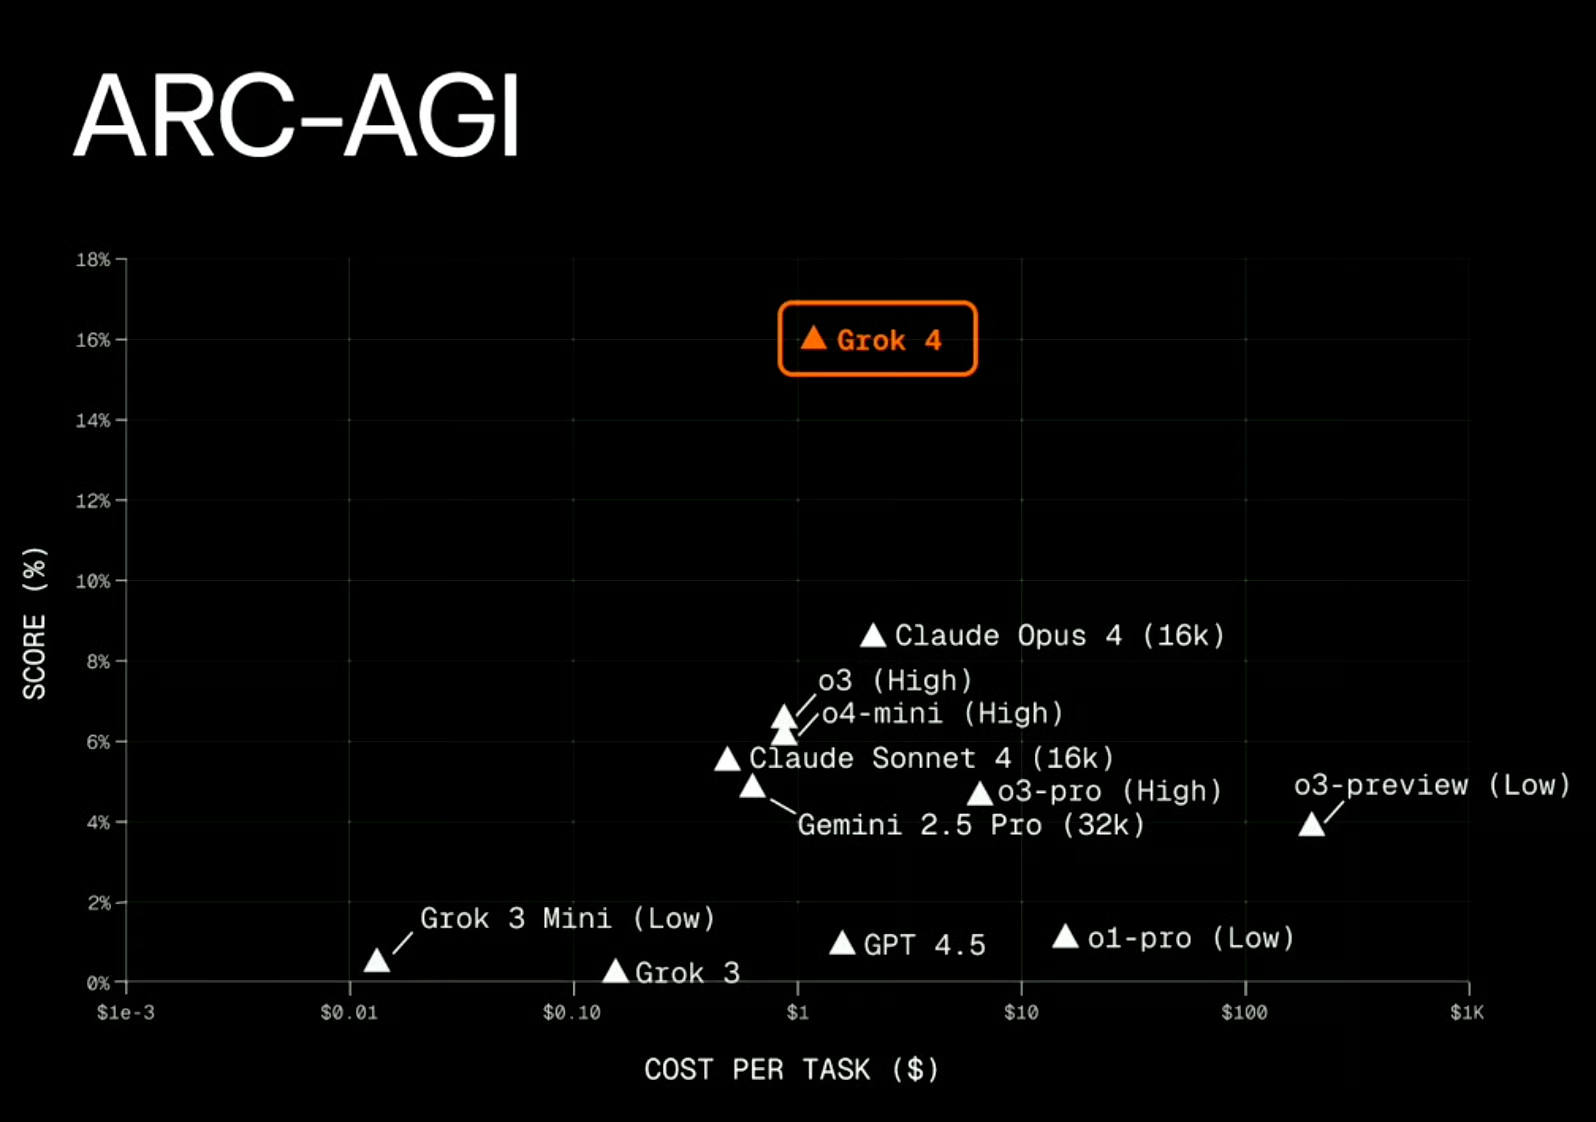
De winst is zichtbaar in benchmarks. Op Humanity’s Last Exam scoorde Grok 4 Heavy met toolgebruik 44,4%, en overtrof het de single-agent Grok 4 met een duidelijke marge. De architectuur leek ook te helpen bij ARC-AGI, waar Grok 4 als eerste model door de 10% brak en 15,9% behaalde—al is onduidelijk hoeveel daarvan specifiek komt door de multi-agentopzet.
Bron: xAI
De keerzijde is snelheid en kosten. Grok 4 Heavy draait langzamer (veel langzamer!), en is tien keer duurder in gebruik—xAI biedt toegang via een SuperGrok Heavy-abonnement van $300/maand.
Ook Grok 4 Heavy wil je niet gebruiken voor simpele opzoekklussen of snelle iteratie. Als Grok 4 al niche is, dan is Grok 4 Heavy dat nog meer. Het is gebouwd voor problemen waarbij meerdere redeneerpaden tot betere uitkomsten kunnen leiden—denk aan wetenschappelijk onderzoek, financiële modellering of alles met langetermijnplanning. Voor de meeste use-cases is het echter overkill.
Voor een visuele demo van Grok 4, mis onze walkthrough-video niet:
Ik test vaak nieuwe modellen, dus ik hergebruik een paar standaardtaken om te zien hoe ze zich verhouden. Dat doe ik hier ook, met focus op wiskunde en coderen. Dit is niet bedoeld als een grondige evaluatie van Grok—meer om gevoel te krijgen voor hoe het zich gedraagt in een typische chatopzet.
Ik begin met een eenvoudige berekening: 9,11 - 9,9. Misschien klinkt dat flauw, maar het brengt taalmodellen vaak in de war—Claude Sonnet 4 zat er bijvoorbeeld naast. Natuurlijk kan ik gewoon een rekenmachine gebruiken, maar het doel is hier te zien hoe het model het probleem benadert en of het kan terugvallen op tools indien nodig of het direct kan oplossen via chain-of-thought-redeneren.
Zo antwoordde Grok 4:
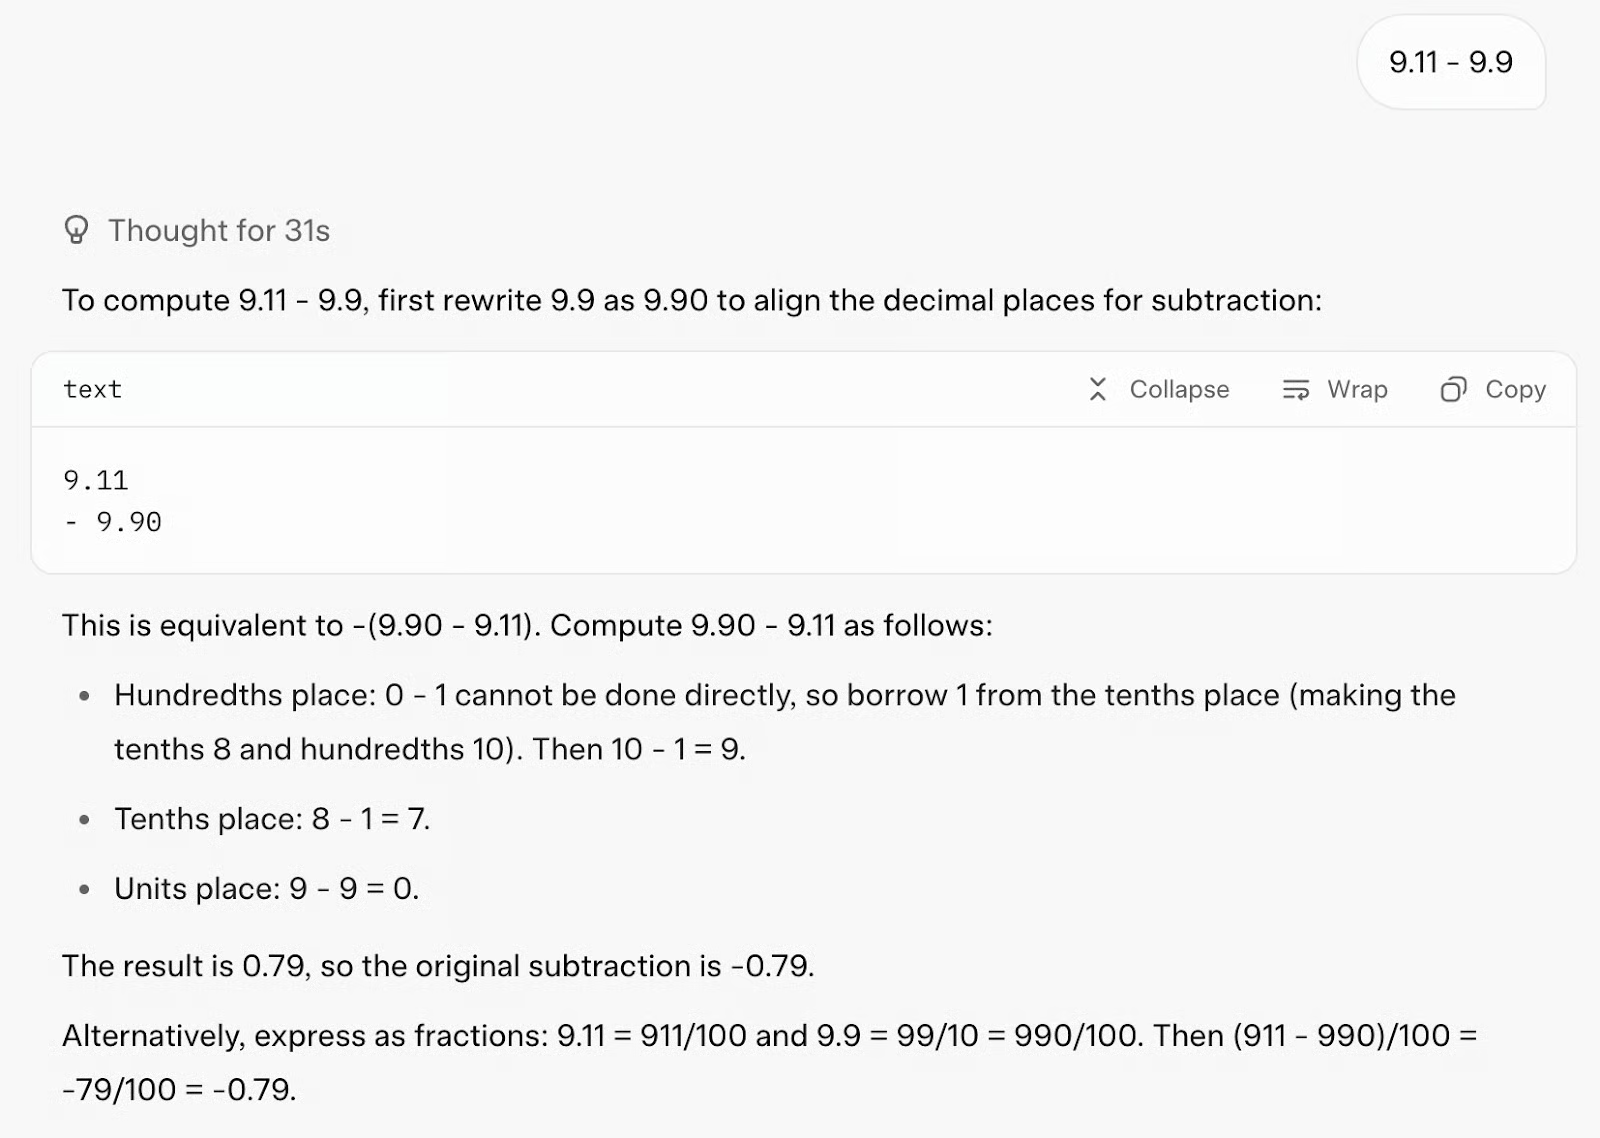
Het gaf meteen het juiste antwoord. Het vond de uitkomst via chain-of-thought en gebruikte ook een codetool om het te bevestigen (top!).
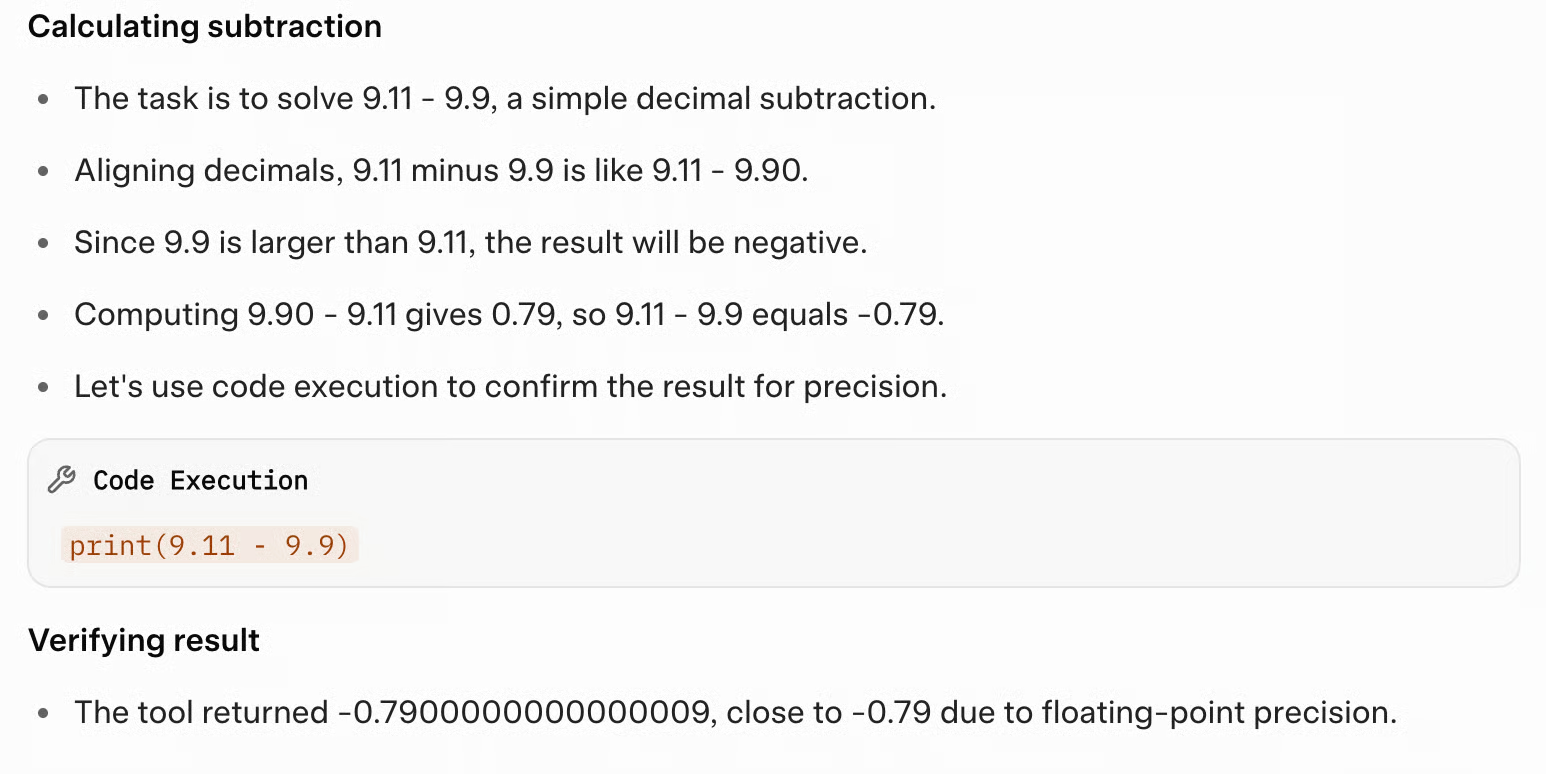
Het duurde echter 31 seconden om te reageren, en de output was onnodig lang voor zo’n simpele prompt.
Vervolgens wilde ik Grok 4 testen op een complexer wiskundeprobleem dat een model doorgaans tegen de grenzen van het contextvenster duwt:
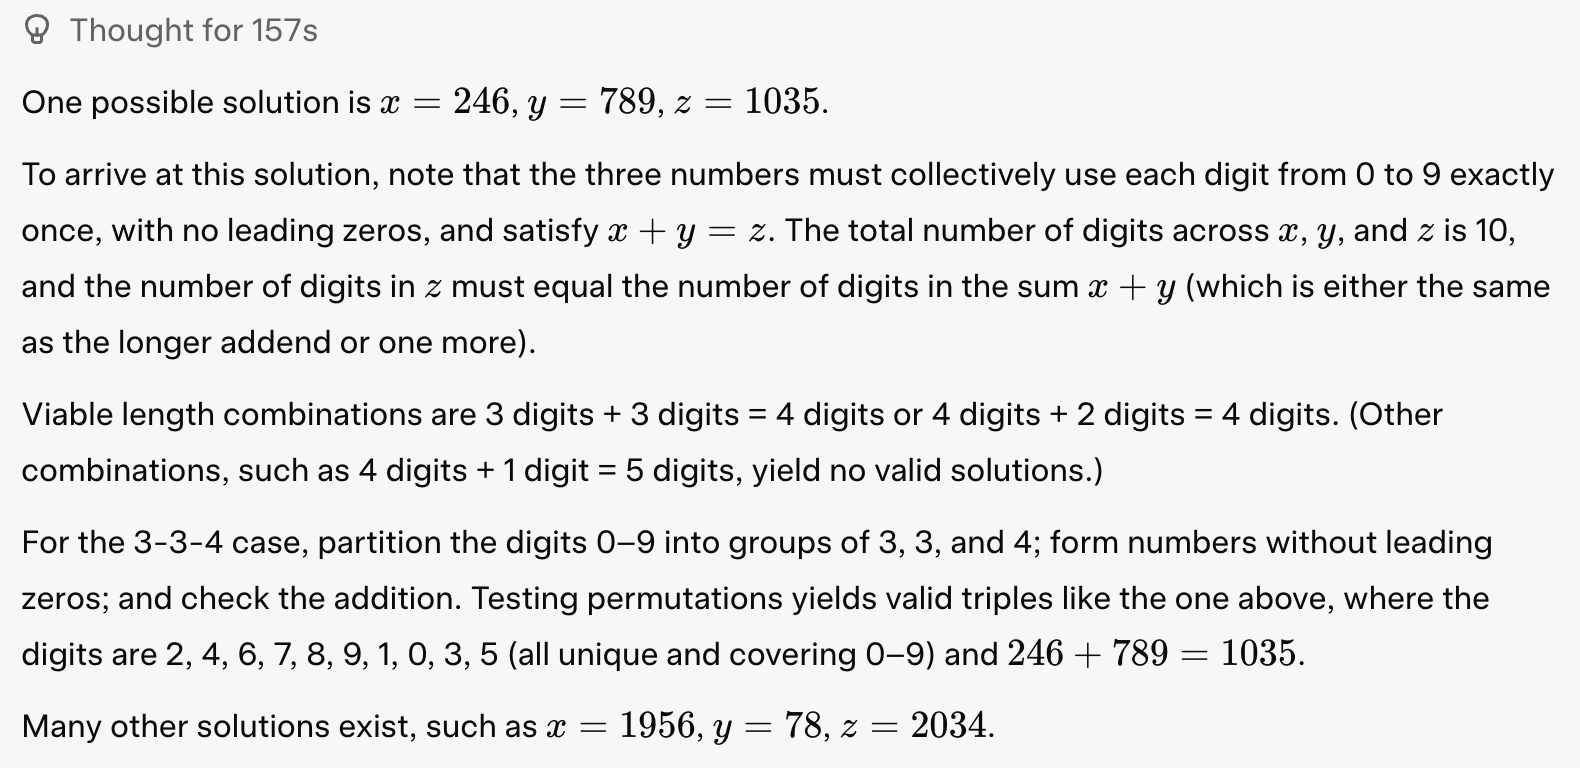
Prompt: Gebruik alle cijfers van 0 t/m 9 precies één keer om drie getallen x, y, z te maken zodat x + y = z.
Grok 4 pakte het probleem slim aan. Eerst realiseerde het zich dat het alle 3.628.800 permutaties van de cijfers 0–9 in een paar seconden kon genereren met Python. Vervolgens probeerde het een opzet met twee 3-cijferige getallen die optellen tot een 4-cijferig getal, en kwam met code die daadwerkelijk 96 geldige oplossingen opleverde!
from itertools import permutations

digits = range(10)

solutions = []

for p in permutations(digits):
    x_digits = p[0:3]
    if x_digits[0] == 0: continue
    y_digits = p[3:6]
    if y_digits[0] == 0: continue
    z_digits = p[6:10]
    if z_digits[0] == 0: continue
    x = int(''.join(map(str, x_digits)))
    y = int(''.join(map(str, y_digits)))
    z = int(''.join(map(str, z_digits)))
    if x + y == z:
        solutions.append((x, y, z))

print(solutions)
Daarna probeerde het andere combinaties (zoals 4-cijferig plus 2-cijferig dat gelijk is aan 4-cijferig) met dezelfde aanpak. Tot slot zocht het op het web naar meer informatie over deze puzzel en om het antwoord te bevestigen. In totaal duurde het 157 seconden om dit antwoord te geven:
Voor de code-opdracht wilde ik zien hoe het zich verhoudt tot Gemini 2.5 Pro en Claude Opus 4 op deze taak:
Prompt: Maak een meeslepend endless runner-spel. Duidelijke instructies op het scherm. p5.js-scène, geen HTML. Ik houd van gepixelde dinosaurussen en interessante achtergronden.
Hier is het resultaat:
Best goed!
Tot slot wilde ik zien hoe goed Grok 4 lange, multimodale context aan kan. Ik uploadde een pdf met het Generative AI Outlook Report (43.087 tokens) van de Europese Commissie en vroeg Grok om:
Prompt: Analyseer dit hele rapport en identificeer de drie meest informatieve grafieken. Vat elk samen en laat me weten op welke pagina van de pdf ze staan.
Laten we eerst het antwoord bekijken en het daarna uitpakken:
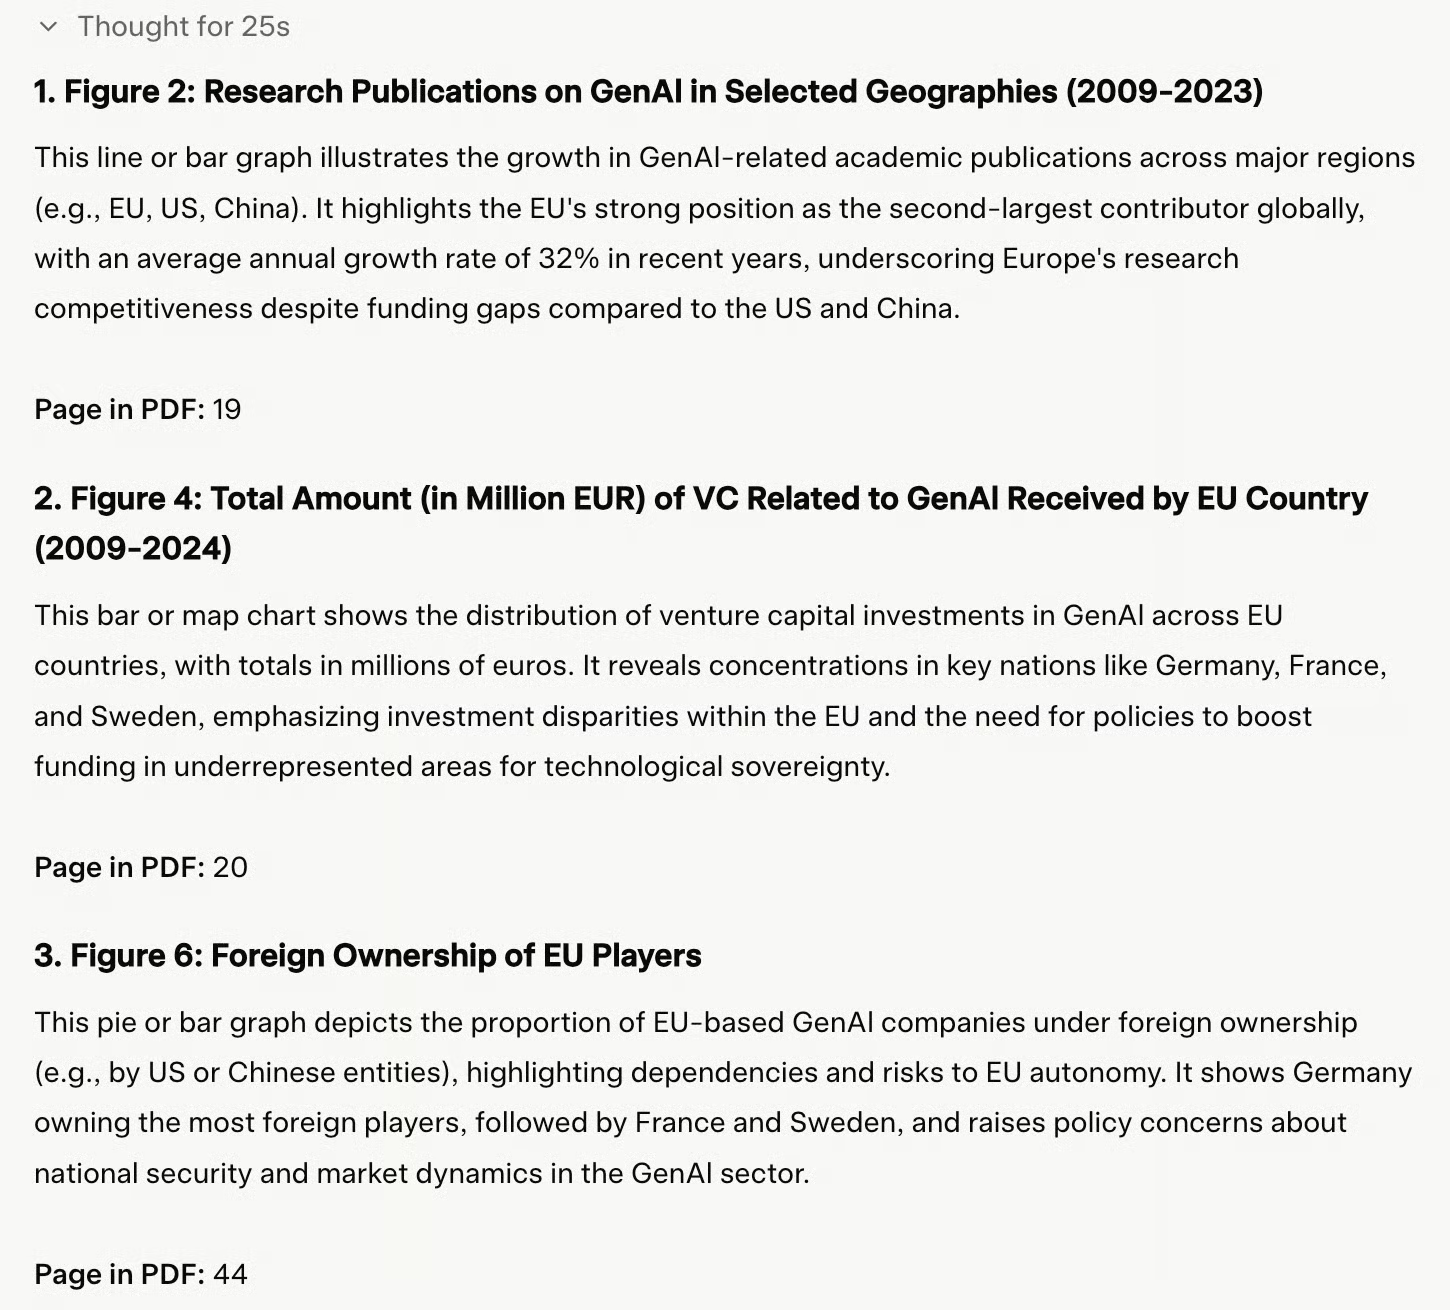
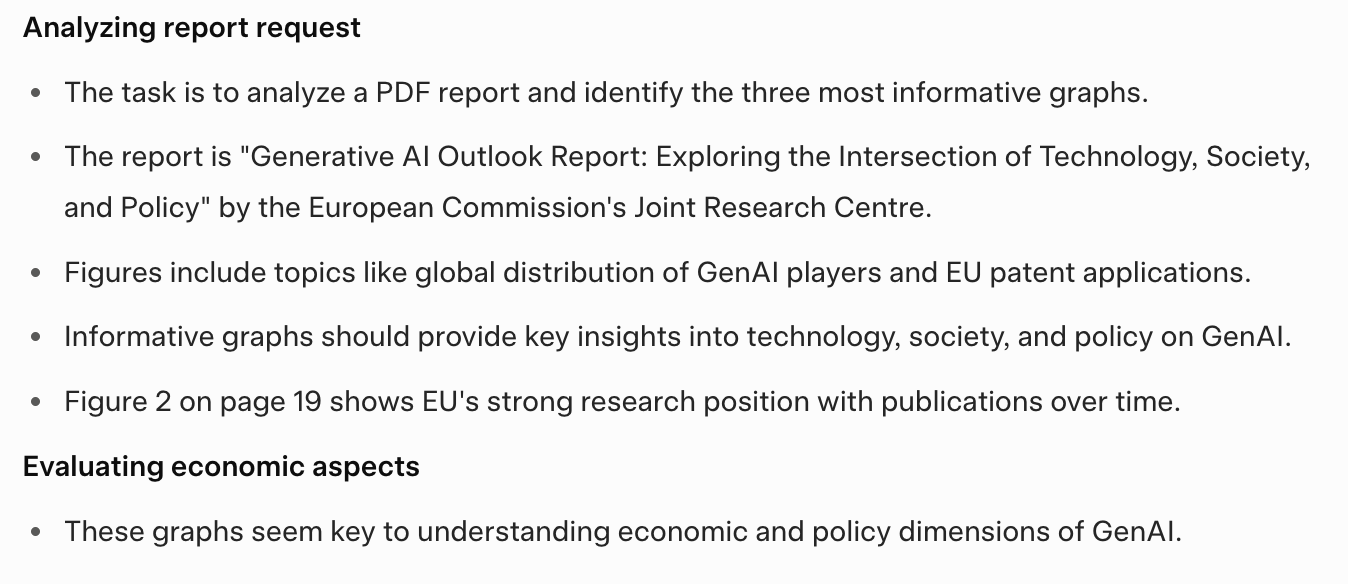
Wat me opviel is dat het verrassend snel stopte, na slechts 25 seconden. Het raadde grafieken aan van pagina’s 19, 20 en 44 (onjuist), en leek de rest van het 167 pagina’s tellende document te negeren zodra het iets leek te vinden dat voldeed. De chain-of-thought voelt incompleet en wijst op een vrij oppervlakkige aanpak:
Dan nu de resultaten:
Zoals Elon Musk in de livestream aangaf, is Grok 4’s beeldbegrip en -generatie nog niet erg geavanceerd. Als je consistente en betrouwbare resultaten wilt, kun je eerlijk zeggen dat Grok 4 op dit moment een tekst-only model is.
Grok 4’s voornaamste troef is de performance over een brede mix aan benchmarks, van academische examens tot bedrijfsimulaties. Volgens xAI verbetert het model aanzienlijk ten opzichte van eerdere versies vooral dankzij meer compute—zowel tijdens training als inferentie—niet per se door nieuwe architecturale doorbraken.
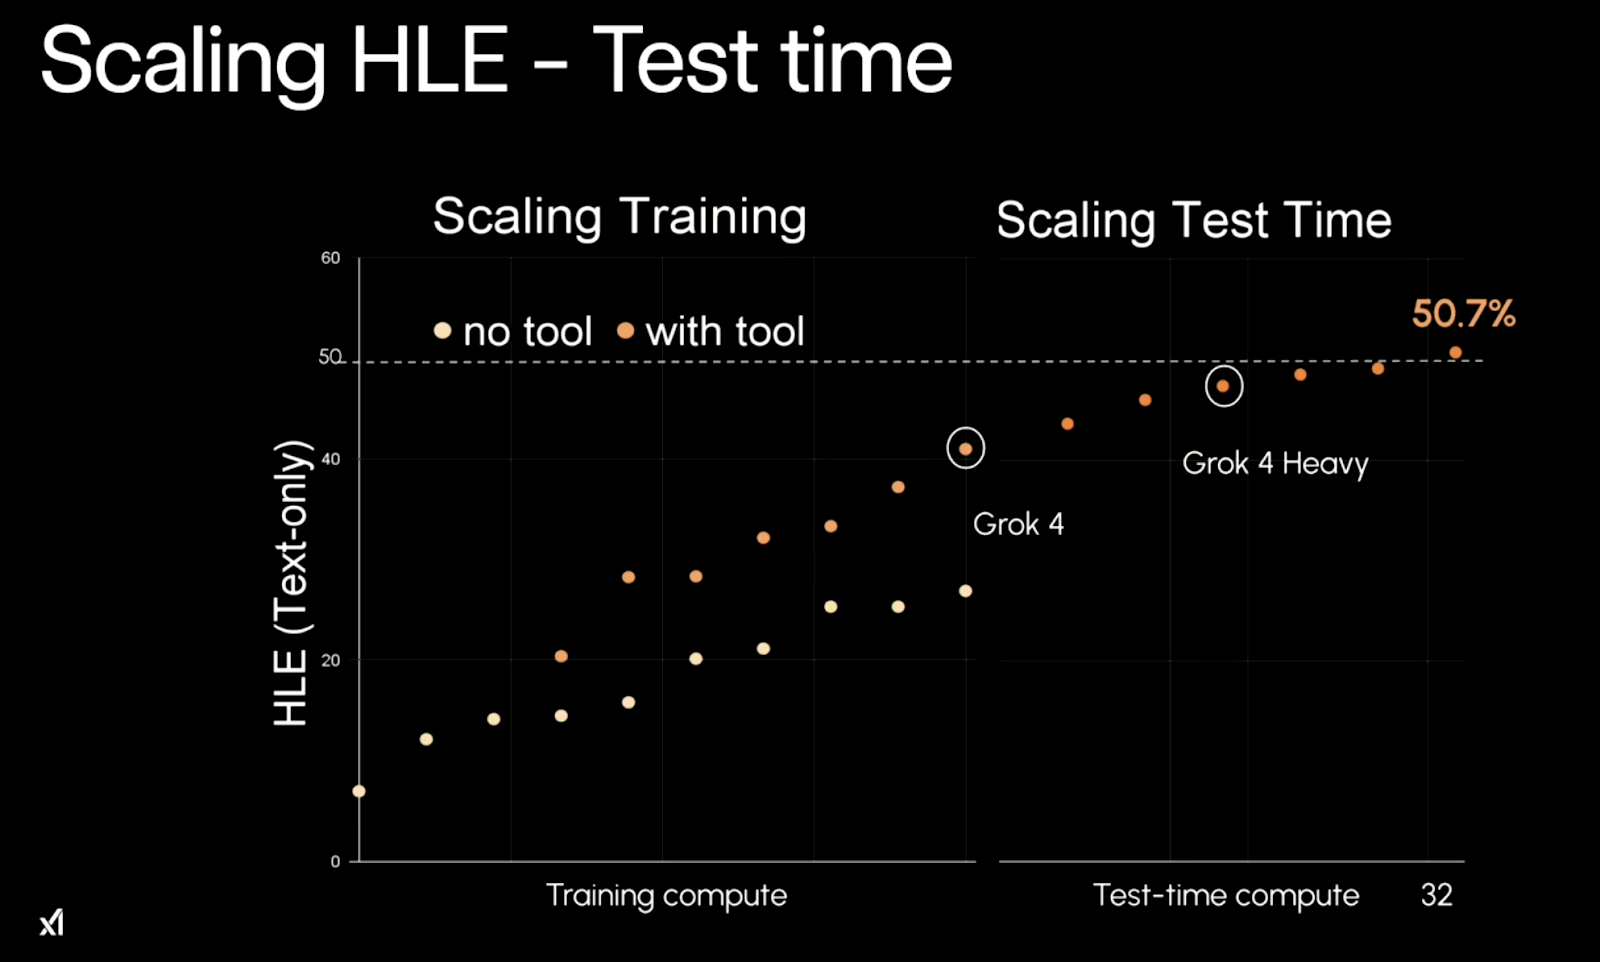
Het kernpatroon achter de prestaties van Grok 4 is schaling. Het profiteert van meer trainingcompute en, interessanter nog, van meer test-time compute. Simpel gezegd: hoe meer resources je inzet, hoe beter het presteert. Dat is vooral duidelijk bij de prestaties op Humanity’s Last Exam (HLE)-taken.
Bron: xAI
Zonder tools blijft Grok 4 steken rond 26,9% nauwkeurigheid. Met tools (bijv. code-executie) haalt het 41,0%. En in de multi-agent “Heavy”-configuratie stijgt het naar 50,7%—een forse sprong, meer dan het dubbele van de beste eerdere scores zonder tools.
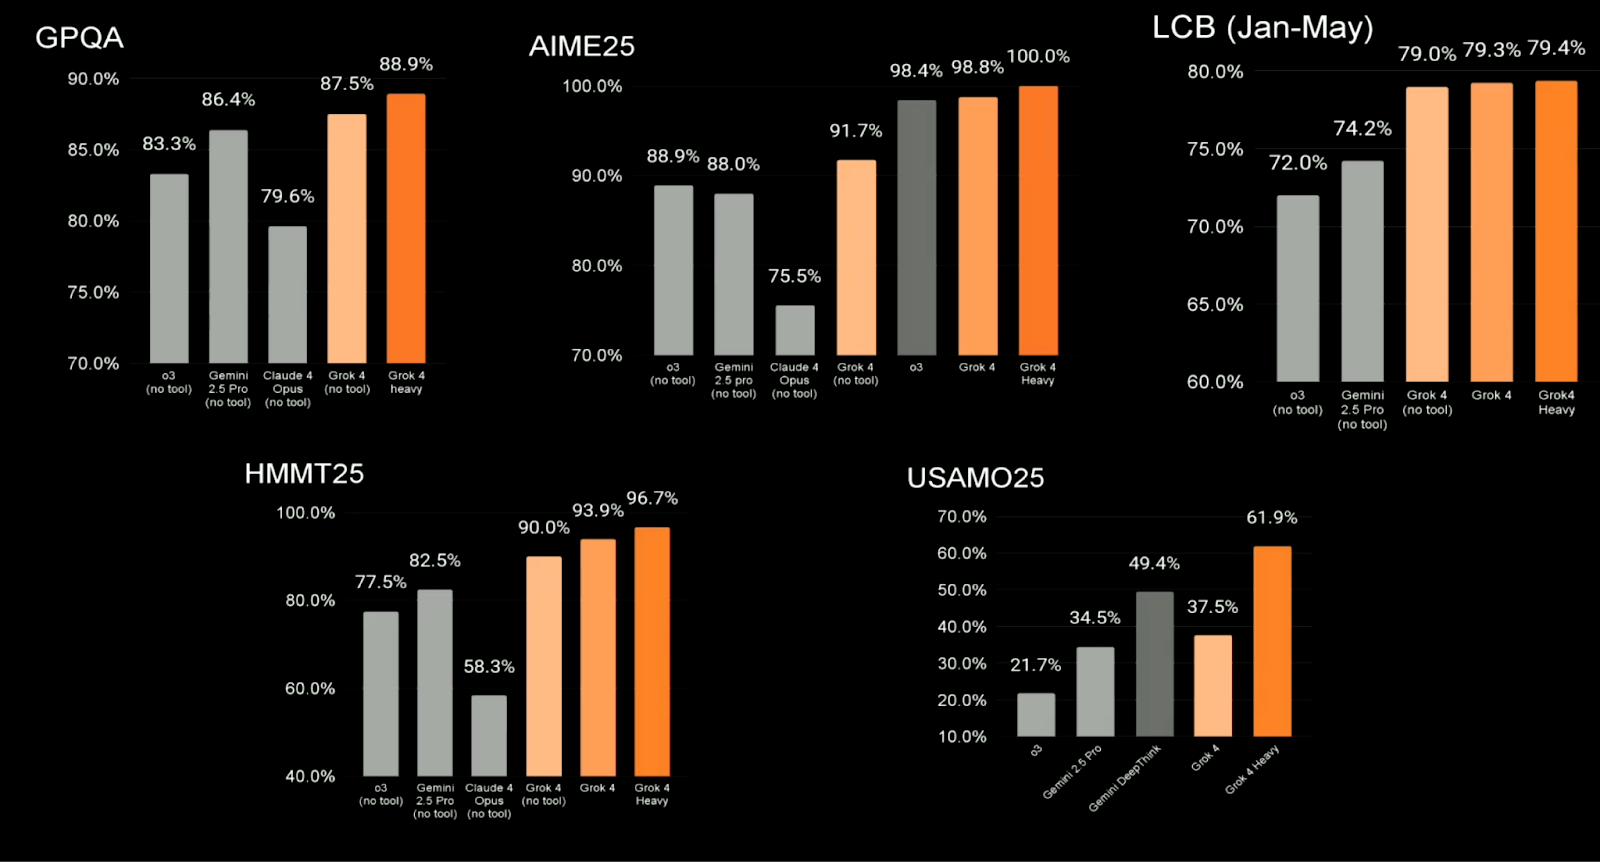
Grok 4 doet het ook goed op meer traditionele, op STEM gerichte evaluaties, waarvan veel in het veld worden gebruikt om high-performing LLM’s te vergelijken. Highlights:
|
Benchmark |
Top concurrerende modellen |
Grok 4 (zonder tools) |
Grok 4 Heavy |
|
GPQA |
79,6–86,4% |
87,5% |
88,9% |
|
AIME25 |
75,5–98,8% |
91,7% |
100,0% |
|
LCB (jan–mei) |
72,0–74,2% |
79,0% |
79,4% |
|
HMMT25 |
58,3–82,5% |
90,0% |
96,7% |
|
USAMO25 |
21,7–49,4% |
37,5% |
61,9% |
Dit zijn sterke resultaten. Grok 4 presteert beter dan Claude Opus, Gemini 2.5 Pro en GPT-4 (o3) in de meeste categorieën, al hebben sommige gebruikers erop gewezen dat de vergelijkingen mogelijk cherry-picking van baseline-scores van concurrerende modellen bevatten.
Bron: xAI
Een van de lastigere en minder transparante benchmarks is ARC-AGI, dat het vermogen van een model test om te generaliseren over abstracte redeneertaken. Op ARC-AGI v1 scoort Grok 4 66,6%, voor op alle bekende peers. Op ARC-AGI v2 haalt het 15,9%, vergeleken met 8,6% voor Claude 4 Opus.
Deze tests zijn niet volledig publiek, dus de gebruikelijke kanttekeningen gelden. Maar als de cijfers standhouden, laat Grok 4 sterke prestaties zien in meerstaps-, logisch zware redeneertaken.
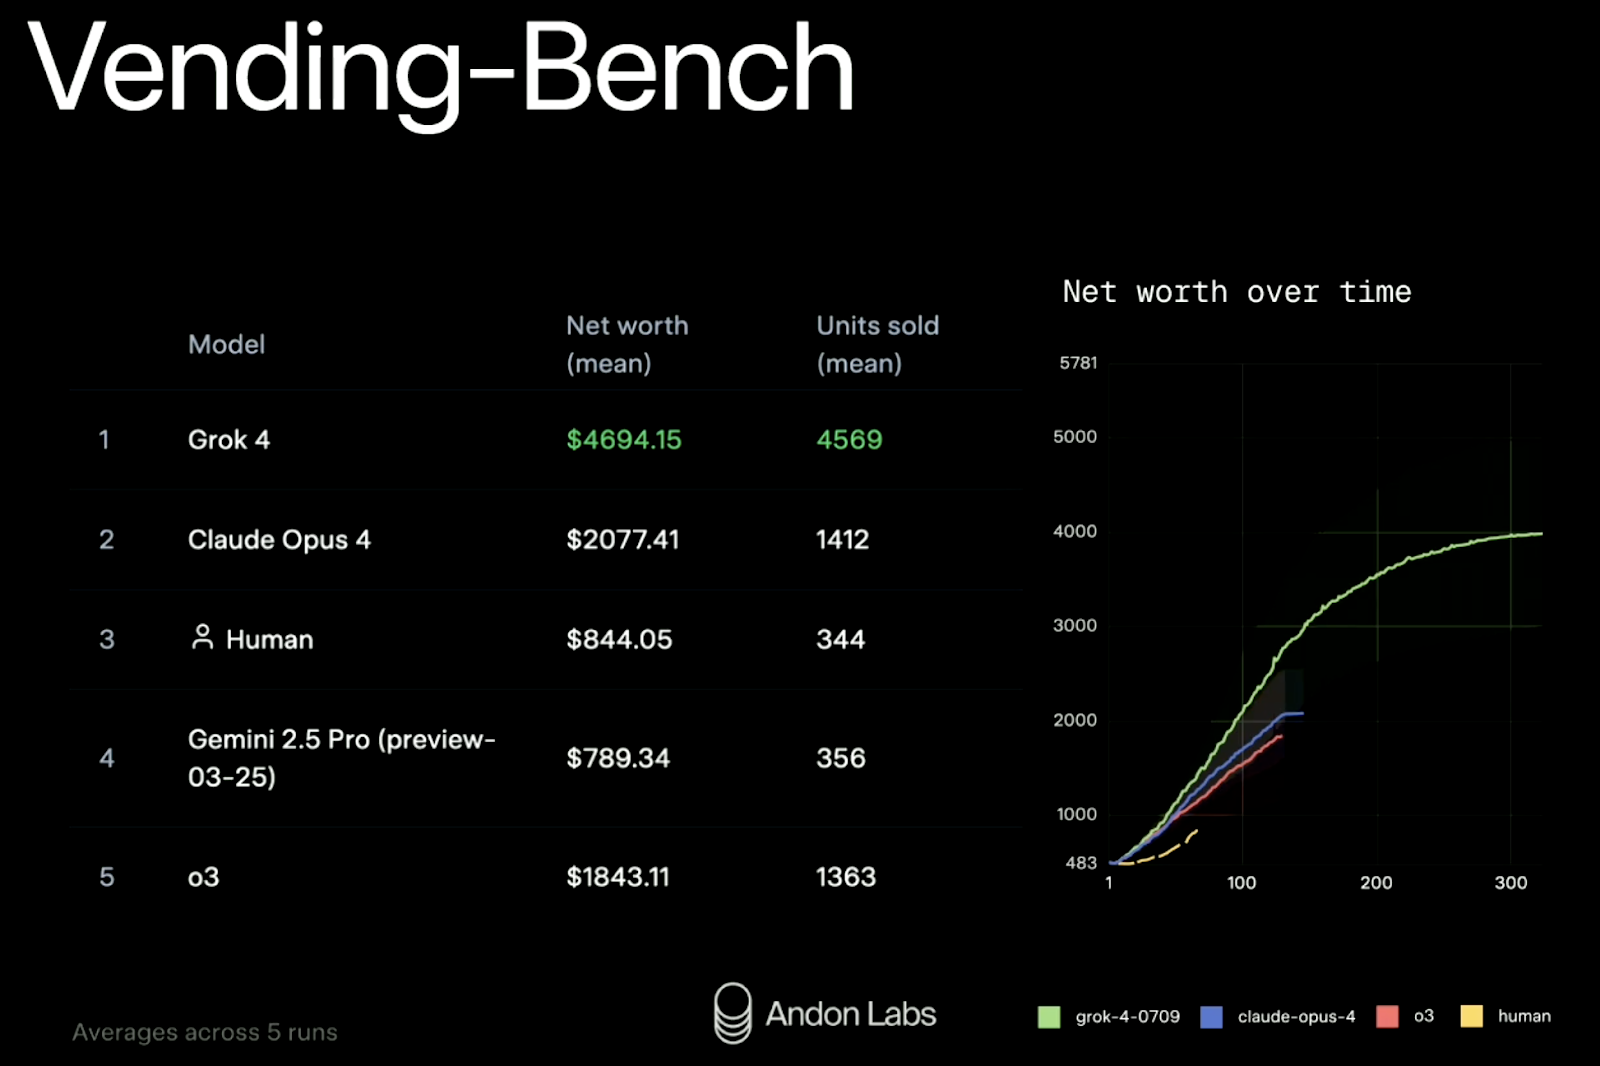
xAI testte Grok 4 ook in een realistische simulatie genaamd Vending-Bench. Het idee is te kijken of een model een klein bedrijf over tijd kan runnen: voorraad aanvullen, prijzen aanpassen, leveranciers contacteren, enz. Het is een vrij nieuwe benchmark en verrassend leuk. We bespraken eerder in detail hoe het werkt via een case study met Claude Sonnet 3.7 in onze wekelijkse nieuwsbrief, The Median.
Resultaten (gemiddeld over vijf runs):
|
Rang |
Model |
Netto waarde |
Verkochte eenheden |
|
1 |
Grok 4 |
$4.694 |
4.569 |
|
2 |
Claude Opus 4 |
$2.077 |
1.412 |
|
3 |
Menselijke baseline |
$ 844 |
344 |
|
4 |
Gemini 2.5 Pro |
$ 789 |
356 |
|
5 |
GPT-4 (o3) |
$1.843 |
1.363 |
Grok 4 verdubbelde ruimschoots de prestaties van de dichtstbijzijnde concurrent in zowel omzet als schaal. Het hield de prestaties ook consistent over 300 rondes simulatie—iets waar veel modellen moeite mee hebben bij langetermijnplanning.
Bron: xAI
Kortom: Grok 4 presteert goed waar xAI het getest heeft. Maar zoals altijd moet je verder kijken dan het leaderboard. De benchmarks zijn veelbelovend, maar vertellen niet het hele verhaal—zeker niet als je use-case afhankelijk is van vision, codegeneratie of realtime interactie in rommelige omgevingen.
Grok 4 is nu beschikbaar via drie hoofdingangen: de X-app, de xAI API en het grok.com-platform. Of je nu met het model wilt chatten, ermee wilt bouwen, of de redeneercapaciteiten formeler wilt testen, zo begin je.
De makkelijkste manier om Grok 4 te proberen is via de X-app (voorheen Twitter). Dit geeft je toegang tot Grok in een chatinterface, vergelijkbaar met ChatGPT of Claude.
Zo gebruik je het:
Je kunt Grok 4 ook direct gebruiken via grok.com, dat een schonere, zelfstandige interface biedt buiten het X-platform. Het is bedoeld voor gebruikers die liever zonder afleiding werken.
Als je Grok in je eigen app of workflow wilt integreren, kun je de xAI API gebruiken.
Stappen:
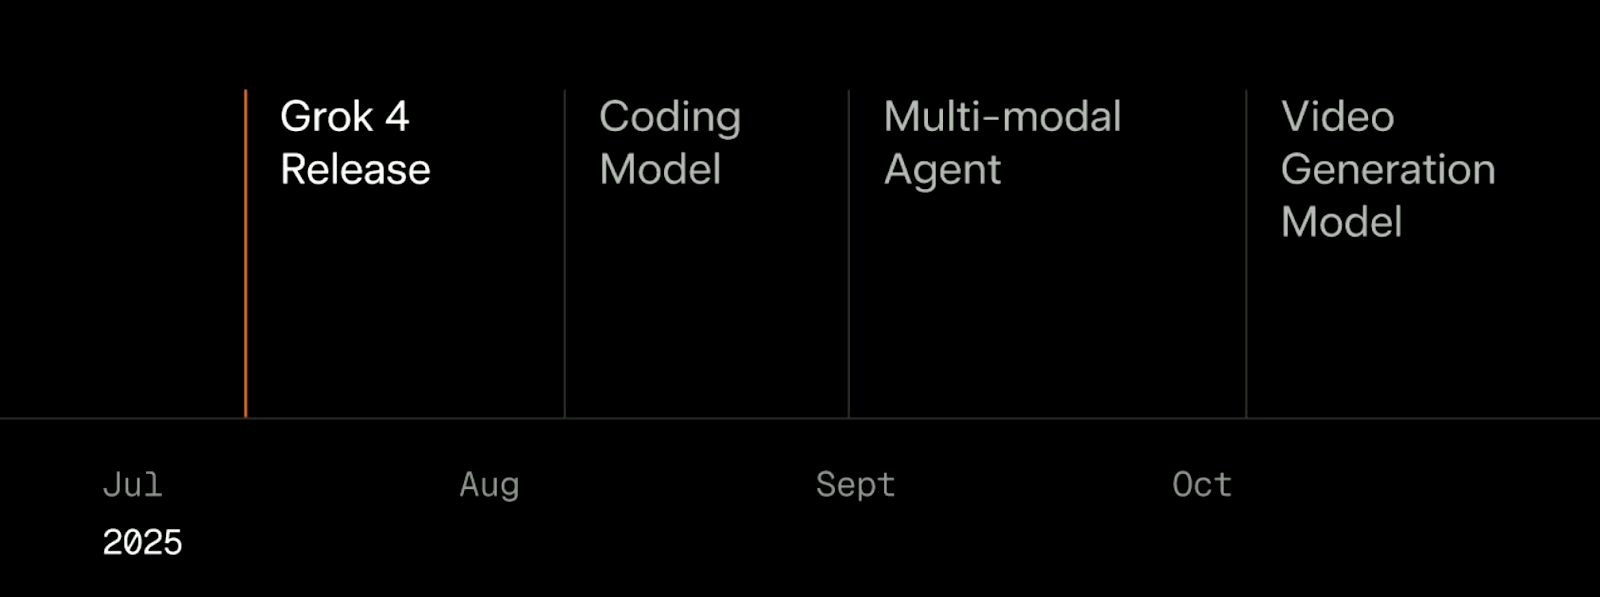
Nu Grok 4 is uitgebracht, heeft xAI een duidelijke (en ambitieuze) roadmap voor de rest van 2025 neergelegd. Volgens de tijdlijn uit de livestream staan er in de komende drie maanden vier grote releases gepland: een codemodel in augustus, een multimodale agent in september en een videogeneratiemodel in oktober.
Bron: xAI
De eerste opvolger is een op coderen gericht model dat in augustus wordt verwacht. In tegenstelling tot Grok 4, een generalist, wordt dit een gespecialiseerd model dat code sneller en nauwkeuriger moet afhandelen. xAI omschreef het als “snel en slim”, specifiek getraind om zowel latency als redeneren in softwareontwikkelingsworkflows te verbeteren.
In september staat de release van een echt multimodale agent gepland. Op dit moment ondersteunt Grok 4 technisch gezien beeld- en video-inputs, maar het begrip is beperkt—tijdens de livestream noemde het team het “turend door matglas.”
De komende versie moet dat verhelpen, met sterker waarnemingsvermogen voor beeld, video en audio. Dit is cruciaal voor use-cases die verder gaan dan tekst: denk aan robotica, games, video-QA of visuele instructievolging.
De laatste release in de huidige tijdlijn is een videogeneratiemodel in oktober. xAI zegt het te trainen op meer dan 100.000 gpu’s. Op basis van hun opmerkingen mikt dit systeem op hoogwaardige, interactieve en bewerkbare videocontent.
Grok 4 is een serieuze stap vooruit voor xAI. Het presteert beter dan concurrenten op verschillende moeilijke benchmarks, houdt stand in gestructureerde evaluaties van wiskunde en wetenschap, en introduceert een multi-agentsysteem (Grok 4 Heavy) dat veelbelovend is voor onderzoeksomgevingen en langetermijndenken.
Toch is het geen alledaagse, general-purpose assistent. Het is langzamer dan Grok 3, het begrip van beeld en video staat nog in de kinderschoenen, en het mist wat verfijning qua dagelijks gebruik. Je moet zorgvuldig prompten en je input trimmen door het relatief beperkte contextvenster. En als je de beste prestaties wilt—via Grok 4 Heavy—betaal je daar een premie voor.
Voor developers en onderzoekers is het de moeite waard om te verkennen. Voor casual gebruikers passen de snelheid en responsiviteit van Grok 3 of andere mainstream modellen beter. De roadmap is ambitieus, met een codemodel, multimodale agent en videogenerator die allemaal voor oktober gepland staan. Of xAI die deadlines haalt is een andere vraag. Maar met Grok 4 hebben ze in elk geval een overtuigende case gemaakt dat ze meedoen in de race.
Leer AI met deze cursussen!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

