{count, plural, one {कोर्स} other {कोर्स}}
AI Agents परिचय
{hours} घंटा {minutes} मिनट
144.6K
हमने महीनों तक Grok 3.5 का इंतज़ार किया, लेकिन xAI ने उसे छोड़कर सीधे Grok 4 पर छलांग लगा दी। (नवंबर 2025 तक, Grok 4.1 भी लॉन्च हो चुका है)।
क्या यह छलांग मॉडल के प्रदर्शन से सही ठहरती है?
हाँ, अगर आप बेंचमार्क के आधार पर जज करें। फिलहाल, कागज़ पर Grok 4 शायद दुनिया का सबसे बेहतर मॉडल है।
लेकिन ऐप में 128,000 और API में 256,000 के कॉन्टेक्स्ट विंडो के साथ, असली प्रोडक्शन काम में आपको मुश्किल हो सकती है। यह Gemini 2.5 Pro जितना उदार नहीं है, जो आपको पूरे एक मिलियन टोकन देता है। अगर आप Grok 4 को सिर्फ छोटी चैट से ज़्यादा के लिए इस्तेमाल करना चाहते हैं, तो इसे काम में लाने के लिए आपको गंभीर कॉन्टेक्स्ट इंजीनियरिंग कौशल की ज़रूरत होगी।
इस ब्लॉग में, मैं सामान्य हाइप से हटकर आपको संतुलित ओवरव्यू दूंगा—Grok 4 की मुख्य खूबियाँ और कमजोरियाँ समझाते हुए, साथ ही मेरे अपने टेस्ट में इसका प्रदर्शन कैसा रहा।
हम अपने पाठकों को AI की ताज़ा अपडेट The Median के ज़रिए देते हैं—यह हमारा फ्री शुक्रवार न्यूज़लेटर है जो हफ्ते की प्रमुख ख़बरों को सरलता से समझाता है। सब्सक्राइब करें और हर हफ्ते कुछ मिनटों में अपडेट रहें:
Grok 4 परिवार में सिर्फ Grok 4 और Grok 4 Heavy शामिल हैं, और तेज़ रीजनिंग के लिए कोई मिनी वर्ज़न नहीं है।
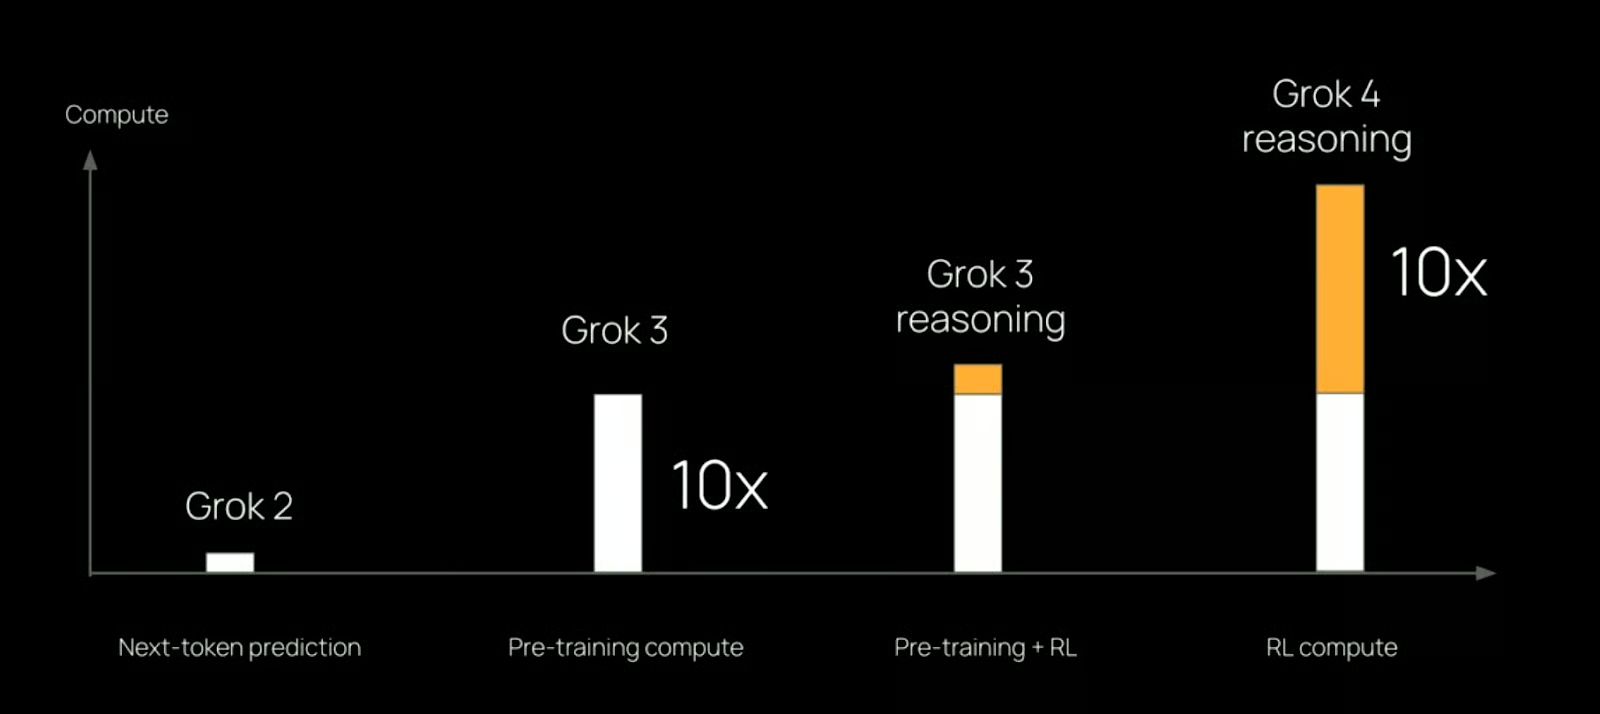
Grok 4 xAI का नवीनतम सिंगल-एजेंट मॉडल है (Grok 4 Heavy के विपरीत, जो मल्टी-एजेंट का उपयोग करता है—इस पर हम अगले सेक्शन में आएंगे)। लाइवस्ट्रीम के आधार पर, इंजीनियरिंग के लिहाज़ से इसमें कुछ विशेष क्रांतिकारी नहीं दिखता। बढ़त छोटे-छोटे सुधारों और कंप्यूट में बड़े इज़ाफे से आती लगती है—Grok 3 की तुलना में लगभग 10 गुना अधिक।
स्रोत: xAI
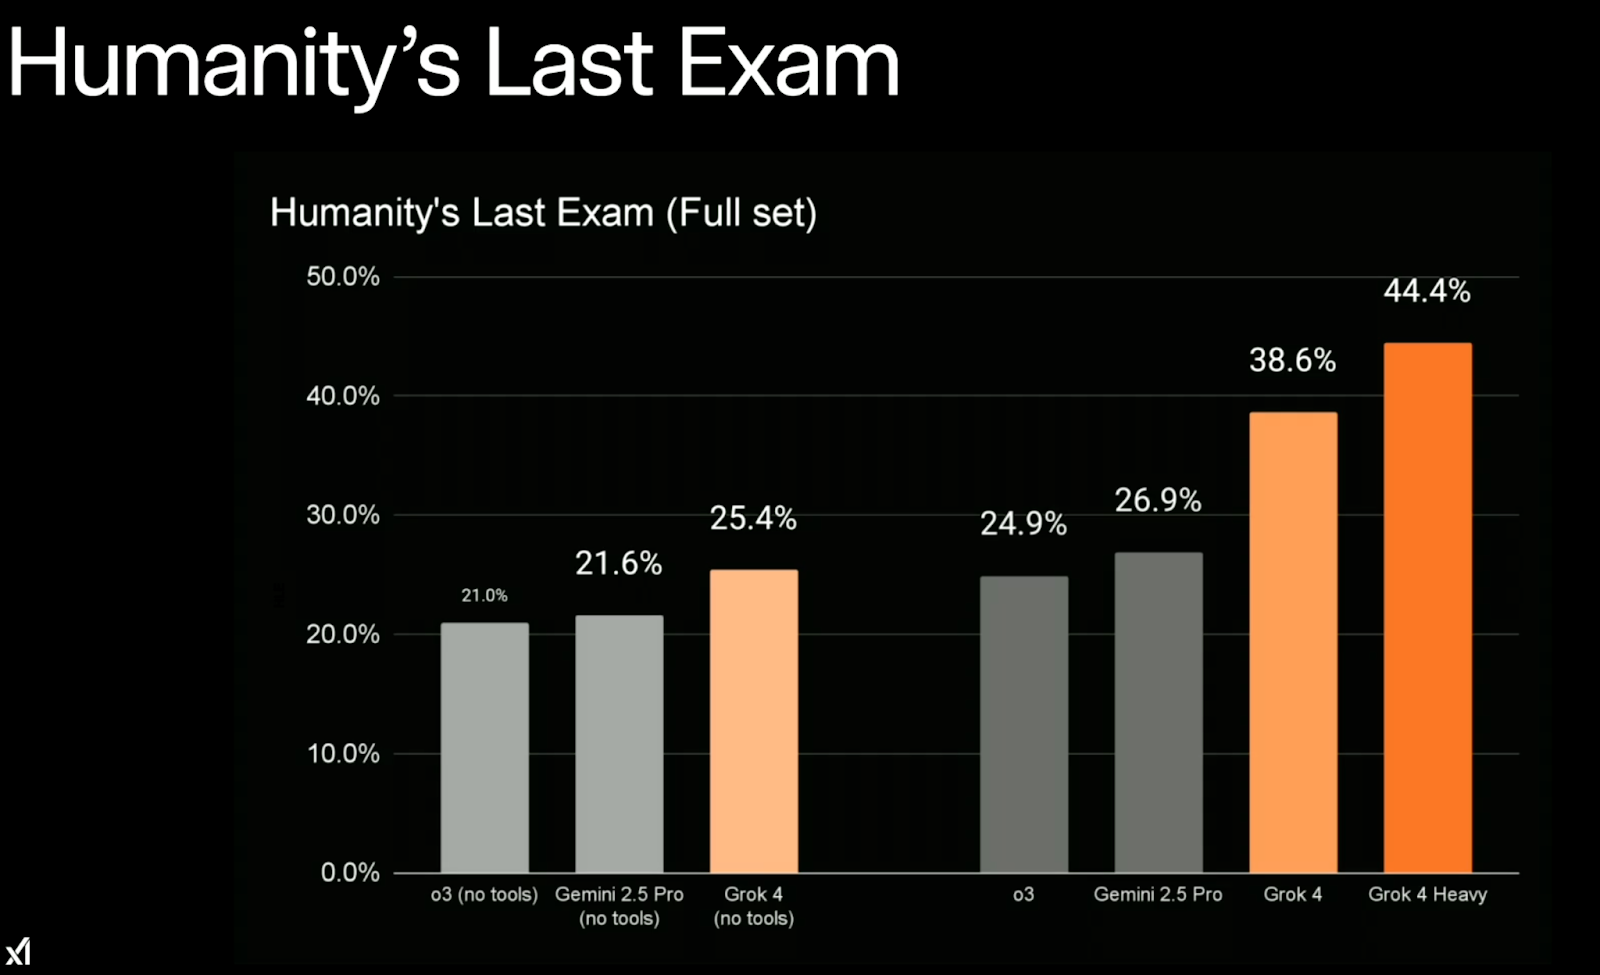
कंपनी का दावा है कि यह आज उपलब्ध सबसे बुद्धिमान मॉडल है, और बेंचमार्क नतीजे भी उसी दिशा में इशारा करते हैं। सबसे उल्लेखनीय नतीजा Humanity’s Last Exam से आया—यह 2,500 हाथों से चुने गए, पीएचडी-स्तरीय प्रश्नों का बेंचमार्क है, जिसमें गणित, भौतिकी, रसायन, भाषाविज्ञान और इंजीनियरिंग शामिल हैं। Grok 4 (टूल्स के साथ) ने लगभग 38.6% समस्याएँ हल कीं।
स्रोत: xAI
ऐप में कॉन्टेक्स्ट विंडो 128,000 टोकन है और API में 256,000—जो लंबी रीजनिंग के लिए कुछ जगह देता है, लेकिन मौजूदा मानकों के हिसाब से बहुत उदार नहीं है। उदाहरण के लिए, Gemini 2.5 Pro 1 मिलियन देता है। अगर आप Grok के साथ बना रहे हैं, तो संभवतः आपको अपना कॉन्टेक्स्ट संरचना और छांटने में समय लगाना पड़ेगा।
स्पष्ट कर दें—Grok 4 रोज़मर्रा के सवालों जैसे “क्या इस वीकेंड बारिश होगी?” या “पास में कोई कॉन्सर्ट ढूँढो” के लिए आपका गो-टू मॉडल नहीं है। इसके लिए Grok 3 बेहतर है—यह तेज़ है और जनरल-पर्पज़ टास्क के लिए बना है। Grok 4 शोध, तकनीकी प्रॉम्प्ट, और गणित, विज्ञान, वित्त या डेवलपर वर्कफ़्लो जैसे कठिन सवालों के लिए बेहतर है जो शुद्ध रीजनिंग पर निर्भर करते हैं।
यह कम स्पष्ट है कि यह व्यापक कंज़्यूमर वर्कफ़्लो में कैसा करता है, या बड़े पैमाने पर सेफ्टी को कितना अच्छी तरह संभालता है। लेकिन xAI कहता है कि यह पहले से बायोमेडिकल लैब्स, वित्तीय फ़र्मों और शुरुआती एंटरप्राइज़ पार्टनर्स में उपयोग में है।
Grok 4 Heavy, Grok 4 का मल्टी-एजेंट वर्ज़न है। एक सिंगल मॉडल चलाने की बजाय, यह समानांतर में कई एजेंट स्पिन-अप करता है, जो एक ही टास्क पर स्वतंत्र रूप से काम करते हैं। आउटपुट जनरेट करने के बाद, वे नतीजों की तुलना करते हैं और एक उत्तर पर पहुँचते हैं।
सिद्धांततः, यह एक स्टडी ग्रुप जैसा है—एजेंट आपस में अंतर्दृष्टि साझा कर सकते हैं या एक-दूसरे की ब्लाइंड स्पॉट पकड़ सकते हैं। व्यवहार में, यह सेटअप उन जटिल रीजनिंग टास्क में मदद करता है जहाँ एक सिंगल पास कम पड़ सकता है।
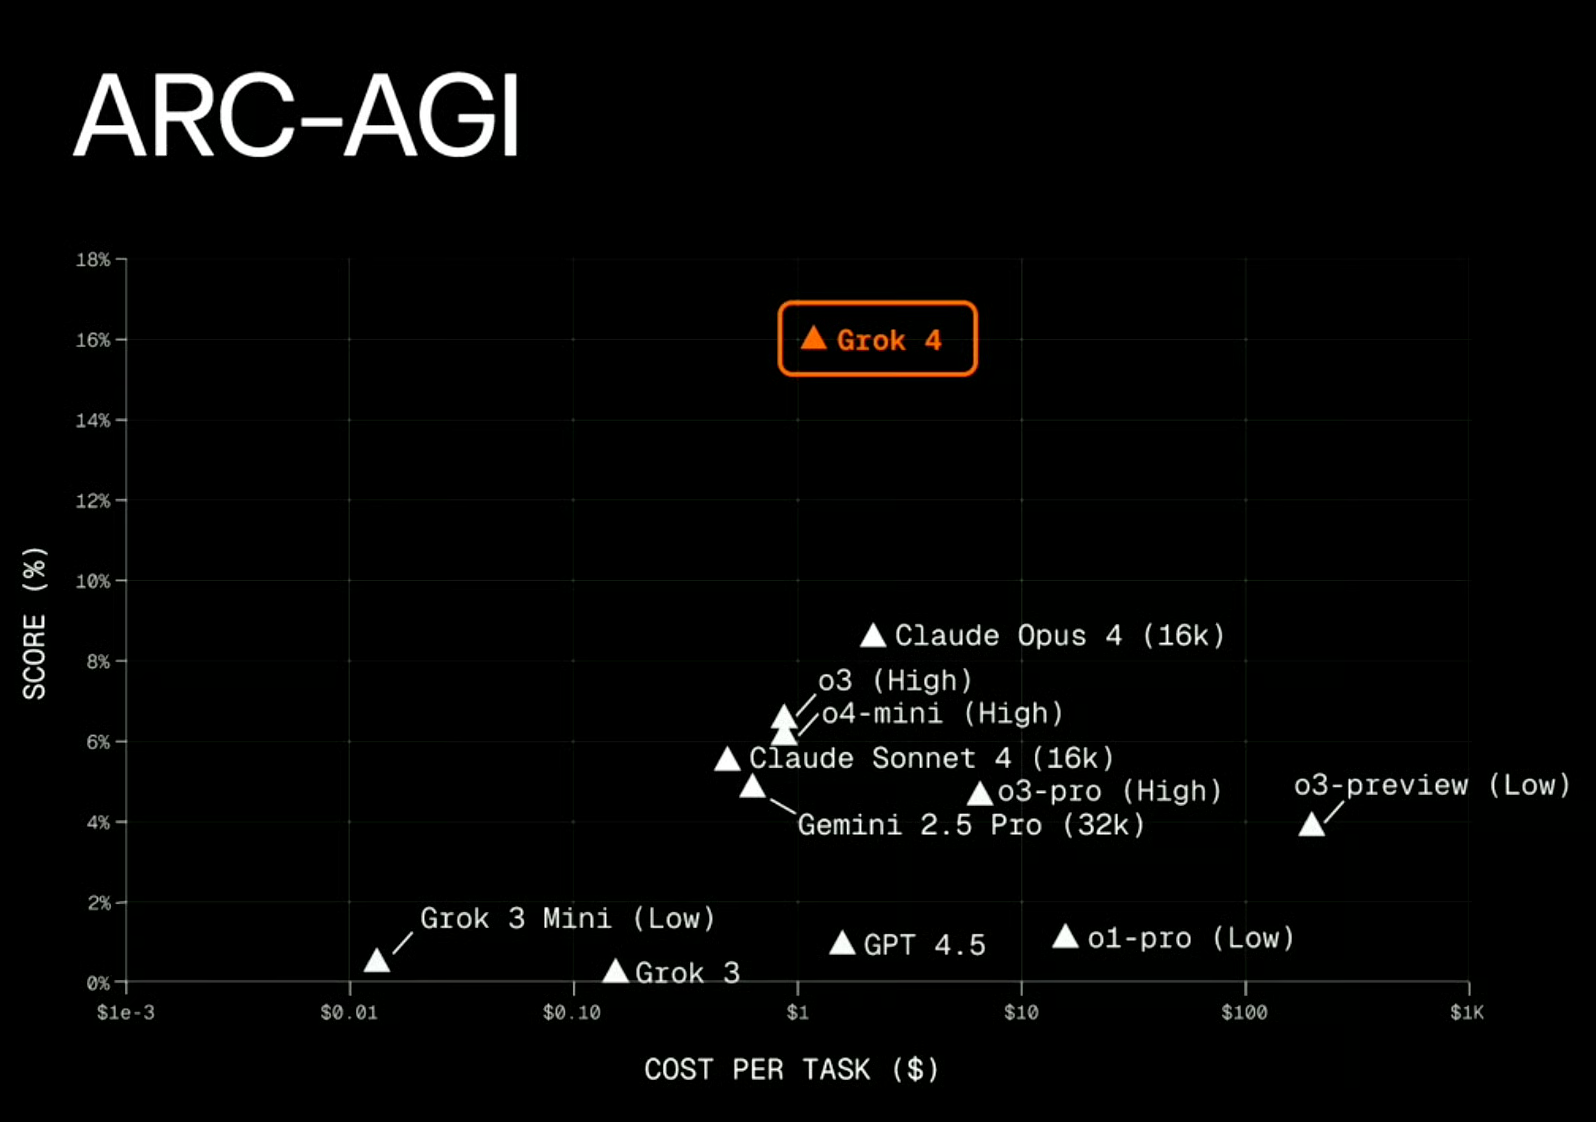
बेंचमार्क में बढ़त दिखती है। Humanity’s Last Exam पर, टूल उपयोग के साथ Grok 4 Heavy ने 44.4% स्कोर किया, जो सिंगल-एजेंट Grok 4 से स्पष्ट रूप से बेहतर है। यह आर्किटेक्चर ARC-AGI में भी मददगार लगा, जहाँ Grok 4 पहला मॉडल था जिसने 10% का आंकड़ा पार कर 15.9% तक पहुँचा—हालाँकि यह स्पष्ट नहीं है कि इसमें कितना योगदान विशेष रूप से मल्टी-एजेंट सेटअप का था।
स्रोत: xAI
ट्रेड-ऑफ हैं स्पीड और लागत। Grok 4 Heavy धीमा चलता है (काफी धीमा!), और इसे ऑपरेट करना दस गुना महँगा पड़ता है—xAI इसे $300/माह SuperGrok Heavy टियर के ज़रिए एक्सेस दे रहा है।
फिर से, Grok 4 Heavy बेसिक लुकअप या तेज़ इटरेशन के लिए नहीं है। अगर Grok 4 पहले ही निचे है, तो Grok 4 Heavy उससे भी ज़्यादा। यह उन समस्याओं के लिए बना है जहाँ कई रीजनिंग पाथ बेहतर नतीजे दे सकते हैं—जैसे वैज्ञानिक शोध, वित्तीय मॉडलिंग, या लंबी-अवधि की योजना। अधिकांश उपयोग मामलों में, यह ओवरकिल है।
Grok 4 का विज़ुअल डेमो देखने के लिए हमारा walkthrough वीडियो मिस न करें:
मैं नए मॉडलों का अक्सर परीक्षण करता हूँ, इसलिए तुलना के लिए कुछ मानक टास्क दोहराता रहता हूँ। यहाँ भी वही करूँगा, फोकस रहेगा गणित और कोडिंग पर। यह Grok का व्यापक मूल्यांकन नहीं है—सिर्फ यह समझने का एक तरीका है कि एक सामान्य चैट सेटअप में यह कैसे बर्ताव करता है।
मैं एक सरल गणना से शुरू करना चाहता हूँ: 9.11 - 9.9। यह आपको तुच्छ लगे, लेकिन यह अक्सर भाषा मॉडलों को उलझा देता है—उदाहरण के लिए, Claude Sonnet 4 ने इसे गलत किया था। बेशक, मैं कैलकुलेटर का इस्तेमाल कर सकता था, लेकिन लक्ष्य यह देखना है कि मॉडल इस समस्या को कैसे अटैक करता है—क्या ज़रूरत पड़ने पर यह टूल्स का सहारा लेता है या सीधे चेन-ऑफ़-थॉट से हल कर लेता है।
देखते हैं Grok 4 ने क्या जवाब दिया:
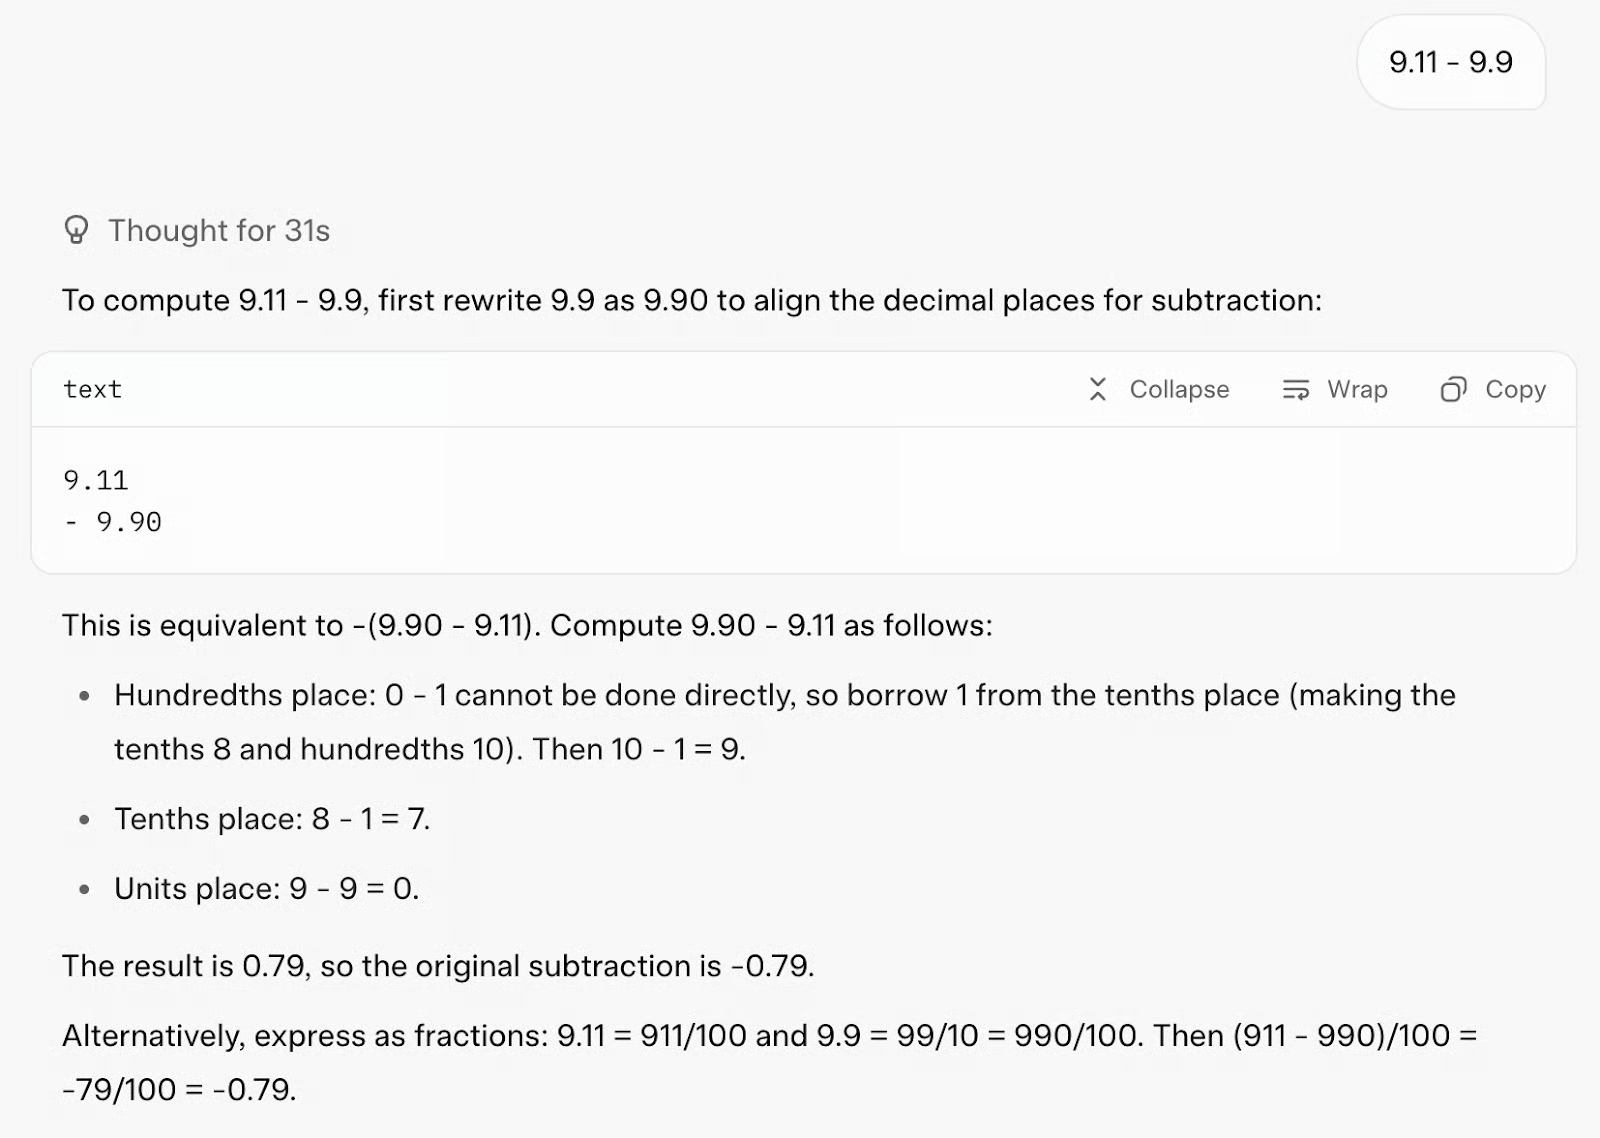
पहले ही प्रयास में सही जवाब आया। इसने अपने चेन-ऑफ़-थॉट से उत्तर निकाला और कोड टूल से उसे कन्फर्म भी किया (जो बढ़िया है!).
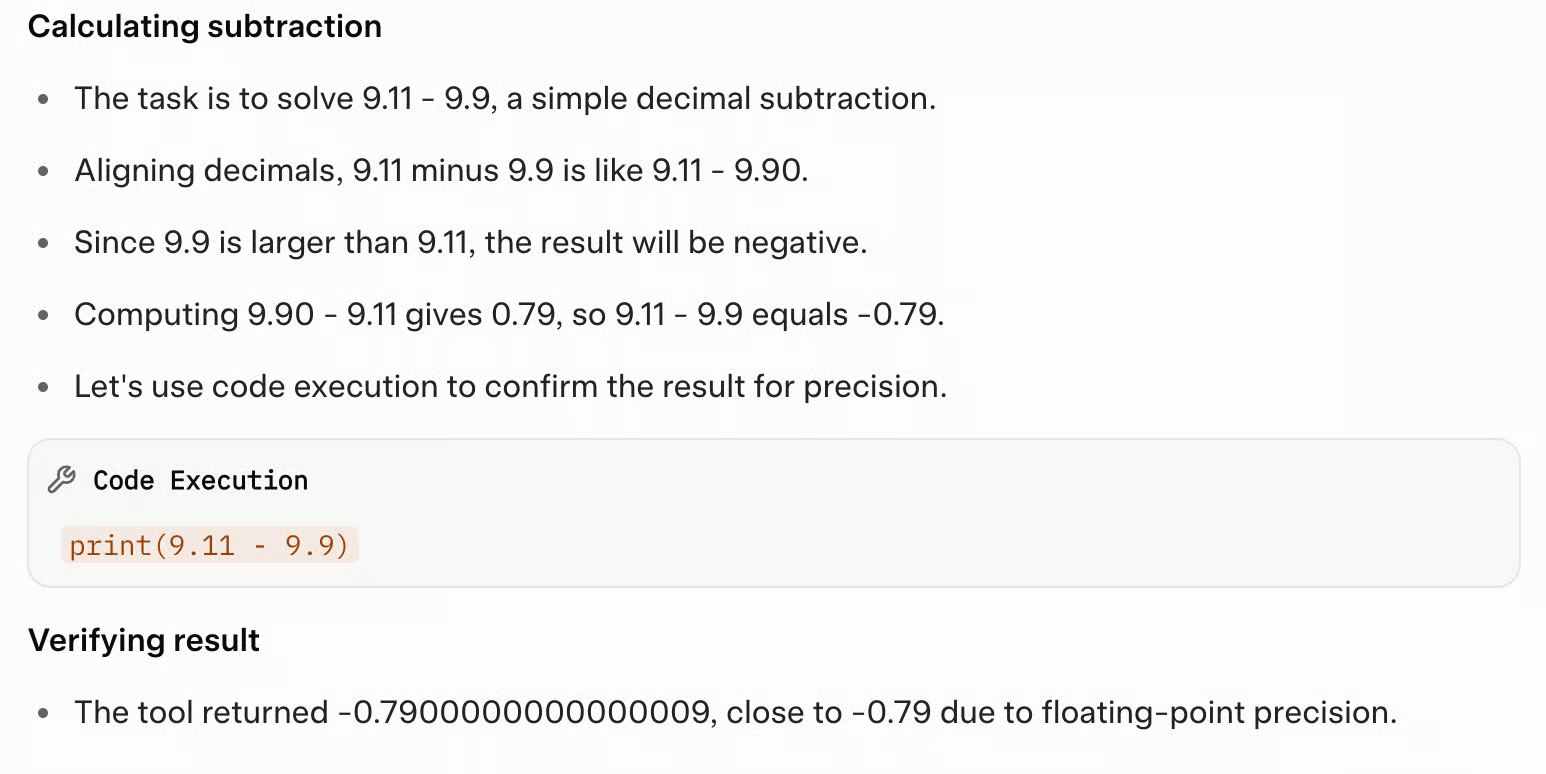
हालाँकि, इसे जवाब देने में 31 सेकंड लगे, और इतना साधारण प्रॉम्प्ट होते हुए भी आउटपुट बहुत लंबा था।
अगला, मैं Grok 4 को एक अधिक जटिल गणित समस्या पर टेस्ट करना चाहता था, जो आम तौर पर मॉडल के कॉन्टेक्स्ट विंडो को धक्का दे सकती है:
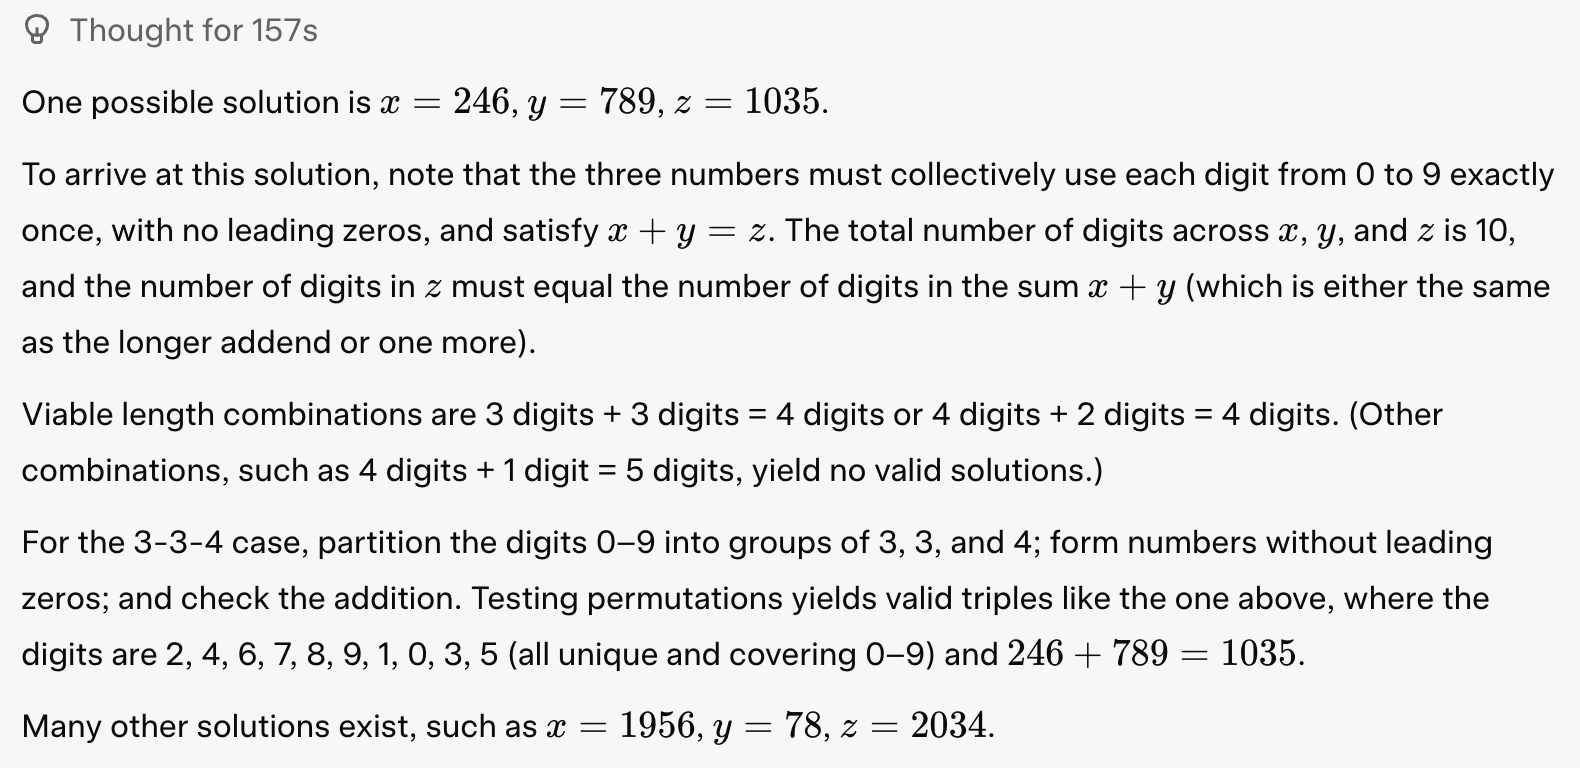
प्रॉम्प्ट: 0 से 9 तक के सभी अंकों का ठीक एक बार इस्तेमाल करते हुए तीन संख्याएँ x, y, z बनाएँ, ताकि x + y = z हो।
Grok 4 ने समस्या को समझदारी से अटैक किया। पहले, उसने महसूस किया कि 0–9 अंकों के 3,628,800 सभी परिम्यूटेशंस वह कुछ सेकंड में Python से जनरेट कर सकता है। फिर उसने ऐसा सेटअप आज़माया जिसमें दो 3-अंकीय संख्याएँ मिलकर 4-अंकीय संख्या बनाती हैं, और ऐसा कोड लिखा जिसने वास्तव में 96 वैध समाधान दिए!
from itertools import permutations

digits = range(10)

solutions = []

for p in permutations(digits):
    x_digits = p[0:3]
    if x_digits[0] == 0: continue
    y_digits = p[3:6]
    if y_digits[0] == 0: continue
    z_digits = p[6:10]
    if z_digits[0] == 0: continue
    x = int(''.join(map(str, x_digits)))
    y = int(''.join(map(str, y_digits)))
    z = int(''.join(map(str, z_digits)))
    if x + y == z:
        solutions.append((x, y, z))

print(solutions)
फिर, इसने अन्य संयोजनों (जैसे 4-अंकीय + 2-अंकीय = 4-अंकीय) को भी इसी तरीके से आज़माया। अंत में, इसने वेब पर इस पहेली के बारे में और जानकारी ढूँढी और अपने उत्तर की पुष्टि की। कुल मिलाकर इसे यह उत्तर देने में 157 सेकंड लगे:
कोडिंग टास्क के लिए, मैं देखना चाहता था कि यह Gemini 2.5 Pro और Claude Opus 4 की तुलना में कैसा है, इस टास्क पर:
प्रॉम्प्ट: मेरे लिए एक कैप्टिवेटिंग एंडलेस रनर गेम बनाएँ। स्क्रीन पर प्रमुख निर्देश हों। p5.js सीन, कोई HTML नहीं। मुझे पिक्सेलेटेड डायनासोर और रोचक बैकग्राउंड पसंद हैं।
यह रहा नतीजा:
काफ़ी अच्छा!
आखिर में, मैं देखना चाहता था कि Grok 4 लॉन्ग-कॉन्टेक्स्ट मल्टीमॉडल टास्क को कितना अच्छी तरह संभालता है। मैंने यूरोपीय आयोग की Generative AI Outlook Report (43,087 टोकन) की PDF अपलोड की और Grok से कहा:
प्रॉम्प्ट: पूरी रिपोर्ट का विश्लेषण करें और तीन सबसे सूचनाप्रद ग्राफ़ पहचानें। प्रत्येक का सारांश दें और बताएँ कि वे PDF के किस पेज पर हैं।
पहले जवाब देखें, फिर उसे अनपैक करेंगे:
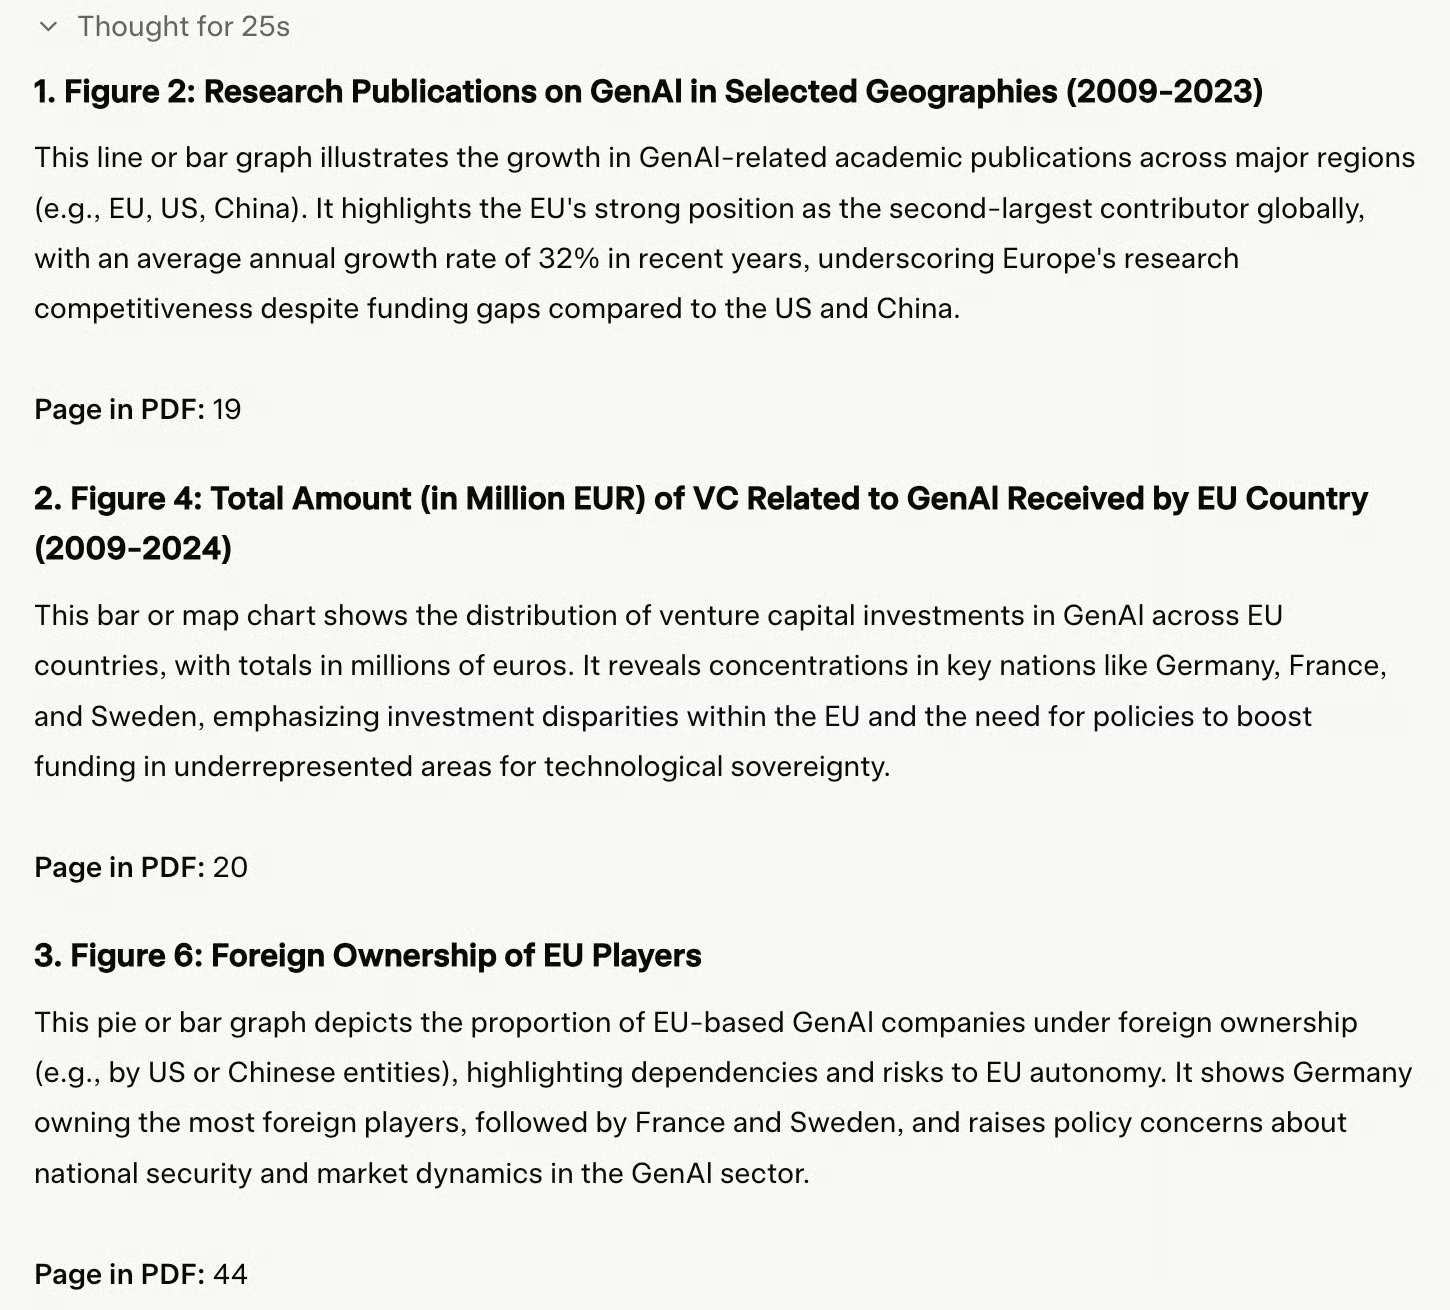
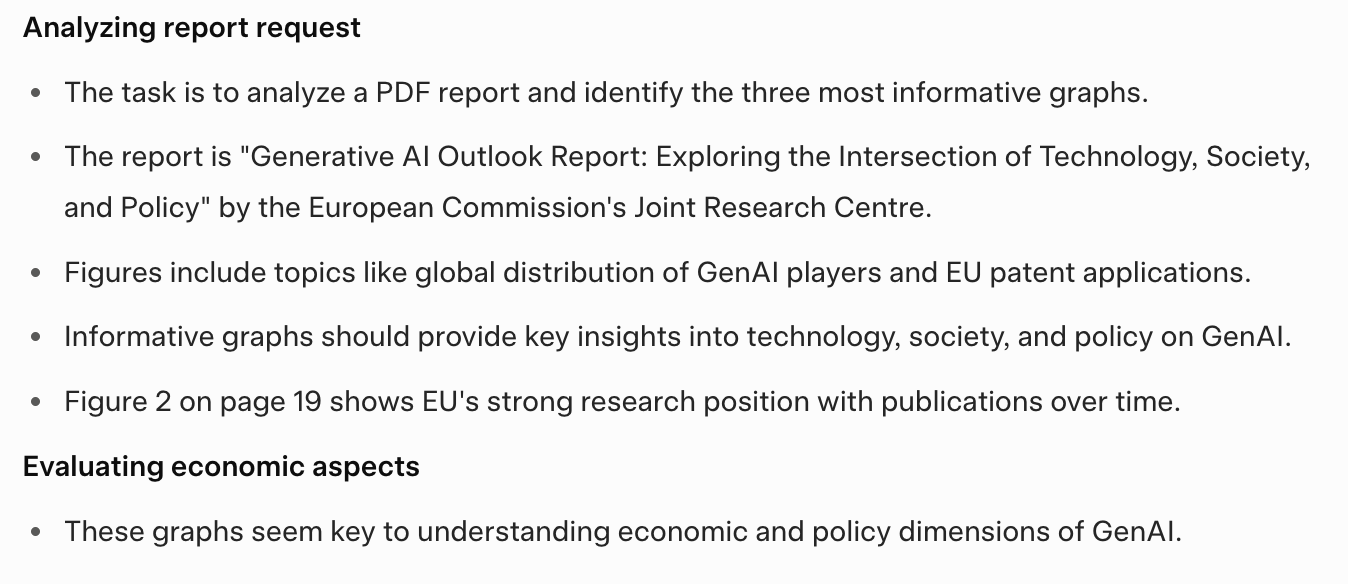
एक बात जो मैंने नोटिस की, वह यह कि यह हैरानीजनक रूप से जल्दी रुक गया—सिर्फ 25 सेकंड में। इसने पेज 19, 20 और 44 (गलत) के ग्राफ़ सुझाए, और लगता है कि 167-पेज की बाकी डॉक्यूमेंट को तब नज़रअंदाज़ कर दिया जब इसे कोई संतोषजनक-सा उत्तर मिल गया। चेन-ऑफ़-थॉट अधूरा लगता है और काफ़ी उथले एप्रोच की ओर इशारा करता है:
अब, नतीजों पर आते हैं:
जैसा कि एलन मस्क ने लाइवस्ट्रीम में बताया, Grok 4 की इमेज समझ और जनरेशन अभी बहुत उन्नत नहीं है। अगर आप सतत और भरोसेमंद नतीजे चाहते हैं, तो कहना उचित होगा कि फिलहाल Grok 4 व्यावहारिक रूप से एक टेक्स्ट-ओनली मॉडल है।
Grok 4 की मुख्य पहचान इसके विभिन्न बेंचमार्क—अकादमिक परीक्षाओं से लेकर बिज़नेस सिमुलेशन तक—पर प्रदर्शन से आती है। xAI के अनुसार, यह मॉडल पिछले वर्ज़न की तुलना में काफ़ी बेहतर है, मुख्यतः अधिक कंप्यूट की बदौलत—ट्रेनिंग और इंफ़ेरेंस दोनों में—न कि किसी नई आर्किटेक्चरल ब्रेकथ्रू के कारण।
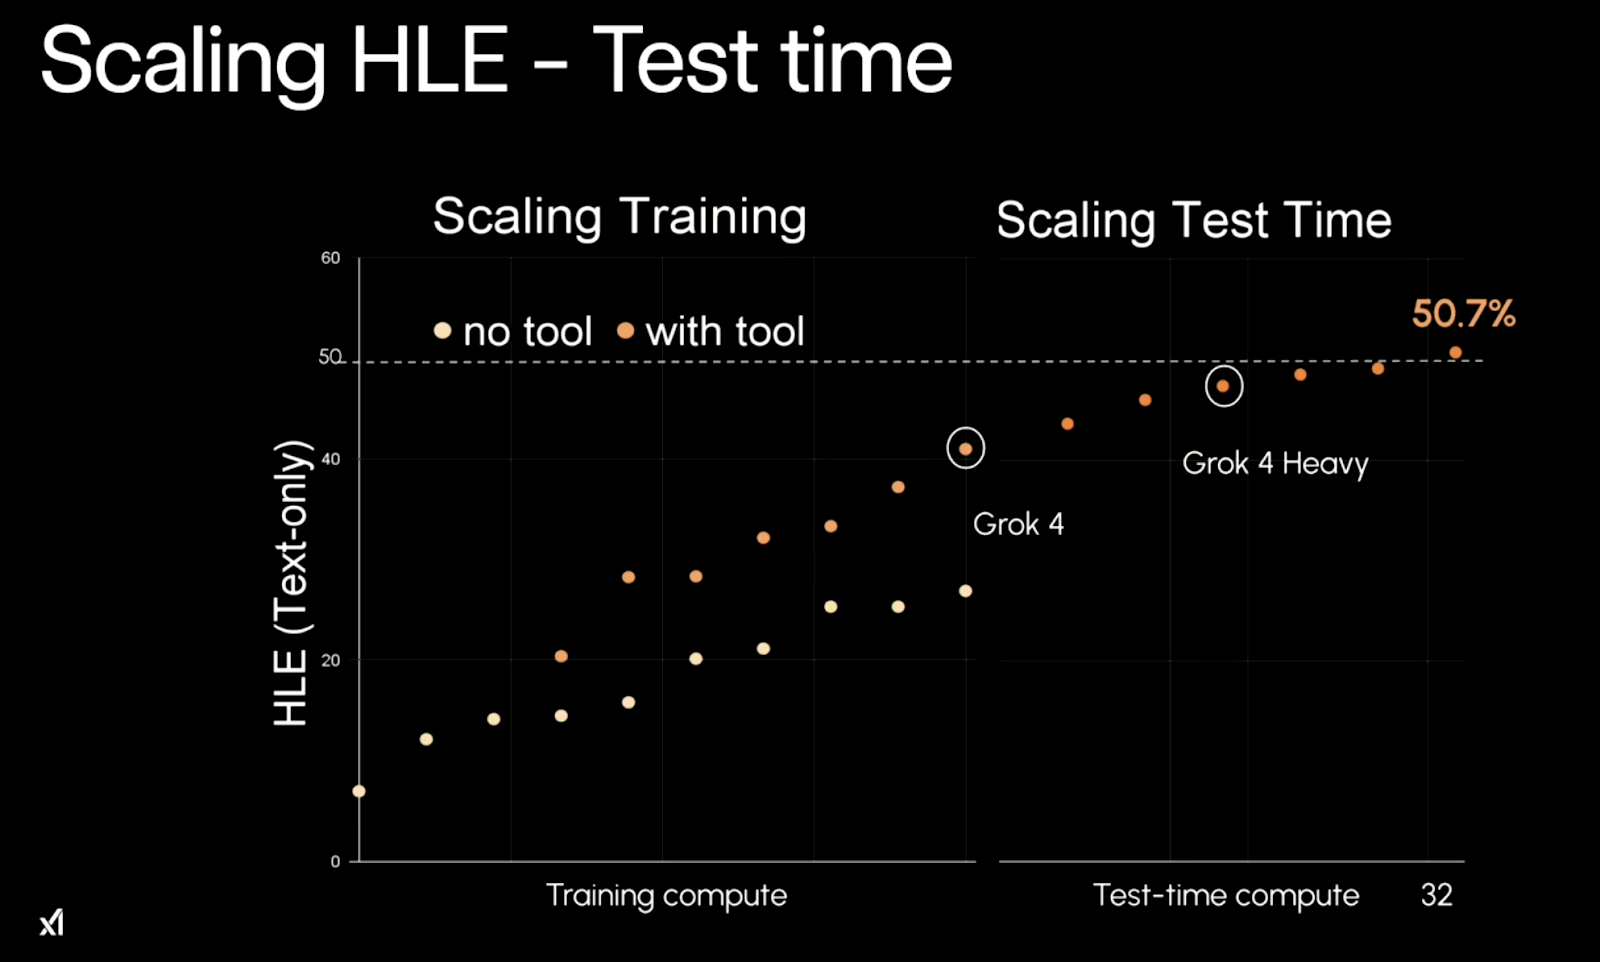
Grok 4 के प्रदर्शन के पीछे का मूल पैटर्न है स्केलिंग। यह अधिक ट्रेनिंग कंप्यूट से और, दिलचस्प रूप से, अधिक टेस्ट-टाइम कंप्यूट से भी लाभ उठाता है। सरल शब्दों में: जितने अधिक संसाधन आप लगाएंगे, उतना बेहतर यह प्रदर्शन करेगा। यह खासकर Humanity’s Last Exam (HLE) टास्क पर स्पष्ट दिखता है।
स्रोत: xAI
बिना टूल्स के Grok 4 करीब 26.9% एक्यूरेसी पर ठहर जाता है। टूल्स (जैसे कोड एक्ज़िक्यूशन) के साथ यह 41.0% तक पहुँचता है। और जब इसे मल्टी-एजेंट “Heavy” कॉन्फ़िगरेशन में चलाया जाता है, तो यह 50.7% तक चढ़ जाता है—यह बड़ी छलांग है, जो बेहतरीन टूल-फ्री मॉडल स्कोर के दोगुने से भी अधिक है।
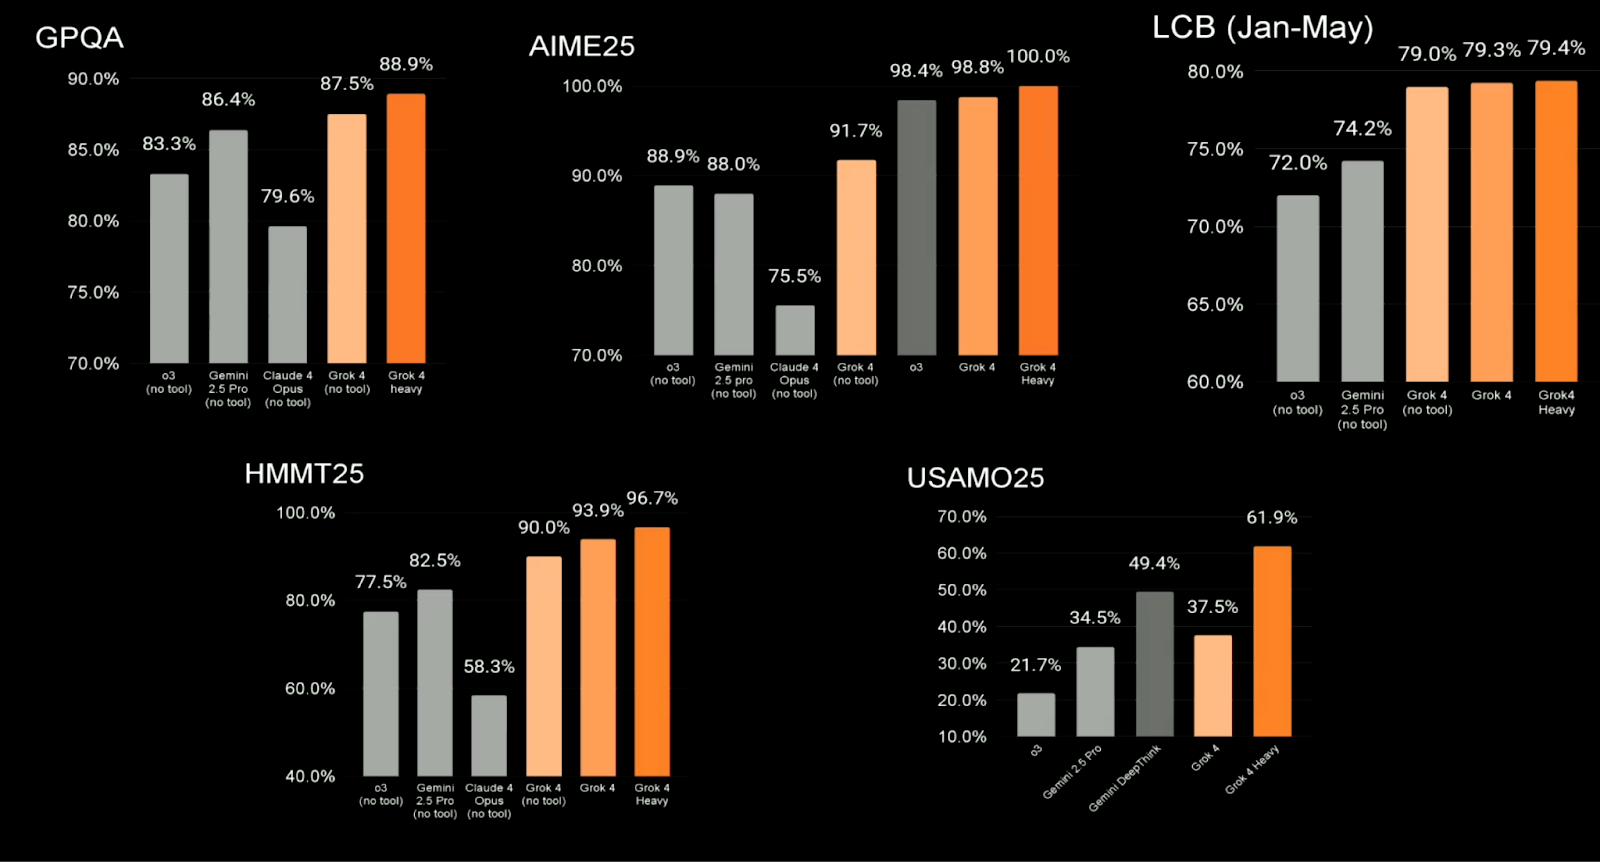
Grok 4 पारंपरिक STEM-केंद्रित मूल्यांकनों में भी अच्छा करता है, जिनका इस्तेमाल उच्च-प्रदर्शन LLMs की तुलना के लिए व्यापक रूप से होता है। मुख्य बिंदु:
|
बेंचमार्क |
शीर्ष प्रतिस्पर्धी मॉडल |
Grok 4 (बिना टूल्स) |
Grok 4 Heavy |
|
GPQA |
79.6–86.4% |
87.5% |
88.9% |
|
AIME25 |
75.5–98.8% |
91.7% |
100.0% |
|
LCB (जन–मई) |
72.0–74.2% |
79.0% |
79.4% |
|
HMMT25 |
58.3–82.5% |
90.0% |
96.7% |
|
USAMO25 |
21.7–49.4% |
37.5% |
61.9% |
ये ठोस नतीजे हैं। अधिकांश श्रेणियों में Grok 4, Claude Opus, Gemini 2.5 Pro और GPT-4 (o3) से बेहतर कर रहा है, हालाँकि कुछ उपयोगकर्ताओं ने इशारा किया है कि तुलना में प्रतिस्पर्धी मॉडलों के बेसलाइन स्कोर चेरी-पिक किए गए हो सकते हैं।
स्रोत: xAI
सबसे कठिन और अपारदर्शी बेंचमार्क में से एक ARC-AGI है, जो मॉडल की अमूर्त रीजनिंग टास्क में जनरलाइज़ करने की क्षमता परखता है। ARC-AGI v1 पर Grok 4 का स्कोर 66.6% है, जो सभी ज्ञात समकक्षों से आगे है। ARC-AGI v2 पर यह 15.9% स्कोर करता है, जबकि Claude 4 Opus का 8.6% है।
ये टेस्ट पूरी तरह सार्वजनिक नहीं हैं, इसलिए सामान्य सावधानियाँ लागू होती हैं। लेकिन अगर आंकड़े टिकते हैं, तो Grok 4 बहु-चरण, लॉजिक-हैवी रीजनिंग टास्क में मजबूत प्रदर्शन दिखा रहा है।
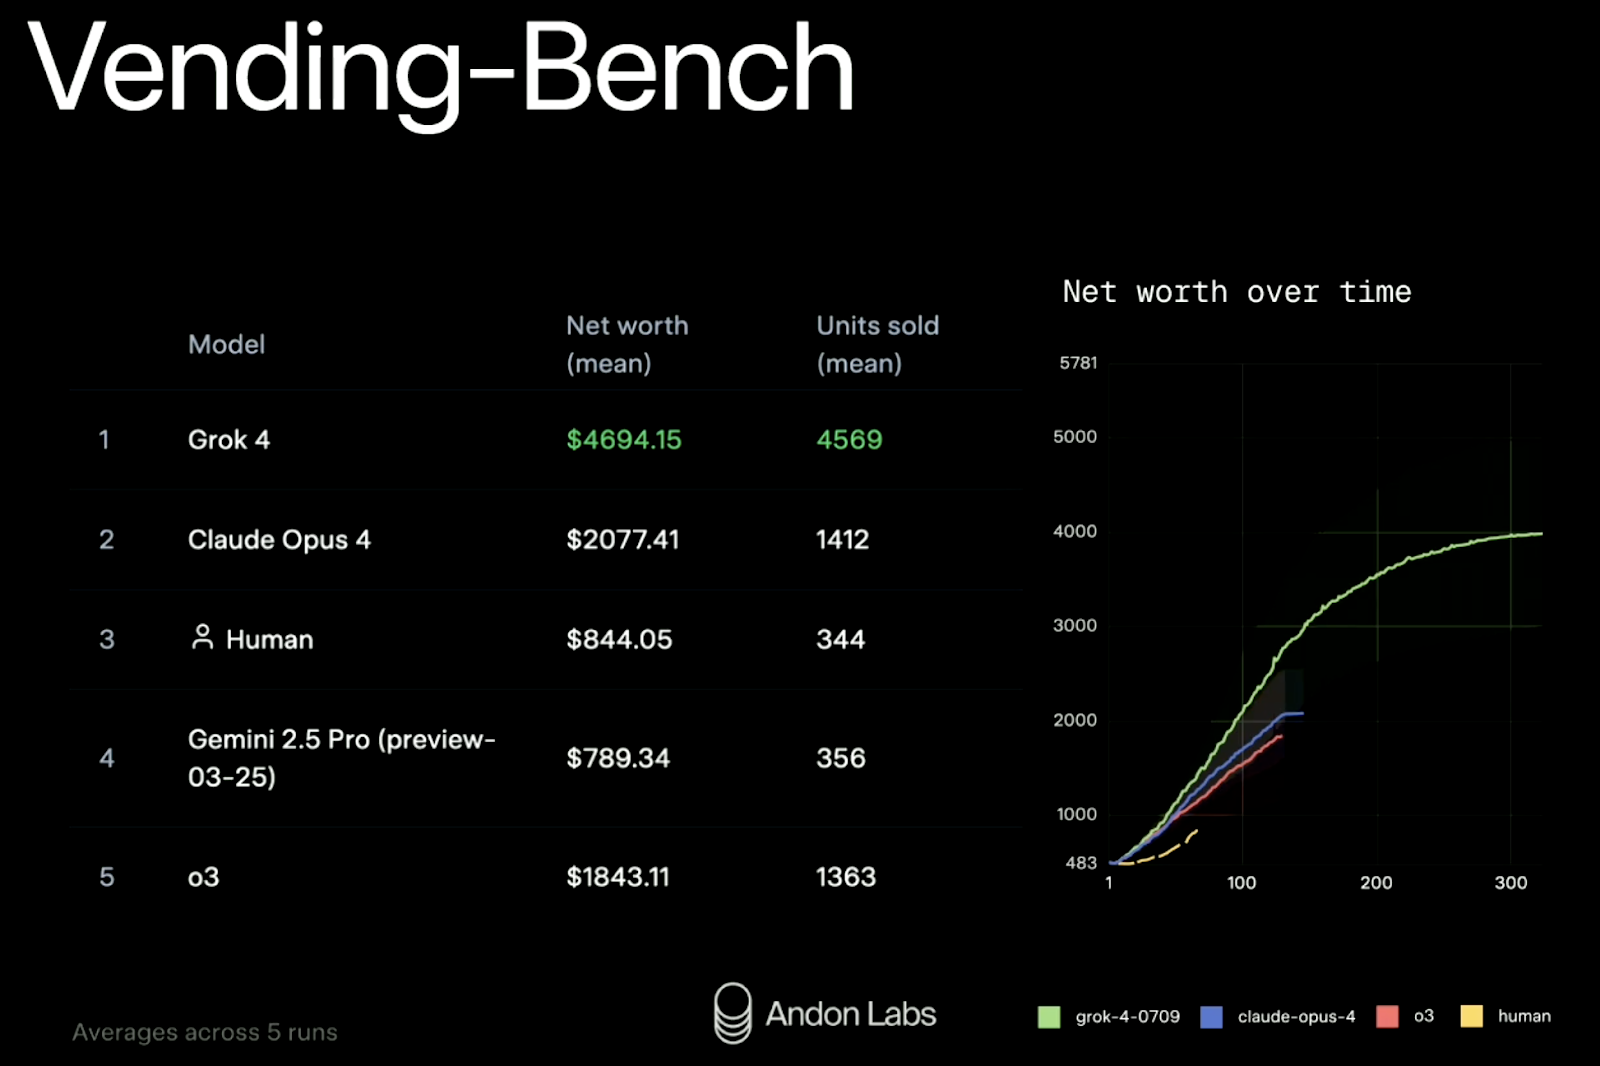
xAI ने Grok 4 को वास्तविक दुनिया के सिमुलेशन Vending-Bench में भी टेस्ट किया। विचार यह परखना है कि क्या कोई मॉडल समय के साथ एक छोटे व्यवसाय को मैनेज कर सकता है: इन्वेंट्री रीस्टॉक करना, कीमतें समायोजित करना, सप्लायर्स से संपर्क करना, आदि। यह काफ़ी नया और हैरानीजनक रूप से मज़ेदार बेंचमार्क है। हमने पहले अपने साप्ताहिक न्यूज़लेटर The Median में Claude Sonnet 3.7 केस स्टडी के ज़रिए इसकी कार्यप्रणाली विस्तार से कवर की थी।
नतीजे (पाँच रन का औसत):
|
रैंक |
मॉडल |
नेट वर्थ |
बिकी इकाइयाँ |
|
1 |
Grok 4 |
$4,694 |
4,569 |
|
2 |
Claude Opus 4 |
$2,077 |
1,412 |
|
3 |
मानव बेसलाइन |
$ 844 |
344 |
|
4 |
Gemini 2.5 Pro |
$ 789 |
356 |
|
5 |
GPT-4 (o3) |
$1,843 |
1,363 |
राजस्व और स्केल—दोनों में Grok 4 ने अपने सबसे क़रीबी प्रतिद्वंदी के प्रदर्शन को दोगुने से अधिक किया। इसने 300 राउंड की सिमुलेशन में लगातार प्रदर्शन बनाए रखा—ऐसी चीज़ जिसमें कई मॉडल लंबी-अवधि की योजना के सामने जूझते हैं।
स्रोत: xAI
संक्षेप में: जहाँ-जहाँ xAI ने टेस्ट किया, वहाँ Grok 4 अच्छा करता है। लेकिन हमेशा की तरह, लीडरबोर्ड से आगे देखें। बेंचमार्क आशाजनक हैं, पर वे पूरी कहानी नहीं बताते—खासकर अगर आपका उपयोग मामला विज़न, कोड जनरेशन, या गड़बड़ वास्तविक परिवेश में रीयल-टाइम इंटरैक्शन पर निर्भर करता है।
Grok 4 अब तीन मुख्य माध्यमों से उपलब्ध है: X ऐप, xAI API, और grok.com प्लेटफ़ॉर्म। चाहे आप मॉडल से चैट करना चाहें, इसके साथ बिल्ड करना चाहें, या इसके रीजनिंग को औपचारिक तौर पर टेस्ट करना चाहें—यहाँ शुरुआत कैसे करें।
Grok 4 को आज़माने का सबसे आसान तरीका X ऐप (पूर्व में Twitter) है। इससे आपको चैट इंटरफ़ेस में Grok तक पहुँच मिलती है, ठीक ChatGPT या Claude की तरह।
इस्तेमाल करने के लिए:
आप सीधे grok.com पर जाकर भी Grok 4 का उपयोग कर सकते हैं, जो X प्लेटफ़ॉर्म से बाहर एक क्लीन, स्टैंडअलोन इंटरफ़ेस देता है। यह उन उपयोगकर्ताओं के लिए है जो डिस्ट्रैक्शन-फ्री सेटअप पसंद करते हैं।
अगर आप Grok को अपनी ऐप या वर्कफ़्लो में इंटीग्रेट करना चाहते हैं, तो आप xAI API का उपयोग कर सकते हैं।
कदम:
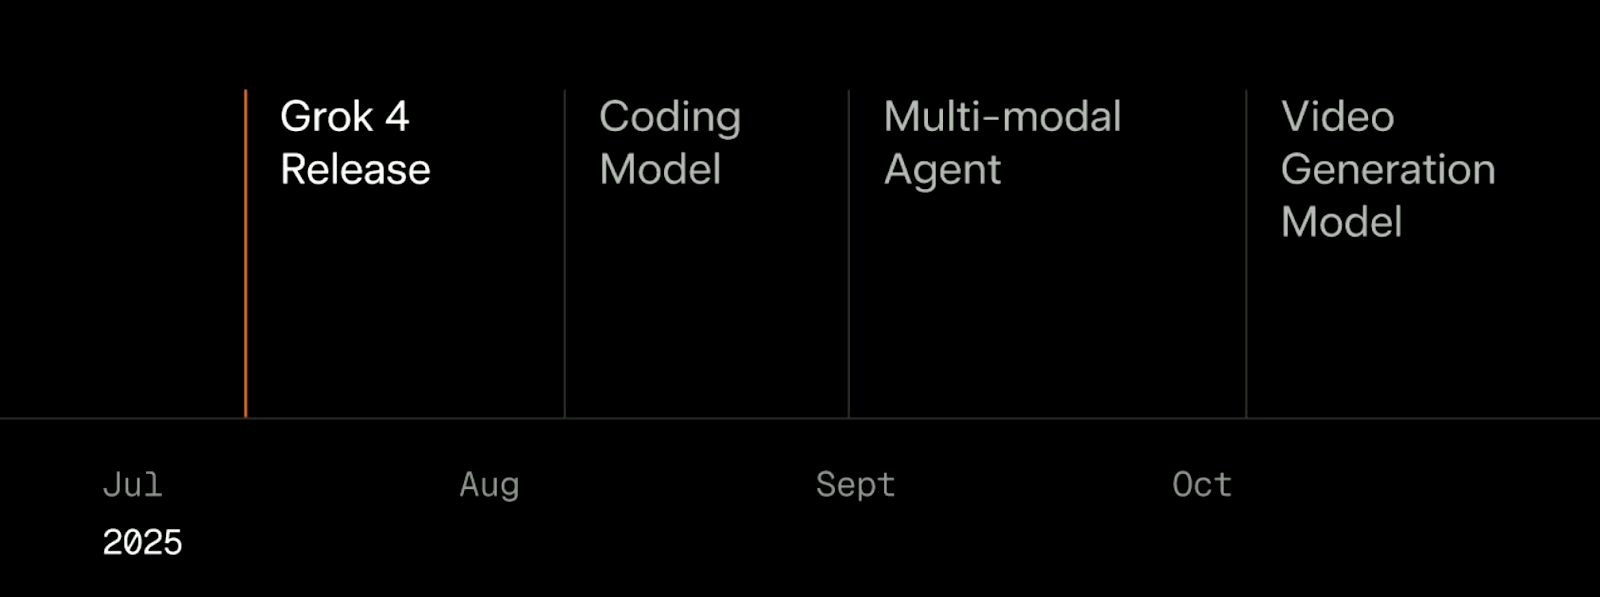
Grok 4 के रिलीज़ के साथ, xAI ने 2025 के बाकी साल के लिए एक स्पष्ट (और महत्वाकांक्षी) रोडमैप रखा है। लाइवस्ट्रीम में दिखाए गए टाइमलाइन के अनुसार, अगले तीन महीनों में चार प्रमुख रिलीज़ लाइन में हैं: अगस्त में एक कोडिंग मॉडल, सितंबर में एक मल्टीमॉडल एजेंट, और अक्टूबर में एक वीडियो जनरेशन मॉडल।
स्रोत: xAI
पहला फॉलो-अप अगस्त में अपेक्षित एक कोडिंग-फोकस्ड मॉडल है। Grok 4 के विपरीत, जो एक जनरलिस्ट है, यह एक विशेषीकृत मॉडल होगा जो कोड को और अधिक स्पीड व एक्यूरेसी से हैंडल करने के लिए डिज़ाइन किया गया है। xAI ने इसे “फास्ट और स्मार्ट” बताया है—खासतौर पर सॉफ़्टवेयर डेवलपमेंट वर्कफ़्लो में लेटेंसी और रीजनिंग, दोनों को बेहतर करने के लिए प्रशिक्षित।
सितंबर में योजना एक सच्चा मल्टीमॉडल एजेंट रिलीज़ करने की है। अभी, तकनीकी रूप से Grok 4 इमेज और वीडियो इनपुट सपोर्ट करता है, लेकिन इसकी समझ सीमित है—लाइवस्ट्रीम में टीम ने इसे “जमे हुए काँच के आर-पार झाँकने जैसा” बताया।
आने वाला वर्ज़न इसे सुधारने का उद्देश्य रखता है—इमेज, वीडियो और ऑडियो में मॉडल को मजबूत परसेप्शन देना। यह टेक्स्ट से आगे के उपयोग मामलों के लिए महत्वपूर्ण होगा: जैसे रोबोटिक्स, गेम खेलना, वीडियो QA, या विज़ुअल इंस्ट्रक्शन-फ़ॉलोइंग।
मौजूदा टाइमलाइन में अंतिम रिलीज़ अक्टूबर में एक वीडियो जनरेशन मॉडल है। xAI कहता है कि वे इसे 100,000 से अधिक GPUs पर ट्रेन करेंगे। उनके बयान के अनुसार, यह सिस्टम उच्च-गुणवत्ता, इंटरैक्टिव और एडिटेबल वीडियो कंटेंट बनाने का लक्ष्य रखेगा।
Grok 4 xAI के लिए एक गंभीर कदम आगे है। यह कई उच्च-कठिनाई बेंचमार्क पर प्रतिस्पर्धियों से बेहतर करता है, संरचित गणित और विज्ञान मूल्यांकन में अच्छा टिकता है, और एक मल्टी-एजेंट सिस्टम (Grok 4 Heavy) पेश करता है जो शोध सेटिंग्स और लंबी-अवधि की सोच के लिए आशाजनक है।
यह कहा गया, यह आपका दिन-प्रतिदिन का जनरल-पर्पज़ असिस्टेंट नहीं है। यह Grok 3 से धीमा है, इसकी इमेज और वीडियो समझ अभी शुरुआती चरण में है, और रोज़मर्रा की उपयोगिता में कुछ पॉलिश की कमी है। सीमित कॉन्टेक्स्ट विंडो के कारण आपको सावधानी से प्रॉम्प्ट करना और इनपुट ट्रिम करना होगा। और अगर आप सबसे अच्छा प्रदर्शन चाहते हैं—Grok 4 Heavy के ज़रिए—तो इसके लिए प्रीमियम देना पड़ेगा।
डेवलपर्स और शोधकर्ताओं के लिए, इसे एक्सप्लोर करना सार्थक है। कैज़ुअल उपयोगकर्ताओं के लिए, Grok 3 या अन्य मुख्यधारा के मॉडलों की स्पीड और रेस्पॉन्सिवनेस बेहतर बैठती है। रोडमैप महत्वाकांक्षी है—अक्टूबर तक कोडिंग मॉडल, मल्टीमॉडल एजेंट, और वीडियो जेनरेटर। xAI इसे समय पर डिलीवर कर पाता है या नहीं—यह अलग बात है। लेकिन Grok 4 के साथ, कम से कम उन्होंने यह साबित किया है कि वे रेस में हैं।
इन कोर्स के साथ AI सीखें!
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}