

Khóa học
Giới thiệu về AI Agents
1 giờ 30 phút
147.2K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleSau khi chờ đợi nhiều tháng cho Grok 3.5, xAI đã bỏ qua hoàn toàn và nhảy thẳng lên Grok 4. (Tính đến tháng 11/2025, Grok 4.1 cũng đã ra mắt).
Cú nhảy đó có xứng đáng với hiệu năng của mô hình không?
Có, nếu bạn nhìn vào điểm chuẩn. Hiện tại, trên lý thuyết, Grok 4 có lẽ là mô hình tốt nhất thế giới.
Nhưng với cửa sổ ngữ cảnh 128.000 trong ứng dụng và 256.000 trên API, bạn có thể chật vật khi đưa vào sản xuất thực tế. Nó không “dễ tính” như Gemini 2.5 Pro, vốn cho bạn đủ một triệu token. Nếu muốn dùng Grok 4 cho nhiều hơn một cuộc trò chuyện ngắn, bạn sẽ cần kỹ năng kỹ thuật ngữ cảnh nghiêm túc để vận hành hiệu quả.
Trong bài viết này, tôi sẽ gạt bỏ sự thổi phồng thường thấy và đưa ra một cái nhìn cân bằng bằng cách giải thích điểm mạnh và điểm yếu chính của Grok 4, cùng với kết quả trong các thử nghiệm riêng của tôi.
Chúng tôi luôn cập nhật cho độc giả về những điều mới nhất trong AI qua The Median, bản tin miễn phí mỗi thứ Sáu tóm lược các câu chuyện chính trong tuần. Đăng ký và bắt kịp chỉ trong vài phút mỗi tuần:
Dòng Grok 4 chỉ gồm Grok 4 và Grok 4 Heavy, và không có phiên bản mini để dùng cho suy luận nhanh.
Grok 4 là mô hình một tác tử mới nhất của xAI (khác với Grok 4 Heavy dùng nhiều tác tử—chúng ta sẽ bàn ở phần tiếp theo). Dựa trên livestream, không có điều gì đột phá đặc biệt về mặt kỹ thuật. Những cải thiện dường như đến từ loạt tinh chỉnh nhỏ và tăng đáng kể tài nguyên tính toán, khoảng gấp 10 lần so với Grok 3.
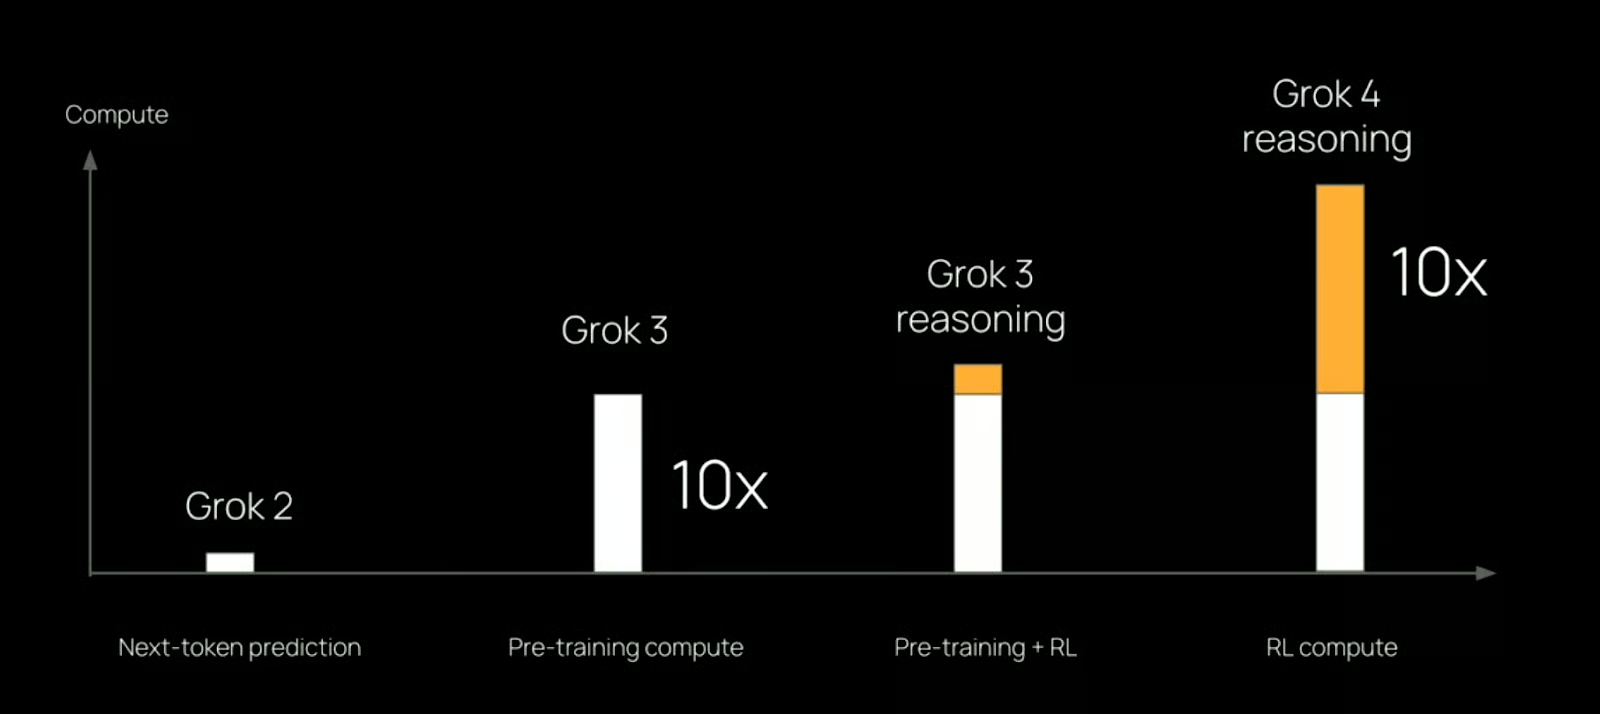
Nguồn: xAI
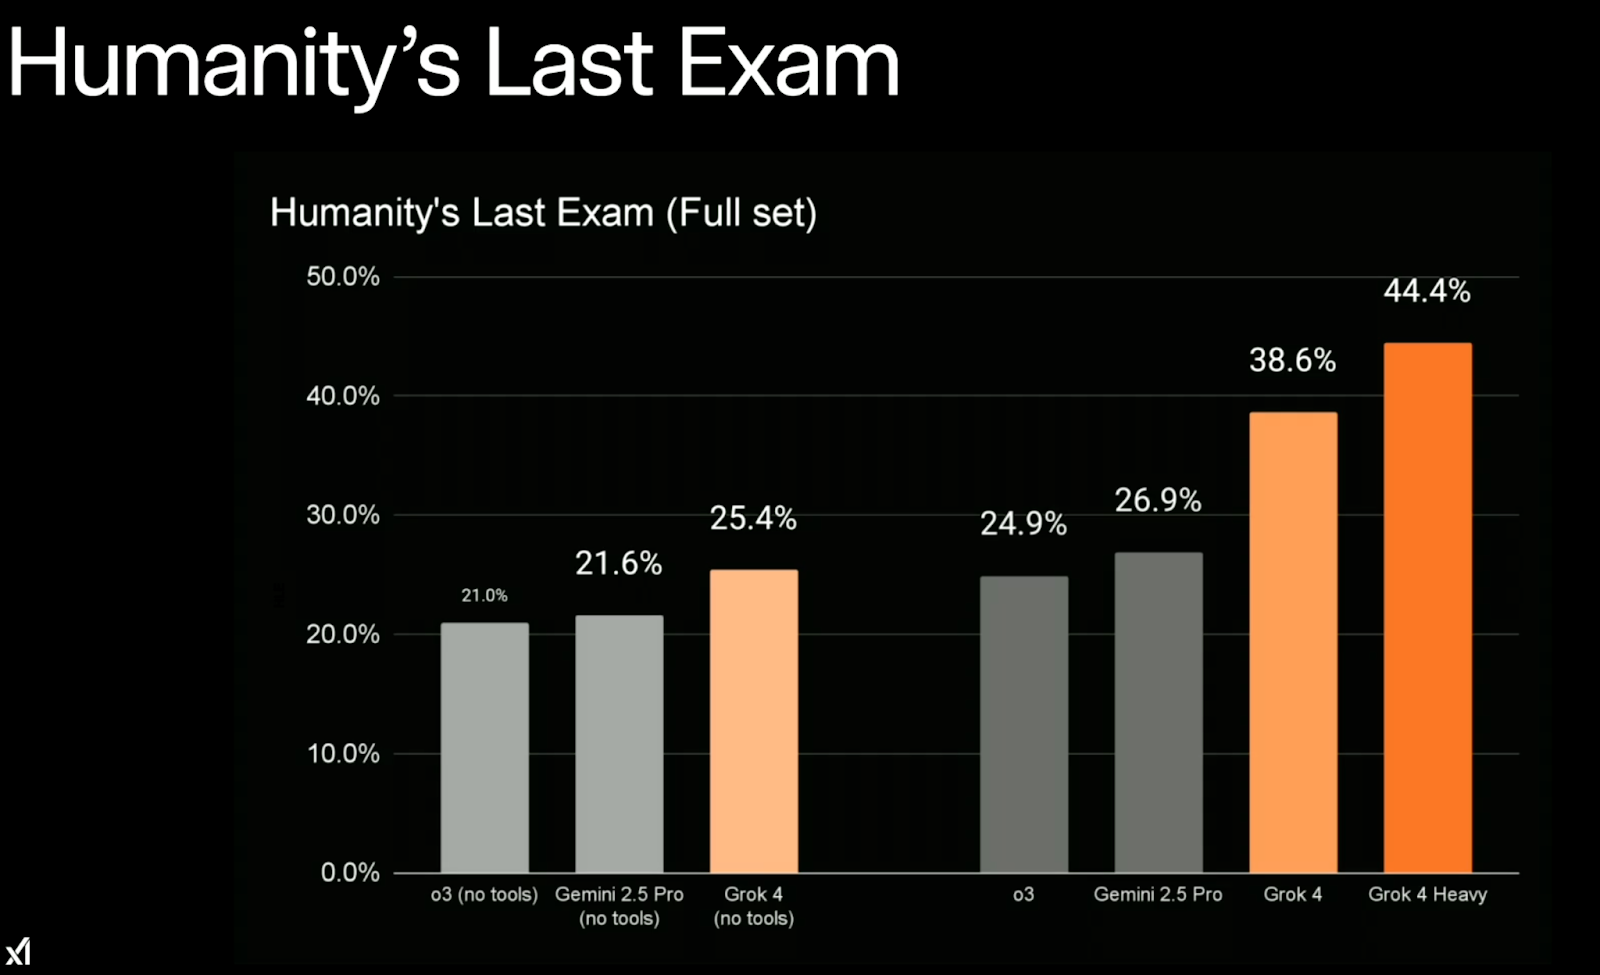
Công ty cho rằng đây là mô hình thông minh nhất hiện nay, và kết quả điểm chuẩn cũng hướng đến điều đó. Kết quả đáng chú ý nhất đến từ Humanity’s Last Exam, một bộ điểm chuẩn gồm 2.500 câu hỏi được chọn lọc thủ công ở trình độ tiến sĩ, trải rộng các lĩnh vực toán, vật lý, hóa học, ngôn ngữ học và kỹ thuật. Grok 4 (kèm công cụ) giải được khoảng 38,6% bài toán.
Nguồn: xAI
Cửa sổ ngữ cảnh là 128.000 token trong ứng dụng và 256.000 trên API, đủ chỗ cho suy luận dài nhưng không quá hào phóng theo tiêu chuẩn hiện nay. Chẳng hạn, Gemini 2.5 Pro cung cấp 1 triệu. Nếu bạn xây dựng với Grok, nhiều khả năng bạn sẽ phải dành thời gian cấu trúc và cắt tỉa ngữ cảnh cẩn thận.
Nói cho rõ, Grok 4 không phải là mô hình để bạn dùng hằng ngày cho các câu hỏi kiểu “Cuối tuần này có mưa không?” hay “Tìm giúp tôi một buổi hòa nhạc gần đây.” Tốt hơn là dùng Grok 3 cho việc đó—nhanh hơn và xây dựng cho tác vụ tổng quát. Grok 4 phù hợp hơn cho nghiên cứu, prompt kỹ thuật, và các câu hỏi khó trong toán, khoa học, tài chính, hoặc quy trình phát triển phần mềm dựa nhiều vào khả năng suy luận thuần.
Khả năng hoạt động trong các quy trình tiêu dùng rộng hơn hoặc xử lý an toàn ở quy mô thế nào thì chưa rõ. Nhưng xAI cho biết nó đã được dùng tại các phòng thí nghiệm y sinh, công ty tài chính và các đối tác doanh nghiệp sớm.
Grok 4 Heavy là phiên bản đa tác tử của Grok 4. Thay vì chạy một mô hình, nó khởi tạo nhiều tác tử song song, mỗi tác tử làm việc độc lập trên cùng một nhiệm vụ. Sau khi tạo đầu ra, chúng so sánh kết quả và hội tụ về một câu trả lời.
Về lý thuyết, nó giống một nhóm học tập—các tác tử có thể chia sẻ phát hiện hoặc bù đắp điểm mù cho nhau. Trên thực tế, thiết lập này hữu ích với các bài toán suy luận phức tạp nơi một lần xử lý có thể chưa đủ.
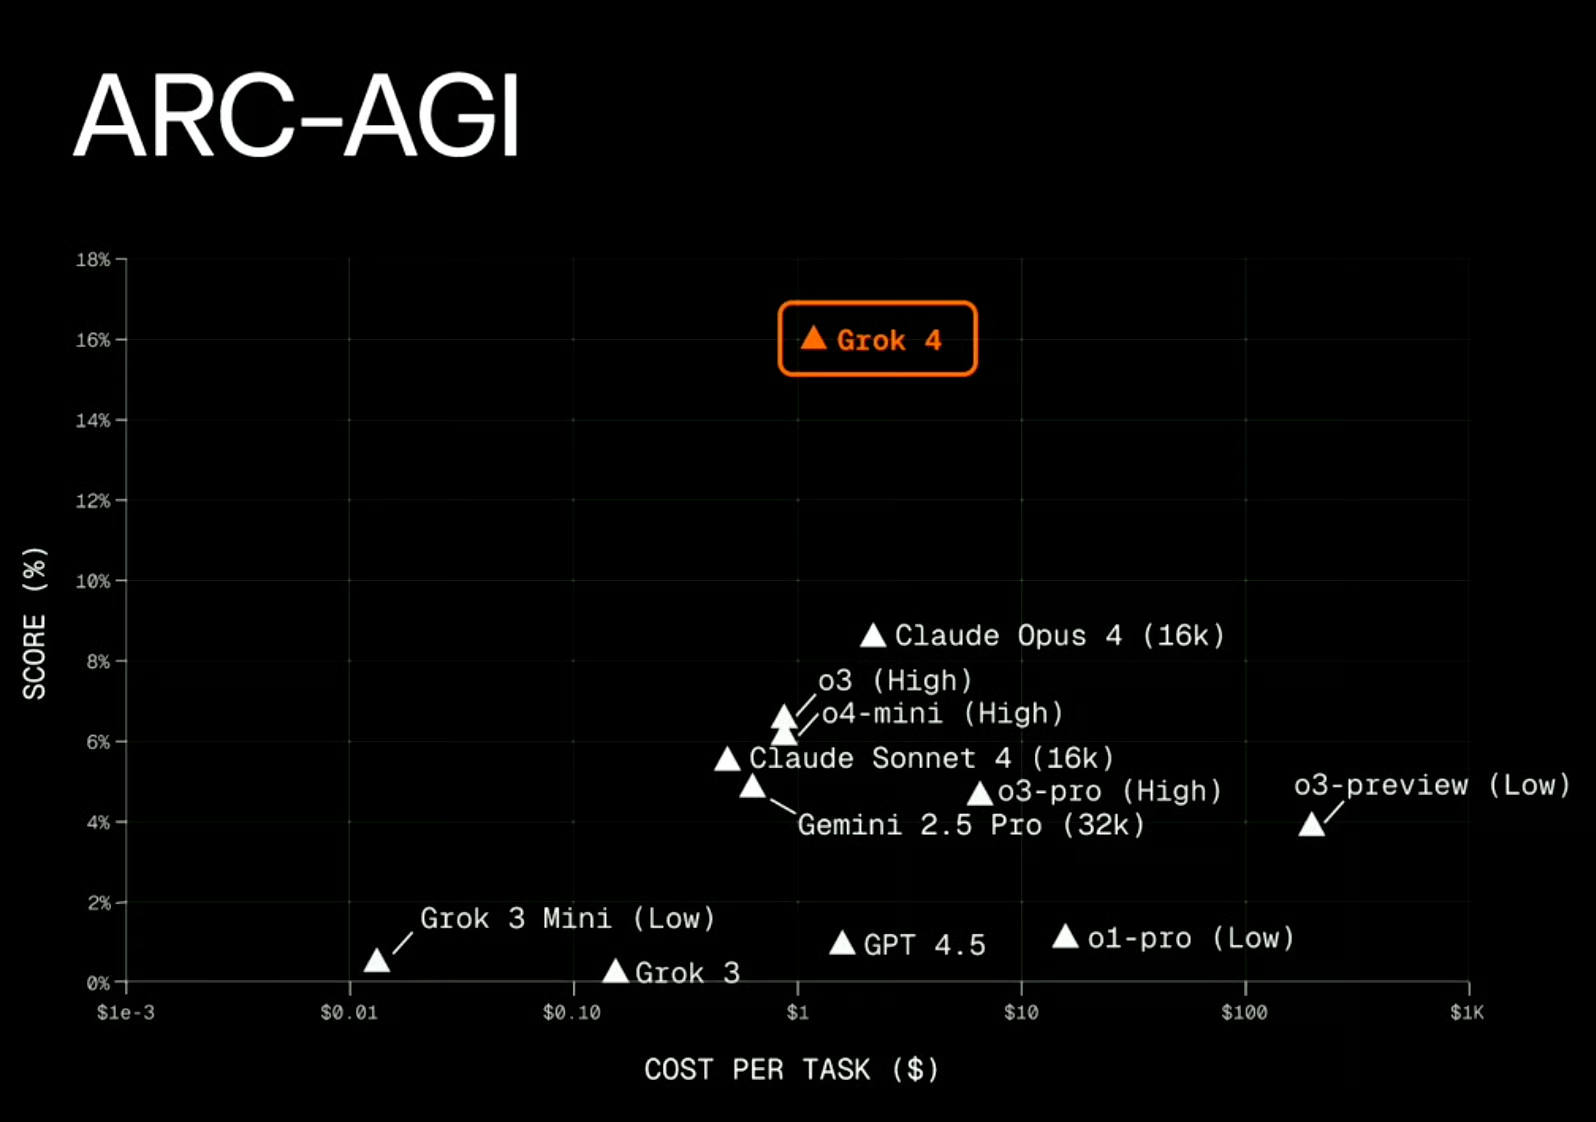
Lợi ích thể hiện rõ trong điểm chuẩn. Trên Humanity’s Last Exam, Grok 4 Heavy có dùng công cụ đạt 44,4%, vượt đáng kể Grok 4 đơn tác tử. Kiến trúc này cũng có vẻ giúp trên ARC-AGI, nơi Grok 4 là mô hình đầu tiên vượt 10% và đạt 15,9%—dù chưa rõ bao nhiêu phần trong kết quả đó đến từ thiết lập đa tác tử cụ thể.
Nguồn: xAI
Đổi lại là tốc độ và chi phí. Grok 4 Heavy chạy chậm hơn (chậm hơn nhiều!), và vận hành đắt gấp mười lần—xAI cung cấp quyền truy cập qua gói SuperGrok Heavy $300/tháng.
Một lần nữa, Grok 4 Heavy không phải thứ bạn muốn dùng cho tra cứu cơ bản hay lặp nhanh. Nếu Grok 4 đã là ngách, thì Grok 4 Heavy còn ngách hơn. Nó được xây để giải những vấn đề mà nhiều lộ trình suy luận có thể đem lại kết quả tốt hơn—hãy nghĩ đến nghiên cứu khoa học, mô hình tài chính, hoặc bất cứ thứ gì liên quan đến lập kế hoạch dài hạn. Dù vậy, với hầu hết trường hợp sử dụng, nó là “dùng dao mổ trâu giết gà”.
Để xem demo trực quan của Grok 4, đừng bỏ lỡ video hướng dẫn của chúng tôi:
Tôi thường xuyên thử các mô hình mới, nên hay tái sử dụng vài tác vụ tiêu chuẩn để so sánh. Tôi sẽ làm tương tự ở đây, tập trung vào toán và lập trình. Đây không nhằm đánh giá toàn diện Grok—chỉ để cảm nhận cách nó hành xử trong một thiết lập trò chuyện điển hình.
Tôi muốn bắt đầu với một phép tính đơn giản: 9,11 - 9,9. Nghe có vẻ vớ vẩn, nhưng điều này thường làm các mô hình ngôn ngữ rối trí—ví dụ Claude Sonnet 4 đã trả lời sai. Rõ ràng tôi có thể dùng máy tính, nhưng mục tiêu ở đây là xem mô hình tiếp cận vấn đề thế nào và liệu nó có biết dựa vào công cụ khi cần hoặc giải trực tiếp bằng chuỗi suy nghĩ.
Hãy xem Grok 4 trả lời ra sao:
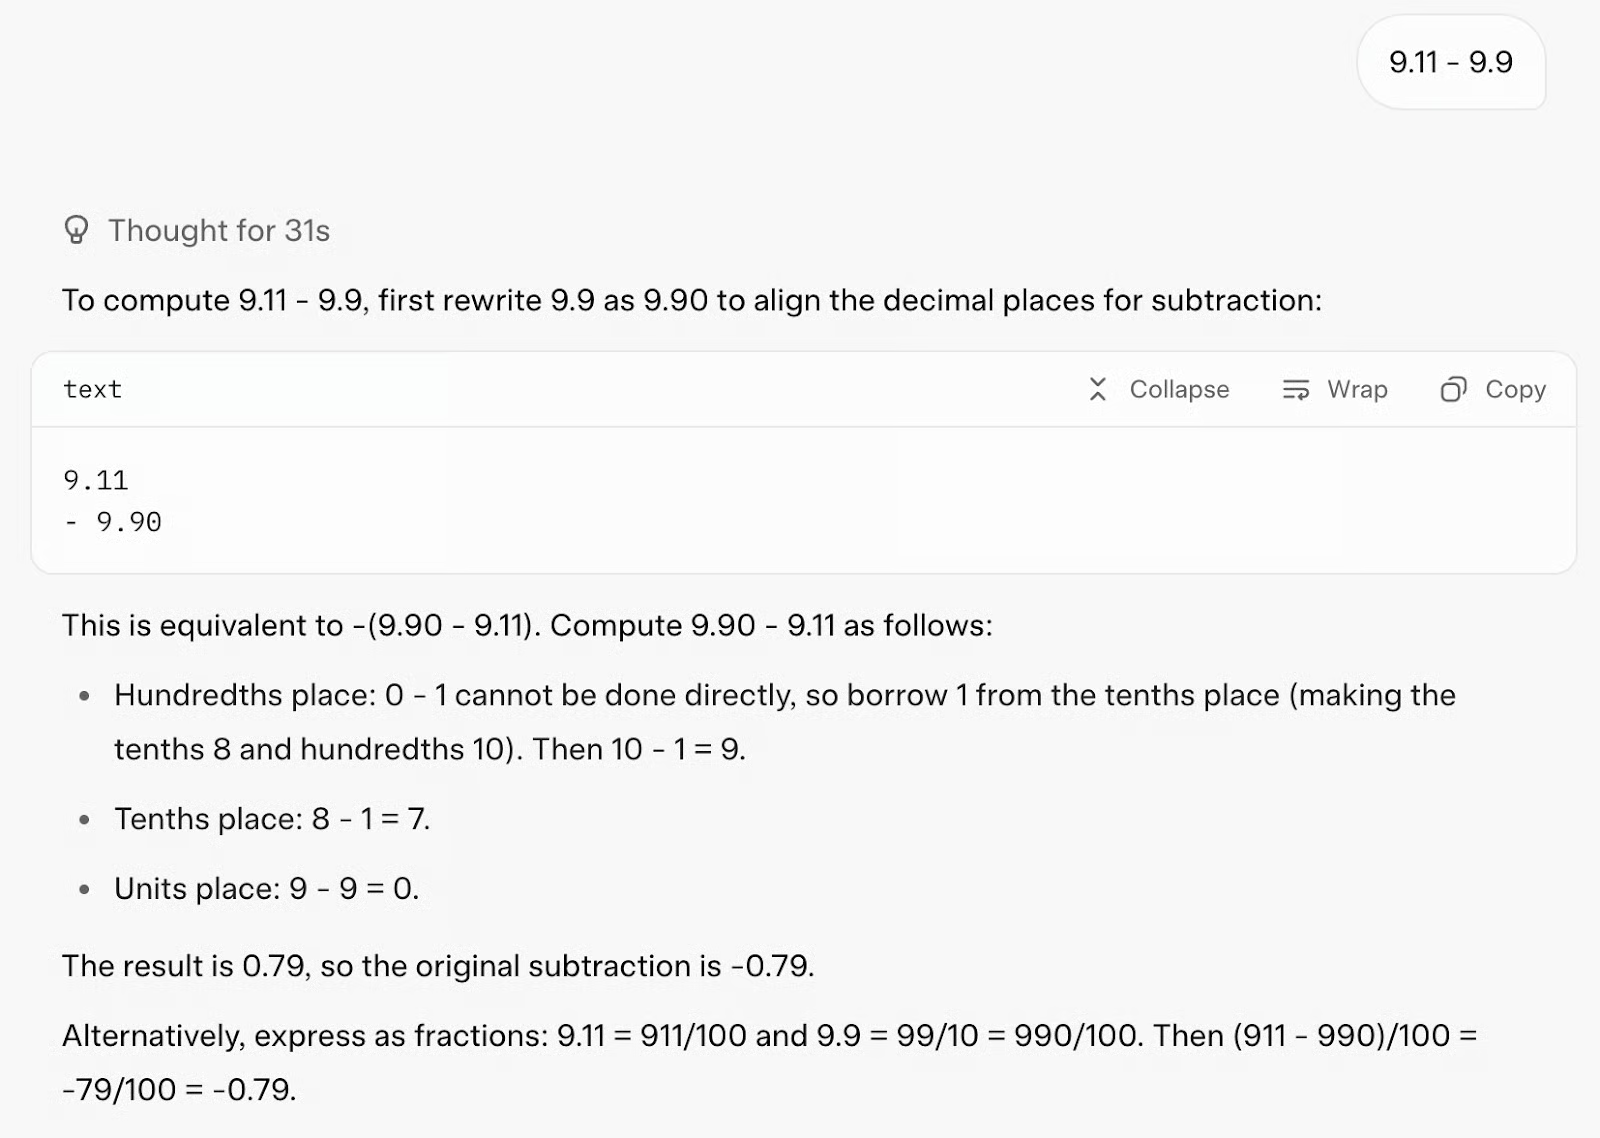
Nó trả lời đúng ngay lần đầu. Nó tìm ra đáp án qua chuỗi suy nghĩ, đồng thời dùng công cụ mã để xác nhận kết quả (rất tốt!).
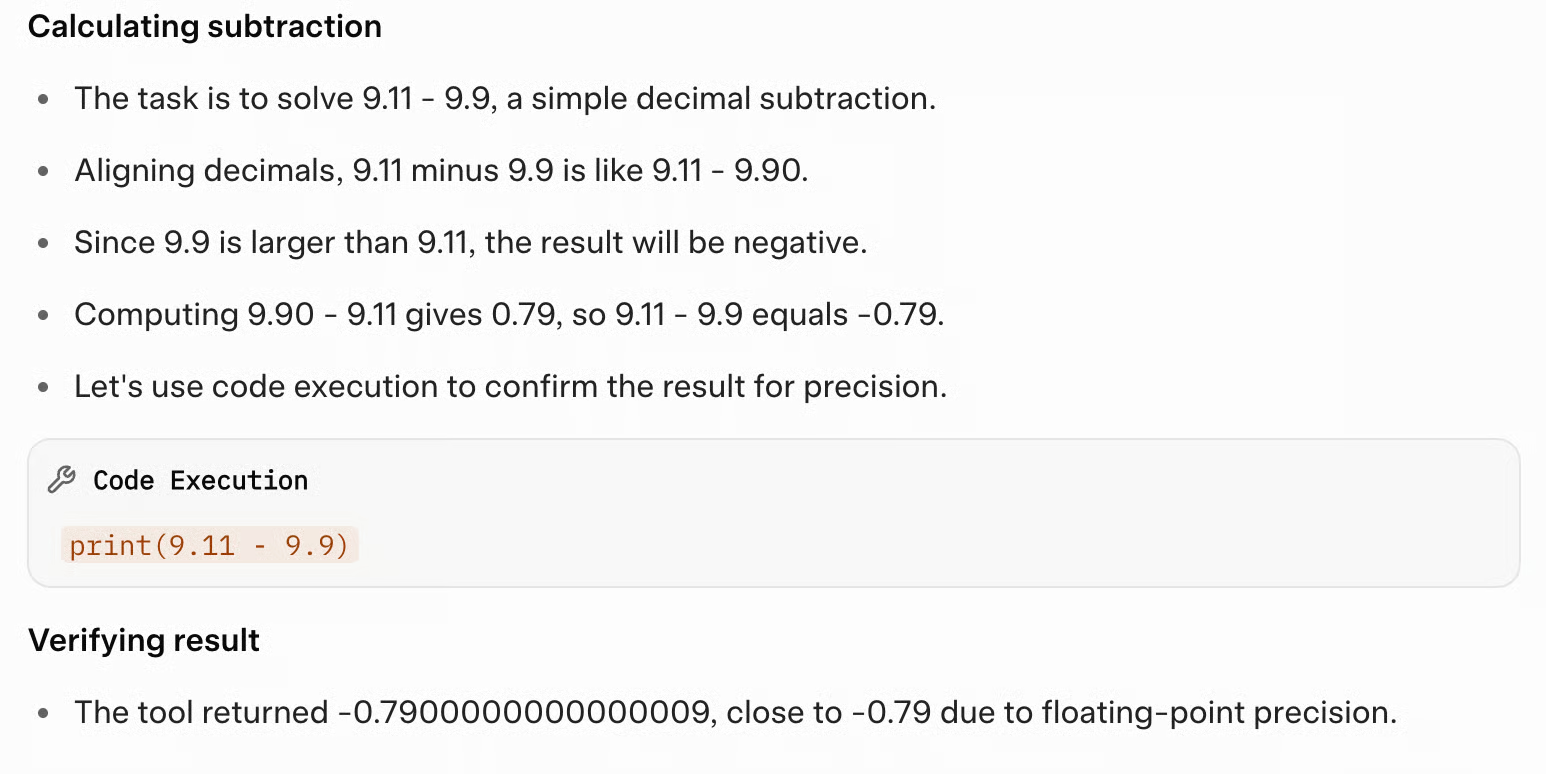
Tuy nhiên, nó mất 31 giây để phản hồi và câu trả lời quá dài so với một đề bài đơn giản như vậy.
Tiếp theo, tôi muốn thử Grok 4 với một bài toán phức tạp hơn, thường có thể đẩy cửa sổ ngữ cảnh của mô hình đến giới hạn:
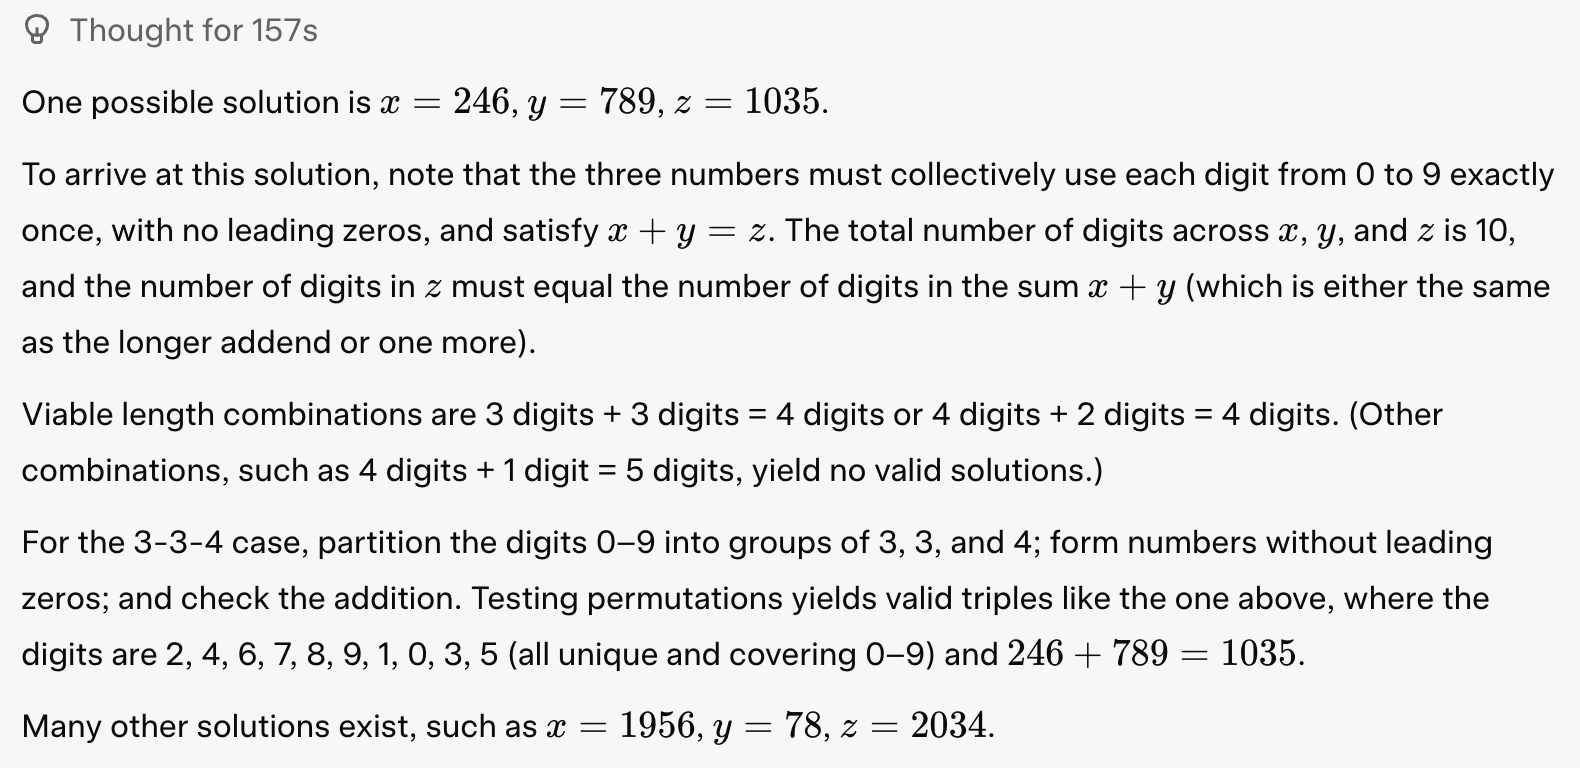
Đề: Dùng tất cả các chữ số từ 0 đến 9, mỗi chữ số đúng một lần, để tạo ba số x, y, z sao cho x + y = z.
Grok 4 tiếp cận thông minh. Trước tiên, nó nhận ra có thể tạo tất cả 3.628.800 hoán vị của các số 0–9 chỉ trong vài giây bằng Python. Sau đó nó thử thiết lập gồm hai số 3 chữ số cộng lại thành số 4 chữ số, và viết mã thực sự trả về 96 nghiệm hợp lệ!
from itertools import permutations

digits = range(10)

solutions = []

for p in permutations(digits):
    x_digits = p[0:3]
    if x_digits[0] == 0: continue
    y_digits = p[3:6]
    if y_digits[0] == 0: continue
    z_digits = p[6:10]
    if z_digits[0] == 0: continue
    x = int(''.join(map(str, x_digits)))
    y = int(''.join(map(str, y_digits)))
    z = int(''.join(map(str, z_digits)))
    if x + y == z:
        solutions.append((x, y, z))

print(solutions)
Sau đó, nó thử các tổ hợp khác (như 4 chữ số cộng 2 chữ số bằng 4 chữ số) với cùng cách tiếp cận. Cuối cùng, nó tìm trên web để biết thêm về câu đố toán này và xác nhận đáp án. Tổng cộng mất 157 giây để đưa ra câu trả lời sau:
Với tác vụ lập trình, tôi muốn xem nó so với Gemini 2.5 Pro và Claude Opus 4 trên bài này thế nào:
Đề: Tạo cho tôi một game endless runner cuốn hút. Hiển thị hướng dẫn chính trên màn hình. Cảnh p5.js, không HTML. Tôi thích khủng long dạng pixel và nền thú vị.
Đây là kết quả:
Ổn phết!
Cuối cùng, tôi muốn xem Grok 4 xử lý các tác vụ đa phương thức với ngữ cảnh dài tốt đến đâu. Tôi đã tải lên một PDF chứa Báo cáo Triển vọng AI tạo sinh (43.087 token) của Ủy ban Châu Âu và yêu cầu Grok:
Đề: Phân tích toàn bộ báo cáo này và xác định ba biểu đồ giàu thông tin nhất. Tóm tắt từng biểu đồ và cho tôi biết chúng xuất hiện ở trang nào trong PDF.
Hãy xem câu trả lời trước, rồi ta phân tích:
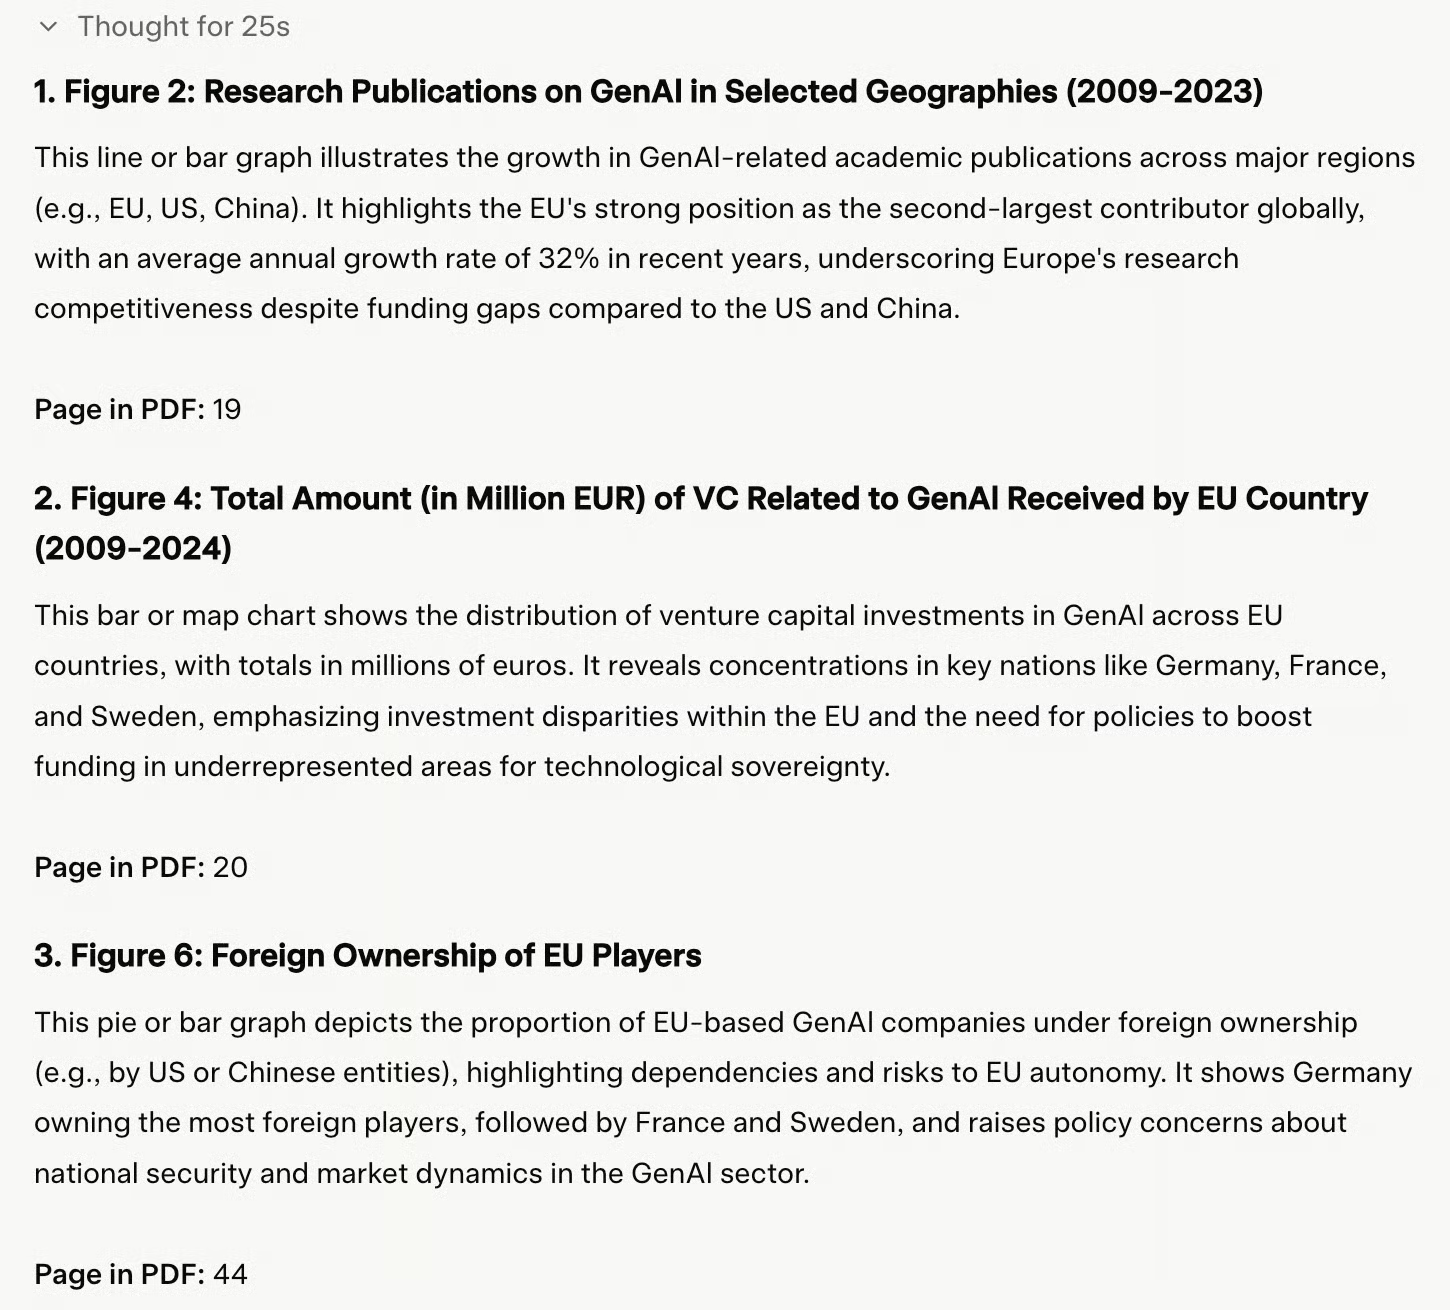
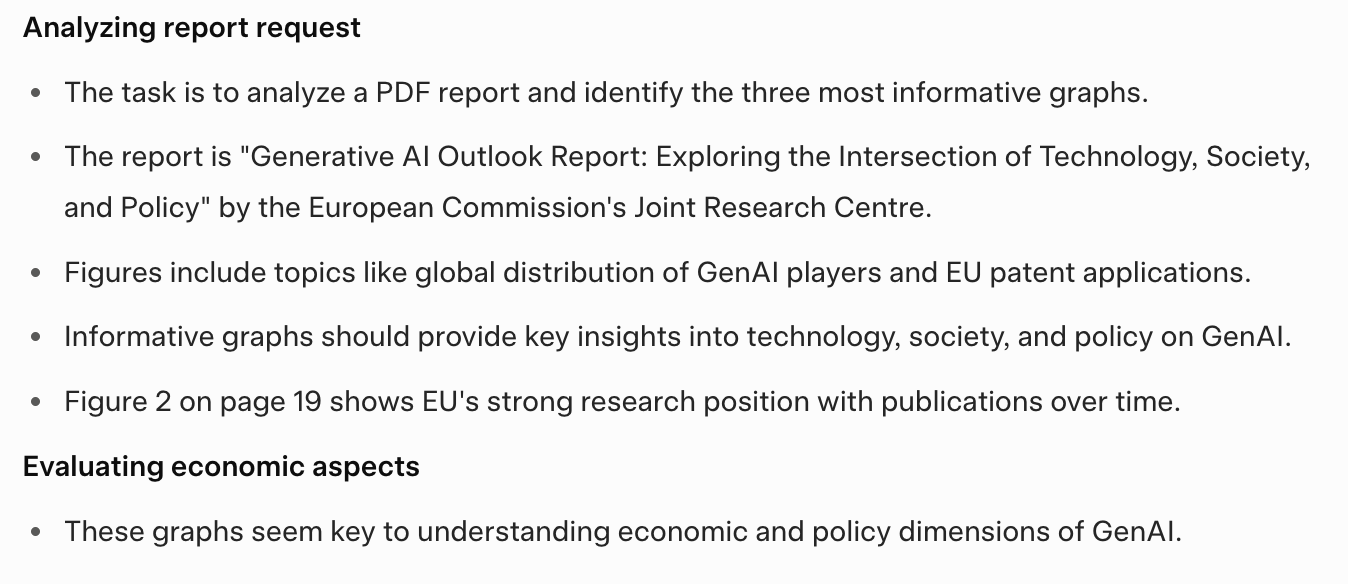
Một điều tôi nhận thấy là nó dừng lại khá nhanh, chỉ sau 25 giây. Nó đề xuất các biểu đồ từ trang 19, 20 và 44 (sai), và có vẻ bỏ qua phần còn lại của tài liệu dài 167 trang ngay khi tìm thấy câu trả lời trông có vẻ thỏa đáng. Chuỗi suy nghĩ có cảm giác chưa hoàn chỉnh và cho thấy cách tiếp cận khá nông:
Giờ đến kết quả:
Như Elon Musk chỉ ra trong livestream, khả năng hiểu và tạo ảnh của Grok 4 vẫn chưa phát triển nhiều. Nếu bạn cần kết quả ổn định và đáng tin cậy, tôi cho rằng lúc này có thể xem Grok 4 là mô hình chỉ văn bản.
Điểm nổi bật của Grok 4 là hiệu năng trên nhiều bộ điểm chuẩn, từ bài kiểm tra học thuật đến mô phỏng kinh doanh. Theo xAI, mô hình cải thiện đáng kể so với các phiên bản trước chủ yếu nhờ nhiều tài nguyên tính toán hơn—cả khi huấn luyện lẫn suy luận—chứ không hẳn vì đột phá kiến trúc mới.
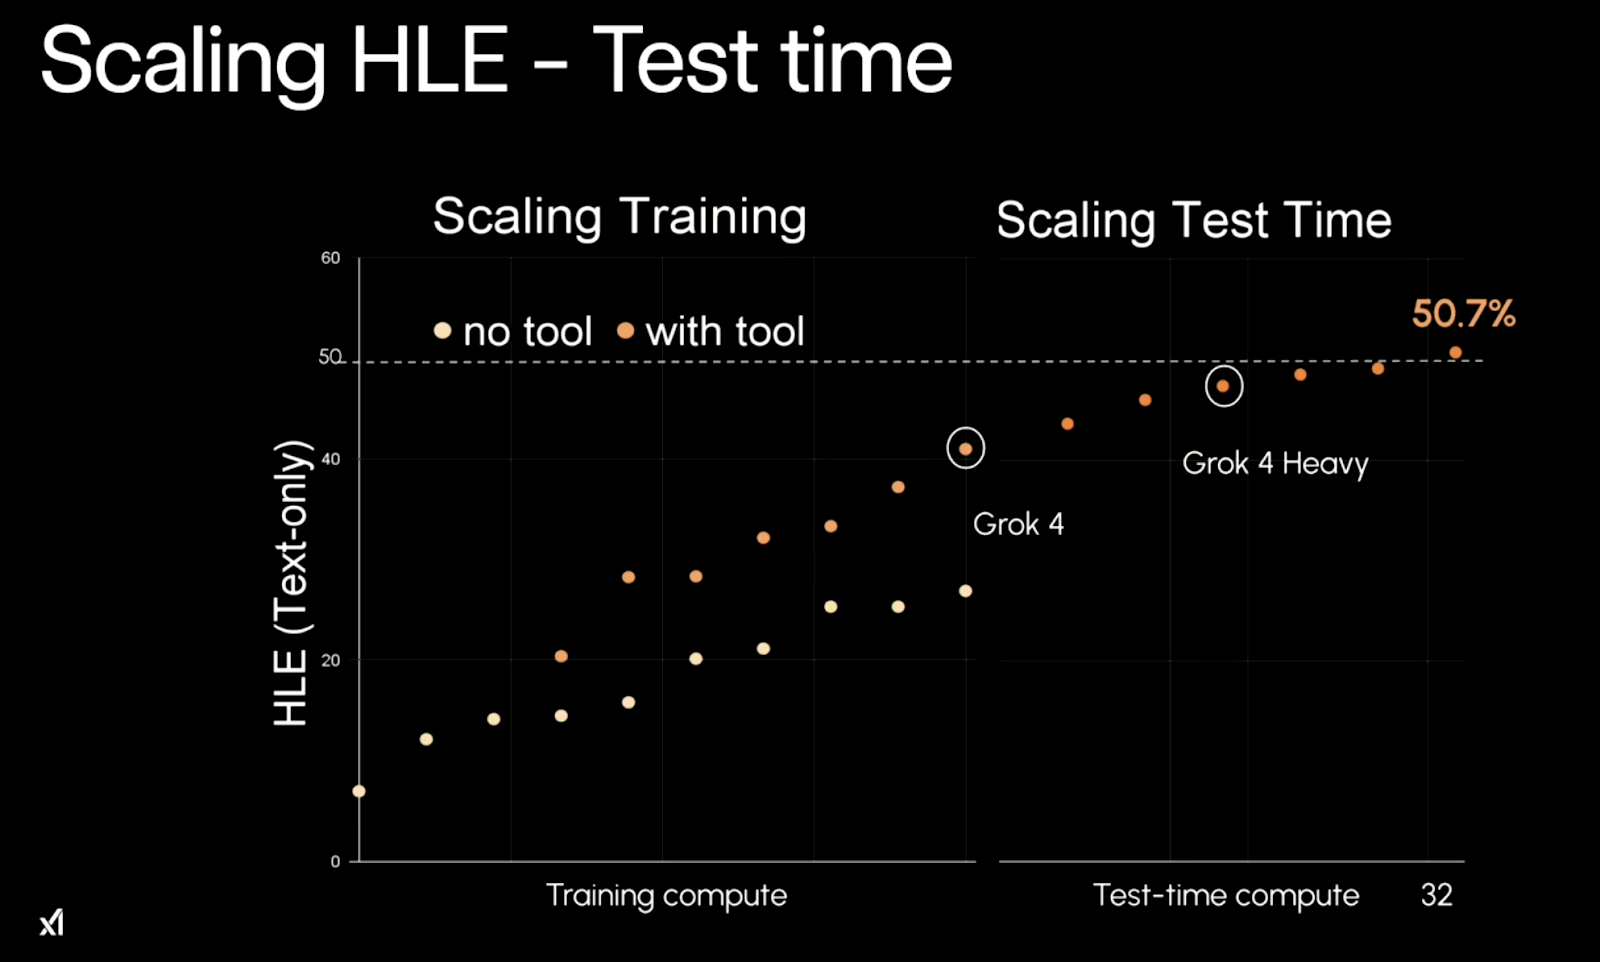
Mô thức cốt lõi phía sau hiệu năng của Grok 4 là mở rộng quy mô. Nó hưởng lợi từ nhiều tài nguyên tính toán khi huấn luyện và, thú vị hơn, từ nhiều tính toán lúc kiểm thử. Nói đơn giản: càng cấp nhiều tài nguyên, nó càng hoạt động tốt. Điều này thấy rõ ở các tác vụ của Humanity’s Last Exam (HLE).
Nguồn: xAI
Không dùng công cụ, Grok 4 đạt trần khoảng 26,9% độ chính xác. Bật công cụ (ví dụ thực thi mã), nó đạt 41,0%. Và khi chạy ở cấu hình đa tác tử “Heavy”, nó leo lên 50,7%—một bước nhảy lớn, hơn gấp đôi điểm tốt nhất trước đó của các mô hình không dùng công cụ.
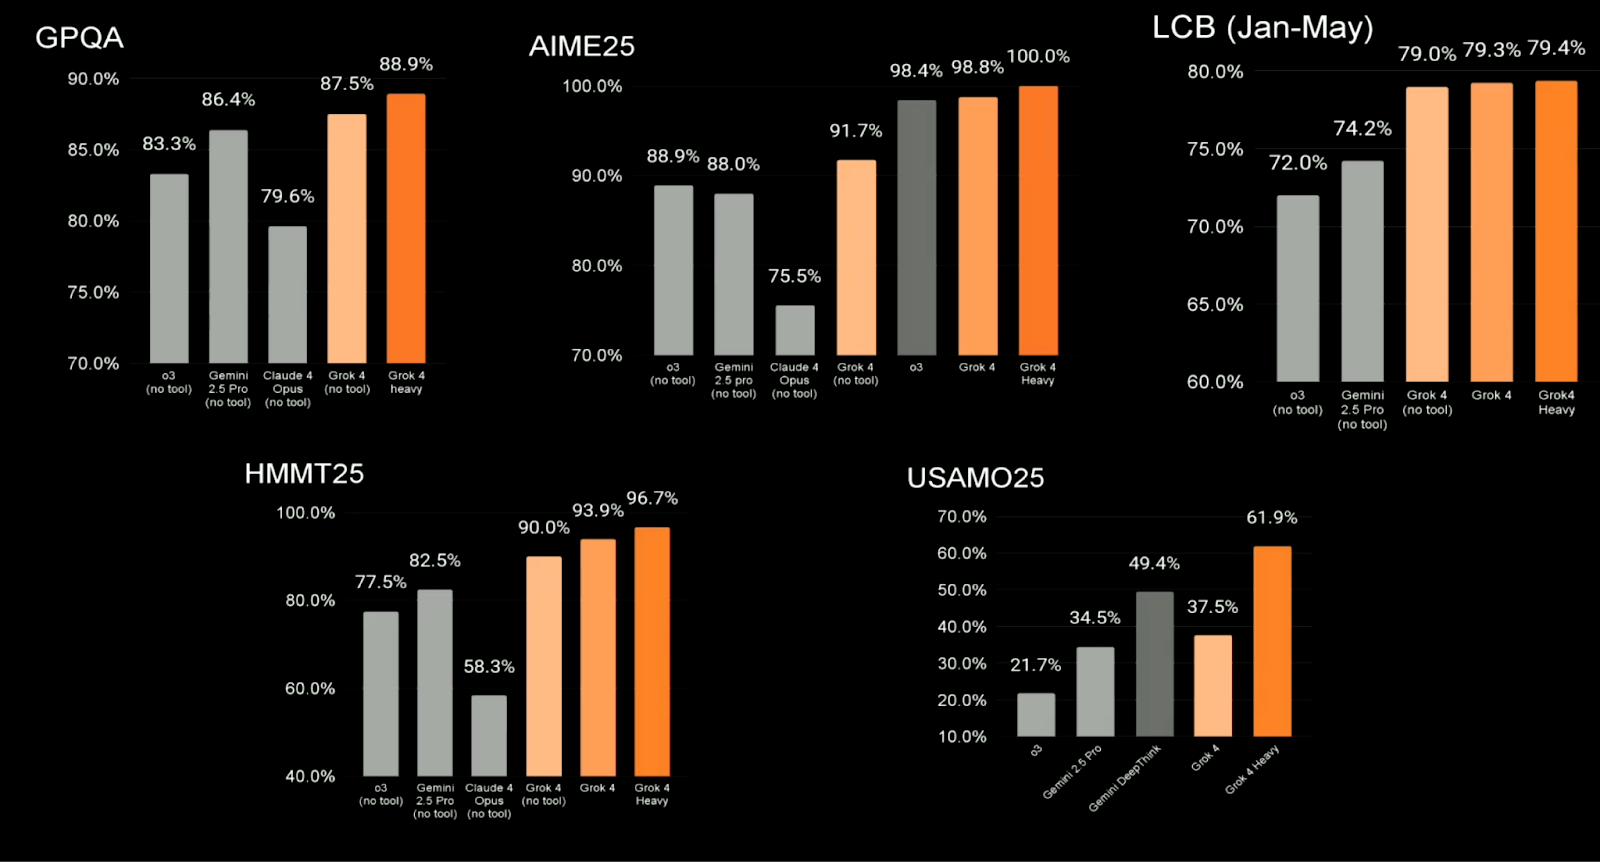
Grok 4 cũng thể hiện tốt trên các bài đánh giá truyền thống tập trung vào STEM, vốn được dùng rộng rãi để so sánh các LLM hiệu năng cao. Điểm nhấn gồm:
|
Điểm chuẩn |
Các mô hình cạnh tranh hàng đầu |
Grok 4 (Không công cụ) |
Grok 4 Heavy |
|
GPQA |
79,6–86,4% |
87,5% |
88,9% |
|
AIME25 |
75,5–98,8% |
91,7% |
100,0% |
|
LCB (Jan–May) |
72,0–74,2% |
79,0% |
79,4% |
|
HMMT25 |
58,3–82,5% |
90,0% |
96,7% |
|
USAMO25 |
21,7–49,4% |
37,5% |
61,9% |
Đây là những kết quả chắc chắn. Grok 4 vượt Claude Opus, Gemini 2.5 Pro và GPT-4 (o3) ở hầu hết hạng mục, dù một số người dùng chỉ ra rằng các so sánh có thể chọn lọc điểm gốc của mô hình đối thủ.
Nguồn: xAI
Một trong những điểm chuẩn khó và “đố” hơn là ARC-AGI, kiểm tra khả năng khái quát hóa của mô hình qua các tác vụ suy luận trừu tượng. Trên ARC-AGI v1, Grok 4 đạt 66,6%, dẫn đầu so với các đối thủ đã biết. Trên ARC-AGI v2, nó đạt 15,9%, so với 8,6% của Claude 4 Opus.
Các bài kiểm tra này không hoàn toàn công khai, nên cần kèm các lưu ý thông thường. Nhưng nếu các con số giữ vững, Grok 4 đang cho thấy hiệu năng mạnh ở các tác vụ suy luận nhiều bước, nặng tính logic.
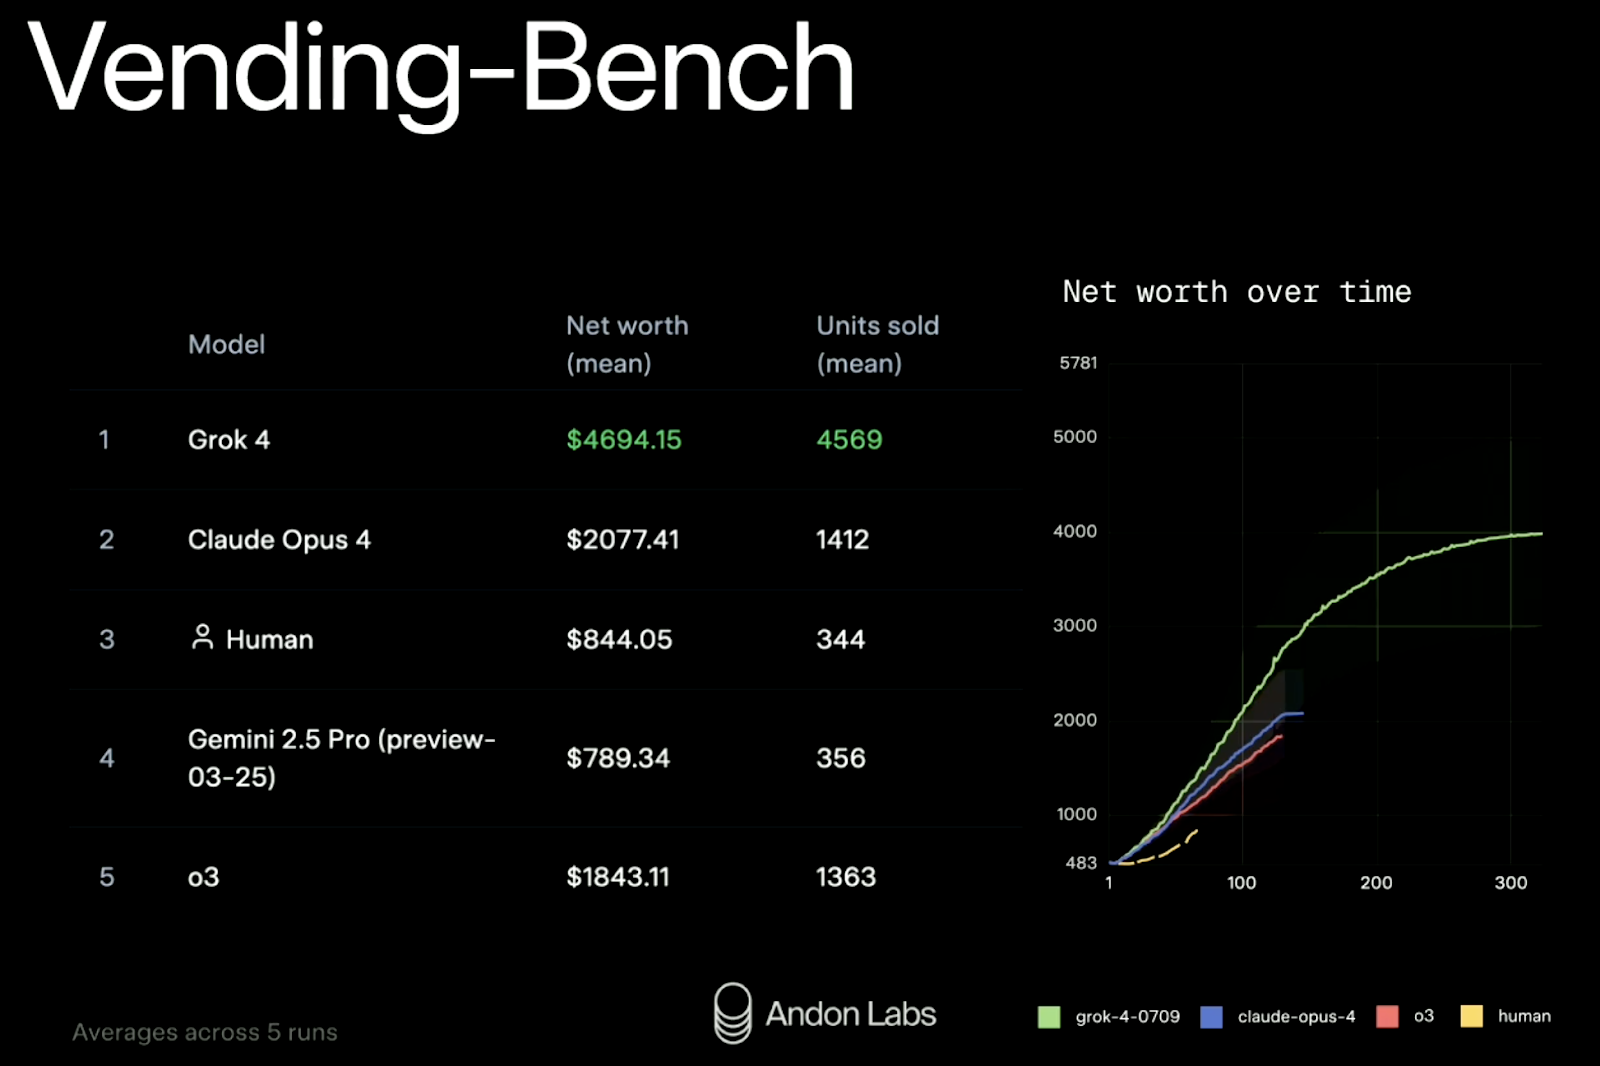
xAI cũng thử Grok 4 trong một mô phỏng thế giới thực gọi là Vending-Bench. Ý tưởng là xem liệu mô hình có thể quản lý một doanh nghiệp nhỏ theo thời gian: bổ sung hàng, điều chỉnh giá, liên hệ nhà cung cấp, v.v. Đây là một điểm chuẩn khá mới và bất ngờ là khá thú vị. Trước đó chúng tôi đã phân tích chi tiết cách nó vận hành qua một nghiên cứu trường hợp Claude Sonnet 3.7 trong bản tin hàng tuần The Median.
Kết quả (trung bình qua năm lượt chạy):
|
Hạng |
Mô hình |
Giá trị ròng |
Số đơn vị bán |
|
1 |
Grok 4 |
$4.694 |
4.569 |
|
2 |
Claude Opus 4 |
$2.077 |
1.412 |
|
3 |
Mốc người |
$ 844 |
344 |
|
4 |
Gemini 2.5 Pro |
$ 789 |
356 |
|
5 |
GPT-4 (o3) |
$1.843 |
1.363 |
Grok 4 vượt hơn gấp đôi hiệu năng của đối thủ gần nhất cả về doanh thu và quy mô. Nó cũng duy trì hiệu năng ổn định qua 300 vòng mô phỏng—điều nhiều mô hình chật vật khi phải lập kế hoạch dài hạn.
Nguồn: xAI
Tóm lại: Grok 4 hoạt động tốt ở những nơi xAI đã thử nghiệm. Nhưng như thường lệ, bạn nên nhìn vượt ra ngoài bảng xếp hạng. Các điểm chuẩn hứa hẹn, nhưng không kể hết câu chuyện—đặc biệt nếu trường hợp sử dụng của bạn phụ thuộc vào thị giác, sinh mã, hoặc tương tác thời gian thực trong môi trường lộn xộn.
Grok 4 hiện khả dụng qua ba cổng chính: ứng dụng X, xAI API, và nền tảng grok.com. Dù bạn muốn trò chuyện với mô hình, xây dựng với nó, hay kiểm thử khả năng suy luận bài bản hơn, dưới đây là cách bắt đầu.
Cách dễ nhất để thử Grok 4 là qua ứng dụng X (trước đây là Twitter). Điều này cho bạn truy cập Grok trong giao diện chat, tương tự ChatGPT hay Claude.
Để sử dụng:
Bạn cũng có thể dùng Grok 4 trực tiếp qua grok.com, cung cấp một giao diện độc lập, gọn gàng bên ngoài nền tảng X. Nhắm tới người dùng ưa thiết lập không xao nhãng.
Nếu bạn muốn tích hợp Grok vào ứng dụng hoặc quy trình của riêng mình, bạn có thể dùng xAI API.
Các bước:
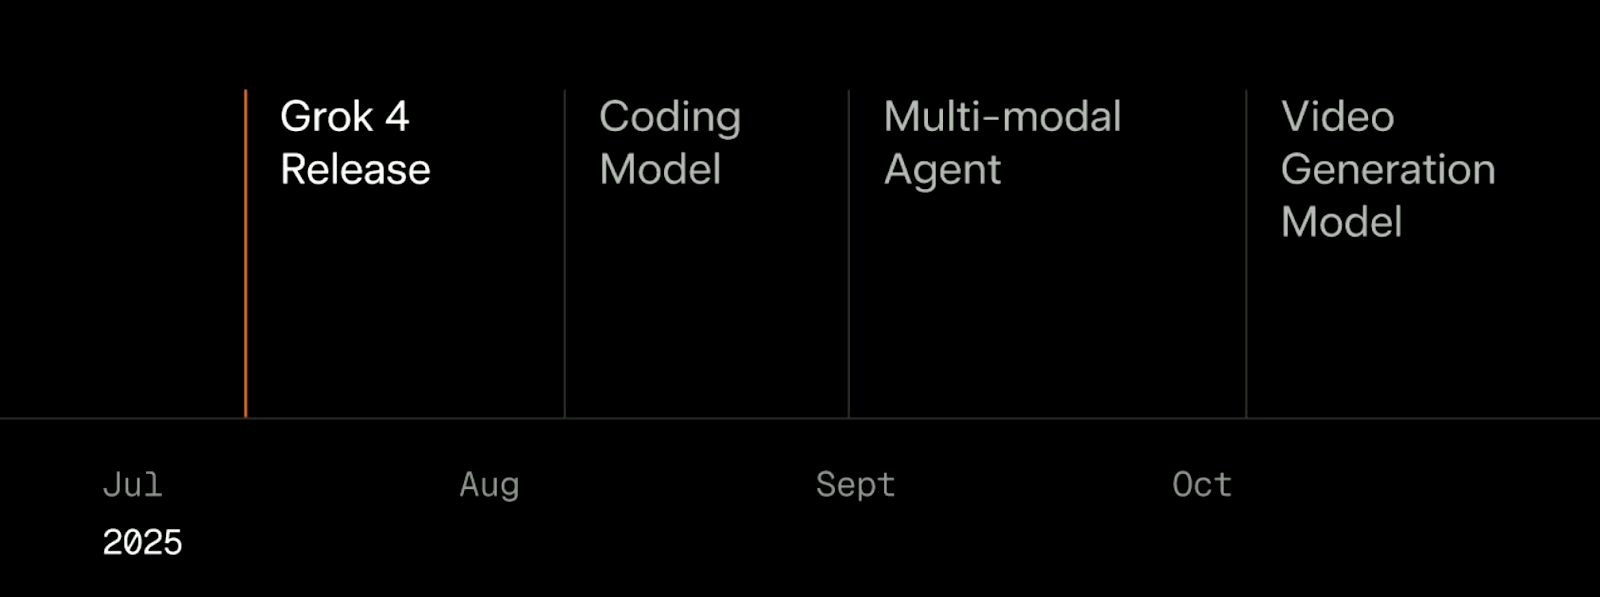
Sau khi phát hành Grok 4, xAI đã đưa ra lộ trình rõ ràng (và tham vọng) cho phần còn lại của năm 2025. Theo mốc thời gian trong livestream, bốn bản phát hành lớn xếp lịch trong ba tháng tới: một mô hình lập trình vào tháng 8, một tác tử đa phương thức vào tháng 9, và một mô hình tạo video vào tháng 10.
Nguồn: xAI
Bản tiếp nối đầu tiên là một mô hình tập trung vào lập trình dự kiến trong tháng 8. Khác với Grok 4 là nhà tổng quát, đây sẽ là mô hình chuyên biệt xử lý mã nhanh và chính xác hơn. xAI mô tả nó “nhanh và thông minh”, được huấn luyện riêng để cải thiện cả độ trễ và suy luận trong quy trình phát triển phần mềm.
Vào tháng 9, kế hoạch là phát hành một tác tử thực sự đa phương thức. Hiện tại, Grok 4 về mặt kỹ thuật hỗ trợ đầu vào hình ảnh và video, nhưng khả năng hiểu còn hạn chế—trong livestream, nhóm mô tả như “nheo mắt qua tấm kính mờ”.
Phiên bản sắp tới nhằm khắc phục điều đó, tăng cường nhận thức với hình ảnh, video và âm thanh. Điều này then chốt cho các trường hợp vượt ngoài văn bản: nghĩ đến robot, chơi game, QA video, hoặc tuân thủ chỉ dẫn trực quan.
Bản phát hành cuối trong mốc hiện tại là mô hình tạo video vào tháng 10. xAI cho biết họ sẽ huấn luyện nó trên hơn 100.000 GPU. Theo chia sẻ, hệ thống này hướng tới tạo nội dung video chất lượng cao, tương tác và có thể chỉnh sửa.
Grok 4 là một bước tiến nghiêm túc cho xAI. Nó vượt đối thủ trên nhiều điểm chuẩn khó, đứng vững trong các đánh giá có cấu trúc về toán và khoa học, và giới thiệu hệ thống đa tác tử (Grok 4 Heavy) hứa hẹn cho bối cảnh nghiên cứu và tư duy dài hạn.
Tuy vậy, nó không phải trợ lý tổng quát cho công việc thường ngày. Nó chậm hơn Grok 3, khả năng hiểu hình ảnh và video vẫn ở giai đoạn đầu, và thiếu một số “độ mượt” trong khả năng dùng hằng ngày. Bạn sẽ cần prompt cẩn thận và tỉa gọn đầu vào do cửa sổ ngữ cảnh tương đối hạn chế. Và nếu bạn muốn hiệu năng tốt nhất—qua Grok 4 Heavy—bạn sẽ phải trả mức phí cao.
Với nhà phát triển và nhà nghiên cứu, đáng để khám phá. Với người dùng phổ thông, tốc độ và độ phản hồi của Grok 3 hoặc các mô hình phổ biến khác sẽ phù hợp hơn. Lộ trình rất tham vọng, với mô hình lập trình, tác tử đa phương thức và bộ tạo video đều dự kiến trước tháng 10. Liệu xAI có giao hàng đúng hạn không là câu chuyện khác. Nhưng với Grok 4, ít nhất họ đã đưa ra một bằng chứng thuyết phục rằng họ đang ở trong cuộc đua.
Học AI với các khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
