

Kurs
AI Agent'lere Giriş
1 sa 30 dk
147.2K
Alıştırma and program your progress.
Google Ile Devam EdinGrok 3.5 için aylarca bekledikten sonra xAI bunu tamamen atlayıp doğrudan Grok 4’e geçti. (Kasım 2025 itibarıyla Grok 4.1 de yayımlandı).
Bu sıçrama, modelin performansıyla haklı çıkarılıyor mu?
Evet, kıyaslamalara bakarsanız öyle. Şu anda Grok 4, kâğıt üzerinde muhtemelen dünyanın en iyi modeli.
Ancak uygulamada 128.000 ve API’de 256.000 bağlam penceresiyle, gerçek üretim işlerinde zorlanabilirsiniz. Size tam 1 milyon token veren Gemini 2.5 Pro kadar müsamahakâr değil. Grok 4’ü kısa bir sohbetten fazlası için kullanmak istiyorsanız, bunu işe koşmak adına ciddi bağlam mühendisliği becerilerine ihtiyacınız olacak.
Bu blogda, olağan abartıyı bir kenara bırakıp Grok 4’ün başlıca güçlü ve zayıf yönlerini ve kendi testlerimde nasıl performans gösterdiğini anlatarak dengeli bir genel bakış sunacağım.
Okurlarımızı yapay zekâdaki en son gelişmelerden haberdar etmek için, haftanın önemli haberlerini sade bir şekilde özetleyen ücretsiz Cuma bültenimiz The Median’ı gönderiyoruz. Abone olun; haftada sadece birkaç dakikada güncel kalın:
Grok 4 ailesi sadece Grok 4 ve Grok 4 Heavy’den oluşuyor; hızlı akıl yürütme için kullanabileceğimiz bir mini sürüm yok.
Grok 4, xAI’nin en son tek ajanlı modeli (çok ajan kullanan Grok 4 Heavy’nin aksine—ona bir sonraki bölümde geleceğiz). Canlı yayına bakılırsa mühendislik açısından özellikle çığır açan bir şey yok. Kazanımlar bir dizi küçük ayardan ve hesaptaki (compute) önemli artıştan geliyor gibi görünüyor; Grok 3’e kıyasla yaklaşık 10 kat daha fazla.
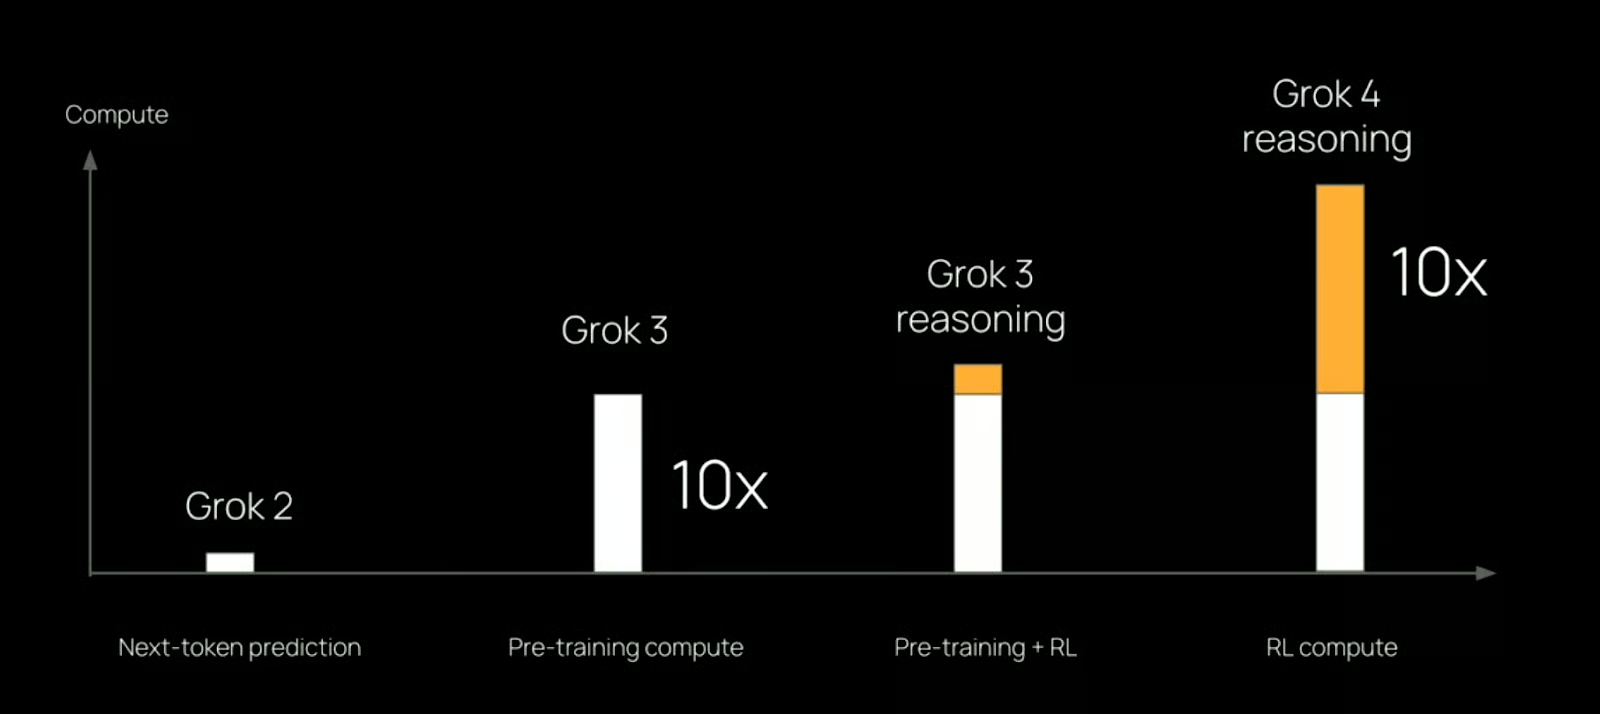
Kaynak: xAI
Şirket, bunun bugün mevcut en akıllı model olduğunu iddia ediyor ve kıyaslama sonuçları da o yönde. En dikkat çekici sonuç, matematik, fizik, kimya, dilbilim ve mühendisliği kapsayan, özenle seçilmiş 2.500 doktora seviyesi sorudan oluşan Humanity’s Last Exam’den geldi. Grok 4 (araçlarla) sorunların yaklaşık %38,6’sını çözmeyi başardı.
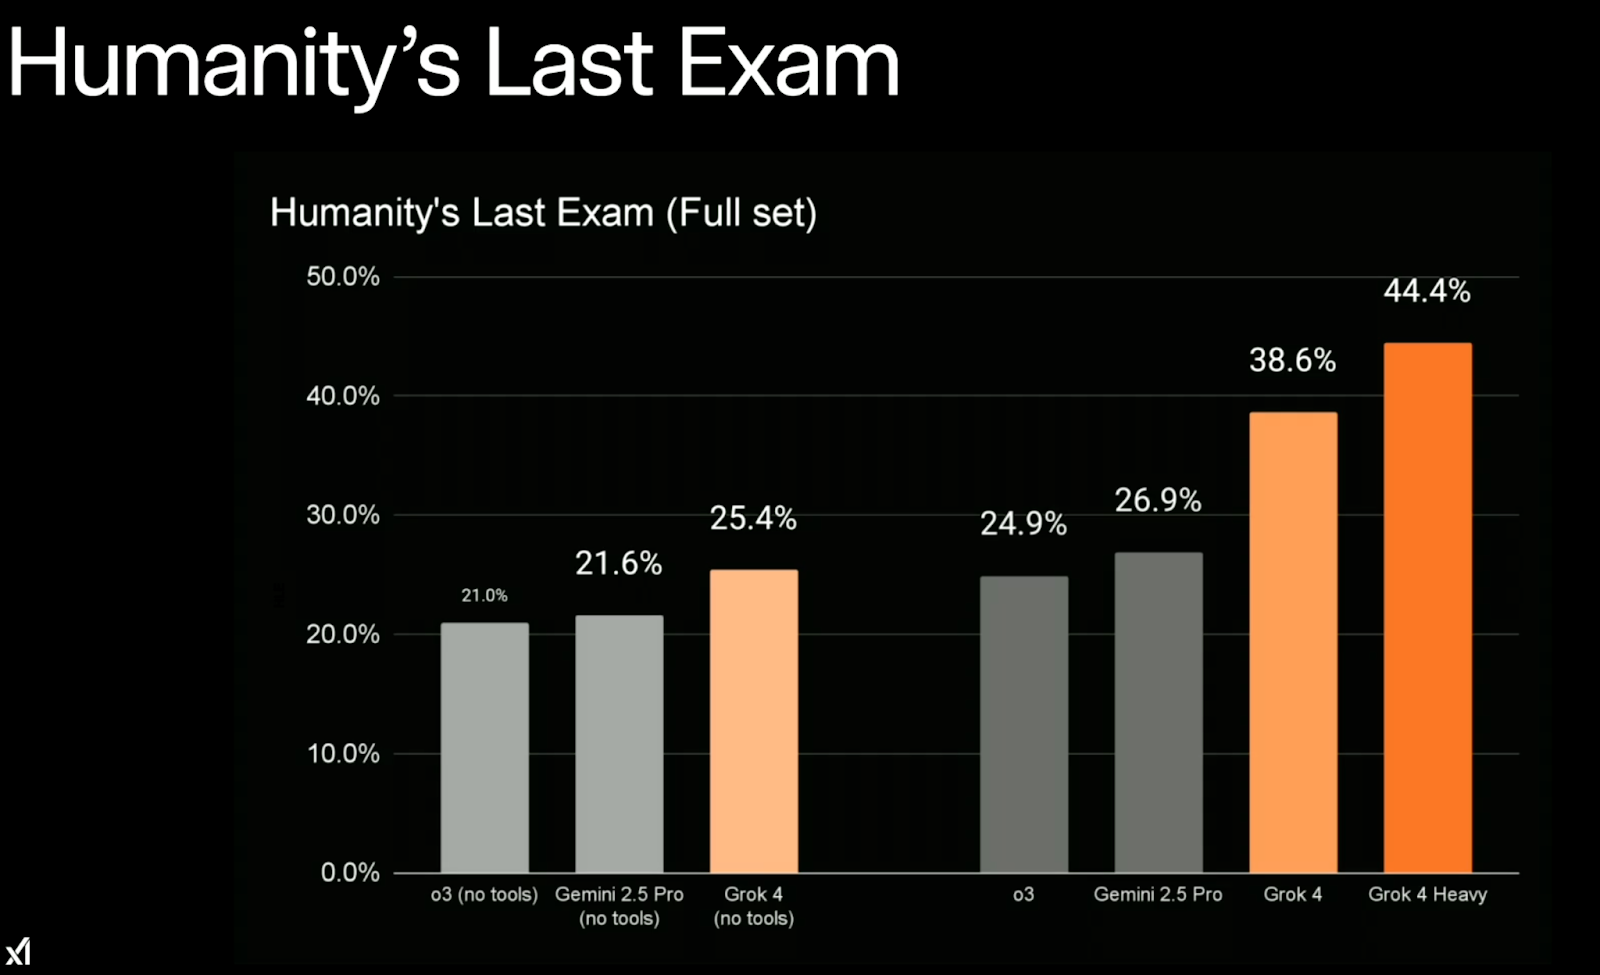
Kaynak: xAI
Bağlam penceresi uygulamada 128.000, API’de 256.000 token; uzun biçimli akıl yürütme için biraz alan sağlıyor ama günümüz standartlarına göre özellikle cömert değil. Örneğin Gemini 2.5 Pro 1 milyon sunuyor. Grok ile ürün geliştiriyorsanız, muhtemelen bağlamınızı dikkatlice yapılandırmaya ve budamaya zaman ayırmanız gerekecek.
Açık olmak gerekirse, Grok 4 “Bu hafta sonu yağmur yağacak mı?” veya “Yakında bir konser bul” gibi günlük sorular için başvuracağınız model değil. Bunun için Grok 3’ü kullanmanız daha iyi—daha hızlı ve genel amaçlı görevler için tasarlandı. Grok 4 ise araştırma, teknik istemler ve matematik, bilim, finans gibi zor sorular ya da ham akıl yürütmeye dayanan geliştirici iş akışları için daha uygun.
Daha geniş tüketici iş akışlarında nasıl performans gösterdiği veya güvenliği ölçekli şekilde ne kadar iyi yönettiği daha belirsiz. Ancak xAI, bunun halihazırda biyomedikal laboratuvarlarda, finans kuruluşlarında ve erken kurumsal iş ortaklarında kullanıldığını söylüyor.
Grok 4 Heavy, Grok 4’ün çok ajanlı sürümüdür. Tek bir model çalıştırmak yerine, aynı görev üzerinde bağımsız çalışan birkaç ajanı paralel olarak başlatır. Çıktıları ürettikten sonra sonuçları karşılaştırır ve tek bir yanıtta uzlaşırlar.
Teoride, bir çalışma grubuna benzer—ajanlar içgörüleri paylaşabilir veya birbirlerinin kör noktalarını yakalayabilir. Pratikte, bu kurulum tek geçişin yetersiz kalabileceği karmaşık akıl yürütme görevlerine yardımcı olur.
Kazanımlar kıyaslamalarda görülüyor. Humanity’s Last Exam’de, araç kullanımıyla Grok 4 Heavy %44,4 puan aldı ve tek ajanlı Grok 4’ü belirgin şekilde geride bıraktı. Mimari ayrıca ARC-AGI’de de yardımcı olmuş görünüyor; Grok 4, %10’u aşan ve %15,9’a ulaşan ilk model oldu—ancak bu sonucun ne kadarının özellikle çok ajanlı kuruluma atfedilebileceği belirsiz.
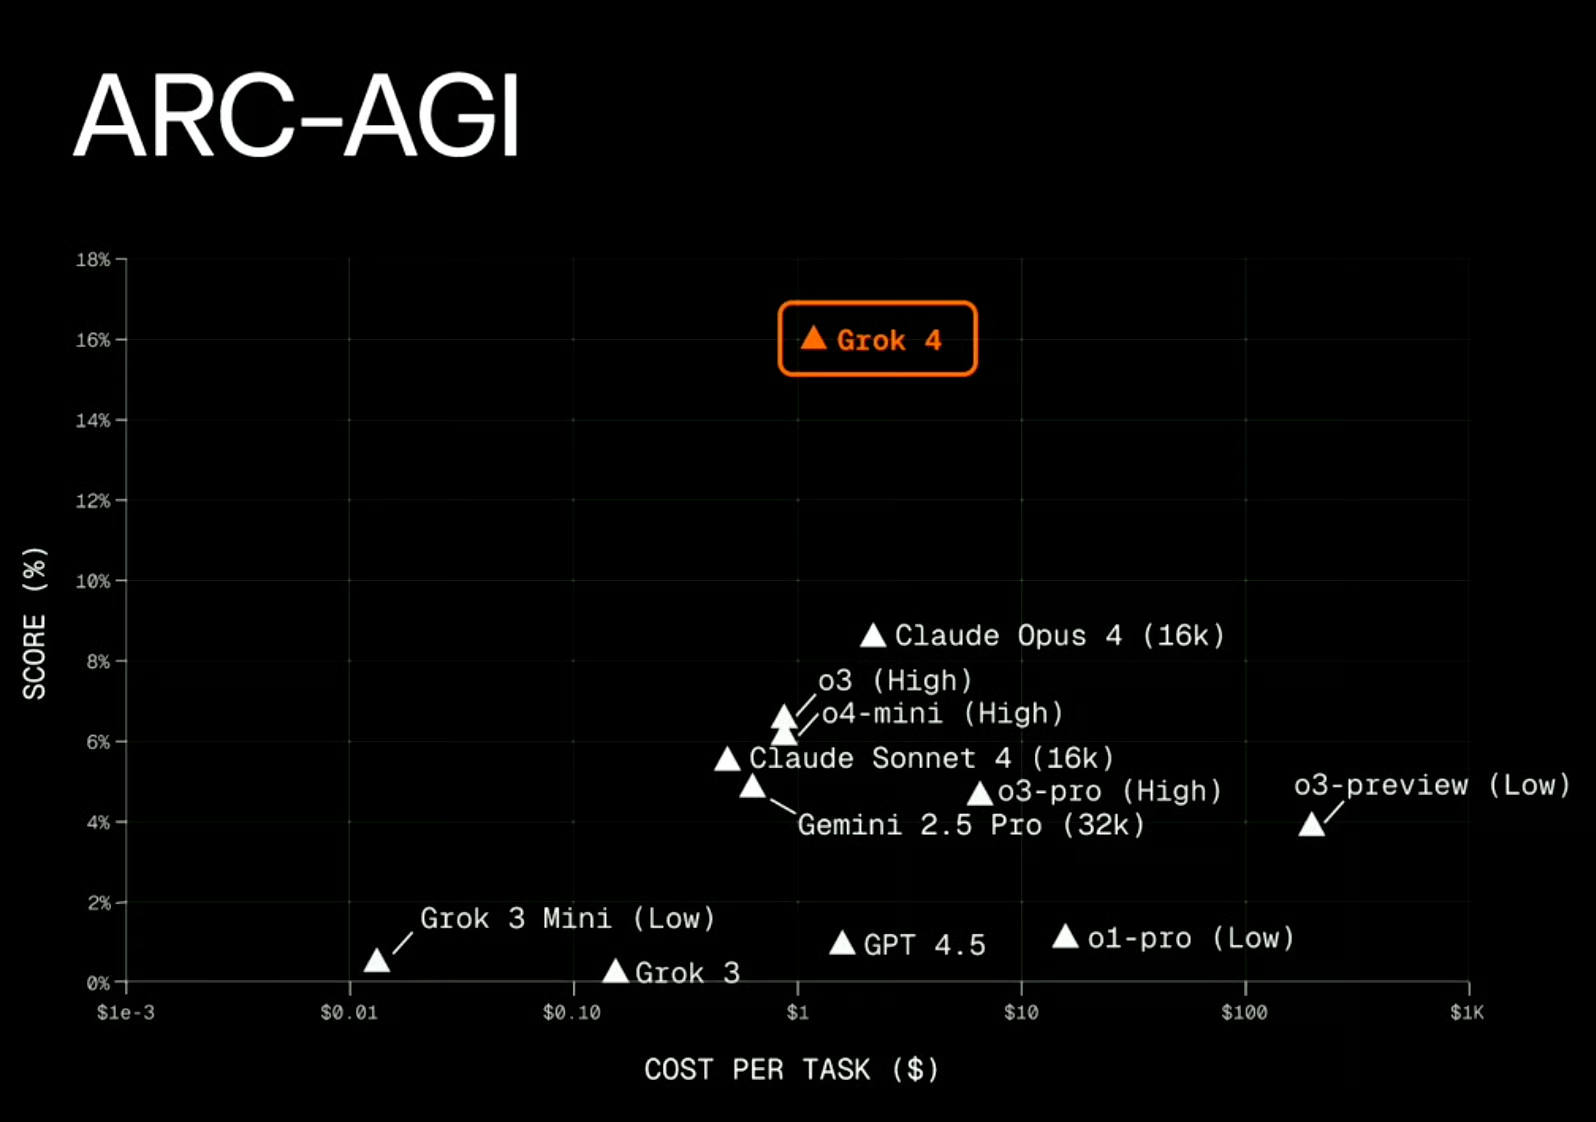
Kaynak: xAI
Bedeli ise hız ve maliyet. Grok 4 Heavy daha yavaş (hem de çok daha yavaş!) çalışıyor ve işletmesi on kat daha pahalı—xAI, erişimi aylık 300 $’lık SuperGrok Heavy katmanıyla sunuyor.
Yine, Grok 4 Heavy’yi temel aramalar veya hızlı yineleme için kullanmak isteyeceğiniz bir şey değil. Grok 4 zaten nişse, Grok 4 Heavy daha da niş. Birden çok akıl yürütme yolunun daha iyi sonuçlara götürebileceği türden problemler için geliştirildi—bilimsel araştırmalar, finansal modelleme veya uzun ufuklu planlama gerektiren her şey gibi. Ancak çoğu kullanım senaryosu için aşırı.
Grok 4’ün görsel demosu için, anlatımlı videomuzu kaçırmayın:
Yeni modelleri sık sık test ettiğim için, karşılaştırma yapabilmek adına bazı standart görevleri tekrar kullanma eğilimindeyim. Burada da aynısını yapacağım; matematik ve kodlamaya odaklanacağım. Bu, Grok’un kapsamlı bir değerlendirmesi olmayı amaçlamıyor—sadece tipik bir sohbet kurulumunda nasıl davrandığına dair bir fikir edinme yolu.
Basit bir hesaplamayla başlamak istiyorum: 9,11 - 9,9. Bu size saçma gelebilir ama dil modellerini sık sık şaşırtır—örneğin Claude Sonnet 4 bunu yanlış yaptı. Elbette bir hesap makinesi kullanabilirim, ancak burada amaç, modelin probleme nasıl yaklaştığını ve gerekirse araçlara başvurup başvuramayacağını ya da zincirleme düşünme yoluyla doğrudan çözüp çözemeyeceğini görmek.
Bakalım Grok 4 nasıl yanıtladı:
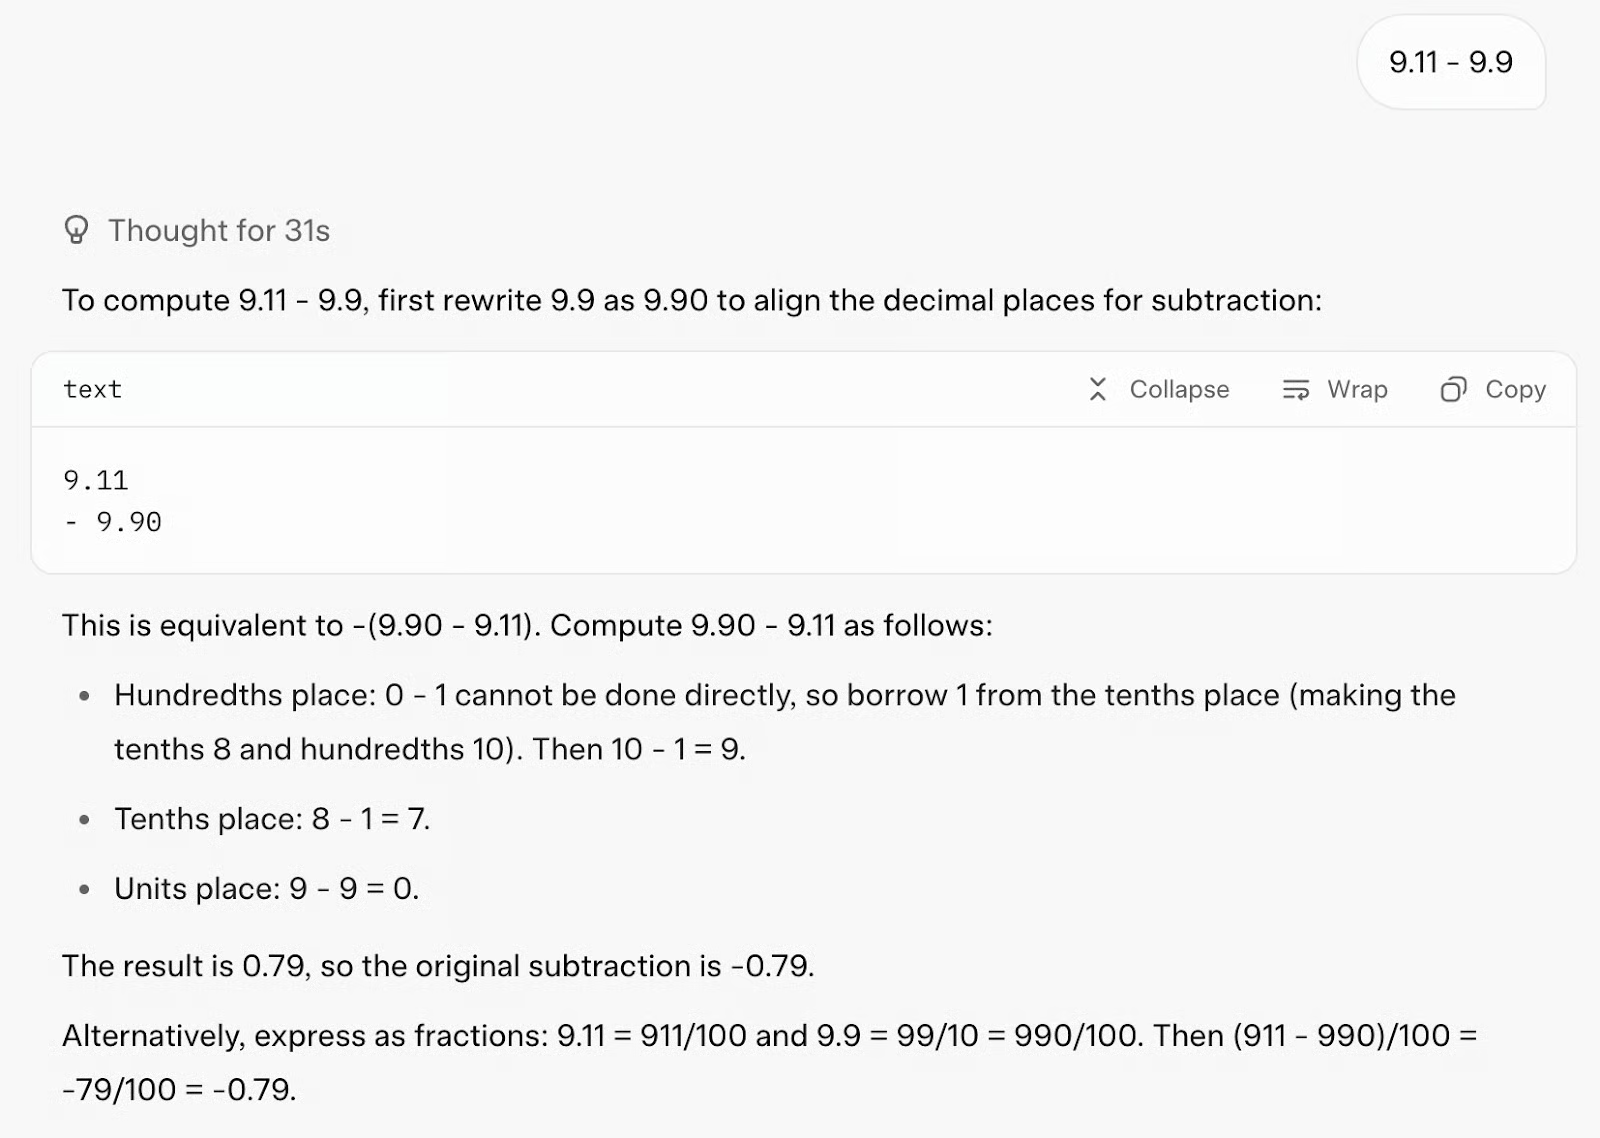
İlk denemede doğru cevap verdi. Cevabı zincirleme düşünme yoluyla buldu ve ayrıca bir kod aracını kullanarak yanıtı doğruladı (harika!).
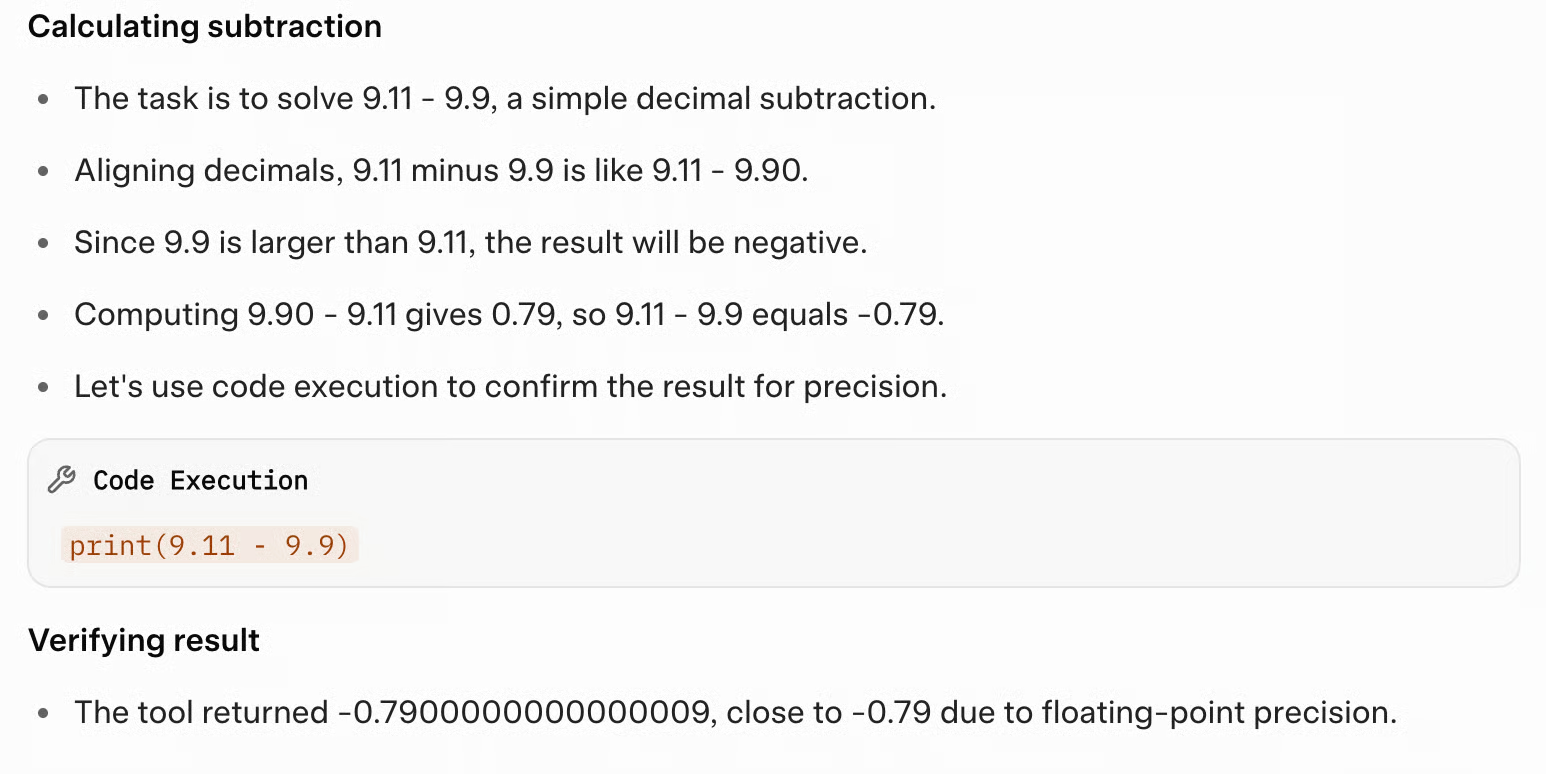
Ancak yanıt vermesi 31 saniye sürdü ve bu kadar basit bir istem için çıktı gereğinden uzundu.
Sonraki adımda, genellikle bir modelin bağlam penceresini zorlayabilen daha karmaşık bir matematik problemini Grok 4’te test etmek istedim:
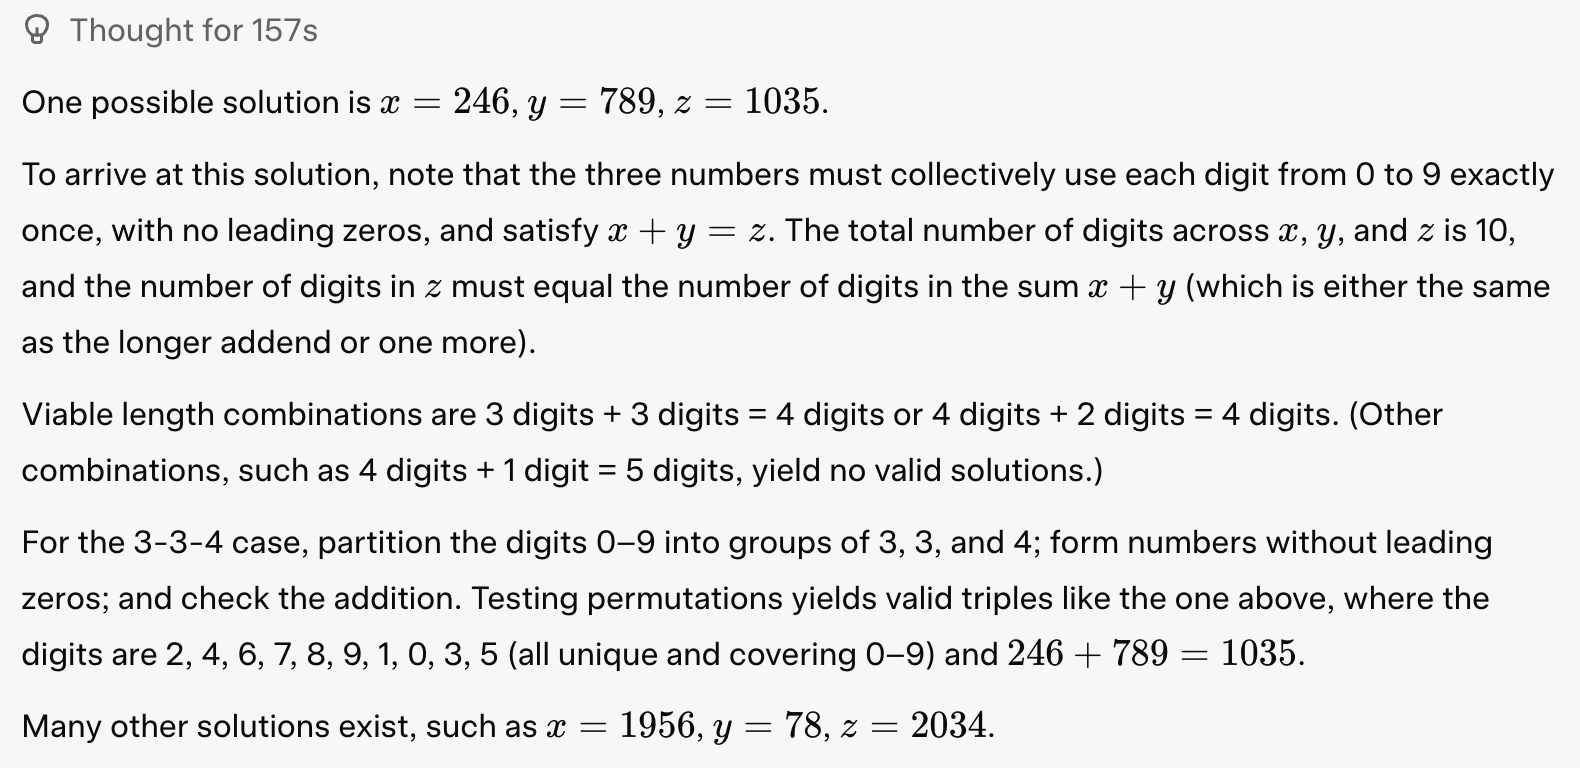
İstem: 0’dan 9’a kadar tüm rakamları tam olarak birer kez kullanarak x, y, z olmak üzere üç sayı oluşturun; öyle ki x + y = z olsun.
Grok 4 probleme akıllıca yaklaştı. Önce, 0–9 sayılarının tüm 3.628.800 permütasyonunu Python ile birkaç saniyede oluşturabileceğini fark etti. Sonra toplamı 4 basamaklı bir sayı olan iki 3 basamaklı sayı kurulumunu denedi ve 96 geçerli çözüm döndüren bir kod yazdı!
from itertools import permutations

digits = range(10)

solutions = []

for p in permutations(digits):
    x_digits = p[0:3]
    if x_digits[0] == 0: continue
    y_digits = p[3:6]
    if y_digits[0] == 0: continue
    z_digits = p[6:10]
    if z_digits[0] == 0: continue
    x = int(''.join(map(str, x_digits)))
    y = int(''.join(map(str, y_digits)))
    z = int(''.join(map(str, z_digits)))
    if x + y == z:
        solutions.append((x, y, z))

print(solutions)
Ardından, aynı yaklaşımla (4 basamaklı artı 2 basamaklı eşittir 4 basamaklı gibi) diğer kombinasyonları denedi. Sonunda, bu matematik bulmacası hakkında daha fazlasını bulmak ve yanıtını doğrulamak için web’i aradı. Bu yanıtı sunması toplam 157 saniye sürdü:
Kodlama görevi için, bu görevde Gemini 2.5 Pro ve Claude Opus 4 ile nasıl karşılaştırdığını görmek istedim:
İstem: Bana etkileyici bir sonsuz koşucu oyunu yap. Ekranda temel talimatlar olsun. p5.js sahnesi, HTML yok. Piksel dinozorları ve ilginç arka planları seviyorum.
İşte sonuç:
Gayet iyi!
Son olarak, Grok 4’ün uzun bağlamlı çok modlu görevleri ne kadar iyi yönettiğini görmek istedim. Avrupa Komisyonu’nun Üretken Yapay Zekâ Görünüm Raporunu (43.087 token) içeren bir PDF yükledim ve Grok’tan şunları istedim:
İstem: Bu raporun tamamını analiz et ve en bilgilendirici üç grafiği belirle. Her birini özetle ve PDF’nin hangi sayfasında göründüklerini belirt.
Önce yanıta bakalım, sonra irdeleyelim:
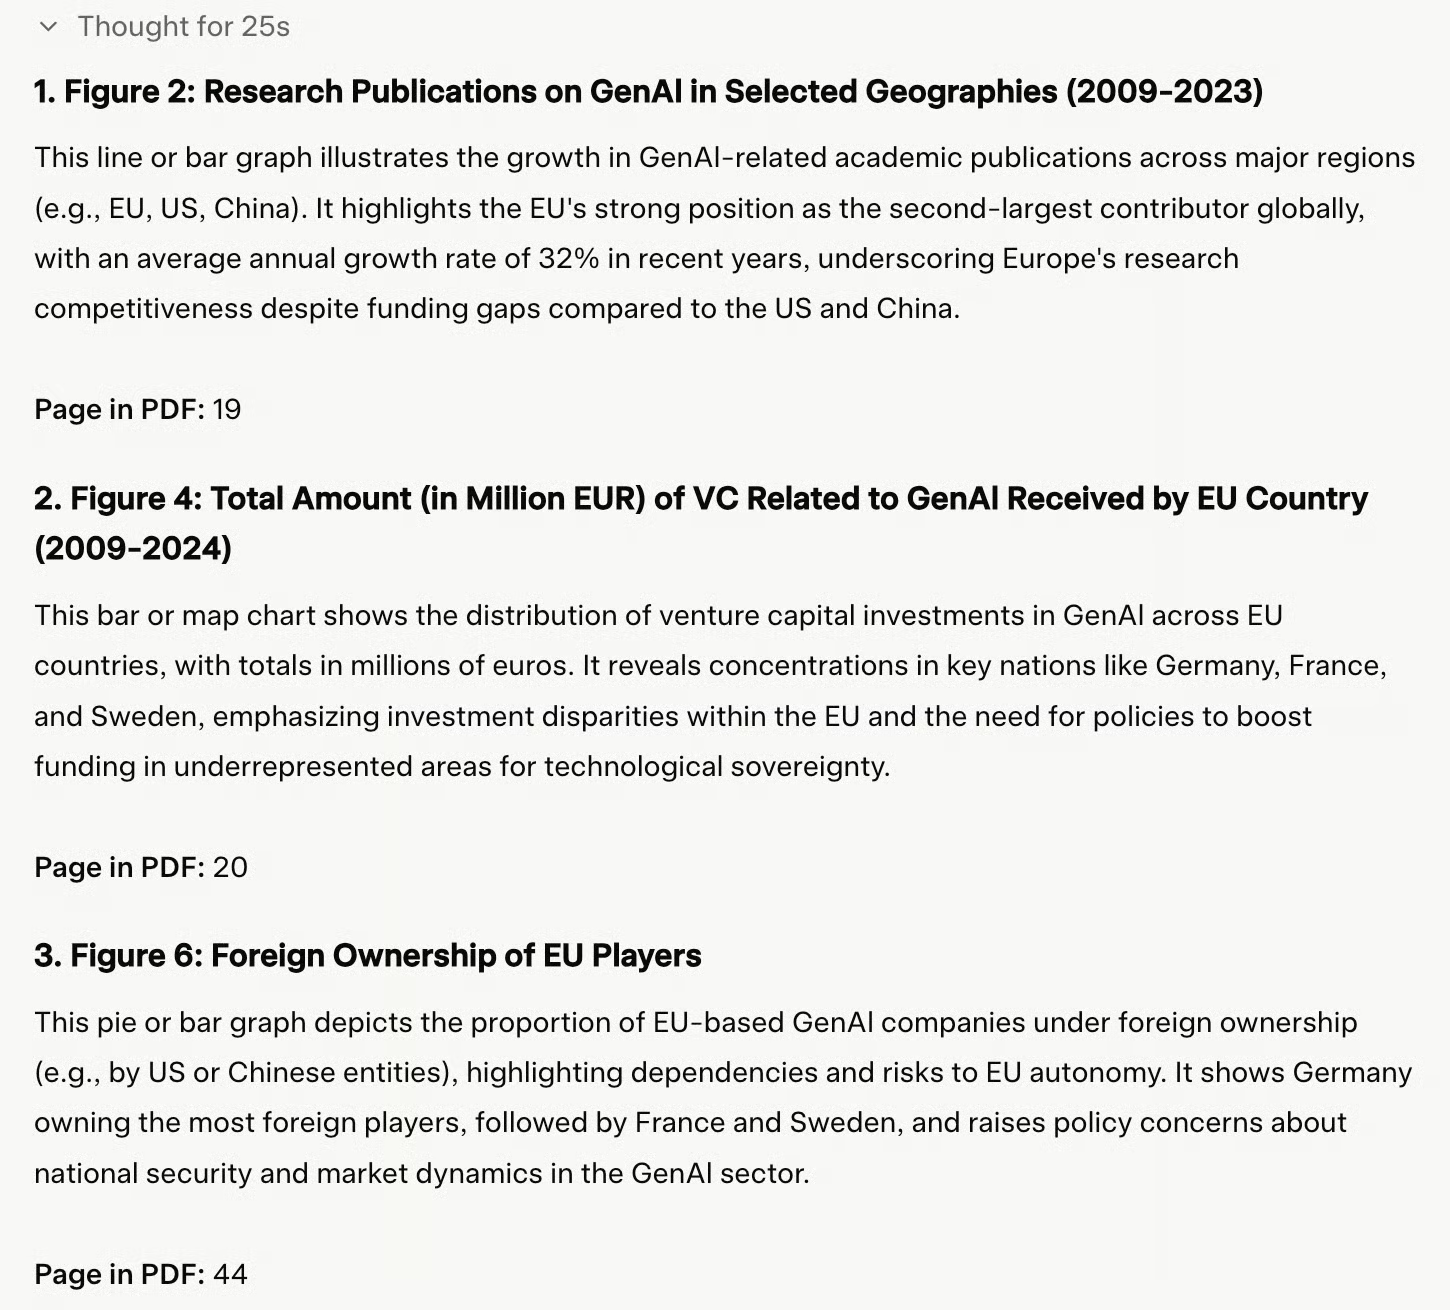
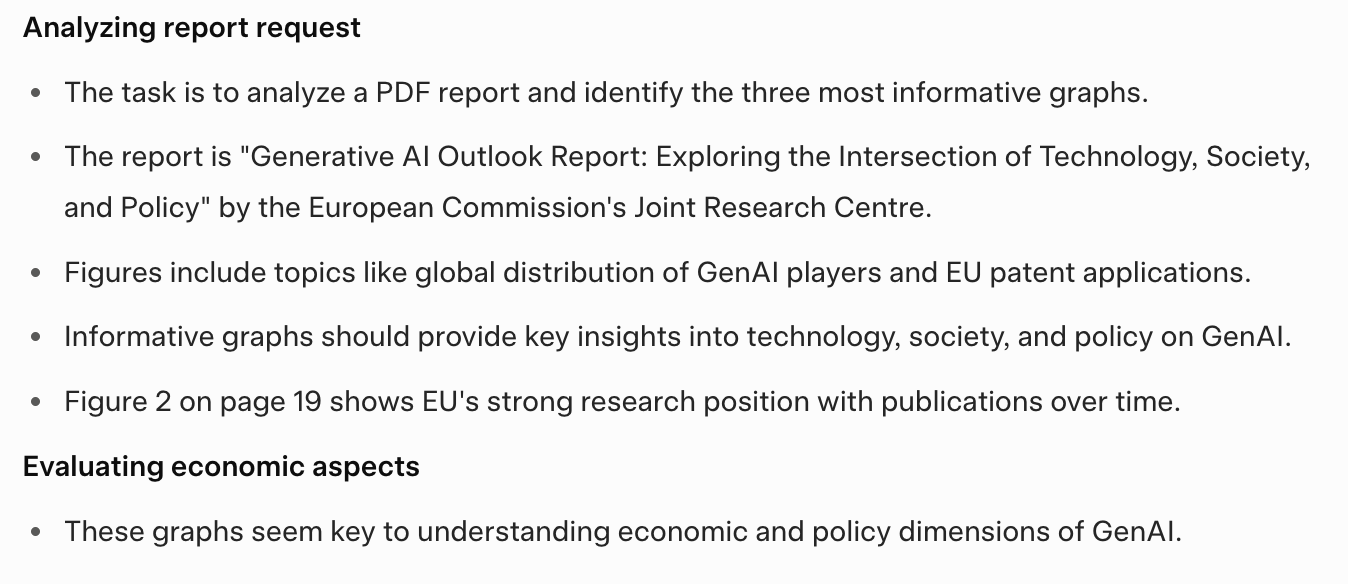
Dikkatimi çeken şeylerden biri, yalnızca 25 saniye sonra şaşırtıcı derecede çabuk durması oldu. 19, 20 ve 44. sayfalardaki (yanlış) grafikleri önerdi ve tatmin edici görünen bir yanıta ulaşır ulaşmaz 167 sayfalık belgenin geri kalanını yok saymış gibi göründü. Zincirleme düşünme eksik hissettiriyor ve oldukça yüzeysel bir yaklaşıma işaret ediyor:
Şimdi sonuçlara geçelim:
Elon Musk’ın canlı yayında belirttiği gibi, Grok 4’ün görsel anlama ve üretimi hâlâ çok ileri düzeyde değil. Sürekli ve güvenilir sonuçlar istiyorsanız, şu anda Grok 4’ün esasen metin tabanlı bir model olduğunu söylemek bence adil.
Grok 4’ün asıl ünü, akademik sınavlardan iş simülasyonlarına kadar geniş bir karışımda sergilediği performans. xAI’ye göre model, esasen daha fazla hesap gücü sayesinde—hem eğitim hem çıkarım sırasında—önceki sürümlere göre önemli ölçüde iyileşiyor; yeni mimari atılımlar nedeniyle değil.
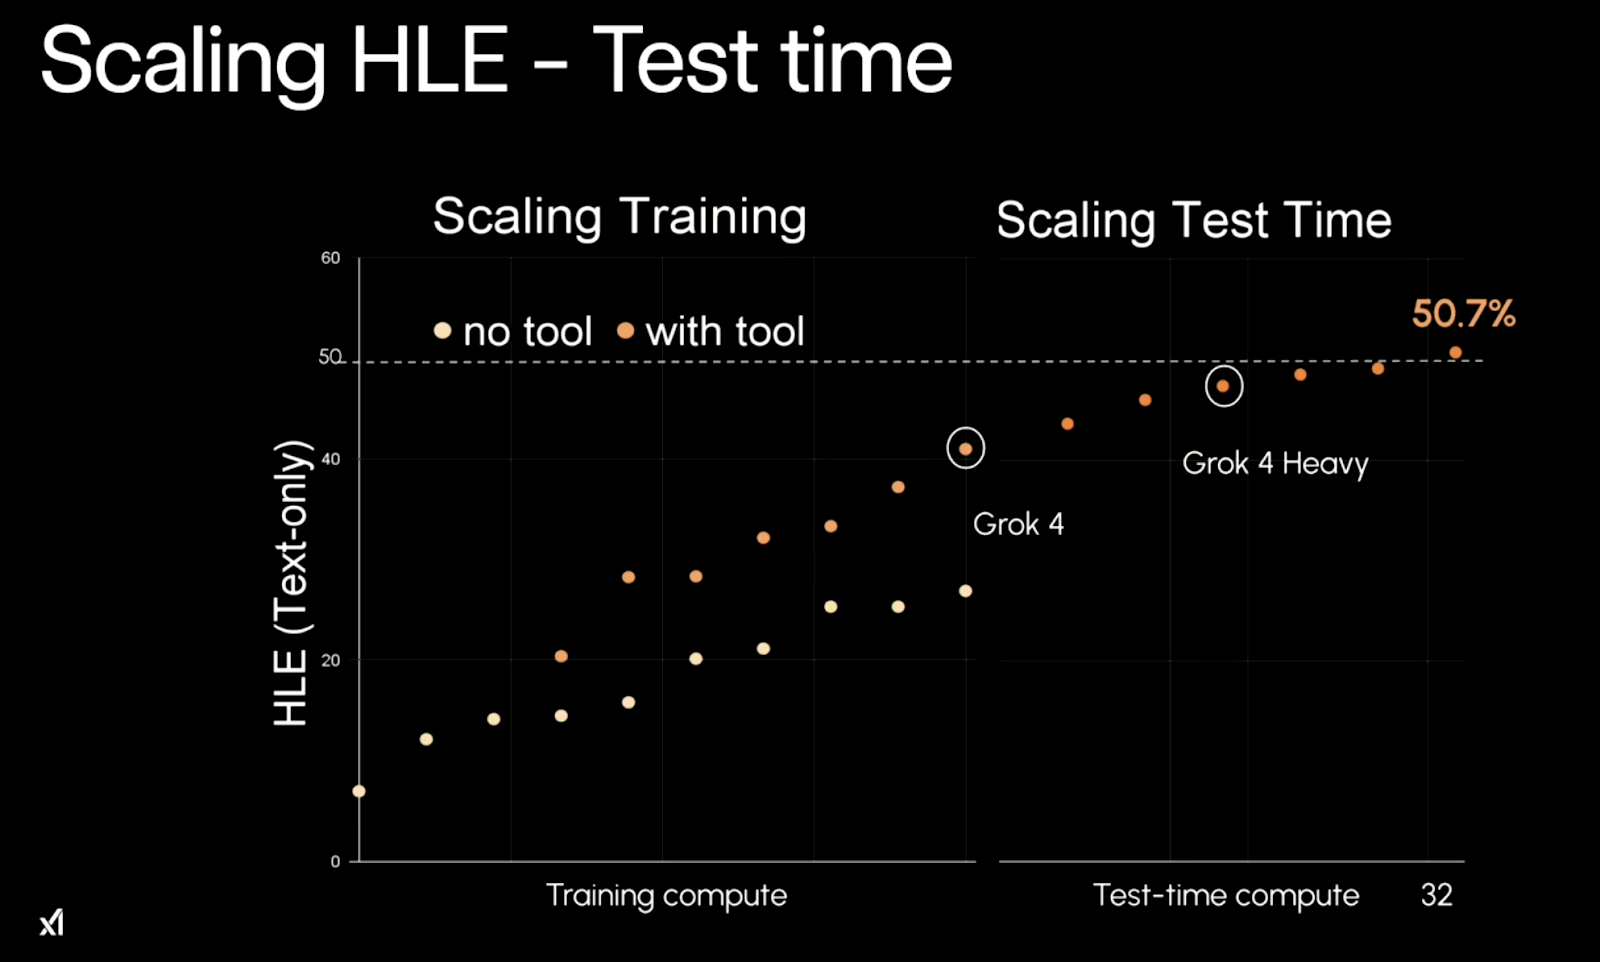
Grok 4’ün performansının ardındaki temel desen ölçekleme. Daha fazla eğitim hesabından ve daha da ilginci, daha fazla test zamanı hesabından faydalanıyor. Basitçe söylemek gerekirse: Ne kadar fazla kaynak ayırırsanız, o kadar iyi performans gösteriyor. Bu, özellikle Humanity’s Last Exam (HLE) görevlerindeki performansında net.
Kaynak: xAI
Araç kullanımı olmadan Grok 4 yaklaşık %26,9 doğrulukta plato yapıyor. Araçlar etkinleştirildiğinde (ör. kod çalıştırma), %41,0’a ulaşıyor. Çok ajanlı “Heavy” konfigürasyonunda ise %50,7’ye tırmanıyor—önceki araçsız en iyi model puanlarının iki katından fazla olan büyük bir sıçrama.
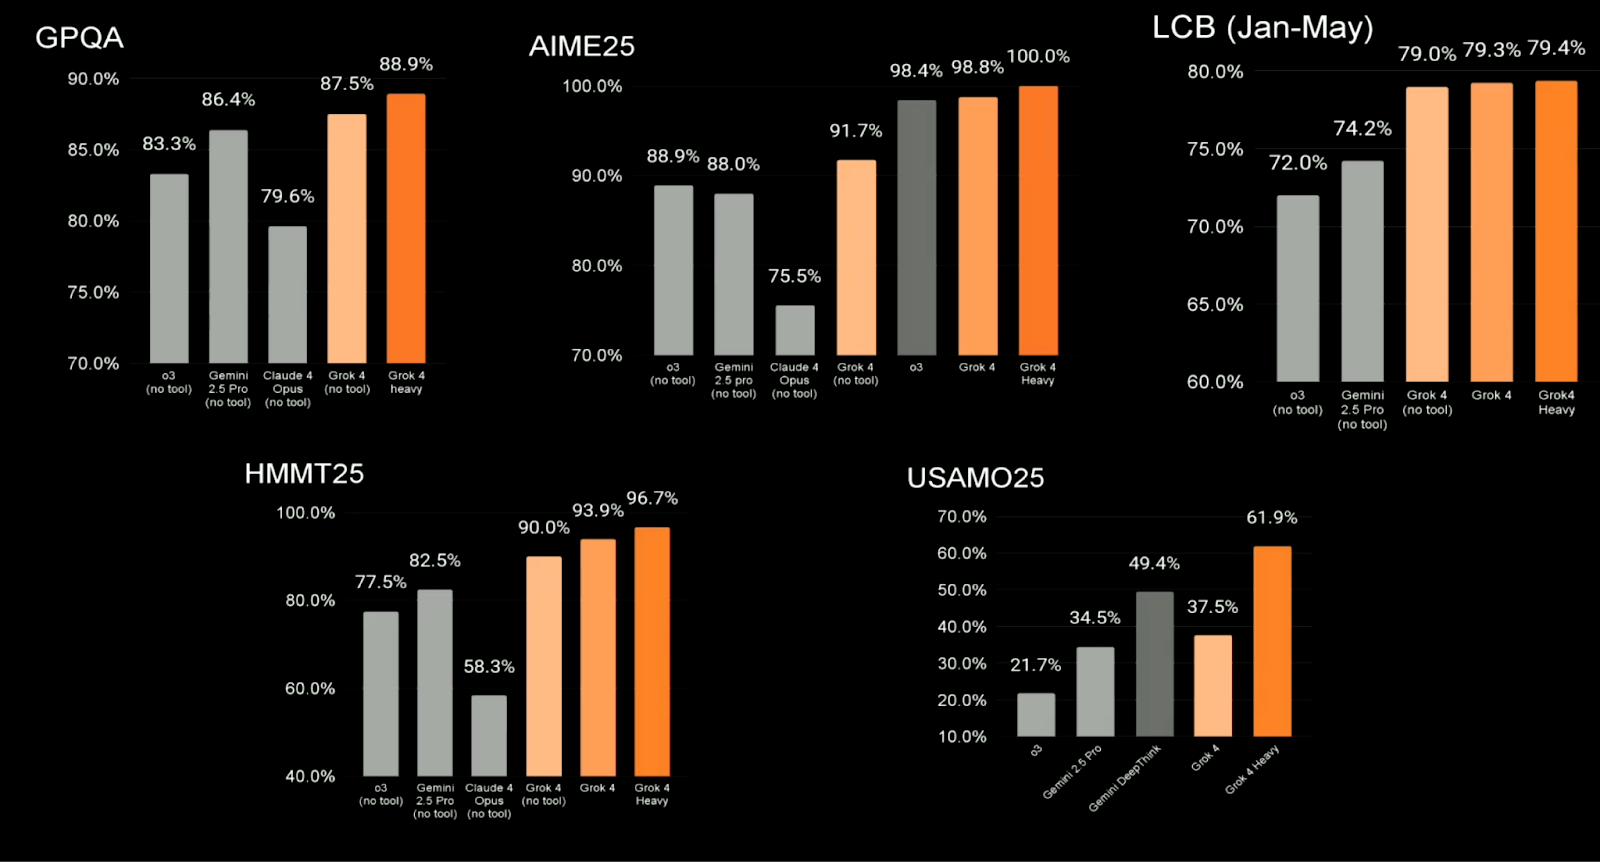
Grok 4, alanda yüksek performanslı LLM’leri karşılaştırmak için kullanılan daha geleneksel STEM odaklı değerlendirmelerde de iyi iş çıkarıyor. Öne çıkanlar şunlar:
|
Kıyaslama |
En İyi Rakip Modeller |
Grok 4 (Araçsız) |
Grok 4 Heavy |
|
GPQA |
%79,6–%86,4 |
%87,5 |
%88,9 |
|
AIME25 |
%75,5–%98,8 |
%91,7 |
%100,0 |
|
LCB (Oca–May) |
%72,0–%74,2 |
%79,0 |
%79,4 |
|
HMMT25 |
%58,3–%82,5 |
%90,0 |
%96,7 |
|
USAMO25 |
%21,7–%49,4 |
%37,5 |
%61,9 |
Bunlar sağlam sonuçlar. Grok 4, çoğu kategoride Claude Opus, Gemini 2.5 Pro ve GPT-4 (o3)’ü geride bırakıyor; ancak bazı kullanıcılar karşılaştırmaların rakip modellerden seçmece başlangıç puanları içerebileceğini belirtti.
Kaynak: xAI
Daha zor ve opak kıyaslamalardan biri, bir modelin soyut akıl yürütme görevleri arasında genelleme yapabilme yeteneğini test eden ARC-AGI’dir. ARC-AGI v1’de Grok 4 %66,6 puan alarak tüm bilinen akranlarının önünde yer alıyor. ARC-AGI v2’de ise %15,9 puan alıyor; Claude 4 Opus’un %8,6’sına kıyasla.
Bu testler tamamen kamuya açık değil, bu nedenle olağan çekinceler geçerli. Ancak rakamlar doğrulanırsa Grok 4, çok adımlı, mantık ağırlıklı akıl yürütme görevlerinde güçlü performans sergiliyor.
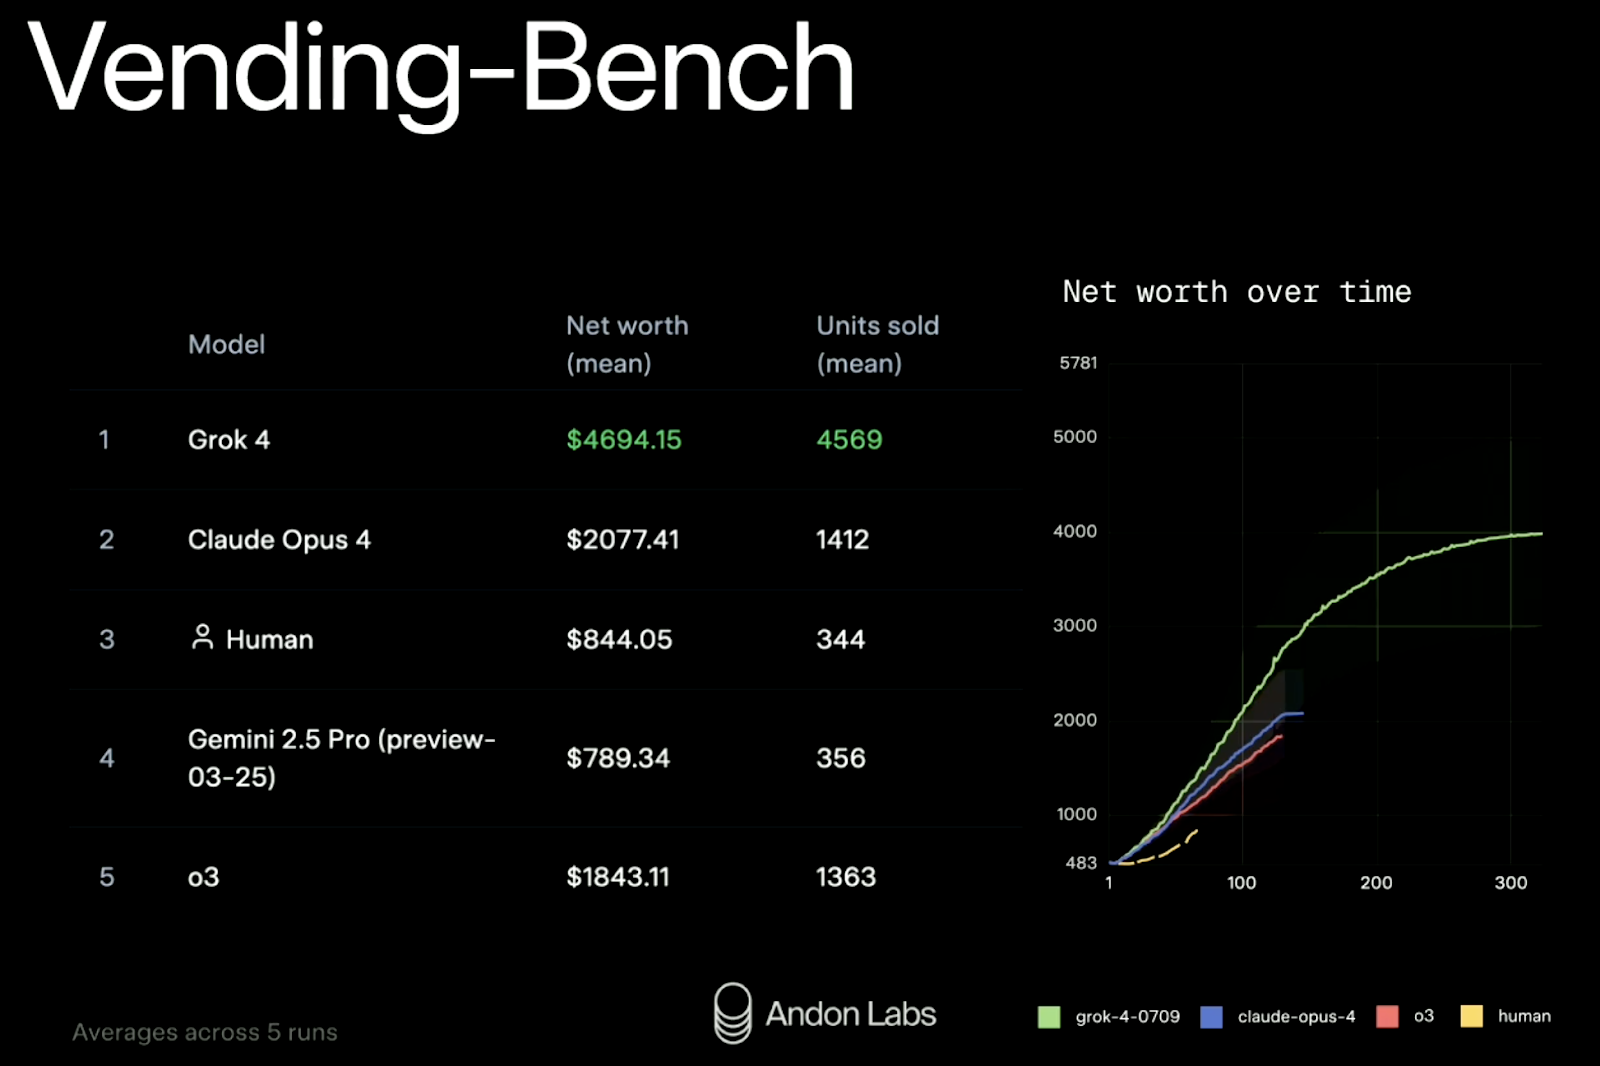
xAI, Grok 4’ü ayrıca Vending-Bench adlı gerçek dünya simülasyonunda test etti. Amaç, bir modelin zaman içinde küçük bir işletmeyi yönetip yönetemeyeceğini görmek: stoğu yenilemek, fiyatları ayarlamak, tedarikçilerle iletişime geçmek vb. Oldukça yeni ve şaşırtıcı derecede eğlenceli bir kıyaslama. Daha önce, haftalık bültenimiz The Median’da bir Claude Sonnet 3.7 vaka incelemesi üzerinden nasıl çalıştığını ayrıntılı biçimde ele almıştık.
Sonuçlar (beş koşunun ortalaması):
|
Sıra |
Model |
Net Servet |
Satılan Birim |
|
1 |
Grok 4 |
$4.694 |
4.569 |
|
2 |
Claude Opus 4 |
$2.077 |
1.412 |
|
3 |
İnsan temel |
$ 844 |
344 |
|
4 |
Gemini 2.5 Pro |
$ 789 |
356 |
|
5 |
GPT-4 (o3) |
$1.843 |
1.363 |
Grok 4, hem gelir hem ölçek açısından en yakın rakibinin performansını ikiye katladı. Ayrıca 300 tur süren simülasyon boyunca performansını tutarlı şekilde korudu—birçok model, uzun ufuklu planlama söz konusu olduğunda bununla mücadele ediyor.
Kaynak: xAI
Kısacası: Grok 4, xAI’nin test ettiği yerlerde iyi performans gösteriyor. Ancak her zaman olduğu gibi, sadece sıralamaların ötesine bakmalısınız. Kıyaslamalar umut verici, fakat hikâyenin tamamını anlatmıyor—özellikle kullanım senaryonuz görme, kod üretimi veya dağınık ortamlarda gerçek zamanlı etkileşime dayanıyorsa.
Grok 4’e artık üç ana giriş noktası üzerinden ulaşılabiliyor: X uygulaması, xAI API ve grok.com platformu. Modelle sohbet etmek, onunla geliştirme yapmak veya akıl yürütme yeteneklerini daha resmî şekilde test etmek isteyin, işte nasıl başlayacağınız.
Grok 4’ü denemenin en kolay yolu X uygulaması (eski adıyla Twitter) üzerinden. Bu, size ChatGPT veya Claude’a benzer bir sohbet arayüzünde Grok erişimi sağlar.
Kullanmak için:
Grok 4’ü doğrudan grok.com üzerinden de kullanabilirsiniz; bu platform X dışında daha sade, bağımsız bir arayüz sunuyor. Dikkat dağıtmayan bir kurulum tercih eden kullanıcıları hedefliyor.
Grok’u kendi uygulamanıza veya iş akışınıza entegre etmek istiyorsanız xAI API’yi kullanabilirsiniz.
Adımlar:
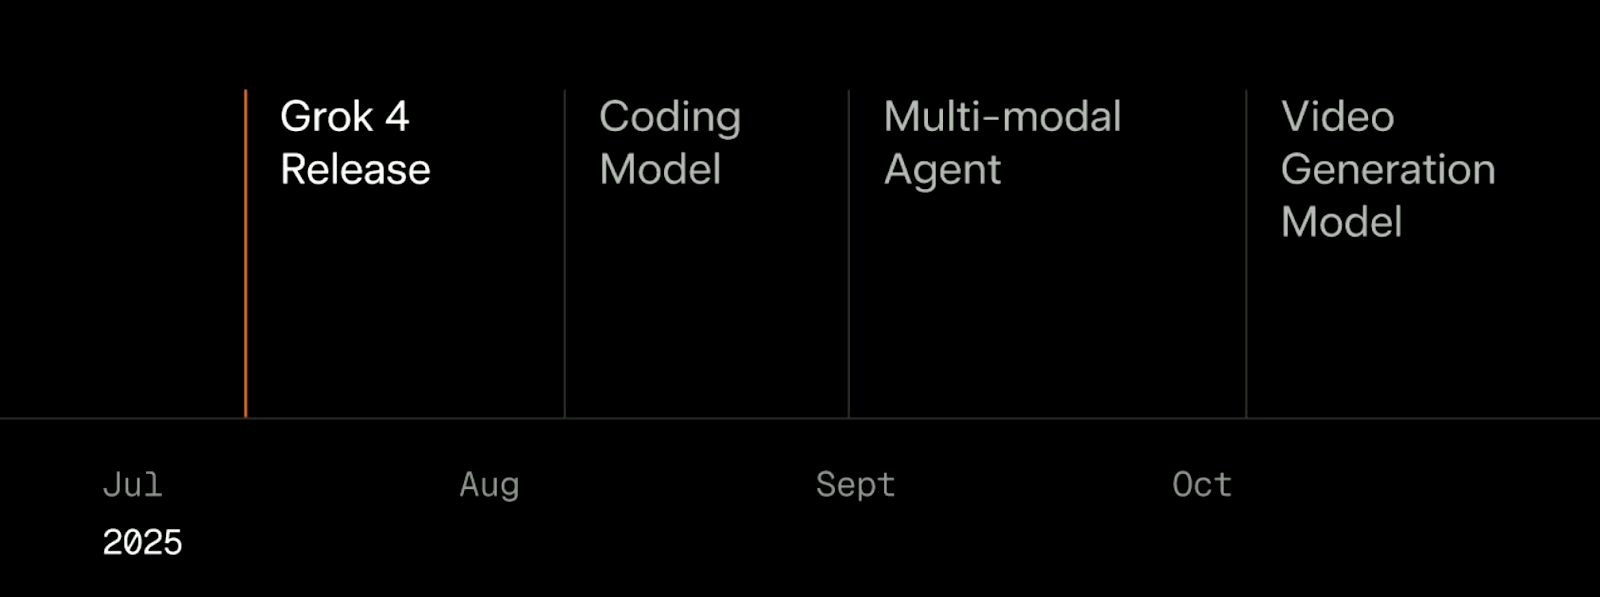
Grok 4 yayımlandıktan sonra, xAI 2025’in geri kalanı için net (ve iddialı) bir yol haritası ortaya koydu. Canlı yayında gösterilen zaman çizelgesine göre, önümüzdeki üç ayda dört büyük sürüm sıralandı: Ağustos’ta bir kodlama modeli, Eylül’de çok modlu bir ajan ve Ekim’de bir video üretim modeli.
Kaynak: xAI
İlk takip sürümü, Ağustos’ta beklenen kod odaklı bir model. Genelci olan Grok 4’ten farklı olarak bu, kodu daha hızlı ve daha doğru işlemek üzere tasarlanmış uzman bir model olacak. xAI bunu “hızlı ve akıllı” olarak tanımladı; yazılım geliştirme iş akışlarında hem gecikmeyi hem akıl yürütmeyi iyileştirmek üzere özel olarak eğitilmiş.
Eylül’de plan, gerçekten çok modlu bir ajanın yayımlanması. Şu an Grok 4 teknik olarak görüntü ve video girdilerini destekliyor, ancak anlayışı sınırlı—ekip canlı yayında bunu “buzlu camdan kısarak bakmak” olarak tanımladı.
Gelecek sürüm bunu düzeltmeyi, modele görüntü, video ve ses genelinde daha güçlü bir algı kazandırmayı hedefliyor. Bu, metnin ötesine geçen kullanım senaryoları için kilit önemde olacak: robotik, oyun oynama, video QA veya görsel talimat takibi gibi düşünün.
Mevcut zaman çizelgesindeki son sürüm, Ekim’de çıkacak bir video üretim modeli. xAI, bunu 100.000’den fazla GPU üzerinde eğiteceklerini söylüyor. Açıklamalarına göre bu sistem, yüksek kaliteli, etkileşimli ve düzenlenebilir video içerik üretmeyi hedefleyecek.
Grok 4, xAI için ciddi bir ileri adım. Birkaç yüksek zorluklu kıyaslamada rakiplerini geride bırakıyor, yapılandırılmış matematik ve bilim değerlendirmelerinde iyi dayanıyor ve araştırma ortamları ile uzun ufuklu düşünme için umut vaat eden çok ajanlı bir sistemi (Grok 4 Heavy) tanıtıyor.
Bununla birlikte, günlük genel amaçlı asistanınız değil. Grok 3’ten daha yavaş, görüntü ve video anlama yetileri hâlâ erken aşamada ve günlük kullanılabilirlik açısından biraz ciladan yoksun. Nispeten sınırlı bağlam penceresi nedeniyle özenli istemlemeye ve girdilerinizi budamaya ihtiyacınız olacak. Ve en iyi performansı—Grok 4 Heavy üzerinden—istiyorsanız bunun için prim ödeyeceksiniz.
Geliştiriciler ve araştırmacılar için keşfetmeye değer. Gündelik kullanıcılar içinse Grok 3’ün veya diğer ana akım modellerin hızı ve tepkiselliği daha uygun. Yol haritası iddialı; Ekim’e kadar bir kodlama modeli, çok modlu ajan ve video üretici geliyor. xAI’nin bunları zamanında sunup sunamayacağı ayrı bir soru. Ancak Grok 4 ile en azından yarışta olduklarına dair ikna edici bir tablo çizdiler.
Bu kurslarla yapay zekâyı öğrenin!
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



