
Kursus
Pemrosesan Bahasa Lisan dengan Python
4 Hr
9.3K
Streaming ucapan-ke-teks kini menjadi ajang persaingan ketat. OpenAI, Google, ElevenLabs, Meta, dan Deepgram semuanya merilis model transkripsi waktu nyata, dan Artificial Analysis kini memeringkat puluhan di antaranya pada satu indeks tingkat kesalahan kata. Model terbaru SpaceXAI, Grok Voice Transcribe 2.0, kini menempati posisi teratas pada indeks tersebut.
Di artikel ini, saya akan membahas semua hal baru di Grok Voice Transcribe 2.0: menyoroti fitur-fitur barunya, meninjau tolok ukur publik dan internal, serta mengulas harga dan akses API. Anda juga dapat melihat panduan kami untuk API Grok Voice Think Fast 2.0 dan API GPT Live Transcribe.
Grok Voice Transcribe 2.0 adalah model ucapan-ke-teks generasi kedua dari SpaceXAI, dan model yang kini disebut xAI sebagai model transkripsi terbaiknya. Model ini dibangun di atas model fondasi audio yang digunakan Grok Voice, yang menurut SpaceXAI sudah menangani puluhan ribu panggilan dukungan pelanggan per hari, mentranskripsi jutaan jam narasi video, dan menjalankan asisten Grok di kendaraan Tesla.
Yang berubah dari 1.0 adalah pelatihannya, bukan API-nya. SpaceXAI melatih 2.0 pada audio langsung, bising, multibahasa yang direkam di berbagai lingkungan, lalu menyempurnakannya dengan pascapelatihan yang ditujukan pada kondisi dunia nyata yang paling sulit:
Klaim utamanya adalah 2.0 dua kali lebih akurat daripada 1.0 pada evaluasi dunia nyata xAI, dengan harga yang tidak berubah dari generasi pertama. Saya akan mengulas klaim itu di bagian tolok ukur, karena papan peringkat publik menunjukkan cerita yang lebih moderat dibanding set internal.
Daftar fiturnya sama seperti yang dibawa 1.0, dan itu memang tujuannya: xAI menaruh seluruh peningkatan pada akurasi dan membiarkan permukaan API tetap sama.
Anda dapat mengirim berkas rekaman atau URL ke endpoint batch, atau melakukan streaming audio mentah melalui WebSocket dan menerima event transkrip saat pembicara masih berbicara. Keduanya menggunakan model yang sama, jadi transkrip rekaman panggilan dan transkrip panggilan langsung seharusnya terbaca sama.
Batch menerima berkas hingga 500 MB dalam 12 format audio, termasuk WAV, MP3, FLAC, dan kontainer MP4 plus PCM mentah dan codec teleponi G.711. Streaming dapat memancarkan transkrip parsial sekitar setiap 500 ms dan menandai tiap hasil sebagai potongan terkunci atau ujaran yang selesai, sehingga UI penulisan teks dapat menampilkan teks lebih awal dan menggantinya kemudian.
Setiap kata disertai waktu mulai dan selesai, dan mengaktifkan diarization menambahkan label pembicara pada tiap kata tanpa biaya tambahan. Untuk audio call center dengan agen di satu kanal dan pelanggan di kanal lain, mode multikanal mentranskripsikan hingga 8 kanal secara independen, sehingga tidak perlu diarization sama sekali.
Respons berupa satu objek JSON dengan teks penuh, bahasa terdeteksi sebagai kode BCP-47, durasi audio, dan larik kata. Tidak ada panggilan terpisah untuk timestamp.
Anda dapat meneruskan hingga 100 istilah kunci per permintaan, masing-masing hingga 50 karakter, untuk membiasakan model terhadap nama produk, nama obat, atau apa pun dalam domain Anda yang sering diucapkan dan tidak ada di kamus. Pemformatan teks menulis angka, tanggal, mata uang, nomor telepon, dan alamat email dalam bentuk tulisannya saat Anda menetapkan parameter bahasa, yang didukung SpaceXAI untuk 25 bahasa.
Kata isian seperti "um" dan "uh" dihapus secara default. Itu adalah default yang tepat untuk transkrip yang dibaca manusia dan kurang tepat untuk analitik percakapan, jadi flag-nya tersedia jika Anda ingin kata isian tetap ditampilkan.
Deteksi giliran pintar memungkinkan agen suara menunggu akhir pemikiran alih-alih menyela pada setiap jeda. Anda menetapkan ambang keyakinan antara 0 dan 1, dan model hanya menandai ujaran sebagai selesai ketika tingkat keyakinannya mencapai ambang tersebut bahwa pembicara telah selesai; SpaceXAI menyarankan 0,5 untuk penggunaan seimbang dan 0,7 saat orang mendikte angka atau alamat.
Timeout pendamping memaksa giliran berakhir setelah jeda hening tetap, sehingga penelepon yang menjauh tidak menggantungkan sesi. Tanpa giliran pintar, endpointing default berjalan setelah 400 ms keheningan, yang baik untuk perintah pendek namun menyulitkan siapa pun yang membacakan nomor telepon.
Model secara otomatis mendeteksi bahasa dan menangani peralihan bahasa dalam satu rekaman dalam satu proses, tanpa petunjuk bahasa. SpaceXAI menyebut akurasi multibahasa sebagai peningkatan terbesar dibanding 1.0, dan angka frasa pendek pada bagian berikutnya mendukung hal itu.
Satu catatan: parameter bahasa tetap penting untuk pemformatan. Tetapkan saat Anda menginginkan angka dan mata uang dalam bentuk tulisannya, dan biarkan kosong saat audio mencampur bahasa dan Anda lebih memilih kata mentahnya.
Grok Voice Transcribe 2.0 memimpin papan peringkat streaming publik untuk akurasi dan mengungguli 1.0 pada setiap set internal yang dilaporkan SpaceXAI, tetapi besarnya peningkatan sangat bergantung pada audio yang diuji.
Pada indeks ucapan-ke-teks streaming milik Artificial Analysis, Grok Voice Transcribe 2.0 mencatat word error rate (WER) sebesar 2,7%, terendah dari 34 model streaming yang tercantum per 21 September 2026. Muse Voice Transcribe dari Meta menyusul di 3,1%, ElevenLabs Scribe v2 Realtime di 3,6%, dan Grok Voice Transcribe 1.0 di 3,9%. Pengumuman SpaceXAI menghitung 32 model pada papan peringkat yang sama saat peluncuran.
Apa yang diukur WER: WER adalah porsi kata yang salah dikenali model, sehingga semakin rendah semakin baik.
Apa yang diukur indeks ucapan-ke-teks: Indeks Artificial Analysis merata-ratakan WER di 3 set uji (AA-AgentTalk, VoxPopuli, dan Earnings-22). Keunggulan Grok 2.0 paling lebar ada di VoxPopuli, dengan WER 1,4% yang kurang dari setengah 3,1% milik 1.0.
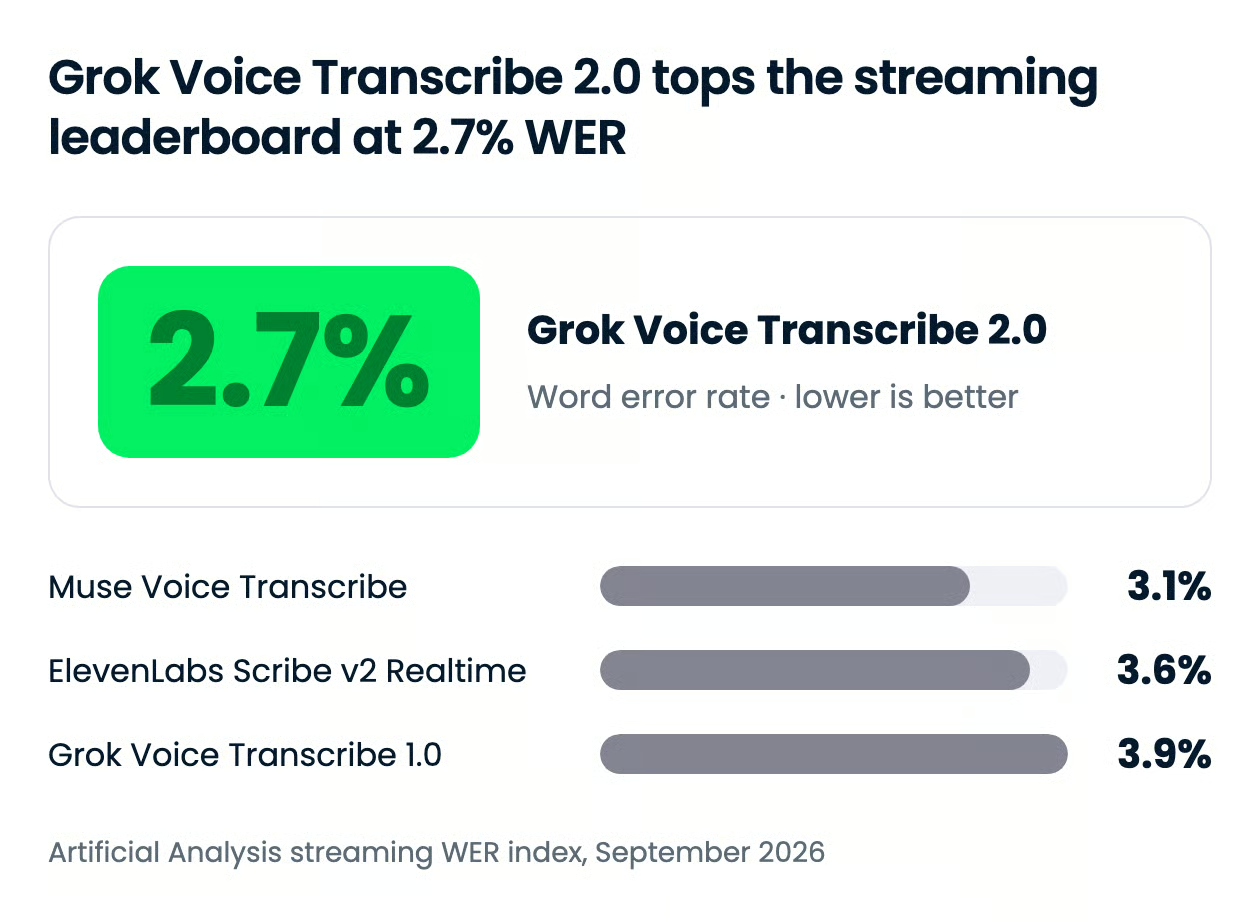
Jarak ke 1.0 pada indeks ini adalah 31%, bukan 2x seperti yang disoroti pengumuman. Klaim yang lebih besar itu berasal dari set produksi milik SpaceXAI sendiri, yang saya bahas berikutnya. Papan peringkat yang sama juga mencatat berapa lama tiap model membutuhkan waktu untuk mengunci transkrip final, dan di sini hasilnya berbalik.
| Model | Indeks WER (transkrip final) | Waktu ke transkrip final |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2,7% | 0,49 dtk |
| Muse Voice Transcribe (Meta) | 3,1% | 0,16 dtk |
| ElevenLabs Scribe v2 Realtime | 3,6% | 0,14 dtk |
| Grok Voice Transcribe 1.0 | 3,9% | 0,37 dtk |
| Deepgram Flux | 7,4% | 0,02 dtk |
Latensi adalah biayanya. Grok 2.0 membutuhkan 0,49 dtk untuk mengembalikan transkrip final, dibanding 0,37 dtk untuk 1.0 dan 0,14 dtk untuk Scribe v2 Realtime. Untuk teks takarir itu nyaris tak terlihat. Untuk agen suara yang harus merespons pada tiap giliran, tambahan sepersekian detik itu akan terakumulasi.
SpaceXAI mengukur WER pada empat set internal yang diambil dari trafik produksi:
Grok Voice Transcribe 2.0 meningkat dibanding 1.0 pada keempatnya, dan pada teleponi SpaceXAI menyatakan model ini mengungguli setiap model yang mereka uji.
Satu angka yang dipublikasikan SpaceXAI dari set ini adalah hasil frasa pendek: WER turun dari 20,6% pada 1.0 menjadi 6,8% pada 2.0. Perintah singkat di dalam mobil hampir tidak memberi konteks bagi model untuk mengidentifikasi bahasa, persis area di mana 1.0 kesulitan, dan peningkatan 3x di sana adalah bukti terkuat di balik klaim "dua kali lebih akurat".
Sisa bagan internal, termasuk perbandingan multibahasa terhadap ElevenLabs Scribe v2 dan Deepgram Nova-3, ditampilkan sebagai batang tanpa nilai berlabel. Saya akan memperlakukan klaim "mengungguli setiap model yang kami uji" pada teleponi sebagai klaim vendor sampai ada yang mereproduksinya pada audio panggilan mereka sendiri.
Grok Voice Transcribe 2.0 berharga $0,10 per jam audio untuk transkripsi batch dan $0,20 per jam untuk streaming, identik dengan Grok Voice Transcribe 1.0. Diarization, timestamp kata, dan pembiasan istilah kunci sudah termasuk dalam tarif tersebut, bukan ditagihkan sebagai tambahan.
| Mode | Harga | Termasuk |
|---|---|---|
| Batch (berkas atau URL) | $0,10 per jam audio | Diarization, timestamp, istilah kunci, pemformatan |
| Streaming (WebSocket) | $0,20 per jam audio | Diarization, timestamp, istilah kunci, pemformatan, giliran pintar |
Tarif tersebut termasuk yang terendah pada papan peringkat streaming. Artificial Analysis mencantumkan Grok 2.0 di $3,33 per 1.000 menit, berdampingan dengan $3,00 untuk Muse Voice Transcribe dari Meta dan $6,50 untuk ElevenLabs Scribe v2 Realtime maupun Deepgram Flux. Di antara empat model terakurat pada indeks, hanya Muse yang lebih murah, dan Muse skornya lebih rendah untuk akurasi.
Model ini tersedia umum di API SpaceXAI, tanpa daftar tunggu atau pembatasan wilayah yang disebutkan dalam pengumuman maupun dokumentasi. Tidak ada paket konsumen untuk dipilih, karena ini produk API, dan baik pengumuman maupun dokumentasi tidak menyebutkan lapisan gratis untuk ucapan-ke-teks.
Default sedang dalam transisi. SpaceXAI menyatakan 2.0 akan segera menjadi default di Speech-to-Text API dan 1.0 akan dipensiunkan dalam beberapa minggu ke depan. Sampai saat itu, ID model sebaiknya ditetapkan secara eksplisit.
ID modelnya adalah grok-voice-transcribe-2.0, diteruskan sebagai field form pada endpoint REST atau sebagai parameter kueri pada endpoint WebSocket. Untuk tetap menggunakan model lama selama masa pemensiunan, sematkan grok-voice-transcribe-1.0.
Model ini tersedia pada dua permukaan: API SpaceXAI, dengan batch di https://api.x.ai/v1/stt dan streaming di wss://api.x.ai/v1/stt, serta konsol SpaceXAI, yang memiliki playground ucapan-ke-teks langsung. Model ini belum ada di katalog OpenRouter per 21 September 2026.
Berikut panggilan batch terkecil yang mengembalikan transkrip dengan diarization:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
Untuk agen suara yang dibangun di atas API suara WebSocket xAI, lihat tutorial API Grok Voice Think Fast 2.0 kami, yang membahas model ucapan-ke-ucapan, dan panduan API Grok Voice Agent kami. Jika Anda memanggil model teks Grok dari basis kode yang sama, tutorial API Grok 4.6 kami membahas kunci dan pemanggilan alat.
Grok Voice Transcribe 2.0 adalah cara termurah untuk mendapatkan transkrip streaming terakurat di papan peringkat publik, dan kombinasi itu jarang terjadi. xAI menyatakan bahwa tumpukan suaranya ditujukan untuk bersaing dengan OpenAI, Google, dan ElevenLabs, bukan hanya model teksnya.
Saya akan beralih jika audio saya berkualitas telepon, multibahasa, atau sarat angka yang diucapkan, area di mana 2.0 unggul jauh dari 1.0 dan kebanyakan pesaing. Saya akan menunda pada agen suara yang sensitif terhadap latensi sampai xAI menutup celah dengan Scribe v2 dalam waktu ke transkrip final.
Jika Anda ingin membangun sendiri pipeline transkripsi, saya merekomendasikan kursus Spoken Language Processing in Python kami, yang membahas langkah dari berkas audio mentah hingga panggilan telepon yang ditranskripsi dan diklasifikasikan.
Belajar AI bersama DataCamp!
Kursus
Program
Kursus