Courses
Pythonで学ぶ音声言語処理
4時間
9.3K
ストリーミング音声認識は、群雄割拠のランキング争いになっています。OpenAI、Google、ElevenLabs、Meta、Deepgram がいずれもリアルタイムの文字起こしモデルを提供し、Artificial Analysis はそれら多数を単一の単語誤り率(WER)指標で評価しています。SpaceXAI の最新モデル Grok Voice Transcribe 2.0 は、その指標で首位に立ちました。
この記事では、Grok Voice Transcribe 2.0 の新機能、公開・社内ベンチマーク、価格と API アクセスについて解説します。併せて、Grok Voice Think Fast 2.0 API と GPT Live Transcribe API のガイドも参照してください。
Grok Voice Transcribe 2.0 は SpaceXAI の第 2 世代の音声認識モデルで、xAI が現時点で最良の文字起こしモデルと位置づけています。Grok Voice の背後にある音声基盤モデルを土台としており、SpaceXAI によれば、すでに毎日数万件のカスタマーサポート通話を処理し、数百万時間の動画ナレーションを文字起こしし、Tesla 車載の Grok アシスタントも動かしています。
1.0 から変わったのは API ではなく学習です。2.0 は、多様な環境で収録された実運用の騒がしい多言語音声で学習し、さらに現場で最も難しい条件に的を絞った事後学習で洗練しています:
見出しの主張は、2.0 が xAI の実運用評価で 1.0 の 2 倍の正確性を示すというもの。価格は初代から据え置きです。次のベンチマーク節でその主張を精査します。公開リーダーボードは、社内セットより控えめな差を示しています。
機能一覧は 1.0 と同じです。つまり、xAI は API の表面は変えず、改善のすべてを精度に注ぎ込みました。
録音ファイルや URL をバッチエンドポイントに送ることも、WebSocket 経由で生の音声をストリーミングして、話している最中にトランスクリプトのイベントを受け取ることもできます。どちらも同じモデルで動くため、通話録音の書き起こしとライブ通話の書き起こしは同じ内容になるはずです。
バッチは最大 500 MB、12 種類の音声形式に対応(WAV、MP3、FLAC、MP4 コンテナに加え、生の PCM と G.711 電話コーデック)。ストリーミングは約 500 ms ごとに部分的な書き起こしを出力でき、各結果にロック済みチャンクか確定発話かのタグが付くため、字幕 UI では先にテキストを出し、後から置き換えられます。
各単語には開始・終了時刻が付き、話者分離(ダイアライゼーション)を有効にすると追加料金なしで単語ごとに話者ラベルが付きます。オペレーターと顧客が別チャンネルのコールセンター音声には、最大 8 チャンネルを独立に文字起こしするマルチチャンネルモードがあり、話者分離自体を回避できます。
レスポンスは 1 つの JSON オブジェクトに、全文、検出言語(BCP-47 コード)、音声の長さ、単語配列が含まれます。タイムスタンプ用の別呼び出しは不要です。
1 リクエストにつき最大 100 個、各 50 文字までのキータームを渡して、製品名や医薬品名など辞書にない発話にバイアスをかけられます。テキスト整形は、言語パラメータを設定すると、数字・日付・通貨・電話番号・メールアドレスを記述形で出力します。これは SpaceXAI が 25 言語でサポートしています。
「えー」「あー」といったフィラーワードはデフォルトで除去されます。人が読むトランスクリプトには適切ですが、会話分析には不向きなので、必要ならフラグで復活できます。
スマートターン検出により、音声エージェントは一時停止のたびに割り込むのではなく、言い切りを待てます。0〜1 のしきい値を設定すると、モデルが話者の発話完了にその確信度で達したときだけ、発話を確定します。SpaceXAI はバランス用に 0.5、数字や住所の口述には 0.7 を推奨しています。
相棒となるタイムアウトは、一定の無音後に強制的にターンを終了させ、離席した発話者がセッションを固着させないようにします。スマートターンなしのデフォルトの終端処理は 400 ms の無音で発火します。短いコマンドには十分ですが、電話番号を読み上げる人にはつらい設定です。
モデルは言語を自動検出し、1 本の録音内での言語切り替えにも 1 パスで対応します。xAI は多言語の正確性が 1.0 からの最大の改善だと述べており、次節の短文フレーズの数値がそれを裏付けます。
注意点が 1 つ:書式設定には言語パラメータが依然として重要です。数字や通貨を記述形にしたいときは設定し、音声が複数言語を混在し素の単語を優先したいときはオフにします。
Grok Voice Transcribe 2.0 は公開ストリーミング・リーダーボードで正確性の首位に立ち、SpaceXAI が報告するすべての社内セットでも 1.0 を上回りますが、差の大きさは音声の種類に大きく依存します。
Artificial Analysis のストリーミング音声認識指標で、Grok Voice Transcribe 2.0 の単語誤り率(WER)は 2.7%。2026 年 9 月 21 日時点で掲載されている 34 のストリーミングモデル中で最小です。続くのは Meta の Muse Voice Transcribe の 3.1%、ElevenLabs Scribe v2 Realtime の 3.6%、Grok Voice Transcribe 1.0 は 3.9% です。SpaceXAI の発表では、同リーダーボードのモデル数は公開時点で 32 とカウントされています。
WER が測るもの:WER はモデルが誤った単語の割合で、低いほど良好です。
音声認識指標が測るもの:Artificial Analysis の指標は、3 つのテストセット(AA-AgentTalk、VoxPopuli、Earnings-22)の WER の平均です。Grok 2.0 の最も大きなリードは VoxPopuli で、WER 1.4% は 1.0 の 3.1% の半分以下です。
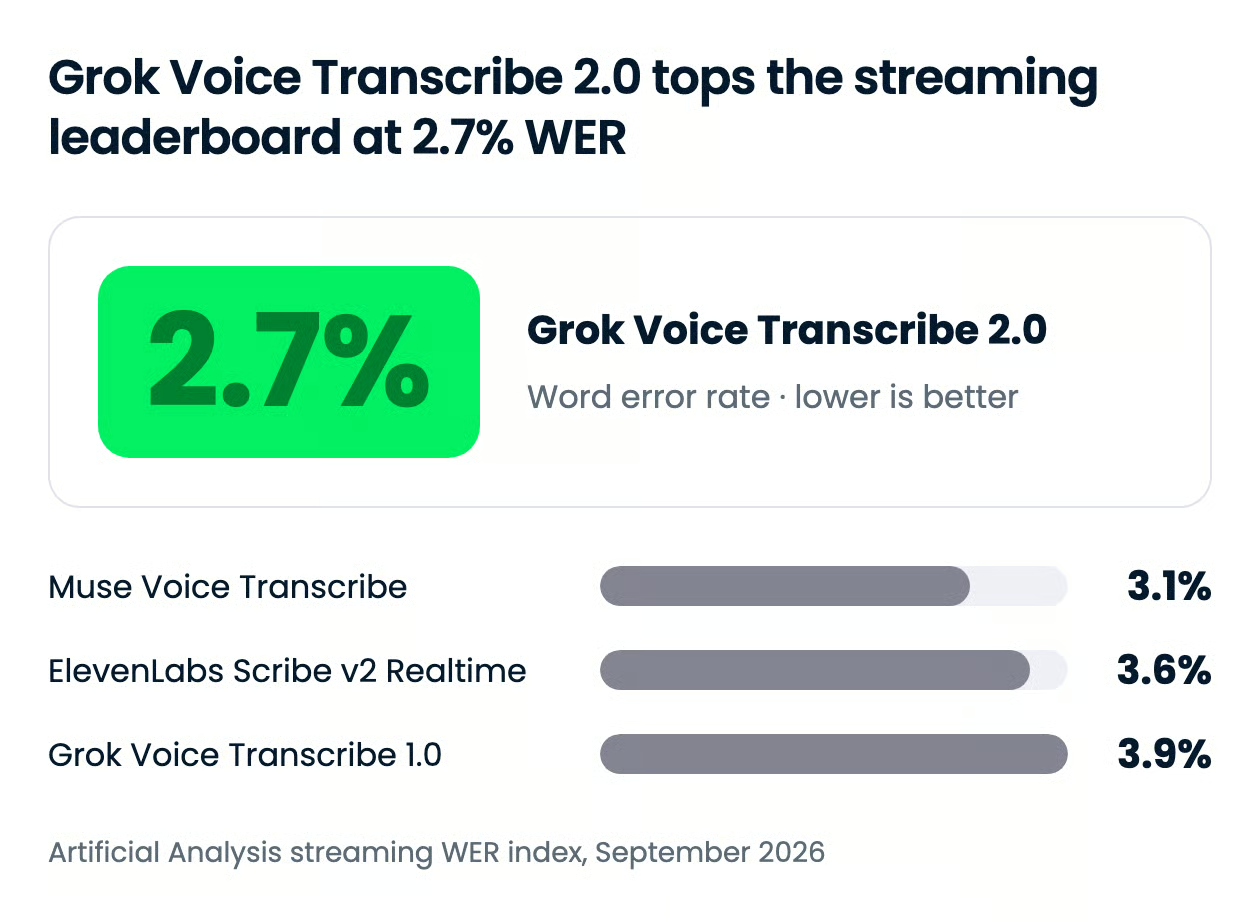
この指標で 1.0 との差は 31% で、発表が前面に出す「2 倍」とは異なります。より大きな主張は SpaceXAI の本番セットに基づくもので、次で触れます。同じリーダーボードは、各モデルが最終トランスクリプトを確定するまでの時間も記録しており、こちらは様相が逆転します。
| Model | WER index (final transcript) | Time to final transcript |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2.7% | 0.49 s |
| Muse Voice Transcribe (Meta) | 3.1% | 0.16 s |
| ElevenLabs Scribe v2 Realtime | 3.6% | 0.14 s |
| Grok Voice Transcribe 1.0 | 3.9% | 0.37 s |
| Deepgram Flux | 7.4% | 0.02 s |
犠牲になるのはレイテンシーです。Grok 2.0 は最終トランスクリプトの返却に 0.49 秒、1.0 は 0.37 秒、Scribe v2 Realtime は 0.14 秒です。字幕用途では不可視でも、ターンごとに応答する必要がある音声エージェントでは、この数十分の数秒が積み重なります。
SpaceXAI は、本番トラフィックから抽出した 4 つの社内セットで WER を測定しています:
Grok Voice Transcribe 2.0 は 4 つすべてで 1.0 を上回り、テレフォニーでは SpaceXAI によればテストしたすべてのモデルをリードしています。
SpaceXAI がこれらのセットから公表する唯一の数値は短文フレーズの結果で、WER は 1.0 の 20.6% から 2.0 の 6.8% に低下しました。車内の短いコマンドは言語特定の文脈がほとんどなく、まさに 1.0 が苦手とした領域で、ここでの 3 倍の改善は「2 倍の正確性」主張の最も強い裏付けです。
その他の社内チャート(ElevenLabs Scribe v2 や Deepgram Nova-3 との多言語比較を含む)は数値ラベルのない棒グラフで提供されています。テレフォニー分野の「テストしたすべてのモデルに勝る」という主張は、誰かが自社の通話音声で再現するまではベンダーの主張として扱うのが妥当でしょう。
Grok Voice Transcribe 2.0 の料金は、バッチ文字起こしが音声 1 時間あたり $0.10、ストリーミングが 1 時間あたり $0.20 で、Grok Voice Transcribe 1.0 と同一です。ダイアライゼーション、単語レベルのタイムスタンプ、キータームのバイアスは追加課金ではなく、これらの料金に含まれます。
| Mode | Price | Included |
|---|---|---|
| Batch (file or URL) | $0.10 per hour of audio | Diarization, timestamps, key terms, formatting |
| Streaming (WebSocket) | $0.20 per hour of audio | Diarization, timestamps, key terms, formatting, smart turn |
これらの料金はストリーミング・リーダーボードの中でも低価格帯です。Artificial Analysis は Grok 2.0 を 1,000 分あたり $3.33 と記載しており、Meta の Muse Voice Transcribe は $3.00、ElevenLabs Scribe v2 Realtime と Deepgram Flux はともに $6.50 です。インデックスで最も正確な 4 モデルの中では、より安いのは Muse のみで、Muse は精度が低くなります。
モデルは SpaceXAI API で一般提供されており、発表やドキュメントにウェイトリストや地域制限の記載はありません。これは API 製品のため、コンシューマープランの選択もなく、発表やドキュメントには音声認識の無料枠についての記載もありません。
デフォルトは移行中です。SpaceXAI は、近く 2.0 が Speech-to-Text API のデフォルトとなり、1.0 は今後数週間で非推奨になると述べています。それまでは、モデル ID を明示的に設定してください。
モデル ID は grok-voice-transcribe-2.0 で、REST エンドポイントではフォームフィールド、WebSocket エンドポイントではクエリパラメータとして渡します。非推奨化の期間中も旧モデルを使い続けるには、grok-voice-transcribe-1.0 を固定してください。
提供面は 2 つあります。SpaceXAI API(バッチは https://api.x.ai/v1/stt、ストリーミングは wss://api.x.ai/v1/stt)と、ライブの音声認識プレイグラウンドを備えた SpaceXAI コンソールです。2026 年 9 月 21 日時点で OpenRouter のカタログにはありません。
以下は、話者分離付きのトランスクリプトを返す最小のバッチ呼び出しです:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
xAI の WebSocket 音声 API で構築する音声エージェントについては、音声対音声モデルを扱う Grok Voice Think Fast 2.0 API チュートリアル と、Grok Voice Agent API ガイド を参照してください。同じコードベースで Grok のテキストモデルも呼び出す場合は、Grok 4.6 API チュートリアル がキー管理とツール呼び出しを解説しています。
Grok Voice Transcribe 2.0 は、公開リーダーボードで最も正確なストリーミング文字起こしを最安クラスで提供しており、この組み合わせは希少です。xAI は、音声スタックでも OpenAI、Google、ElevenLabs と競う姿勢を、テキストモデルだけでなく明確に打ち出しています。
自分の音声が電話品質、多言語、あるいは口頭の数字が多いなら乗り換えるでしょう。最終確定までの時間に敏感な音声エージェントでは、xAI が Scribe v2 との時間差を詰めるまで様子見します。
文字起こしパイプラインを自作したい場合は、Spoken Language Processing in Python コースをおすすめします。生の音声ファイルから、通話の文字起こしと分類まで一通り扱います。
DataCamp で AI を学ぼう!
Courses
Tracks
Courses