流式语音转文本已经成为竞争激烈的榜单赛道。OpenAI、Google、ElevenLabs、Meta 和 Deepgram 都推出了实时转写模型,Artificial Analysis 现将其中数十款统一以词错误率进行排名。SpaceXAI 最新模型 Grok Voice Transcribe 2.0 现已登顶该指数。
本文将全面介绍 Grok Voice Transcribe 2.0 的更新内容,包括新功能、公开与内部基准测试结果,以及价格和 API 访问方式。您也可以参考我们的 Grok Voice Think Fast 2.0 API 指南 和 GPT Live Transcribe API 指南。
要点速览
- Grok Voice Transcribe 2.0 是 xAI 的新一代语音转文本模型,以相同的小时计费取代 1.0。
- 在 Artificial Analysis 公开榜单的流式模型中,其准确率位列第一。
- 最大提升体现在困难音频:电话线路、口述账号编码与邮箱、多语种的短指令。
- 权衡在于时延:返回最终转录的时间比 1.0 和 ElevenLabs Scribe v2 更长。
- 现有集成无需改代码即可升级,但在默认切换前应显式设置模型 ID。
- 如果您目前付费使用竞品流式转写,值得用自家音频做一场并行对比测试。
Grok Voice Transcribe 2.0 是什么?
Grok Voice Transcribe 2.0 是 SpaceXAI 的第二代语音转文本模型,也是 xAI 目前称为其最佳转写模型的产品。它基于 Grok Voice 背后的音频基础模型构建。SpaceXAI 表示,该基础模型已每天处理数万通客服来电、转写数百万小时的视频解说,并驱动特斯拉车载的 Grok 助手。
与 1.0 相比,变化在训练而非 API。SpaceXAI 使用在多种环境中采集的实时、嘈杂、多语音频训练了 2.0,并通过后训练针对最艰难的真实场景做了优化:
- 不稳定的电话线路
- 多方竞争说话
- 本地口音
- 口述的电话号码或电子邮箱地址
核心宣称是:在 xAI 的真实世界评测中,2.0 的准确率是 1.0 的两倍,同时价格与第一代保持不变。本文的基准测试部分会具体分析这一点,因为公开榜单呈现的提升幅度低于内部数据。
Grok Voice Transcribe 2.0 关键功能
功能列表与 1.0 保持一致,这正是重点:xAI 将全部升级投入到准确率,API 表面不做改动。
用同一个模型转写文件或实时音频
您可以向批处理端点发送录音文件或 URL,或通过 WebSocket 流式传输原始音频,并在说话尚未结束时持续接收转写事件。两条路径运行同一模型,因此通话录音与实时通话得到的转录应一致。
批处理支持最大 500 MB 的文件、12 种音频格式,包括 WAV、MP3、FLAC、MP4 容器,以及原始 PCM 和 G.711 电话编解码。流式模式大约每 500 毫秒输出一次部分转录,并将结果标记为锁定片段或已完成话语,便于字幕界面先早显再替换。
明确谁在何时说了什么
每个词都附带开始与结束时间,开启说话人分离后,还会为每个词添加说话人标签,且不额外收费。对于坐席与客户分居不同声道的呼叫中心音频,多声道模式可独立转写最多 8 个声道,从而完全绕开分离问题。
响应是一个 JSON 对象,包含全文、检测到的语言(BCP-47 代码)、音频时长以及词数组。无需额外调用时间戳接口。
教会它您的专有词汇
您可以在每个请求中传入最多 100 个关键词(每个最长 50 个字符),以引导模型更好识别产品名、药品名或您所在领域常说但词典未收录的术语。文本格式化在设置 language 参数后,会将数字、日期、货币、电话号码和电邮地址按书面形式输出,SpaceXAI 目前支持 25 种语言。
诸如“um”“uh”之类的语气词默认会被去除。这对供人阅读的转录是恰当的默认设置,但不适用于对话分析,如需保留语气词,可通过开关设置。
让语音代理知道来电者何时说完
智能轮次检测可让语音代理等待完整表达结束,而不是在每个停顿处都插话。您可以设置 0 到 1 的置信度阈值,模型仅在足够确信说话者已结束时,才将话语标记为完成;SpaceXAI 建议通用场景用 0.5,当人们口述数字或地址时用 0.7。
配套的超时机制会在固定静音后强制结束轮次,避免来电者走开导致会话悬停。若不启用智能轮次,默认端点在 400 毫秒静音后触发,这对短指令尚可,但对口述电话号码会很难用。
录音中途切换语言也能识别
模型可自动检测语言,并在一次录音内处理语言切换,无需语言提示。SpaceXAI 称多语种准确率是相对 1.0 的最大改进,下一节的短语测试数据也支持这一点。
需要注意:language 参数仍然影响格式化。当您希望输出书面形式的数字与货币时应设置它;当音频混用多种语言且您更希望保留原始口语时则不设。
Grok Voice Transcribe 2.0 基准测试表现如何?
Grok Voice Transcribe 2.0 在公开流式榜单的准确率上领先,并在 SpaceXAI 报告的所有内部数据集上优于 1.0,但提升幅度高度依赖具体音频类型。
公开榜单上的流式准确率
在 Artificial Analysis 的流式语音转写指数上,Grok Voice Transcribe 2.0 的词错误率(WER)为 2.7%,截至 2026 年 9 月 21 日在 34 个流式模型中最低。Meta 的 Muse Voice Transcribe 以 3.1% 紧随其后,ElevenLabs Scribe v2 Realtime 为 3.6%,Grok Voice Transcribe 1.0 为 3.9%。SpaceXAI 的发布在上线时统计了同一榜单上的 32 个模型。
WER 衡量什么:WER 是模型识别错误的词占比,数值越低越好。
语音转写指数衡量什么:Artificial Analysis 的指数对 3 个测试集(AA-AgentTalk、VoxPopuli、Earnings-22)的 WER 取平均。Grok 2.0 的优势在 VoxPopuli 上最明显,其 1.4% 的 WER 不到 1.0(3.1%)的一半。
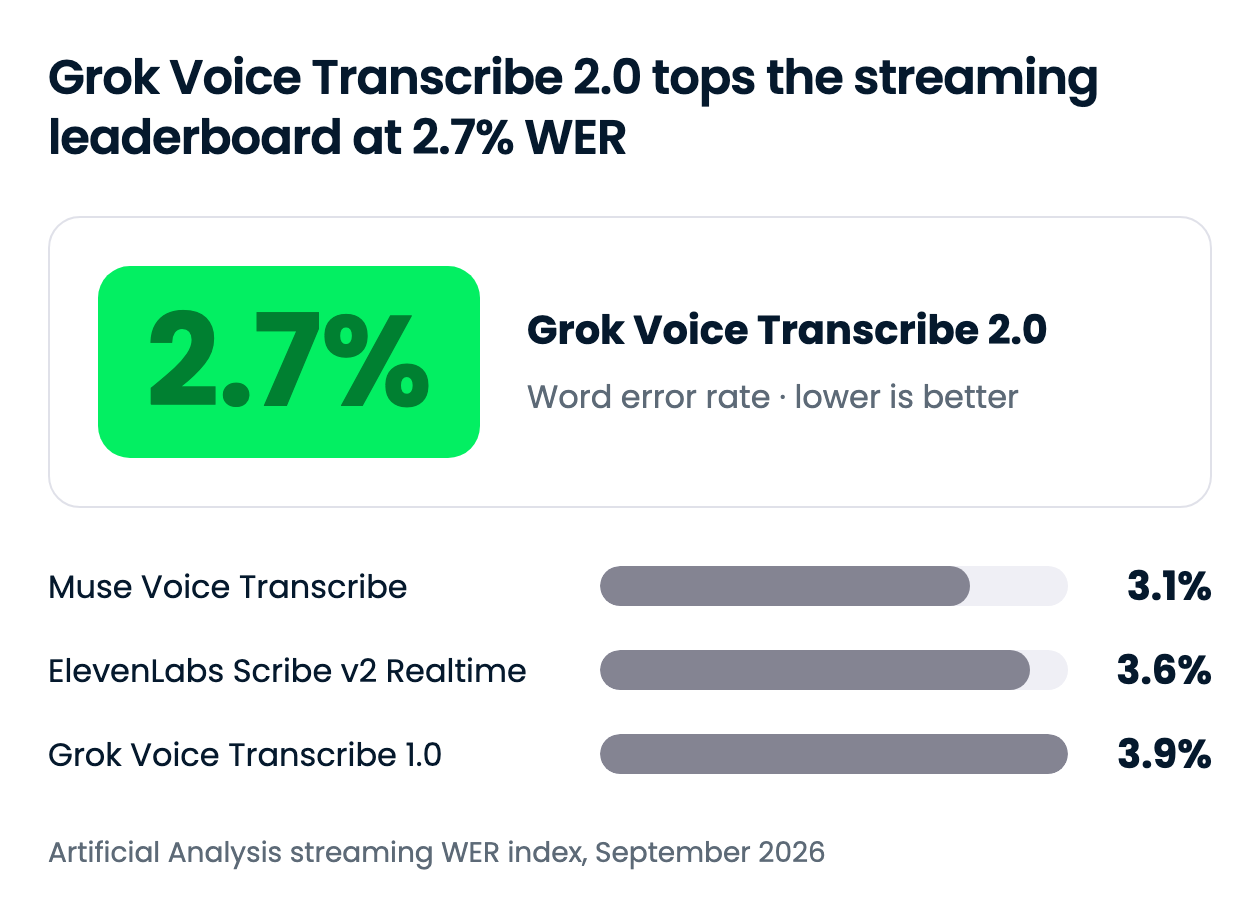
在该指数上相对 1.0 的差距为 31%,而非发布所强调的 2 倍。更大的提升来自 SpaceXAI 自有的生产数据集,下一节会介绍。同一榜单也记录了各模型提交最终转录所需时间,而在这一点上结果相反。
| 模型 | WER 指数(最终转录) | 到最终转录所用时间 |
|---|
| Grok Voice Transcribe 2.0 | 2.7% | 0.49 s |
| Muse Voice Transcribe(Meta) | 3.1% | 0.16 s |
| ElevenLabs Scribe v2 Realtime | 3.6% | 0.14 s |
| Grok Voice Transcribe 1.0 | 3.9% | 0.37 s |
| Deepgram Flux | 7.4% | 0.02 s |
代价在于时延。Grok 2.0 返回最终转录需 0.49 秒,1.0 为 0.37 秒,Scribe v2 Realtime 为 0.14 秒。用于字幕几乎无感;用于每轮都需作答的语音代理,额外的零点几秒会累计成影响。
真实世界音频:电话、凭证与短语
SpaceXAI 在四个来源于生产流量的内部数据集上测量 WER:
- 来自客服通话的 8 kHz 电话音频
- 与 Grok 的对话
- 口述的凭证(如账号编码与电子邮箱地址)
- 覆盖 19 种语言的短语音助手指令
Grok Voice Transcribe 2.0 在四个数据集上均优于 1.0;在电话音频上,SpaceXAI 表示其领先于所有受测模型。
SpaceXAI 从这些数据集中公布的唯一具体数字是短语结果:WER 从 1.0 的 20.6% 降至 2.0 的 6.8%。车载短指令几乎不给模型提供识别语言的上下文,这正是 1.0 的短板,3 倍的提升也是“准确率翻倍”说法最有力的支撑。
其余内部图表(包括与 ElevenLabs Scribe v2 和 Deepgram Nova-3 的多语对比)以未标数值的柱状呈现。我会将“在电话音频上领先我们测试的所有模型”视为厂商声明,直到有人用自家通话音频复现实验。
Grok Voice Transcribe 2.0 价格与可用性
Grok Voice Transcribe 2.0 的批处理转写费用为每小时音频 $0.10,流式为每小时 $0.20,与 Grok Voice Transcribe 1.0 完全一致。说话人分离、词级时间戳与关键词引导均包含在该费率内,不按附加项另计。
| 模式 | 价格 | 包含 |
|---|
| 批处理(文件或 URL) | $0.10/音频小时 | 说话人分离、时间戳、关键词、格式化 |
| 流式(WebSocket) | $0.20/音频小时 | 说话人分离、时间戳、关键词、格式化、智能轮次 |
这些价格在流式榜单中属于较低水平。Artificial Analysis 将 Grok 2.0 标为每 1,000 分钟 $3.33,对比 Meta 的 Muse Voice Transcribe 为 $3.00,ElevenLabs Scribe v2 Realtime 与 Deepgram Flux 均为 $6.50。在指数准确率前四的模型中,只有 Muse 更便宜,但其准确率也更低。
该模型已在 SpaceXAI API 中普遍可用,发布与文档均未提及候补名单或地区限制。由于这是 API 产品,无需选择面向消费者的套餐,发布与文档也未提到语音转写的免费层。
默认设置正处于过渡期。SpaceXAI 表示 2.0 将很快成为语音转文本 API 的默认版本,1.0 将在数周内弃用。在此之前,应显式设置模型 ID。
如何获取 Grok Voice Transcribe 2.0 访问权限?
模型 ID 为 grok-voice-transcribe-2.0,在 REST 端点以表单字段传入,或在 WebSocket 端点以查询参数传入。若需在弃用窗口内继续使用旧模型,请固定为 grok-voice-transcribe-1.0。
它支持两个使用界面:SpaceXAI API(批处理 https://api.x.ai/v1/stt,流式 wss://api.x.ai/v1/stt)与 SpaceXAI 控制台(提供实时语音转文本试验场)。截至 2026 年 9 月 21 日,它尚未进入 OpenRouter 目录。
以下是最小的批处理调用示例,可返回带说话人分离的转录:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])技术支持
基于 xAI WebSocket 语音 API 构建语音代理,请参阅我们的 Grok Voice Think Fast 2.0 API 教程(涵盖语音到语音模型),以及 Grok Voice Agent API 指南。如果您在同一代码库中也调用 Grok 文本模型,我们的 Grok 4.6 API 教程涵盖密钥与工具调用。
结语
Grok Voice Transcribe 2.0 以最低价格拿下公开榜单上的最高流式转写准确率,这样的组合并不常见。xAI 释放的信号是:其语音栈旨在与 OpenAI、Google、ElevenLabs 同台竞争,而不仅是文本模型。
如果我的音频是电话质量、多语言,或充满口述数字,我会选择切换——这正是 2.0 甩开 1.0 与多数竞品的领域。若是对时延高度敏感的语音代理,我会等待 xAI 将最终转录时间与 Scribe v2 的差距补齐。
若您希望自行搭建转写流水线,推荐我们的课程 Spoken Language Processing in Python,从原始音频文件到转写与通话分类全流程覆盖。
流式语音转文本已经成为竞争激烈的榜单赛道。OpenAI、Google、ElevenLabs、Meta 和 Deepgram 都推出了实时转写模型,Artificial Analysis 现将其中数十款统一以词错误率进行排名。SpaceXAI 最新模型 Grok Voice Transcribe 2.0 现已登顶该指数。
本文将全面介绍 Grok Voice Transcribe 2.0 的更新内容,包括新功能、公开与内部基准测试结果,以及价格和 API 访问方式。您也可以参考我们的 Grok Voice Think Fast 2.0 API 指南 和 GPT Live Transcribe API 指南。
要点速览
Grok Voice Transcribe 2.0 是什么?
Grok Voice Transcribe 2.0 是 SpaceXAI 的第二代语音转文本模型,也是 xAI 目前称为其最佳转写模型的产品。它基于 Grok Voice 背后的音频基础模型构建。SpaceXAI 表示,该基础模型已每天处理数万通客服来电、转写数百万小时的视频解说,并驱动特斯拉车载的 Grok 助手。
与 1.0 相比,变化在训练而非 API。SpaceXAI 使用在多种环境中采集的实时、嘈杂、多语音频训练了 2.0,并通过后训练针对最艰难的真实场景做了优化:
核心宣称是:在 xAI 的真实世界评测中,2.0 的准确率是 1.0 的两倍,同时价格与第一代保持不变。本文的基准测试部分会具体分析这一点,因为公开榜单呈现的提升幅度低于内部数据。
Grok Voice Transcribe 2.0 关键功能
功能列表与 1.0 保持一致,这正是重点:xAI 将全部升级投入到准确率,API 表面不做改动。
用同一个模型转写文件或实时音频
您可以向批处理端点发送录音文件或 URL,或通过 WebSocket 流式传输原始音频,并在说话尚未结束时持续接收转写事件。两条路径运行同一模型,因此通话录音与实时通话得到的转录应一致。
批处理支持最大 500 MB 的文件、12 种音频格式,包括 WAV、MP3、FLAC、MP4 容器,以及原始 PCM 和 G.711 电话编解码。流式模式大约每 500 毫秒输出一次部分转录,并将结果标记为锁定片段或已完成话语,便于字幕界面先早显再替换。
明确谁在何时说了什么
每个词都附带开始与结束时间,开启说话人分离后,还会为每个词添加说话人标签,且不额外收费。对于坐席与客户分居不同声道的呼叫中心音频,多声道模式可独立转写最多 8 个声道,从而完全绕开分离问题。
响应是一个 JSON 对象,包含全文、检测到的语言(BCP-47 代码)、音频时长以及词数组。无需额外调用时间戳接口。
教会它您的专有词汇
您可以在每个请求中传入最多 100 个关键词(每个最长 50 个字符),以引导模型更好识别产品名、药品名或您所在领域常说但词典未收录的术语。文本格式化在设置 language 参数后,会将数字、日期、货币、电话号码和电邮地址按书面形式输出,SpaceXAI 目前支持 25 种语言。
诸如“um”“uh”之类的语气词默认会被去除。这对供人阅读的转录是恰当的默认设置,但不适用于对话分析,如需保留语气词,可通过开关设置。
让语音代理知道来电者何时说完
智能轮次检测可让语音代理等待完整表达结束,而不是在每个停顿处都插话。您可以设置 0 到 1 的置信度阈值,模型仅在足够确信说话者已结束时,才将话语标记为完成;SpaceXAI 建议通用场景用 0.5,当人们口述数字或地址时用 0.7。
配套的超时机制会在固定静音后强制结束轮次,避免来电者走开导致会话悬停。若不启用智能轮次,默认端点在 400 毫秒静音后触发,这对短指令尚可,但对口述电话号码会很难用。
录音中途切换语言也能识别
模型可自动检测语言,并在一次录音内处理语言切换,无需语言提示。SpaceXAI 称多语种准确率是相对 1.0 的最大改进,下一节的短语测试数据也支持这一点。
需要注意:language 参数仍然影响格式化。当您希望输出书面形式的数字与货币时应设置它;当音频混用多种语言且您更希望保留原始口语时则不设。
Grok Voice Transcribe 2.0 基准测试表现如何?
Grok Voice Transcribe 2.0 在公开流式榜单的准确率上领先,并在 SpaceXAI 报告的所有内部数据集上优于 1.0,但提升幅度高度依赖具体音频类型。
公开榜单上的流式准确率
在 Artificial Analysis 的流式语音转写指数上,Grok Voice Transcribe 2.0 的词错误率(WER)为 2.7%,截至 2026 年 9 月 21 日在 34 个流式模型中最低。Meta 的 Muse Voice Transcribe 以 3.1% 紧随其后,ElevenLabs Scribe v2 Realtime 为 3.6%,Grok Voice Transcribe 1.0 为 3.9%。SpaceXAI 的发布在上线时统计了同一榜单上的 32 个模型。
WER 衡量什么:WER 是模型识别错误的词占比,数值越低越好。
语音转写指数衡量什么:Artificial Analysis 的指数对 3 个测试集(AA-AgentTalk、VoxPopuli、Earnings-22)的 WER 取平均。Grok 2.0 的优势在 VoxPopuli 上最明显,其 1.4% 的 WER 不到 1.0(3.1%)的一半。
在该指数上相对 1.0 的差距为 31%,而非发布所强调的 2 倍。更大的提升来自 SpaceXAI 自有的生产数据集,下一节会介绍。同一榜单也记录了各模型提交最终转录所需时间,而在这一点上结果相反。
代价在于时延。Grok 2.0 返回最终转录需 0.49 秒,1.0 为 0.37 秒,Scribe v2 Realtime 为 0.14 秒。用于字幕几乎无感;用于每轮都需作答的语音代理,额外的零点几秒会累计成影响。
真实世界音频:电话、凭证与短语
SpaceXAI 在四个来源于生产流量的内部数据集上测量 WER:
Grok Voice Transcribe 2.0 在四个数据集上均优于 1.0;在电话音频上,SpaceXAI 表示其领先于所有受测模型。
SpaceXAI 从这些数据集中公布的唯一具体数字是短语结果:WER 从 1.0 的 20.6% 降至 2.0 的 6.8%。车载短指令几乎不给模型提供识别语言的上下文,这正是 1.0 的短板,3 倍的提升也是“准确率翻倍”说法最有力的支撑。
其余内部图表(包括与 ElevenLabs Scribe v2 和 Deepgram Nova-3 的多语对比)以未标数值的柱状呈现。我会将“在电话音频上领先我们测试的所有模型”视为厂商声明,直到有人用自家通话音频复现实验。
Grok Voice Transcribe 2.0 价格与可用性
Grok Voice Transcribe 2.0 的批处理转写费用为每小时音频 $0.10,流式为每小时 $0.20,与 Grok Voice Transcribe 1.0 完全一致。说话人分离、词级时间戳与关键词引导均包含在该费率内,不按附加项另计。
这些价格在流式榜单中属于较低水平。Artificial Analysis 将 Grok 2.0 标为每 1,000 分钟 $3.33,对比 Meta 的 Muse Voice Transcribe 为 $3.00,ElevenLabs Scribe v2 Realtime 与 Deepgram Flux 均为 $6.50。在指数准确率前四的模型中,只有 Muse 更便宜,但其准确率也更低。
该模型已在 SpaceXAI API 中普遍可用,发布与文档均未提及候补名单或地区限制。由于这是 API 产品,无需选择面向消费者的套餐,发布与文档也未提到语音转写的免费层。
默认设置正处于过渡期。SpaceXAI 表示 2.0 将很快成为语音转文本 API 的默认版本,1.0 将在数周内弃用。在此之前,应显式设置模型 ID。
如何获取 Grok Voice Transcribe 2.0 访问权限?
模型 ID 为
grok-voice-transcribe-2.0,在 REST 端点以表单字段传入,或在 WebSocket 端点以查询参数传入。若需在弃用窗口内继续使用旧模型,请固定为grok-voice-transcribe-1.0。它支持两个使用界面:SpaceXAI API(批处理
https://api.x.ai/v1/stt,流式wss://api.x.ai/v1/stt)与 SpaceXAI 控制台(提供实时语音转文本试验场)。截至 2026 年 9 月 21 日,它尚未进入 OpenRouter 目录。以下是最小的批处理调用示例,可返回带说话人分离的转录:
基于 xAI WebSocket 语音 API 构建语音代理,请参阅我们的 Grok Voice Think Fast 2.0 API 教程(涵盖语音到语音模型),以及 Grok Voice Agent API 指南。如果您在同一代码库中也调用 Grok 文本模型,我们的 Grok 4.6 API 教程涵盖密钥与工具调用。
结语
Grok Voice Transcribe 2.0 以最低价格拿下公开榜单上的最高流式转写准确率,这样的组合并不常见。xAI 释放的信号是:其语音栈旨在与 OpenAI、Google、ElevenLabs 同台竞争,而不仅是文本模型。
如果我的音频是电话质量、多语言,或充满口述数字,我会选择切换——这正是 2.0 甩开 1.0 与多数竞品的领域。若是对时延高度敏感的语音代理,我会等待 xAI 将最终转录时间与 Scribe v2 的差距补齐。
若您希望自行搭建转写流水线,推荐我们的课程 Spoken Language Processing in Python,从原始音频文件到转写与通话分类全流程覆盖。