
Courses
Xử lý Ngôn ngữ Nói bằng Python
4 giờ
9.3K
Chuyển giọng nói thành văn bản theo thời gian thực đang trở thành một bảng xếp hạng chật chội. OpenAI, Google, ElevenLabs, Meta và Deepgram đều phát hành các mô hình phiên âm thời gian thực, và Artificial Analysis hiện xếp hạng hàng chục mô hình dựa trên chỉ số tỷ lệ lỗi từ. Mô hình mới nhất của SpaceXAI, Grok Voice Transcribe 2.0, vừa vươn lên dẫn đầu chỉ số đó.
Trong bài viết này, tôi sẽ trình bày tất cả những điểm mới của Grok Voice Transcribe 2.0: các tính năng mới, đối chiếu các benchmark công khai và nội bộ, cùng mức giá và cách truy cập API. Bạn cũng có thể xem hướng dẫn của chúng tôi về API Grok Voice Think Fast 2.0 và API GPT Live Transcribe.
Grok Voice Transcribe 2.0 là mô hình chuyển giọng nói thành văn bản thế hệ thứ hai của SpaceXAI, và là mô hình phiên âm mà xAI hiện gọi là tốt nhất của họ. Mô hình này được xây dựng trên mô hình nền tảng âm thanh phía sau Grok Voice, mà theo SpaceXAI đã xử lý hàng chục nghìn cuộc gọi hỗ trợ khách hàng mỗi ngày, phiên âm hàng triệu giờ thuyết minh video, và vận hành trợ lý Grok trên các xe Tesla.
Điểm khác biệt so với 1.0 nằm ở việc huấn luyện, không phải API. SpaceXAI đã huấn luyện 2.0 trên âm thanh trực tiếp, nhiễu, đa ngôn ngữ, ghi trong nhiều môi trường khác nhau, rồi tinh chỉnh hậu huấn luyện để nhắm vào những điều kiện khó khăn nhất ngoài đời thực:
Tuyên bố chính là 2.0 chính xác gấp đôi 1.0 trong các đánh giá thực tế của xAI, với giá không đổi so với thế hệ đầu. Tôi sẽ kiểm chứng tuyên bố này trong phần benchmark, vì bảng xếp hạng công khai cho thấy bức tranh khiêm tốn hơn so với các bộ nội bộ.
Danh sách tính năng giống hệt những gì 1.0 đã có, đó là chủ đích: xAI dồn toàn bộ nâng cấp vào độ chính xác và giữ nguyên bề mặt API.
Bạn có thể gửi tệp ghi âm hoặc URL tới endpoint xử lý theo lô, hoặc truyền âm thanh thô qua WebSocket và nhận các sự kiện bản chép khi người nói vẫn đang nói. Cả hai cách đều chạy cùng một mô hình, nên bản chép của ghi âm cuộc gọi và bản chép cuộc gọi trực tiếp sẽ giống nhau.
Xử lý theo lô chấp nhận tệp tối đa 500 MB ở 12 định dạng âm thanh, bao gồm WAV, MP3, FLAC và các container MP4 cùng PCM thô và codec thoại G.711. Truyền phát có thể phát ra bản chép tạm thời khoảng mỗi 500 ms và gắn thẻ từng kết quả là một đoạn đã khóa hoặc một phát ngôn đã hoàn tất, để giao diện phụ đề có thể hiển thị văn bản sớm và thay thế sau.
Mỗi từ đều đi kèm thời gian bắt đầu và kết thúc, và bật diarization sẽ thêm nhãn người nói cho từng từ mà không tính thêm phí. Với âm thanh tổng đài có nhân viên và khách hàng ở hai kênh riêng, chế độ đa kênh phiên âm độc lập tối đa 8 kênh, từ đó bỏ qua hoàn toàn nhu cầu diarization.
Phản hồi là một đối tượng JSON gồm toàn văn bản, ngôn ngữ được phát hiện theo mã BCP-47, thời lượng âm thanh, và mảng từ. Không cần gọi riêng để lấy dấu thời gian.
Bạn có thể truyền tối đa 100 thuật ngữ khóa mỗi yêu cầu, mỗi thuật ngữ tối đa 50 ký tự, để định hướng mô hình nhận đúng tên sản phẩm, tên thuốc, hoặc bất cứ thuật ngữ chuyên ngành nào thường được nói mà từ điển không có. Định dạng văn bản sẽ viết số, ngày tháng, tiền tệ, số điện thoại và địa chỉ email theo dạng viết khi bạn đặt tham số ngôn ngữ, mà SpaceXAI hỗ trợ cho 25 ngôn ngữ.
Các từ đệm như "um" và "uh" bị loại bỏ theo mặc định. Đây là mặc định phù hợp cho bản chép để đọc, nhưng không phù hợp cho phân tích hội thoại, nên có cờ để bạn bật lại từ đệm nếu muốn.
Phát hiện lượt thông minh cho phép tác tử giọng nói đợi đến cuối ý thay vì nhảy vào ở mọi khoảng nghỉ. Bạn đặt ngưỡng độ tin cậy từ 0 đến 1, và mô hình chỉ đánh dấu phát ngôn là hoàn tất khi tự tin ở mức đó rằng người nói đã dừng; SpaceXAI gợi ý 0,5 cho nhu cầu cân bằng và 0,7 khi người dùng đọc số hoặc địa chỉ.
Một cơ chế hết thời gian đi kèm sẽ buộc kết thúc lượt sau một khoảng im lặng cố định, để người gọi rời đi không làm treo phiên. Nếu không dùng lượt thông minh, endpointing mặc định kích hoạt sau 400 ms im lặng, phù hợp cho lệnh ngắn nhưng gây khó chịu khi ai đó đọc số điện thoại.
Mô hình tự động phát hiện ngôn ngữ và xử lý chuyển đổi ngôn ngữ trong một bản ghi duy nhất chỉ trong một lần chạy, không cần gợi ý ngôn ngữ. SpaceXAI gọi độ chính xác đa ngôn ngữ là cải thiện lớn nhất so với 1.0, và các con số cho câu ngắn ở phần sau củng cố điều đó.
Một lưu ý: tham số ngôn ngữ vẫn quan trọng với định dạng. Hãy đặt tham số này khi bạn muốn số và tiền tệ ở dạng viết, và bỏ trống khi âm thanh trộn nhiều ngôn ngữ và bạn muốn giữ lại nguyên văn.
Grok Voice Transcribe 2.0 dẫn đầu bảng xếp hạng phát trực tuyến công khai về độ chính xác và vượt 1.0 trên mọi bộ nội bộ mà SpaceXAI báo cáo, nhưng mức độ cải thiện phụ thuộc nhiều vào loại âm thanh bạn xét đến.
Trên chỉ số chuyển giọng nói thành văn bản phát trực tuyến của Artificial Analysis, Grok Voice Transcribe 2.0 đạt tỷ lệ lỗi từ (WER) 2,7%, thấp nhất trong 34 mô hình phát trực tuyến được liệt kê tính đến ngày 21 tháng 9 năm 2026. Muse Voice Transcribe của Meta đứng tiếp theo với 3,1%, ElevenLabs Scribe v2 Realtime ở mức 3,6%, và Grok Voice Transcribe 1.0 là 3,9%. Thông báo của SpaceXAI ghi nhận 32 mô hình trên cùng bảng xếp hạng vào thời điểm ra mắt.
WER đo gì: WER là tỷ lệ từ mà mô hình nhận sai, nên càng thấp càng tốt.
Chỉ số chuyển giọng nói đo gì: Chỉ số của Artificial Analysis lấy trung bình WER trên 3 bộ kiểm thử (AA-AgentTalk, VoxPopuli và Earnings-22). Khoảng cách dẫn lớn nhất của Grok 2.0 là ở VoxPopuli, nơi WER 1,4% của nó chưa bằng một nửa mức 3,1% của 1.0.
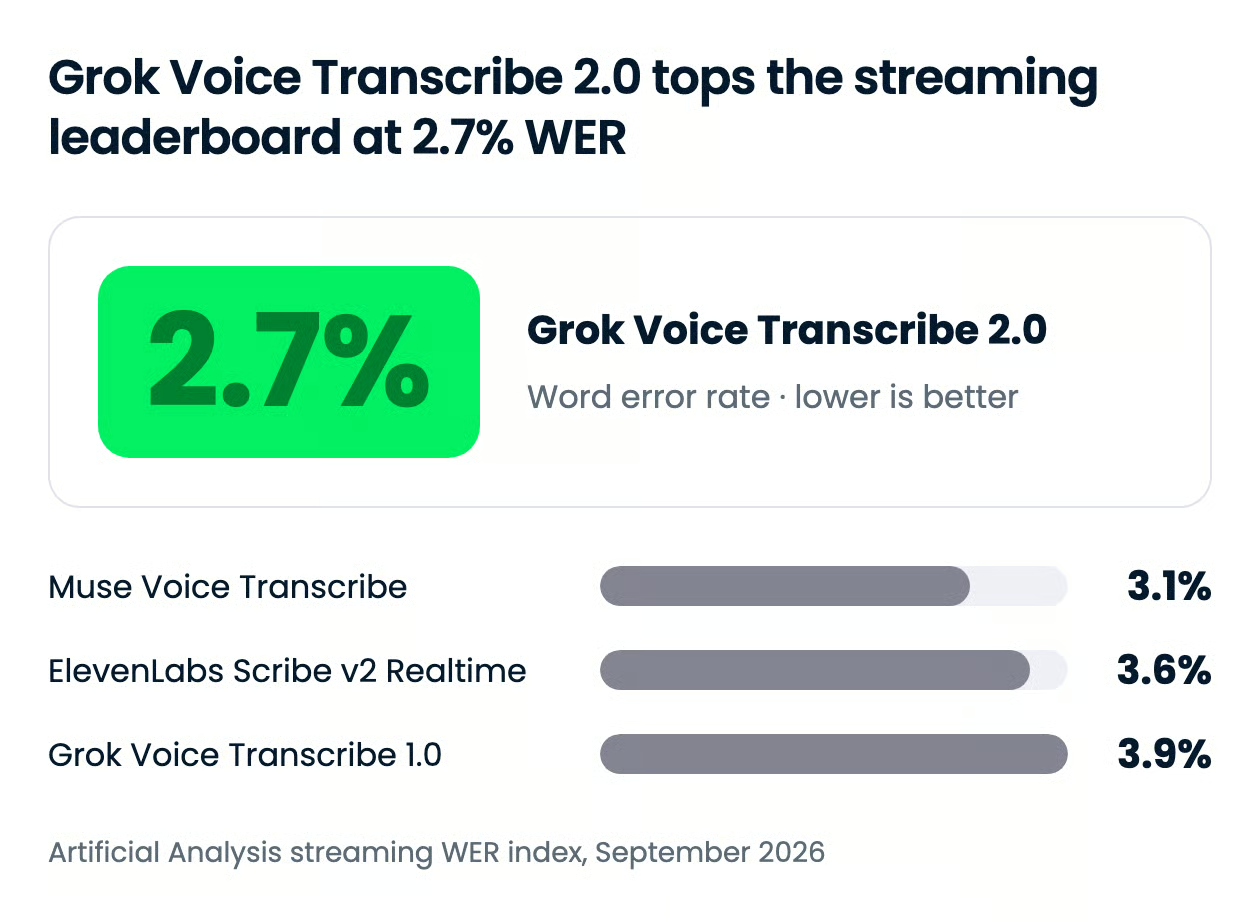
Khoảng cách với 1.0 trên chỉ số này là 31%, chứ không phải gấp đôi như thông báo nhấn mạnh. Tuyên bố lớn hơn đó xuất phát từ các bộ dữ liệu sản xuất của riêng SpaceXAI, tôi sẽ đề cập tiếp theo. Cùng bảng xếp hạng còn ghi nhận thời gian mỗi mô hình cần để chốt bản chép cuối, và ở đây bức tranh đảo chiều.
| Model | WER index (final transcript) | Time to final transcript |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2.7% | 0.49 s |
| Muse Voice Transcribe (Meta) | 3.1% | 0.16 s |
| ElevenLabs Scribe v2 Realtime | 3.6% | 0.14 s |
| Grok Voice Transcribe 1.0 | 3.9% | 0.37 s |
| Deepgram Flux | 7.4% | 0.02 s |
Độ trễ là cái giá phải trả. Grok 2.0 mất 0,49 s để trả về bản chép cuối, so với 0,37 s của 1.0 và 0,14 s của Scribe v2 Realtime. Với phụ đề, điều này gần như không thấy. Với tác tử giọng nói phải phản hồi ở mọi lượt, vài phần mười giây sẽ cộng dồn đáng kể.
SpaceXAI đo WER trên bốn bộ nội bộ rút từ lưu lượng sản xuất:
Grok Voice Transcribe 2.0 cải thiện so với 1.0 trên cả bốn, và với thoại, SpaceXAI cho biết mô hình dẫn đầu tất cả các mô hình họ đã thử nghiệm.
Con số duy nhất SpaceXAI công bố từ các bộ này là kết quả cho câu ngắn: WER giảm từ 20,6% với 1.0 còn 6,8% với 2.0. Các lệnh ngắn trong xe cung cấp rất ít ngữ cảnh để xác định ngôn ngữ, chính là điểm yếu của 1.0, và mức cải thiện gấp 3 lần ở đây là bằng chứng mạnh nhất cho tuyên bố "chính xác gấp đôi".
Phần còn lại của các biểu đồ nội bộ, bao gồm so sánh đa ngôn ngữ với ElevenLabs Scribe v2 và Deepgram Nova-3, được hiển thị dạng cột không gắn nhãn giá trị. Tôi sẽ xem "dẫn đầu mọi mô hình chúng tôi đã thử" trên thoại như một tuyên bố của nhà cung cấp cho đến khi có ai đó tái lập được trên dữ liệu cuộc gọi của riêng họ.
Grok Voice Transcribe 2.0 có giá $0,10 mỗi giờ âm thanh cho phiên âm theo lô và $0,20 mỗi giờ cho phát trực tuyến, giống hệt Grok Voice Transcribe 1.0. Diarization, dấu thời gian theo từ, và định hướng thuật ngữ khóa đã bao gồm trong các mức giá đó thay vì tính thêm.
| Mode | Price | Included |
|---|---|---|
| Batch (file or URL) | $0.10 per hour of audio | Diarization, timestamps, key terms, formatting |
| Streaming (WebSocket) | $0.20 per hour of audio | Diarization, timestamps, key terms, formatting, smart turn |
Các mức giá này thuộc nhóm thấp nhất trên bảng xếp hạng phát trực tuyến. Artificial Analysis liệt kê Grok 2.0 ở mức $3,33 mỗi 1.000 phút, so với $3,00 cho Muse Voice Transcribe của Meta và $6,50 cho cả ElevenLabs Scribe v2 Realtime và Deepgram Flux. Trong bốn mô hình chính xác nhất trên chỉ số, chỉ có Muse rẻ hơn, và Muse đạt điểm thấp hơn về độ chính xác.
Mô hình đã khả dụng rộng rãi trên API của SpaceXAI, không thấy đề cập danh sách chờ hay giới hạn khu vực trong thông báo hoặc tài liệu. Không có gói người dùng cá nhân nào vì đây là sản phẩm API, và cả thông báo lẫn tài liệu đều không nhắc đến tầng miễn phí cho chuyển giọng nói thành văn bản.
Giá trị mặc định đang trong giai đoạn chuyển tiếp. SpaceXAI cho biết 2.0 sẽ sớm trở thành mặc định trong Speech-to-Text API và 1.0 sẽ bị ngừng trong vài tuần tới. Cho đến lúc đó, nên đặt ID mô hình một cách tường minh.
ID mô hình là grok-voice-transcribe-2.0, truyền như một trường form trên endpoint REST hoặc là tham số truy vấn trên endpoint WebSocket. Để tiếp tục dùng mô hình cũ trong giai đoạn ngừng hỗ trợ, hãy cố định grok-voice-transcribe-1.0.
Mô hình chạy trên hai bề mặt: API của SpaceXAI, với xử lý theo lô tại https://api.x.ai/v1/stt và phát trực tuyến tại wss://api.x.ai/v1/stt, và bảng điều khiển SpaceXAI, nơi có playground chuyển giọng nói thành văn bản trực tiếp. Tính đến ngày 21 tháng 9 năm 2026, mô hình chưa có trong danh mục của OpenRouter.
Dưới đây là lệnh theo lô nhỏ nhất trả về bản chép có diarization:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
Với các tác tử giọng nói xây dựng trên các API giọng nói WebSocket của xAI, xem hướng dẫn API Grok Voice Think Fast 2.0 của chúng tôi, nội dung bao phủ mô hình chuyển giọng nói thành giọng nói, và hướng dẫn API Grok Voice Agent. Nếu bạn gọi các mô hình văn bản của Grok từ cùng một codebase, hướng dẫn API Grok 4.6 của chúng tôi có phần về khóa và gọi công cụ.
Grok Voice Transcribe 2.0 là cách rẻ nhất để có bản chép phát trực tuyến chính xác nhất trên bảng xếp hạng công khai, và sự kết hợp này là hiếm. xAI đang khẳng định rằng ngăn xếp giọng nói của họ được xây dựng để cạnh tranh với OpenAI, Google và ElevenLabs, không chỉ ở mô hình văn bản.
Tôi sẽ chuyển sang dùng nếu âm thanh của tôi là chất lượng điện thoại, đa ngôn ngữ, hoặc có nhiều con số đọc thành tiếng, là những nơi 2.0 bỏ xa 1.0 và phần lớn đối thủ. Tôi sẽ tạm hoãn với tác tử giọng nói nhạy cảm độ trễ cho đến khi xAI thu hẹp khoảng cách với Scribe v2 về thời gian ra bản chép cuối.
Nếu bạn muốn tự xây dựng pipeline phiên âm, tôi gợi ý khóa học Spoken Language Processing in Python của chúng tôi, đi từ tệp âm thanh thô đến các cuộc gọi được phiên âm và phân loại.
Học AI cùng DataCamp!
Courses
Tracks
Courses