Cursus
Spoken Language Processing in Python
4 Hr
9.3K
Streaming spraak-naar-tekst is uitgegroeid tot een drukke ranglijst. OpenAI, Google, ElevenLabs, Meta en Deepgram leveren allemaal realtime transcriptiemodellen, en Artificial Analysis rangschikt er nu tientallen op één woordfoutpercentage-index. Het nieuwste model van SpaceXAI, Grok Voice Transcribe 2.0, pakt nu de eerste plek op die index.
In dit artikel neem ik alles door wat nieuw is in Grok Voice Transcribe 2.0: de nieuwe functies, de publieke en interne benchmarks, en de prijs en API-toegang. Bekijk ook onze gidsen voor de Grok Voice Think Fast 2.0 API en de GPT Live Transcribe API.
Grok Voice Transcribe 2.0 is SpaceXAI's spraak-naar-tekstmodel van de tweede generatie, en het model dat xAI nu zijn beste transcriptiemodel noemt. Het is gebouwd op het audiofundamentmodel achter Grok Voice, waarvan SpaceXAI zegt dat het al tienduizenden klantenservicegesprekken per dag afhandelt, miljoenen uren videonarratie transcribeert en de Grok-assistent in Tesla-voertuigen aanstuurt.
Wat er veranderde ten opzichte van 1.0 is de training, niet de API. SpaceXAI trainde 2.0 op live, rumoerige, meertalige audio die in uiteenlopende omgevingen is opgenomen, en verfijnde het daarna met post-training gericht op de lastigste omstandigheden uit de praktijk:
De kopclaim is dat 2.0 twee keer zo nauwkeurig is als 1.0 in xAI's evaluaties in de echte wereld, met ongewijzigde prijzen ten opzichte van de eerste generatie. Op die claim kom ik terug in de benchmarksectie, want de publieke ranglijst vertelt een bescheidener verhaal dan de interne sets.
De functielijst is dezelfde als die van 1.0, en dat is precies de bedoeling: xAI stopte de hele upgrade in nauwkeurigheid en liet het API-oppervlak ongewijzigd.
Je kunt een opgenomen bestand of een URL naar het batch-endpoint sturen, of ruwe audio streamen via een WebSocket en transcriptgebeurtenissen terugkrijgen terwijl de spreker nog praat. Beide paden draaien op hetzelfde model, dus een transcript van een gespreksopname en een transcript van het live gesprek zouden hetzelfde moeten lezen.
Batch accepteert bestanden tot 500 MB in 12 audioformaten, waaronder WAV, MP3, FLAC en MP4-containers plus ruwe PCM en de G.711-telefoniecodecs. Streaming kan ongeveer elke 500 ms gedeeltelijke transcripties uitsturen en labelt elk resultaat als een vergrendeld fragment of een afgeronde uiting, zodat een ondertitelings-UI vroeg tekst kan tonen en die later kan vervangen.
Elk woord komt terug met een begin- en eindtijd, en door diarization in te schakelen wordt aan elk woord zonder extra kosten een sprekerlabel toegevoegd. Voor callcenteraudio met de agent op het ene kanaal en de klant op het andere, transcribeert multikanaalmodus tot 8 kanalen onafhankelijk, waarmee diarization helemaal wordt omzeild.
De response is één JSON-object met de volledige tekst, de gedetecteerde taal als een BCP-47-code, de audioduur en de woordenarray. Er is geen aparte timestamps-call nodig.
Je kunt tot 100 kerntermen per request doorgeven, elk tot 50 tekens, om het model te sturen richting productnamen, medicijnnamen of wat er in jouw domein hardop wordt gezegd maar niet in een woordenboek staat. Tekstopmaak schrijft nummers, datums, valuta, telefoonnummers en e-mailadressen in geschreven vorm wanneer je de taalparameter instelt, wat SpaceXAI voor 25 talen ondersteunt.
Stopwoorden zoals "uhm" en "uh" worden standaard verwijderd. Dat is de juiste standaard voor transcripties die mensen lezen en de verkeerde voor conversatie-analyse, dus de vlag is er als je de fillers terug wilt.
Smart turn-detectie laat een spraakagent wachten tot het einde van een gedachte in plaats van bij elke pauze in te breken. Je stelt een zekerheidsdrempel in tussen 0 en 1, en het model markeert de uiting pas als afgerond wanneer het zó zeker is dat de spreker klaar is; SpaceXAI suggereert 0,5 voor een gebalanceerd gebruik en 0,7 wanneer mensen nummers of adressen dicteren.
Een bijbehorende timeout dwingt de beurt te eindigen na een vaste stilte, zodat een beller die wegloopt de sessie niet ophangt. Zonder smart turn vuurt de standaardendpointing na 400 ms stilte, wat prima is voor korte commando's en pijnlijk voor iedereen die een telefoonnummer voorleest.
Het model detecteert de taal automatisch en verwerkt taalwissels binnen één opname in één keer, zonder taalhint. SpaceXAI noemt meertalige nauwkeurigheid de grootste verbetering ten opzichte van 1.0, en de korte-zinnen-cijfers in de volgende sectie ondersteunen dat.
Eén kanttekening: de taalparameter blijft belangrijk voor opmaak. Stel hem in wanneer je geschreven-vorm nummers en valuta wilt, en laat hem weg als de audio talen mixt en je liever de ruwe woorden hebt.
Grok Voice Transcribe 2.0 voert de publieke streamingranglijst aan qua nauwkeurigheid en verslaat 1.0 op elke interne set die SpaceXAI rapporteert, maar de omvang van de winst hangt sterk af van welke audio je bekijkt.
Op de streaming spraak-naar-tekst-index van Artificial Analysis noteert Grok Voice Transcribe 2.0 een woordfoutpercentage (WER) van 2,7%, het laagste van de 34 streamingmodellen die per 21 september 2026 worden vermeld. Meta's Muse Voice Transcribe volgt met 3,1%, ElevenLabs Scribe v2 Realtime staat op 3,6%, en Grok Voice Transcribe 1.0 sluit aan met 3,9%. De aankondiging van SpaceXAI telde bij lancering 32 modellen op dezelfde ranglijst.
Wat WER meet: WER is het aandeel woorden dat het model fout heeft, dus lager is beter.
Wat de spraak-naar-tekst-index meet: De index van Artificial Analysis neemt het gemiddelde WER over 3 testsets (AA-AgentTalk, VoxPopuli en Earnings-22). Grok 2.0's grootste voorsprong is op VoxPopuli, waar het 1,4% WER noteert, minder dan de helft van 1.0's 3,1%.
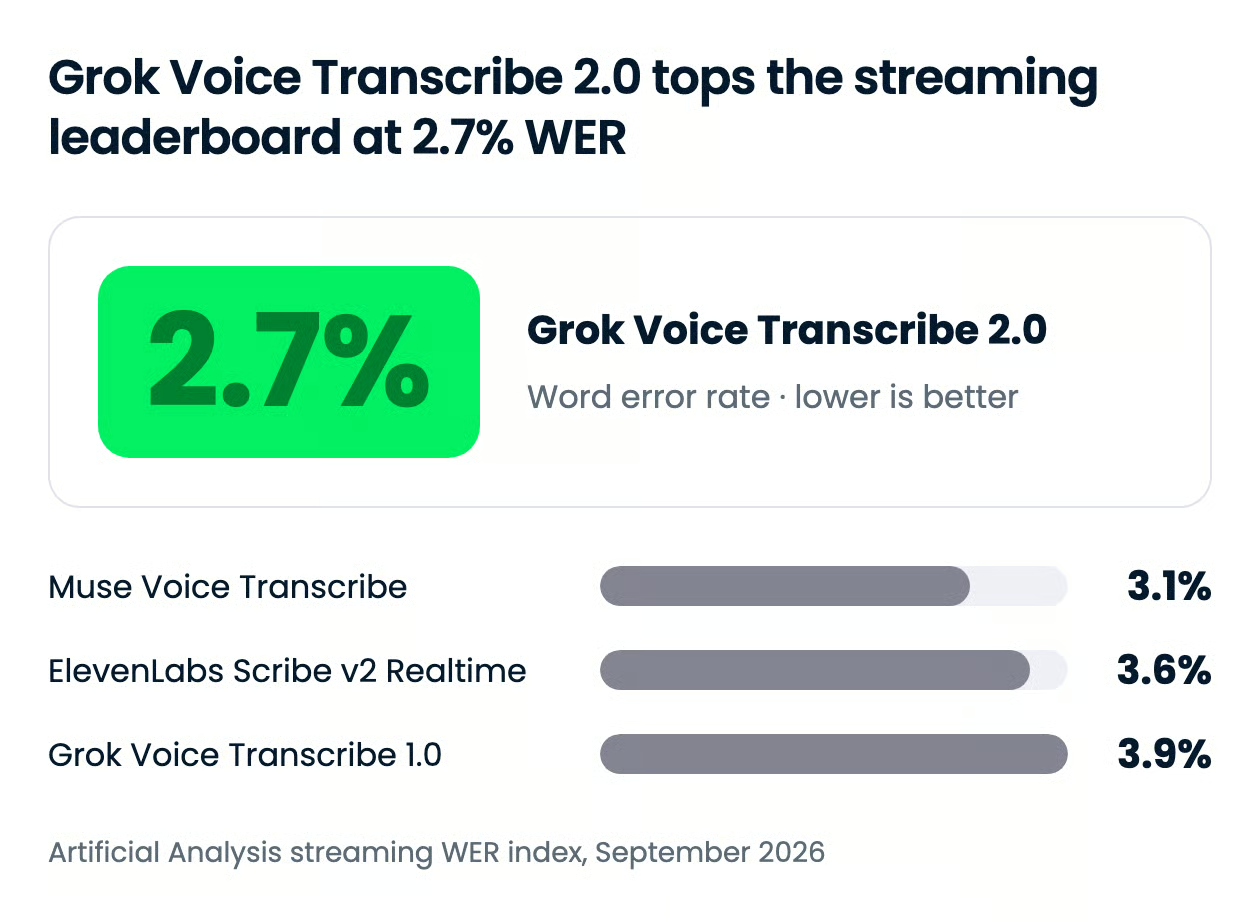
De kloof met 1.0 op deze index is 31%, niet de 2x waarmee de aankondiging opent. Die grotere claim komt uit SpaceXAI's eigen productie-sets, die ik hierna behandel. Op dezelfde ranglijst staat ook hoe lang elk model nodig heeft om een definitieve transcriptie vast te leggen, en daar keert het beeld om.
| Model | WER-index (definitieve transcriptie) | Tijd tot definitieve transcriptie |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2,7% | 0,49 s |
| Muse Voice Transcribe (Meta) | 3,1% | 0,16 s |
| ElevenLabs Scribe v2 Realtime | 3,6% | 0,14 s |
| Grok Voice Transcribe 1.0 | 3,9% | 0,37 s |
| Deepgram Flux | 7,4% | 0,02 s |
Latentie is de prijs. Grok 2.0 doet er 0,49 s over om een definitieve transcriptie te retourneren, tegenover 0,37 s voor 1.0 en 0,14 s voor Scribe v2 Realtime. Voor ondertitels is dat onzichtbaar. Voor een spraakagent die bij elke beurt moet reageren, tellen die extra tienden van een seconde op.
SpaceXAI meet WER op vier interne sets die uit productieverkeer zijn gehaald:
Grok Voice Transcribe 2.0 verbetert ten opzichte van 1.0 op alle vier, en op telefonie zegt SpaceXAI dat het elk getest model verslaat.
Het enige cijfer dat SpaceXAI uit deze sets publiceert is het resultaat voor korte zinnen: WER daalt van 20,6% met 1.0 naar 6,8% met 2.0. Korte commando's in de auto geven het model bijna geen context om de taal te identificeren, precies waar 1.0 moeite mee had, en een 3x verbetering daar is het sterkste bewijs achter de claim "twee keer zo nauwkeurig".
De rest van de interne grafieken, inclusief de meertalige vergelijking met ElevenLabs Scribe v2 en Deepgram Nova-3, worden geleverd als balken zonder gelabelde waarden. Ik zou "leidt elk model dat we hebben getest" op telefonie als een leveranciersclaim behandelen totdat iemand het reproduceert op zijn eigen belaudio.
Grok Voice Transcribe 2.0 kost $0,10 per uur audio voor batchtranscriptie en $0,20 per uur voor streaming, identiek aan Grok Voice Transcribe 1.0. Diarization, woordtijdstempels en biasing met kerntermen zijn in die tarieven inbegrepen en worden niet als add-ons gefactureerd.
| Modus | Prijs | Inbegrepen |
|---|---|---|
| Batch (bestand of URL) | $0,10 per uur audio | Diarization, timestamps, kerntermen, opmaak |
| Streaming (WebSocket) | $0,20 per uur audio | Diarization, timestamps, kerntermen, opmaak, smart turn |
Die tarieven behoren tot de laagste op de streamingranglijst. Artificial Analysis vermeldt Grok 2.0 op $3,33 per 1.000 minuten, naast $3,00 voor Meta's Muse Voice Transcribe en $6,50 voor zowel ElevenLabs Scribe v2 Realtime als Deepgram Flux. Van de vier nauwkeurigste modellen op de index is alleen Muse goedkoper, en Muse scoort lager op nauwkeurigheid.
Het model is algemeen beschikbaar in de SpaceXAI API, zonder wachtlijst of regiobeperking genoemd in de aankondiging of de documentatie. Er is geen consumentenabonnement om te kiezen, want dit is een API-product, en noch de aankondiging noch de documentatie noemt een gratis laag voor spraak-naar-tekst.
De standaard is in overgang. SpaceXAI zegt dat 2.0 binnenkort de standaard wordt in de Speech-to-Text API en dat 1.0 in de komende weken wordt uitgefaseerd. Stel tot die tijd het model-ID expliciet in.
Het model-ID is grok-voice-transcribe-2.0, door te geven als formulierveld op het REST-endpoint of als queryparameter op het WebSocket-endpoint. Om op het oude model te blijven tijdens het uitfaseringsvenster, pin je grok-voice-transcribe-1.0.
Het draait op twee vlakken: de SpaceXAI API, met batch op https://api.x.ai/v1/stt en streaming op wss://api.x.ai/v1/stt, en de SpaceXAI-console, die een live spraak-naar-tekst-speeltuin heeft. Het staat niet in de catalogus van OpenRouter per 21 september 2026.
Hier is de kleinste batch-call die een getrancribeerde, gediariseerde transcriptie retourneert:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
Voor spraakagents die zijn gebouwd op xAI's WebSocket-spraak-API's, zie onze Grok Voice Think Fast 2.0 API-tutorial, die het spraak-naar-spraakmodel behandelt, en onze Grok Voice Agent API-gids. Als je de tekstmodellen van Grok vanuit dezelfde codebase aanroept, behandelt onze Grok 4.6 API-tutorial sleutels en tool-calling.
Grok Voice Transcribe 2.0 is de goedkoopste manier om de meest nauwkeurige streamingtranscriptie op de publieke ranglijst te krijgen, en die combinatie is zeldzaam. xAI maakt duidelijk dat zijn voicestack bedoeld is om te concurreren met OpenAI, Google en ElevenLabs, niet alleen met zijn tekstmodellen.
Ik zou overstappen als mijn audio telefoonkwaliteit heeft, meertalig is of vol uitgesproken nummers zit, want dáár loopt 2.0 uit op 1.0 en op de meeste rivalen. Ik zou nog wachten met een latentiegevoelige spraakagent totdat xAI het gat met Scribe v2 dicht op tijd tot definitieve transcriptie.
Als je zelf transcriptiepijplijnen wilt bouwen, raad ik onze cursus Spoken Language Processing in Python aan, die gaat van ruwe audiobestanden naar getranscribeerde en geclassificeerde telefoongesprekken.
Leer AI met DataCamp!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min