
Kurs
Verarbeitung gesprochener Sprache in Python
4 Std.
9.3K
Streaming-Speech-to-Text ist zu einem dicht besetzten Ranking geworden. OpenAI, Google, ElevenLabs, Meta und Deepgram liefern alle Echtzeit-Transkriptionsmodelle, und Artificial Analysis vergleicht inzwischen Dutzende davon anhand einer einzigen Wortfehlerrate. SpaceXAI’s neuestes Modell, Grok Voice Transcribe 2.0, hat dort jetzt den Spitzenplatz erklommen.
In diesem Artikel zeige ich dir, was bei Grok Voice Transcribe 2.0 neu ist: Features, öffentliche und interne Benchmarks sowie Preise und API-Zugang. Außerdem findest du Anleitungen zur Grok Voice Think Fast 2.0 API und zur GPT Live Transcribe API.
Grok Voice Transcribe 2.0 ist SpaceXAI’s Speech-to-Text-Modell der zweiten Generation und laut xAI derzeit das beste Transkriptionsmodell. Es basiert auf dem Audio-Foundation-Modell hinter Grok Voice, das laut SpaceXAI bereits täglich zigtausende Supportanrufe verarbeitet, Millionen Stunden Videotonspur transkribiert und den Grok-Assistenten in Tesla-Fahrzeugen antreibt.
Neu gegenüber 1.0 ist das Training, nicht die API. SpaceXAI hat 2.0 mit live, lauten und mehrsprachigen Audios aus unterschiedlichsten Umgebungen trainiert und danach gezielt auf die härtesten Realbedingungen abgestimmt:
Die Headline-Behauptung: 2.0 ist in xAI’s Real-World-Tests doppelt so präzise wie 1.0, bei unverändertem Preis. Darauf gehe ich im Benchmark-Abschnitt genauer ein, denn die öffentliche Rangliste zeichnet ein moderateres Bild als die internen Sets.
Die Feature-Liste ist identisch mit 1.0 – genau das ist der Punkt: xAI hat das gesamte Upgrade in die Genauigkeit gesteckt und die API-Oberfläche unverändert gelassen.
Du kannst eine aufgenommene Datei oder eine URL an den Batch-Endpunkt schicken oder Roh-Audio über einen WebSocket streamen und Transkript-Events erhalten, während die Person noch spricht. Beide Pfade laufen über dasselbe Modell, sodass ein Transkript einer Anrufaufzeichnung und das Transkript des Live-Calls identisch ausfallen sollten.
Batch akzeptiert Dateien bis 500 MB in 12 Audioformaten, darunter WAV, MP3, FLAC und MP4-Container sowie Roh-PCM und die G.711-Telefoniecodecs. Streaming kann etwa alle 500 ms Teiltranskripte senden und markiert jedes Ergebnis als gesperrten Abschnitt oder abgeschlossene Äußerung, sodass ein Untertitel-UI Text früh anzeigen und später ersetzen kann.
Jedes Wort kommt mit Start- und Endzeit zurück, und mit aktivierter Diarisierung erhält jedes Wort zusätzlich ein Sprecherlabel – ohne Aufpreis. Bei Callcenter-Audio mit Agent auf einem Kanal und Kundin/Kunde auf einem anderen transkribiert der Mehrkanalmodus bis zu 8 Kanäle getrennt, was Diarisierung umgeht.
Die Antwort ist ein einzelnes JSON-Objekt mit dem Volltext, der erkannten Sprache als BCP-47-Code, der Audiodauer und dem Wort-Array. Es gibt keinen separaten Timestamps-Call.
Du kannst pro Anfrage bis zu 100 Schlüsselbegriffe mit jeweils bis zu 50 Zeichen übergeben, um das Modell auf Produktnamen, Medikamentennamen oder domänenspezifische Begriffe zu biasen, die kein Wörterbuch kennt. Das Textformatting schreibt Zahlen, Daten, Währungen, Telefonnummern und E-Mail-Adressen in die Schreibweise der eingestellten Sprache, die SpaceXAI für 25 Sprachen unterstützt.
Füllwörter wie „ähm“ und „hm“ werden standardmäßig entfernt. Das ist für lesbare Transkripte richtig und für Conversational Analytics falsch – du kannst die Option umschalten, wenn du Füllwörter brauchst.
Smart Turn Detection lässt einen Voice-Agent auf das Ende eines Gedankens warten, statt bei jeder Pause dazwischenzugehen. Du setzt einen Konfidenzschwellenwert zwischen 0 und 1, und das Modell markiert eine Äußerung erst dann als abgeschlossen, wenn es mit diesem Wert sicher ist, dass die Person fertig ist; SpaceXAI empfiehlt 0,5 für ausgewogene Nutzung und 0,7, wenn Zahlen oder Adressen diktiert werden.
Ein begleitendes Timeout beendet den Turn nach fester Stille, damit eine weggehende Anruferin die Session nicht hängen lässt. Ohne Smart Turn greift das Standard-Endpointing nach 400 ms Stille – für kurze Kommandos okay, für vorgelesene Telefonnummern unangenehm.
Das Modell erkennt die Sprache automatisch und kommt mit Sprachwechseln innerhalb einer Aufnahme in einem Durchlauf zurecht – ohne Sprachhinweis. SpaceXAI nennt die mehrsprachige Genauigkeit die größte Verbesserung gegenüber 1.0, und die Kurzphrasen-Zahlen im nächsten Abschnitt stützen das.
Ein Vorbehalt: Der Sprachparameter bleibt für das Formatting relevant. Setze ihn, wenn du Zahlen und Währungen in Schreibweise willst, und lass ihn weg, wenn das Audio Sprachen mischt und du lieber die Rohwörter möchtest.
Grok Voice Transcribe 2.0 führt die öffentliche Streaming-Rangliste bei der Genauigkeit an und schlägt 1.0 in allen internen Sets, die SpaceXAI berichtet. Wie groß der Vorsprung ist, hängt jedoch stark vom Audiotyp ab.
Auf dem Streaming-Speech-to-Text-Index von Artificial Analysis erreicht Grok Voice Transcribe 2.0 eine Wortfehlerrate (WER) von 2,7% – den niedrigsten Wert unter 34 gelisteten Streaming-Modellen (Stand: 21. September 2026). Metas Muse Voice Transcribe folgt mit 3,1%, ElevenLabs Scribe v2 Realtime liegt bei 3,6%, und Grok Voice Transcribe 1.0 kommt auf 3,9%. SpaceXAI zählte zum Launch 32 Modelle auf derselben Rangliste.
Was WER misst: WER ist der Anteil falsch erkannter Wörter – je niedriger, desto besser.
Was der Speech-to-Text-Index misst: Der Index von Artificial Analysis mittelt die WER über 3 Testsets (AA-AgentTalk, VoxPopuli und Earnings-22). Grok 2.0’s größter Vorsprung liegt bei VoxPopuli, wo 1,4% WER weniger als die Hälfte von 1.0’s 3,1% sind.
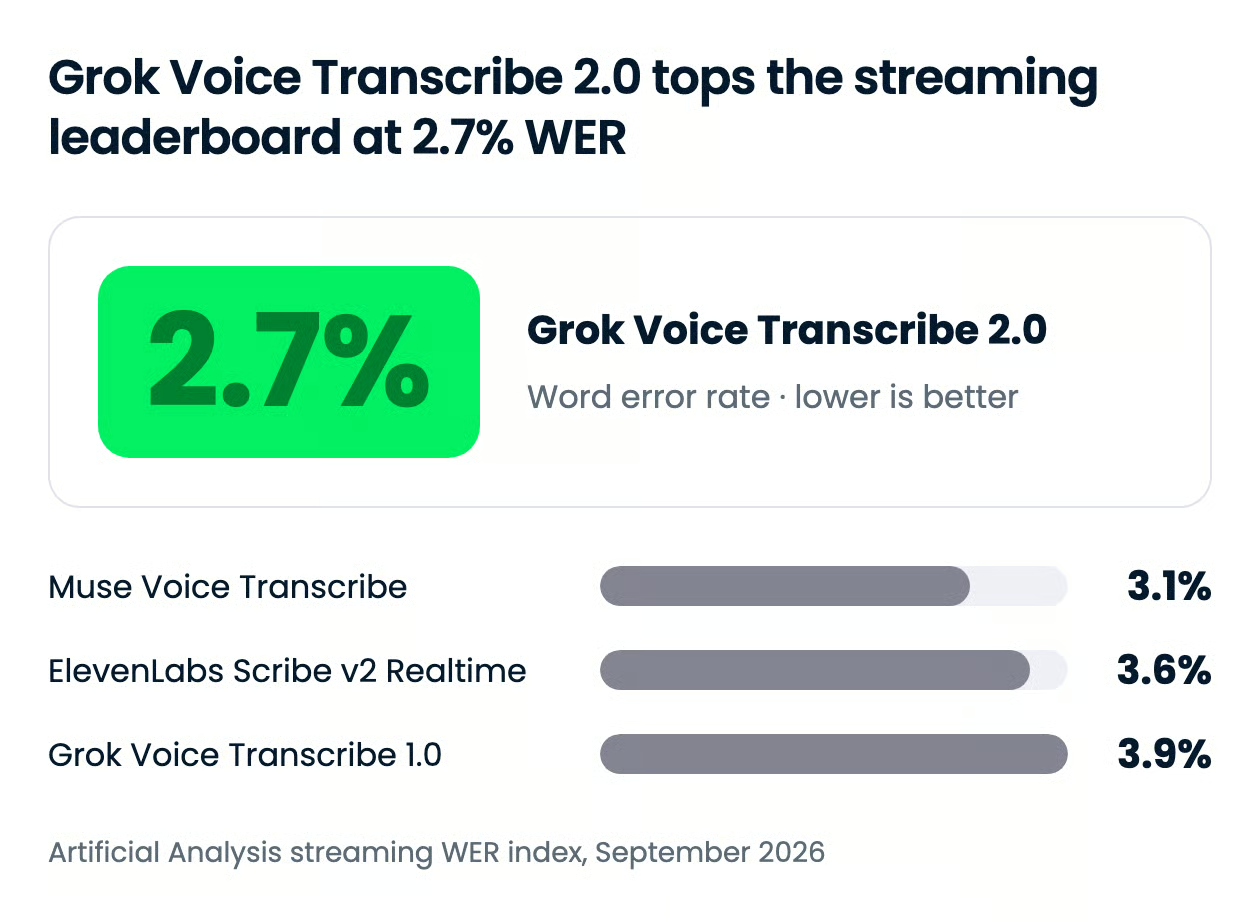
Der Abstand zu 1.0 beträgt hier 31% – nicht die Verdopplung, mit der die Ankündigung wirbt. Diese größere Aussage stützt sich auf SpaceXAI’s eigene Produktionssets, auf die ich gleich eingehe. Dieselbe Rangliste zeigt auch die Zeit bis zum finalen Transkript, und hier dreht sich das Bild.
| Modell | WER-Index (finales Transkript) | Zeit bis finales Transkript |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2,7% | 0,49 s |
| Muse Voice Transcribe (Meta) | 3,1% | 0,16 s |
| ElevenLabs Scribe v2 Realtime | 3,6% | 0,14 s |
| Grok Voice Transcribe 1.0 | 3,9% | 0,37 s |
| Deepgram Flux | 7,4% | 0,02 s |
Die Latenz ist der Preis. Grok 2.0 benötigt 0,49 s für das finale Transkript, gegenüber 0,37 s für 1.0 und 0,14 s für Scribe v2 Realtime. Für Untertitel ist das unsichtbar. Für einen Voice-Agent, der in jedem Turn antworten muss, summieren sich die Zehntelsekunden.
SpaceXAI misst die WER auf vier internen Sets aus Produktionsverkehr:
Grok Voice Transcribe 2.0 verbessert 1.0 in allen vier Sets, und bei Telefonie führt es laut SpaceXAI alle getesteten Modelle an.
Die eine veröffentlichte Zahl aus diesen Sets betrifft die Kurzphrasen: Die WER fällt von 20,6% mit 1.0 auf 6,8% mit 2.0. Kurze Kommandos im Auto geben dem Modell fast keinen Kontext zur Spracherkennung – genau hier tat sich 1.0 schwer. Eine Verdreifachung ist die stärkste Stütze für die „zweimal so genau“-These.
Die übrigen internen Charts – inklusive des mehrsprachigen Vergleichs mit ElevenLabs Scribe v2 und Deepgram Nova-3 – kommen als Balken ohne Werte. „Führt alle getesteten Modelle“ bei Telefonie würde ich als Herstellerangabe werten, bis jemand es auf eigenem Call-Audio reproduziert.
Grok Voice Transcribe 2.0 kostet $0,10 pro Audiostunde für Batch-Transkription und $0,20 pro Stunde für Streaming – identisch zu Grok Voice Transcribe 1.0. Diarisierung, Wortzeitstempel und Keyword-Biasing sind inklusive und werden nicht als Add-ons berechnet.
| Modus | Preis | Inklusive |
|---|---|---|
| Batch (Datei oder URL) | $0,10 pro Audiostunde | Diarisierung, Timestamps, Schlüsselbegriffe, Formatting |
| Streaming (WebSocket) | $0,20 pro Audiostunde | Diarisierung, Timestamps, Schlüsselbegriffe, Formatting, Smart Turn |
Diese Tarife gehören zu den niedrigsten auf der Streaming-Rangliste. Artificial Analysis listet Grok 2.0 mit $3,33 pro 1.000 Minuten, daneben $3,00 für Metas Muse Voice Transcribe und $6,50 für sowohl ElevenLabs Scribe v2 Realtime als auch Deepgram Flux. Unter den vier präzisesten Modellen im Index ist nur Muse günstiger – bei geringerer Genauigkeit.
Das Modell ist allgemein über die SpaceXAI API verfügbar, ohne Warteliste oder Regionsbeschränkung laut Ankündigung oder Doku. Es gibt keinen Endkundentarif, da es sich um ein API-Produkt handelt, und weder Ankündigung noch Doku erwähnen eine Free Tier für Speech-to-Text.
Der Standard ist im Umbruch. SpaceXAI sagt, 2.0 werde bald zum Standard in der Speech-to-Text-API und 1.0 in den kommenden Wochen abgekündigt. Bis dahin solltest du die Modell-ID explizit setzen.
Die Modell-ID lautet grok-voice-transcribe-2.0 und wird als Formularfeld am REST-Endpunkt oder als Query-Parameter am WebSocket-Endpunkt übergeben. Wenn du während der Ausphasung auf dem alten Modell bleiben willst, pinne grok-voice-transcribe-1.0.
Es läuft auf zwei Oberflächen: der SpaceXAI API mit Batch unter https://api.x.ai/v1/stt und Streaming unter wss://api.x.ai/v1/stt sowie der SpaceXAI-Konsole mit einer Live-Speech-to-Text-Playground-Ansicht. In OpenRouters Katalog ist es am 21. September 2026 nicht gelistet.
Hier ist der kleinste Batch-Call, der ein diarisiertes Transkript zurückgibt:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
Für Voice-Agents auf Basis von xAI’s WebSocket-Voice-APIs sieh dir unser Grok Voice Think Fast 2.0 API-Tutorial an, das das Speech-to-Speech-Modell abdeckt, sowie unseren Grok Voice Agent API-Guide. Wenn du in demselben Codebase auch Groks Textmodelle aufrufst, findest du in unserem Grok 4.6 API-Tutorial Infos zu Keys und Tool Calling.
Grok Voice Transcribe 2.0 ist der günstigste Weg zur aktuell präzisesten Streaming-Transkription auf der öffentlichen Rangliste – eine seltene Kombination. xAI setzt damit ein Zeichen: Der Voice-Stack soll mit OpenAI, Google und ElevenLabs konkurrieren, nicht nur die Textmodelle.
Ich würde wechseln, wenn mein Audio Telefonqualität hat, mehrsprachig ist oder viele gesprochene Zahlen enthält – genau dort setzt sich 2.0 von 1.0 und vielen Rivalen ab. Bei latenzkritischen Voice-Agents würde ich warten, bis xAI den Rückstand zu Scribe v2 bei der Zeit bis zum finalen Transkript verkleinert.
Wenn du Transkriptionspipelines selbst bauen willst, empfehle ich unseren Kurs Spoken Language Processing in Python, der dich von Roh-Audiodateien zu transkribierten und klassifizierten Anrufen führt.
Lerne KI mit DataCamp!
Kurs
Lernpfad
Kurs
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Nathaniel Taylor-Leach
4 Min.
Blog
Nathaniel Taylor-Leach
Blog
Zoumana Keita
15 Min.
Blog
Nisha Arya Ahmed
15 Min.
Blog




