Course
Обработка устной речи на Python
4 ч
9.3K
Потоковое распознавание речи превратилось в плотную турнирную таблицу. OpenAI, Google, ElevenLabs, Meta и Deepgram выпускают модели для распознавания в реальном времени, а Artificial Analysis теперь ранжирует десятки таких моделей по единому индексу доли ошибочных слов. Новая модель SpaceXAI — Grok Voice Transcribe 2.0 — заняла в этом рейтинге первое место.
В этой статье мы разберём все новшества Grok Voice Transcribe 2.0: рассмотрим новые возможности, публичные и внутренние бенчмарки, а также цены и доступ к API. Также смотрите наши руководства по API Grok Voice Think Fast 2.0 и GPT Live Transcribe API.
Grok Voice Transcribe 2.0 — это модель второго поколения для преобразования речи в текст от SpaceXAI, которую xAI называет своей лучшей моделью транскрипции. Она построена на базовой аудиомодели Grok Voice, которая, по словам SpaceXAI, уже обрабатывает десятки тысяч звонков в поддержку ежедневно, расшифровывает миллионы часов озвучки видео и работает как ассистент Grok в автомобилях Tesla.
По сравнению с 1.0 изменилось обучение, а не API. SpaceXAI учила 2.0 на живом, «шумном», многоязычном аудио, записанном в разных условиях, а затем доводила модель пост‑обучением, нацеленным на самые сложные реальные сценарии:
Главное утверждение — 2.0 вдвое точнее 1.0 в реальных оценках xAI при неизменной цене. К этим цифрам мы вернёмся в разделе с бенчмарками, потому что публичный лидерборд показывает более скромный разрыв, чем внутренние наборы.
Список функций тот же, что и у 1.0 — в этом и идея: xAI вложила всё обновление в точность и не трогала поверхность API.
Вы можете отправить записанный файл или URL на пакетную точку, либо передавать «сырое» аудио по WebSocket и получать события с расшифровкой, пока говорящий ещё говорит. В обоих случаях работает одна и та же модель, так что транскрипты записи звонка и «живого» звонка должны получаться одинаковыми.
Пакетный режим принимает файлы до 500 МБ в 12 аудиоформатах, включая WAV, MP3, FLAC и контейнеры MP4, а также «сырой» PCM и телефонные кодеки G.711. Потоковый режим может выдавать частичные транскрипты примерно каждые 500 мс и помечает каждый результат как «зафиксированный фрагмент» или «завершённую реплику», чтобы интерфейс субтитров мог показывать текст раньше и заменять его позже.
Каждое слово возвращается с метками начала и конца, а включение диаризации добавляет ярлык говорящего к каждому слову без доплаты. Для колл‑центров, где агент и клиент пишутся по разным каналам, многоканальный режим транскрибирует до 8 каналов независимо, полностью обходя диаризацию.
Ответ — один объект JSON с полным текстом, обнаруженным языком в формате BCP‑47, длительностью аудио и массивом слов. Отдельного запроса за таймстемпами нет.
Можно передать до 100 ключевых терминов в запросе, каждый до 50 символов, чтобы сместить модель в сторону названий продуктов, лекарств и любых специфических слов вашей предметной области, которые часто звучат, но отсутствуют в словаре. Форматирование текста записывает числа, даты, валюты, номера телефонов и адреса электронной почты в письменном виде при установке параметра языка; SpaceXAI поддерживает это для 25 языков.
Слова‑паразиты вроде «эм» и «э-э» по умолчанию удаляются. Это правильная настройка для читаемых людьми транскриптов и неподходящая для аналитики разговоров, поэтому флаг доступен, если вы хотите вернуть заполнители.
Умное определение конца реплики позволяет голосовому агенту дождаться завершения мысли, а не перебивать при каждой паузе. Вы задаёте порог уверенности от 0 до 1, и модель помечает реплику как завершённую только когда настолько уверена, что говорящий договорил; SpaceXAI рекомендует 0.5 для сбалансированных сценариев и 0.7, когда люди диктуют номера или адреса.
Сопутствующий таймаут принудительно завершает реплику после заданной тишины, чтобы абонент, отошедший от телефона, не «вешал» сессию. Без «умного» режима стандартный эндпойнт срабатывает после 400 мс тишины — это приемлемо для коротких команд и мучительно для диктовки номера телефона.
Модель автоматически определяет язык и обрабатывает переключения языка в рамках одной записи за один проход, без подсказки языка. По словам SpaceXAI, многоязычная точность — самый большой скачок по сравнению с 1.0, и цифры по коротким фразам в следующем разделе это подтверждают.
Оговорка: параметр языка по‑прежнему важен для форматирования. Устанавливайте его, когда нужны числа и валюты в письменном виде, и не задавайте, когда в аудио смешиваются языки и лучше оставить «сырые» слова.
Grok Voice Transcribe 2.0 лидирует по точности на публичной таблице потоковых моделей и обходит 1.0 на каждом внутреннем наборе SpaceXAI, но масштаб выигрыша сильно зависит от типа аудио.
В индексе потокового распознавания речи Artificial Analysis Grok Voice Transcribe 2.0 показывает долю ошибочных слов (WER) 2,7% — это минимум среди 34 потоковых моделей по состоянию на 21 сентября 2026 года. Следом идёт Muse Voice Transcribe от Meta с 3,1%, ElevenLabs Scribe v2 Realtime — 3,6%, а Grok Voice Transcribe 1.0 — 3,9%. В анонсе SpaceXAI упоминала 32 модели на том же лидерборде на момент запуска.
Что измеряет WER: WER — доля слов, распознанных с ошибкой, ниже — лучше.
Что измеряет индекс распознавания речи: индекс Artificial Analysis усредняет WER по 3 наборам тестов (AA‑AgentTalk, VoxPopuli и Earnings‑22). На VoxPopuli преимущество Grok 2.0 максимальное: его WER 1,4% менее чем вдвое меньше, чем у 1.0 (3,1%).
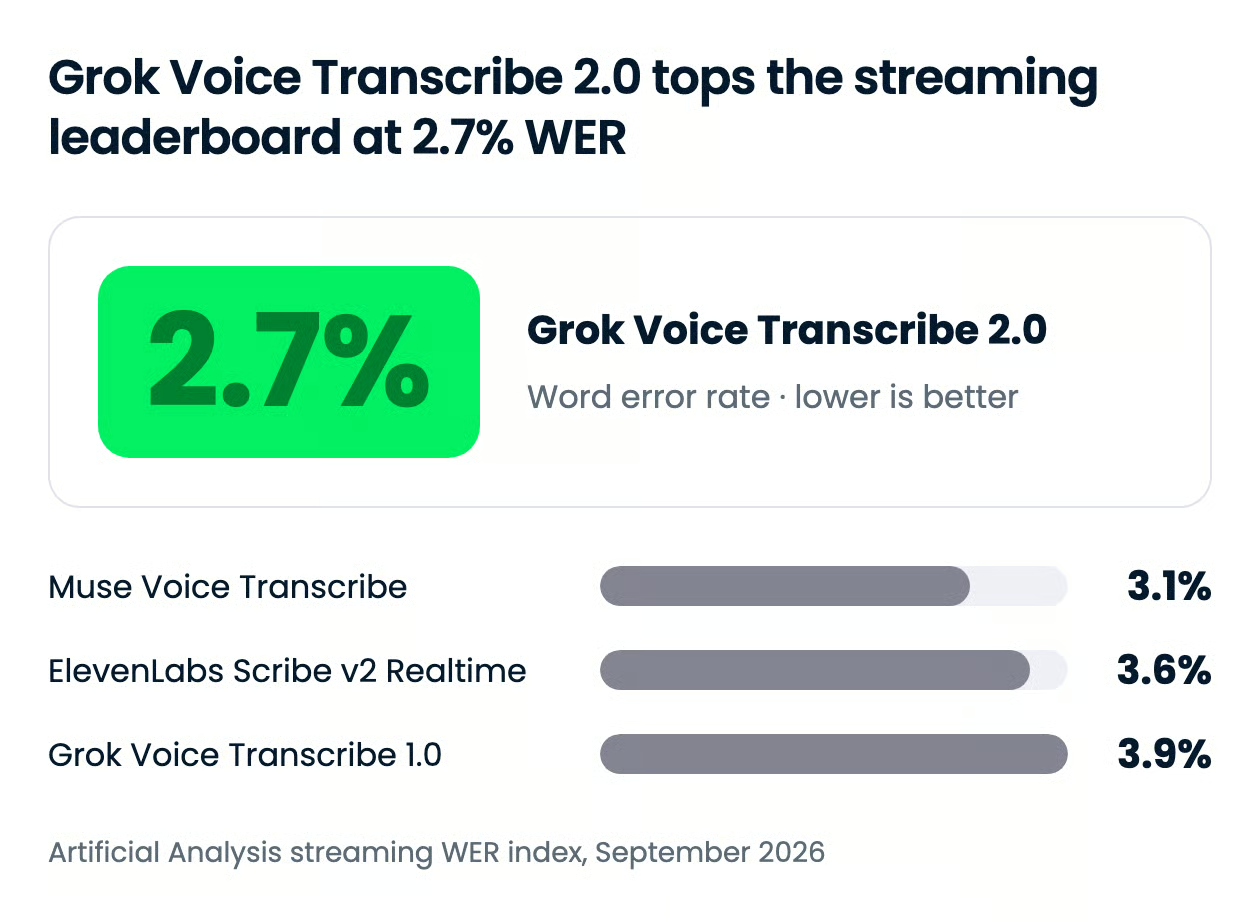
Разрыв с 1.0 по этому индексу — 31%, а не 2x, как заявлено в анонсе. Более крупная цифра опирается на собственные «продовые» наборы SpaceXAI, к которым мы перейдём далее. Тот же лидерборд фиксирует и время до финальной транскрипции — тут картина обратная.
| Модель | Индекс WER (финальная транскрипция) | Время до финальной транскрипции |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2,7% | 0,49 с |
| Muse Voice Transcribe (Meta) | 3,1% | 0,16 с |
| ElevenLabs Scribe v2 Realtime | 3,6% | 0,14 с |
| Grok Voice Transcribe 1.0 | 3,9% | 0,37 с |
| Deepgram Flux | 7,4% | 0,02 с |
Цена — задержка. Grok 2.0 возвращает финальный текст за 0,49 с, против 0,37 с у 1.0 и 0,14 с у Scribe v2 Realtime. Для субтитров это незаметно. Для голосового агента, который отвечает на каждом ходу, лишние десятые секунды накапливаются.
SpaceXAI измеряет WER на четырёх внутренних наборах из продакшн‑трафика:
Grok Voice Transcribe 2.0 улучшает результаты 1.0 по всем четырём, и по телеком‑аудио, по словам SpaceXAI, лидирует среди всех протестированных моделей.
Единственное число, опубликованное SpaceXAI из этих наборов, — результат по коротким фразам: WER падает с 20,6% у 1.0 до 6,8% у 2.0. Короткие команды в машине почти не дают контекста для определения языка — именно с этим у 1.0 были проблемы — и трёхкратное улучшение здесь лучше всего подтверждает тезис «вдвое точнее».
Остальные внутренние графики, включая многоязычное сравнение с ElevenLabs Scribe v2 и Deepgram Nova‑3, представлены столбцами без подписанных значений. Утверждение «лидирует среди всех протестированных нами моделей» по телеком‑аудио стоит воспринимать как заявление вендора, пока кто‑то не воспроизведёт это на своих звонках.
Grok Voice Transcribe 2.0 стоит $0.10 за час аудио в пакетном режиме и $0.20 за час в потоковом — цены идентичны Grok Voice Transcribe 1.0. Диаризация, таймстемпы слов и смещение по ключевым терминам включены в эти тарифы и не тарифицируются отдельно.
| Режим | Цена | Включено |
|---|---|---|
| Пакетный (файл или URL) | $0.10 за час аудио | Диаризация, таймстемпы, ключевые термины, форматирование |
| Потоковый (WebSocket) | $0.20 за час аудио | Диаризация, таймстемпы, ключевые термины, форматирование, «умная» реплика |
Эти ставки — одни из самых низких на потоковом лидерборде. Artificial Analysis указывает для Grok 2.0 $3.33 за 1 000 минут, рядом с $3.00 у Muse Voice Transcribe от Meta и $6.50 у ElevenLabs Scribe v2 Realtime и Deepgram Flux. Среди четырёх самых точных моделей в индексе дешевле только Muse, но у Muse точность ниже.
Модель общедоступна в API SpaceXAI, в анонсе и документации не упоминаются лист ожидания или региональные ограничения. Потребительского тарифа нет — это продукт для API, и ни в анонсе, ни в документации не говорится о бесплатном уровне для распознавания речи.
Значение по умолчанию меняется. SpaceXAI сообщает, что 2.0 вскоре станет значением по умолчанию в Speech‑to‑Text API, а 1.0 будет выведена из эксплуатации в ближайшие недели. До тех пор идентификатор модели стоит указывать явно.
Идентификатор модели — grok-voice-transcribe-2.0, он передаётся как поле формы на REST‑эндпойнте или как параметр запроса на WebSocket‑эндпойнте. Чтобы остаться на старой модели на время вывода из эксплуатации, закрепите grok-voice-transcribe-1.0.
Модель доступна на двух поверхностях: в API SpaceXAI — пакетный режим по адресу https://api.x.ai/v1/stt, потоковый — по адресу wss://api.x.ai/v1/stt, — и в консоли SpaceXAI, где есть «песочница» для распознавания речи в реальном времени. В каталоге OpenRouter её нет по состоянию на 21 сентября 2026 года.
Вот минимальный пакетный вызов, который вернёт транскрипт с диаризацией:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
Для голосовых агентов на WebSocket‑API xAI смотрите наш туториал по API Grok Voice Think Fast 2.0, где разбирается модель speech‑to‑speech, и наш гайд по Grok Voice Agent API. Если вы вызываете текстовые модели Grok из того же кода, туториал по API Grok 4.6 покрывает ключи и вызов инструментов.
Grok Voice Transcribe 2.0 — самый дешёвый способ получить самую точную потоковую транскрипцию на публичном лидерборде, и такое сочетание встречается редко. xAI показывает, что её голосовой стек нацелен на конкуренцию с OpenAI, Google и ElevenLabs — не только текстовыми моделями.
Я бы перешёл на неё, если моё аудио — телефонного качества, многоязычное или насыщено произнесёнными числами: именно здесь 2.0 уходит вперёд от 1.0 и большинства конкурентов. Для чувствительного к задержке голосового агента я бы подождал, пока xAI сократит разрыв с Scribe v2 по времени до финального текста.
Если вы хотите строить конвейеры транскрипции сами, рекомендуем наш курс Spoken Language Processing in Python — от «сырого» аудио до расшифрованных и классифицированных звонков.
Изучайте ИИ с DataCamp!
Course
Track
Course