course
Taligenkänning i Python
4 timmar
9.3K
Strömmande tal-till-text har blivit en fullpackad topplista. OpenAI, Google, ElevenLabs, Meta och Deepgram släpper alla modeller för transkribering i realtid, och Artificial Analysis rankar nu dussintals av dem på ett enda ordfelsindex. SpaceXAI:s senaste modell, Grok Voice Transcribe 2.0, har nu tagit förstaplatsen på det indexet.
I den här artikeln går jag igenom allt som är nytt i Grok Voice Transcribe 2.0, tittar på de nya funktionerna, utforskar de offentliga och interna benchmark-testerna och går igenom prissättning och API-åtkomst. Du kan också läsa våra guider till Grok Voice Think Fast 2.0 API och GPT Live Transcribe API.
Grok Voice Transcribe 2.0 är SpaceXAI:s tal-till-text-modell i andra generationen, och den som xAI nu kallar sin bästa transkriptionsmodell. Den bygger på ljudmodellen bakom Grok Voice, som enligt SpaceXAI redan hanterar tiotusentals kundtjänstsamtal per dag, transkriberar miljontals timmar videoberättelser och driver Grok-assistenten i Tesla-fordon.
Det som ändrats från 1.0 är träningen, inte API:et. SpaceXAI tränade 2.0 på live, brusigt, flerspråkigt ljud inspelat i varierade miljöer och finjusterade sedan med efterträning riktad mot de tuffaste verkliga förhållandena:
Huvudpåståendet är att 2.0 är dubbelt så exakt som 1.0 i xAI:s utvärderingar i verkliga miljöer, med oförändrad prissättning från första generationen. Jag granskar det påståendet i benchmark-avsnittet, eftersom den offentliga topplistan visar en mer modest bild än de interna uppsättningarna.
Funktionslistan är densamma som 1.0 lanserades med, vilket är poängen: xAI lade hela uppgraderingen på noggrannhet och lämnade API-ytan orörd.
Du kan skicka en inspelad fil eller en URL till batch-endpointen, eller strömma rått ljud över en WebSocket och få transkript-händelser tillbaka medan talaren fortfarande pratar. Båda vägarna kör samma modell, så en transkription av en samtalsinspelning och en transkription av det live-samtalet ska se likadana ut.
Batch accepterar filer upp till 500 MB i 12 ljudformat, inklusive WAV, MP3, FLAC och MP4-behållare samt rå PCM och G.711-telefonicodecs. Streaming kan skicka ut partiella transkriptioner ungefär var 500 ms och märker varje resultat som antingen ett låst segment eller en färdig yttring, så att ett undertextgränssnitt kan visa text tidigt och ersätta den senare.
Varje ord kommer tillbaka med start- och sluttid, och om du slår på diariseringsläget läggs en talaretikett till för varje ord utan extra kostnad. För callcenter-ljud med agenten på en kanal och kunden på en annan transkriberar flerkanalsläget upp till 8 kanaler oberoende, vilket helt kringgår diariseringsbehovet.
Svaret är ett JSON-objekt med fullständig text, detekterat språk som en BCP-47-kod, ljudets längd och ordlistan. Det finns inget separat samtal för tidsstämplar att göra.
Du kan skicka upp till 100 nyckeltermer per förfrågan, vardera upp till 50 tecken, för att styra modellen mot produktnamn, läkemedelsnamn eller vad din domän nu uttalar som inte finns i en ordbok. Textformatering skriver tal, datum, valutor, telefonnummer och e-postadresser i skriven form när du sätter språkparametern, vilket SpaceXAI stöder för 25 språk.
Fyllnadsord som ”öh” och ”eh” tas bort som standard. Det är rätt standard för transkriptioner som människor läser och fel för konversationsanalys, så flaggan finns där om du vill ha tillbaka fyllnadsorden.
Smart turdetektering låter en röstagent vänta in slutet av en tanke istället för att hoppa in vid varje paus. Du sätter en tröskel för tillit mellan 0 och 1, och modellen markerar bara yttrandet som färdigt när den är så säker på att talaren är klar; SpaceXAI föreslår 0,5 för balanserad användning och 0,7 när folk dikterar siffror eller adresser.
En tillhörande timeout tvingar turslut efter en fast tystnad, så att en uppringare som går iväg inte låser sessionen. Utan smart turdetektering triggas standard-endpointing efter 400 ms tystnad, vilket är okej för korta kommandon men jobbigt för den som läser upp ett telefonnummer.
Modellen detekterar språket automatiskt och hanterar språkbyten inom en och samma inspelning i ett svep, utan språkhint. SpaceXAI pekar ut flerspråkig noggrannhet som den största förbättringen mot 1.0, och siffrorna för korta fraser i nästa avsnitt stödjer det.
En brasklapp: språkparametern spelar fortfarande roll för formatering. Sätt den när du vill ha siffror och valutor i skriven form, och låt bli när ljudet blandar språk och du hellre vill ha råa ord.
Grok Voice Transcribe 2.0 leder den offentliga topplistan för strömmande transkribering i noggrannhet och slår 1.0 på varje intern uppsättning som SpaceXAI redovisar, men storleken på förbättringen beror starkt på vilket ljud du tittar på.
På Artificial Analysis index för strömmande tal-till-text postar Grok Voice Transcribe 2.0 en ordfelsfrekvens (WER) på 2,7 %, den lägsta av de 34 strömmande modeller som listas per den 21 september 2026. Metas Muse Voice Transcribe följer på 3,1 %, ElevenLabs Scribe v2 Realtime ligger på 3,6 %, och Grok Voice Transcribe 1.0 hamnar på 3,9 %. SpaceXAI:s tillkännagivande räknade 32 modeller på samma topplista vid lansering.
Vad WER mäter: WER är andelen ord som modellen får fel, så lägre är bättre.
Vad tal-till-text-indexet mäter: Artificial Analysis index medelvärdesbildar WER över 3 testuppsättningar (AA-AgentTalk, VoxPopuli och Earnings-22). Grok 2.0:s största ledning är på VoxPopuli, där dess 1,4 % WER är mindre än hälften av 1.0:s 3,1 %.
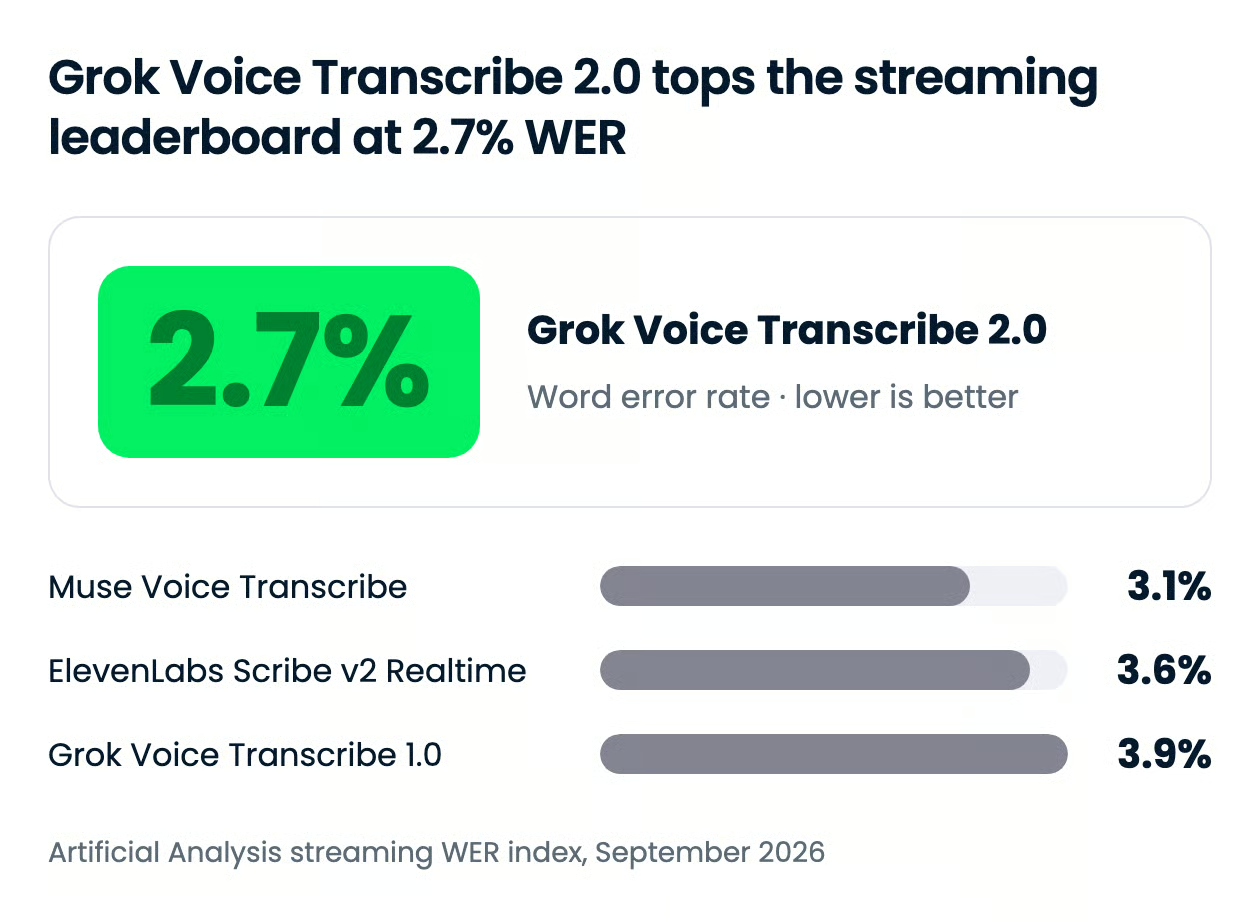
Glappet till 1.0 på detta index är 31 %, inte de 2x som tillkännagivandet lyfter fram. Det större påståendet kommer från SpaceXAI:s egna produktionsuppsättningar, som jag tar upp härnäst. Samma topplista registrerar också hur lång tid varje modell tar på sig att fastställa en slutgiltig transkription, och här vänds bilden.
| Modell | WER-index (slutlig transkription) | Tid till slutlig transkription |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2,7% | 0,49 s |
| Muse Voice Transcribe (Meta) | 3,1% | 0,16 s |
| ElevenLabs Scribe v2 Realtime | 3,6% | 0,14 s |
| Grok Voice Transcribe 1.0 | 3,9% | 0,37 s |
| Deepgram Flux | 7,4% | 0,02 s |
Latensen är kostnaden. Grok 2.0 tar 0,49 s att returnera en slutlig transkription, jämfört med 0,37 s för 1.0 och 0,14 s för Scribe v2 Realtime. För undertexter är det osynligt. För en röstagent som måste svara på varje tur blir de extra tiondelarna en belastning.
SpaceXAI mäter WER på fyra interna uppsättningar hämtade från produktionstrafik:
Grok Voice Transcribe 2.0 förbättras mot 1.0 över alla fyra, och på telefoni säger SpaceXAI att den leder över varje modell som testats.
Det enda talet SpaceXAI publicerar från dessa uppsättningar är resultatet för korta fraser: WER sjunker från 20,6 % med 1.0 till 6,8 % med 2.0. Korta kommandon i bilen ger modellen nästan ingen kontext för att identifiera språket, vilket är precis där 1.0 hade det kämpigt, och en tredubbel förbättring där är det starkaste beviset bakom påståendet ”dubbelt så exakt”.
Resten av de interna diagrammen, inklusive den flerspråkiga jämförelsen mot ElevenLabs Scribe v2 och Deepgram Nova-3, skickas som staplar utan märkta värden. Jag skulle betrakta ”leder varje modell vi testade” på telefoni som ett leverantörspåstående tills någon reproducerar det på sina egna samtalsinspelningar.
Grok Voice Transcribe 2.0 kostar $0,10 per timme ljud för batchtranskribering och $0,20 per timme för strömmande, identiskt med Grok Voice Transcribe 1.0. Diarisering, ordtidsstämplar och styrning med nyckeltermer ingår i dessa priser snarare än att debiteras som tillägg.
| Läge | Pris | Ingår |
|---|---|---|
| Batch (fil eller URL) | $0,10 per timme ljud | Diarisering, tidsstämplar, nyckeltermer, formatering |
| Streaming (WebSocket) | $0,20 per timme ljud | Diarisering, tidsstämplar, nyckeltermer, formatering, smart turdetektering |
Dessa priser är bland de lägsta på topplistan för strömmande. Artificial Analysis listar Grok 2.0 på $3,33 per 1 000 minuter, jämfört med $3,00 för Metas Muse Voice Transcribe och $6,50 för både ElevenLabs Scribe v2 Realtime och Deepgram Flux. Bland de fyra mest exakta modellerna på indexet är bara Muse billigare, och Muse får lägre poäng i noggrannhet.
Modellen är allmänt tillgänglig i SpaceXAI API, utan väntelista eller regionsbegränsning nämnd i tillkännagivandet eller dokumentationen. Det finns ingen konsumentplan att välja, eftersom detta är en API-produkt, och varken tillkännagivandet eller dokumentationen nämner någon gratisnivå för tal-till-text.
Standardvalet är under förändring. SpaceXAI säger att 2.0 snart blir standard i Speech-to-Text API:t och att 1.0 avvecklas under de kommande veckorna. Till dess bör modell-ID anges uttryckligen.
Modell-ID är grok-voice-transcribe-2.0, som skickas som ett formulärfält på REST-endpointen eller som en frågeparameter på WebSocket-endpointen. För att stanna kvar på den gamla modellen under avvecklingsfönstret, lås till grok-voice-transcribe-1.0.
Den körs på två ytor: SpaceXAI API, med batch på https://api.x.ai/v1/stt och strömmande på wss://api.x.ai/v1/stt, samt SpaceXAI-konsolen, som har en spelplats för tal-till-text i realtid. Den finns inte i OpenRouters katalog per den 21 september 2026.
Här är det minsta batchanropet som returnerar en diariserad transkription:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
För röstagenter byggda på xAI:s WebSocket-API:er för röst, se vår Grok Voice Think Fast 2.0 API-handledning, som täcker tal-till-tal-modellen, och vår guide till Grok Voice Agent API. Om du anropar Groks textmodeller från samma kodbas täcker vår Grok 4.6 API-handledning nycklar och verktygsanrop.
Grok Voice Transcribe 2.0 är det billigaste sättet att få den mest exakta strömmande transkriptionen på den offentliga topplistan, och den kombinationen är ovanlig. xAI markerar att dess röststack är tänkt att konkurrera med OpenAI, Google och ElevenLabs, inte bara med dess textmodeller.
Jag skulle byta om mitt ljud är telefonkvalitet, flerspråkigt eller fullt av upplästa siffror, vilket är där 2.0 drar ifrån 1.0 och de flesta konkurrenter. Jag skulle avvakta med en latenskänslig röstagent tills xAI minskar gapet till Scribe v2 vad gäller tid till slutlig transkription.
Om du vill bygga transkriptionspipelines själv rekommenderar jag vår kurs Spoken Language Processing in Python, som går från råa ljudfiler till transkriberade och klassificerade telefonsamtal.
Lär dig AI med DataCamp!
course
track
course