course
Procesarea limbajului vorbit în Python
4 oră
9.3K
Transcrierea vorbirii în timp real a devenit un clasament aglomerat. OpenAI, Google, ElevenLabs, Meta și Deepgram oferă toate modele de transcriere în timp real, iar Artificial Analysis clasează acum zeci dintre ele într-un singur index de rată de eroare pe cuvânt. Noul model al SpaceXAI, Grok Voice Transcribe 2.0, a ajuns acum pe primul loc în acel index.
În acest articol, îți prezint tot ce e nou la Grok Voice Transcribe 2.0: noile funcții, rezultatele din benchmark-urile publice și interne, plus prețurile și accesul la API. Poți vedea și ghidurile noastre pentru API-ul Grok Voice Think Fast 2.0 și API-ul GPT Live Transcribe.
Grok Voice Transcribe 2.0 este modelul speech-to-text de generație a doua al SpaceXAI, iar xAI îl numește acum cel mai bun model de transcriere al său. Este construit pe modelul fundamental audio din spatele Grok Voice, care, potrivit SpaceXAI, gestionează deja zeci de mii de apeluri de suport clienți pe zi, transcrie milioane de ore de narațiune video și alimentează asistentul Grok din vehiculele Tesla.
Ce s-a schimbat față de 1.0 este antrenarea, nu API-ul. SpaceXAI a antrenat 2.0 pe audio live, zgomotos, multilingv, înregistrat în medii variate, apoi l-a rafinat cu post-antrenare țintită pe cele mai dificile condiții din lumea reală:
Afirmația principală este că 2.0 este de două ori mai precis decât 1.0 în evaluările din lumea reală ale xAI, cu prețuri neschimbate față de prima generație. Voi analiza această afirmație în secțiunea de benchmark-uri, pentru că în clasamentul public diferența e mai modestă decât în seturile interne.
Lista de funcții este aceeași cu cea livrată de 1.0, și acesta e și ideea: xAI a investit upgrade-ul în acuratețe și a lăsat suprafața API neschimbată.
Poți trimite un fișier înregistrat sau un URL către endpoint-ul batch, ori poți transmite audio brut prin WebSocket și să primești evenimente de transcript cât timp vorbitorul încă vorbește. Ambele căi rulează același model, astfel încât un transcript al unei înregistrări de apel și un transcript al apelului live ar trebui să arate la fel.
Batch acceptă fișiere de până la 500 MB în 12 formate audio, inclusiv WAV, MP3, FLAC și containere MP4, plus PCM brut și codecurile de telefonie G.711. Streaming-ul poate emite transcripte parțiale aproximativ la fiecare 500 ms și etichetează fiecare rezultat fie ca segment blocat, fie ca rostire finalizată, astfel încât o interfață de subtitrare poate arăta textul devreme și îl poate înlocui ulterior.
Fiecare cuvânt vine cu timp de început și sfârșit, iar activarea diarizării adaugă o etichetă de vorbitor fiecărui cuvânt fără cost suplimentar. Pentru audio de call-center cu agentul pe un canal și clientul pe altul, modul multicanal transcrie până la 8 canale independent, evitând complet diarizarea.
Răspunsul este un singur obiect JSON cu textul integral, limba detectată ca un cod BCP-47, durata audio și lista de cuvinte. Nu există un apel separat pentru timestamp-uri.
Poți trimite până la 100 de termeni-cheie per cerere, fiecare de până la 50 de caractere, pentru a orienta modelul către nume de produse, denumiri de medicamente sau orice termeni specifici domeniului tău care sunt rostiți dar nu apar într-un dicționar. Formatarea textului scrie numerele, datele, valutele, numerele de telefon și adresele de email în formă scrisă când setezi parametrul de limbă, pe care SpaceXAI îl suportă pentru 25 de limbi.
Cuvintele de umplutură precum „ăă” și „hmm” sunt eliminate implicit. Este setarea potrivită pentru transcrise pe care le citesc oamenii și nepotrivită pentru analize conversaționale, așa că există un flag dacă vrei să păstrezi umpluturile.
Detecția inteligentă a turei permite unui agent vocal să aștepte finalul unei idei în loc să intervină la fiecare pauză. Setezi un prag de încredere între 0 și 1, iar modelul marchează rostirea drept finalizată doar când este atât de sigur că vorbitorul a terminat; SpaceXAI sugerează 0,5 pentru uz echilibrat și 0,7 atunci când oamenii dictează numere sau adrese.
Un timeout însoțitor forțează încheierea turei după o perioadă fixă de liniște, astfel încât un apelant care se îndepărtează să nu blocheze sesiunea. Fără tura inteligentă, endpointing-ul implicit se declanșează după 400 ms de liniște, ceea ce e ok pentru comenzi scurte și deranjant pentru oricine dictează un număr de telefon.
Modelul detectează automat limba și gestionează schimbările de limbă în cadrul unei singure înregistrări dintr-o singură trecere, fără indiciu de limbă. SpaceXAI numește acuratețea multilingvă cea mai mare îmbunătățire față de 1.0, iar rezultatele pe fraze scurte din secțiunea următoare confirmă asta.
Un avertisment: parametrul de limbă încă contează pentru formatare. Setează-l când vrei numere și valute în formă scrisă, și lasă-l necompletat când audio-ul amestecă limbi și preferi cuvintele brute.
Grok Voice Transcribe 2.0 conduce clasamentul public de streaming la acuratețe și îl depășește pe 1.0 pe fiecare set intern raportat de SpaceXAI, dar mărimea câștigului depinde mult de tipul de audio analizat.
Pe indexul de speech-to-text în streaming al Artificial Analysis, Grok Voice Transcribe 2.0 obține o rată de eroare pe cuvânt (WER) de 2,7%, cea mai scăzută dintre cele 34 de modele de streaming listate la 21 septembrie 2026. Muse Voice Transcribe de la Meta urmează cu 3,1%, ElevenLabs Scribe v2 Realtime are 3,6%, iar Grok Voice Transcribe 1.0 rămâne la 3,9%. Anunțul SpaceXAI număra 32 de modele pe același clasament la lansare.
Ce măsoară WER: WER este ponderea cuvintelor pe care modelul le greșește, deci mai mic e mai bine.
Ce măsoară indexul speech-to-text: Indexul Artificial Analysis face media WER-ului pe 3 seturi de test (AA-AgentTalk, VoxPopuli și Earnings-22). Avansul cel mai mare al lui Grok 2.0 este pe VoxPopuli, unde WER-ul de 1,4% este mai puțin de jumătate din 3,1% al versiunii 1.0.
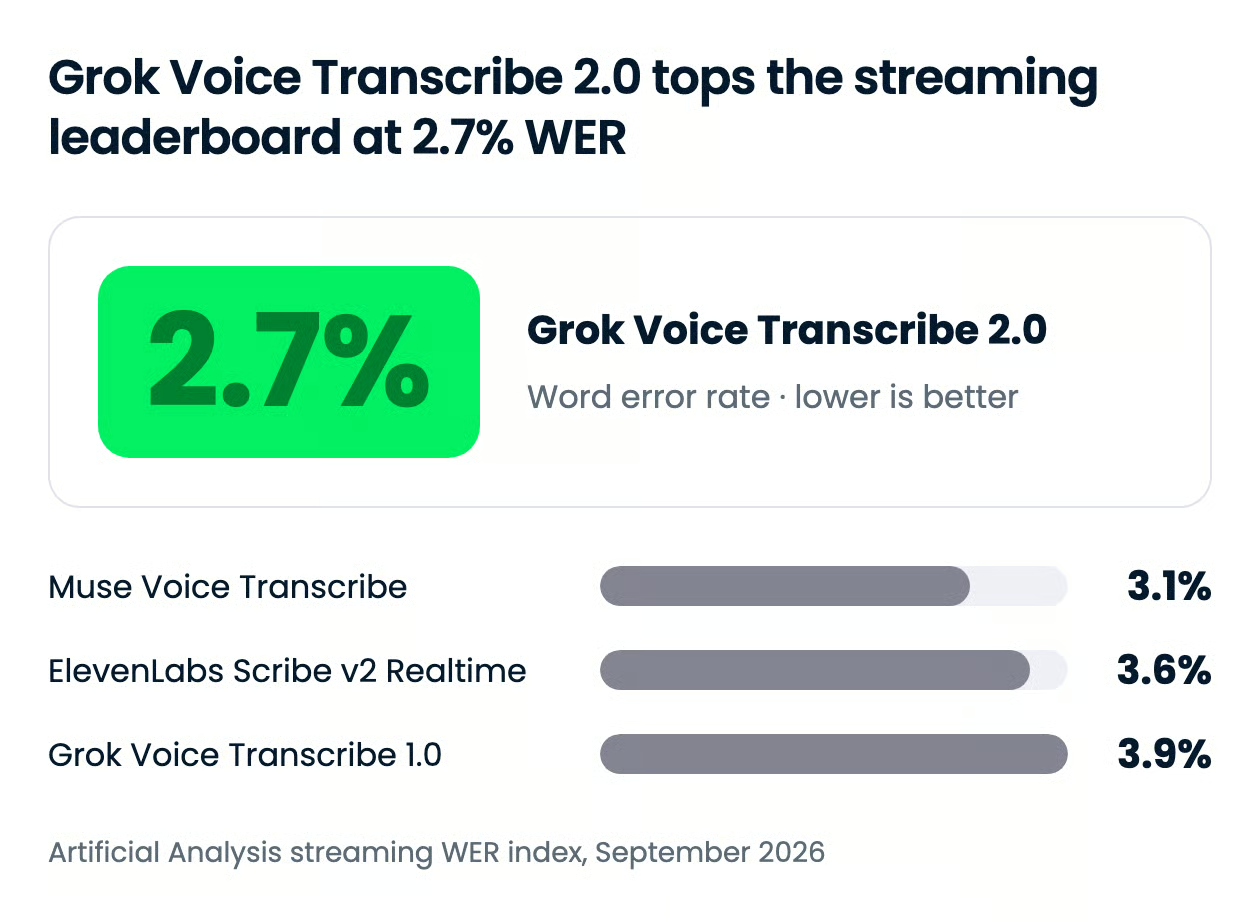
Diferența față de 1.0 pe acest index este de 31%, nu de 2x cum sugerează anunțul. Acea afirmație mai mare vine din seturile de producție ale SpaceXAI, pe care le acopăr în continuare. Același clasament notează și cât durează ca fiecare model să confirme transcriptul final, iar aici imaginea se inversează.
| Model | Index WER (transcript final) | Timp până la transcriptul final |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2,7% | 0,49 s |
| Muse Voice Transcribe (Meta) | 3,1% | 0,16 s |
| ElevenLabs Scribe v2 Realtime | 3,6% | 0,14 s |
| Grok Voice Transcribe 1.0 | 3,9% | 0,37 s |
| Deepgram Flux | 7,4% | 0,02 s |
Latența este costul. Grok 2.0 are nevoie de 0,49 s pentru a returna transcriptul final, față de 0,37 s pentru 1.0 și 0,14 s pentru Scribe v2 Realtime. Pentru subtitrări, asta e invizibil. Pentru un agent vocal care trebuie să răspundă la fiecare tură, zecimile suplimentare de secundă se adună.
SpaceXAI măsoară WER pe patru seturi interne extrase din trafic de producție:
Grok Voice Transcribe 2.0 îmbunătățește 1.0 pe toate cele patru, iar pe telefonie SpaceXAI spune că depășește orice model testat.
Singurul număr publicat de SpaceXAI din aceste seturi este rezultatul pe fraze scurte: WER scade de la 20,6% cu 1.0 la 6,8% cu 2.0. Comenzile scurte în mașină oferă modelului aproape deloc context pentru a identifica limba, exact zona în care 1.0 a avut dificultăți, iar o îmbunătățire de 3x acolo este cea mai solidă dovadă pentru afirmația „de două ori mai precis”.
Restul graficelor interne, inclusiv comparația multilingvă cu ElevenLabs Scribe v2 și Deepgram Nova-3, sunt bare fără valori etichetate. Aș trata „conduce orice model testat” pe telefonie ca pe o afirmație de vendor până când cineva o reproduce pe propriile apeluri.
Grok Voice Transcribe 2.0 costă $0,10 pe oră de audio pentru transcriere batch și $0,20 pe oră pentru streaming, identic cu Grok Voice Transcribe 1.0. Diarizarea, timestamp-urile pe cuvânt și influențarea prin termeni-cheie sunt incluse în aceste tarife, nu facturate ca extraopțiuni.
| Mod | Preț | Inclus |
|---|---|---|
| Batch (fișier sau URL) | $0,10 pe oră de audio | Diarizare, timestamp-uri, termeni-cheie, formatare |
| Streaming (WebSocket) | $0,20 pe oră de audio | Diarizare, timestamp-uri, termeni-cheie, formatare, tură inteligentă |
Aceste tarife se numără printre cele mai mici din clasamentul de streaming. Artificial Analysis listează Grok 2.0 la $3,33 per 1.000 de minute, lângă $3,00 pentru Muse Voice Transcribe de la Meta și $6,50 atât pentru ElevenLabs Scribe v2 Realtime, cât și pentru Deepgram Flux. Dintre cele mai precise patru modele din index, doar Muse este mai ieftin, iar Muse are scor mai mic la acuratețe.
Modelul este disponibil în general în API-ul SpaceXAI, fără listă de așteptare sau restricții regionale menționate în anunț sau în documentație. Nu există un plan pentru consumatori, pentru că este un produs de tip API, iar nici anunțul, nici documentația nu menționează un nivel gratuit pentru speech-to-text.
Implicitele sunt în tranziție. SpaceXAI spune că 2.0 va deveni în curând implicitul în API-ul Speech-to-Text și că 1.0 va fi depreciat în săptămânile următoare. Până atunci, ID-ul modelului ar trebui setat explicit.
ID-ul modelului este grok-voice-transcribe-2.0, transmis ca un câmp de formular pe endpoint-ul REST sau ca parametru de query pe endpoint-ul WebSocket. Pentru a rămâne pe vechiul model pe durata ferestrei de depreciere, fixează grok-voice-transcribe-1.0.
Rulează pe două suprafețe: API-ul SpaceXAI, cu batch la https://api.x.ai/v1/stt și streaming la wss://api.x.ai/v1/stt, și consola SpaceXAI, care are un playground live pentru speech-to-text. Nu se află în catalogul OpenRouter la 21 septembrie 2026.
Iată cel mai mic apel batch care returnează un transcript cu diarizare:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
Pentru agenți vocali construiți pe API-urile vocale WebSocket ale xAI, vezi tutorialul nostru despre API-ul Grok Voice Think Fast 2.0, care acoperă modelul speech-to-speech, și ghidul nostru pentru API-ul Grok Voice Agent. Dacă apelezi modelele text ale lui Grok din același cod, tutorialul nostru despre API-ul Grok 4.6 acoperă cheile și tool calling.
Grok Voice Transcribe 2.0 este cea mai ieftină modalitate de a obține cel mai precis transcript de streaming din clasamentul public, iar combinația asta e rară. xAI transmite clar că stiva sa vocală vrea să concureze cu OpenAI, Google și ElevenLabs, nu doar cu modelele sale text.
Aș face trecerea dacă audio-ul meu este de calitate telefonică, multilingv sau plin de numere rostite — acolo 2.0 se detașează de 1.0 și de majoritatea rivalilor. Aș amâna pentru un agent vocal sensibil la latență până când xAI reduce decalajul față de Scribe v2 la timpul până la transcriptul final.
Dacă vrei să construiești singur pipeline-uri de transcriere, îți recomand cursul nostru Spoken Language Processing in Python, care parcurge drumul de la fișiere audio brute la apeluri telefonice transcrise și clasificate.
Învață AI cu DataCamp!
course
track
course