
Cours
Traitement du langage parlé en Python
4 h
9.3K
Le streaming speech-to-text est devenu un véritable terrain de compétition. OpenAI, Google, ElevenLabs, Meta et Deepgram proposent tous des modèles de transcription en temps réel, et Artificial Analysis classe désormais des dizaines d'entre eux selon un indice de taux d'erreurs par mot. Le tout dernier modèle de SpaceXAI, Grok Voice Transcribe 2.0, occupe désormais la première place de cet indice.
Dans cet article, nous passons en revue toutes les nouveautés de Grok Voice Transcribe 2.0 : ses fonctionnalités, les benchmarks publics et internes, ainsi que les tarifs et l'accès à l'API. Consultez aussi nos guides de l'API Grok Voice Think Fast 2.0 et de l'API GPT Live Transcribe.
Grok Voice Transcribe 2.0 est le modèle speech-to-text de deuxième génération de SpaceXAI, que xAI présente comme son meilleur modèle de transcription. Il est fondé sur le modèle de base audio derrière Grok Voice, qui, selon SpaceXAI, gère déjà des dizaines de milliers d'appels de support client par jour, transcrit des millions d'heures de narration vidéo et alimente l'assistant Grok dans les véhicules Tesla.
Ce qui change par rapport à la 1.0, c'est l'entraînement, pas l'API. SpaceXAI a entraîné la 2.0 sur de l'audio en direct, bruité et multilingue, enregistré dans des environnements variés, puis l'a affinée par un post-entraînement ciblant les conditions réelles les plus difficiles :
La promesse phare : la 2.0 serait deux fois plus précise que la 1.0 sur les évaluations en conditions réelles de xAI, sans changement de tarif. Nous reviendrons sur cette affirmation dans la section benchmarks, car le classement public raconte une histoire plus nuancée que les jeux internes.
La liste des fonctions reste celle de la 1.0 : xAI a concentré toute la mise à niveau sur la précision et n'a pas touché à la surface de l'API.
Vous pouvez envoyer un fichier enregistré ou une URL vers l'endpoint batch, ou bien streamer de l'audio brut via WebSocket et recevoir des événements de transcription pendant que l'interlocuteur parle encore. Les deux voies utilisent le même modèle : la transcription d'un enregistrement d'appel et celle de l'appel en direct doivent donc être identiques.
Le mode batch accepte des fichiers jusqu'à 500 Mo dans 12 formats audio, dont WAV, MP3, FLAC, ainsi que des conteneurs MP4, plus le PCM brut et les codecs téléphoniques G.711. En streaming, le modèle peut émettre des transcriptions partielles toutes les ~500 ms et marque chaque résultat comme bloc figé ou énoncé final, ce qui permet à une interface de sous-titrage d'afficher très tôt puis de remplacer ensuite.
Chaque mot est renvoyé avec une heure de début et de fin, et l'activation de la diarisation ajoute un label de locuteur à chaque mot sans coût supplémentaire. Pour l'audio centre d'appels avec l'agent sur un canal et le client sur un autre, le mode multicanal transcrit jusqu'à 8 canaux indépendamment, ce qui permet de se passer de la diarisation.
La réponse est un objet JSON unique contenant le texte complet, la langue détectée (code BCP-47), la durée audio et le tableau des mots. Il n'y a pas d'appel séparé pour les horodatages.
Vous pouvez transmettre jusqu'à 100 termes clés par requête, chacun jusqu'à 50 caractères, pour biaiser le modèle vers des noms de produits, de médicaments, ou tout terme prononcé propre à votre domaine et absent des dictionnaires. Le formatage du texte écrit les nombres, dates, devises, numéros de téléphone et adresses e-mail sous leur forme écrite lorsque vous définissez le paramètre de langue, que SpaceXAI prend en charge pour 25 langues.
Les mots de remplissage comme « euh » sont supprimés par défaut. C'est le bon choix pour une transcription destinée à la lecture humaine, et le mauvais pour l'analyse conversationnelle ; activez le drapeau si vous souhaitez les conserver.
La détection intelligente de tours de parole permet à un agent vocal d'attendre la fin d'une idée plutôt que de réagir à chaque silence. Vous définissez un seuil de confiance entre 0 et 1, et le modèle ne marque l'énoncé comme terminé que lorsqu'il est suffisamment confiant que l'intervenant a fini ; SpaceXAI suggère 0,5 pour un usage équilibré et 0,7 lorsque des nombres ou adresses sont dictés.
Un délai compagnon force la fin du tour après un silence fixe, évitant qu'un appelant parti séjourne ne bloque la session. Sans détection intelligente, l'endpointing par défaut se déclenche après 400 ms de silence : bien pour de courtes commandes, pénalisant pour la dictée d'un numéro de téléphone.
Le modèle détecte automatiquement la langue et gère les changements de langue au sein d'un même enregistrement en un seul passage, sans indice de langue requis. SpaceXAI présente l'amélioration en multilingue comme la plus marquante face à la 1.0, et les chiffres sur courtes phrases présentés plus loin le confirment.
Un point d'attention : le paramètre de langue reste important pour le formatage. Renseignez-le si vous souhaitez des nombres et devises en forme écrite, et laissez-le vide si l'audio mêle des langues et que vous préférez les mots bruts.
Grok Voice Transcribe 2.0 mène le classement public du streaming en précision et surpasse la 1.0 sur tous les jeux internes rapportés par SpaceXAI, mais l'ampleur du gain varie fortement selon les types d'audio.
Sur l'indice streaming speech-to-text d'Artificial Analysis, Grok Voice Transcribe 2.0 affiche un WER (Word Error Rate) de 2,7 %, le plus bas des 34 modèles en streaming listés au 21 septembre 2026. Muse Voice Transcribe de Meta suit à 3,1 %, ElevenLabs Scribe v2 Realtime est à 3,6 %, et Grok Voice Transcribe 1.0 ferme la marche à 3,9 %. L'annonce de SpaceXAI comptait 32 modèles sur le même classement au lancement.
Ce que mesure le WER : le WER correspond à la part de mots mal transcrits : plus il est bas, mieux c'est.
Ce que mesure l'indice speech-to-text : l'indice d'Artificial Analysis moyenne le WER sur 3 jeux de test (AA-AgentTalk, VoxPopuli et Earnings-22). L'avance la plus large de Grok 2.0 est sur VoxPopuli : son WER de 1,4 % représente moins de la moitié de celui de la 1.0 (3,1 %).
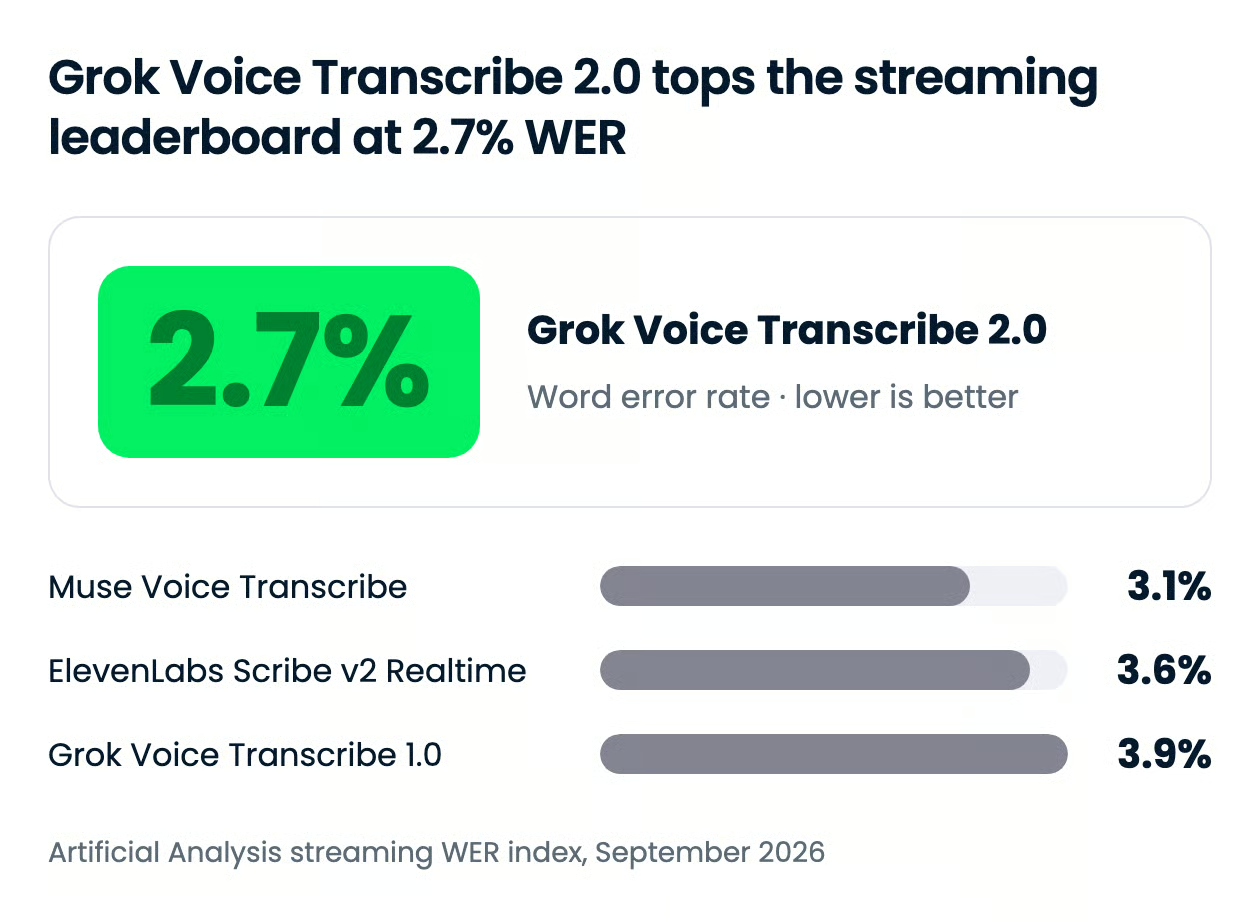
L'écart avec la 1.0 sur cet indice est de 31 %, et non pas « fois deux » comme le laisse entendre l'annonce. Cette affirmation plus ambitieuse vient des jeux en production de SpaceXAI, que nous abordons ensuite. Le même classement mesure également le délai jusqu'à la transcription finale, et là, le tableau s'inverse.
| Modèle | Indice WER (transcription finale) | Délai jusqu'à la transcription finale |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2,7 % | 0,49 s |
| Muse Voice Transcribe (Meta) | 3,1 % | 0,16 s |
| ElevenLabs Scribe v2 Realtime | 3,6 % | 0,14 s |
| Grok Voice Transcribe 1.0 | 3,9 % | 0,37 s |
| Deepgram Flux | 7,4 % | 0,02 s |
La latence est le coût à payer. Grok 2.0 met 0,49 s à renvoyer une transcription finale, contre 0,37 s pour la 1.0 et 0,14 s pour Scribe v2 Realtime. Pour des sous-titres, c'est invisible. Pour un agent vocal qui doit répondre à chaque tour de parole, ces dixièmes s'additionnent.
SpaceXAI mesure le WER sur quatre jeux internes issus du trafic de production :
Grok Voice Transcribe 2.0 s'améliore face à la 1.0 sur les quatre, et sur la téléphonie, SpaceXAI affirme devancer tous les modèles testés.
Le seul chiffre publié par SpaceXAI pour ces jeux concerne les courtes phrases : le WER passe de 20,6 % (1.0) à 6,8 % (2.0). En voiture, de brèves commandes laissent très peu de contexte pour identifier la langue, ce qui était justement le point faible de la 1.0 ; un gain par 3 constitue l'indicateur le plus probant derrière l'affirmation « deux fois plus précise ».
Le reste des graphiques internes, y compris la comparaison multilingue face à ElevenLabs Scribe v2 et Deepgram Nova-3, est présenté sous forme d'histogrammes sans valeurs chiffrées. Traitez « devance tous les modèles testés » sur la téléphonie comme une revendication fournisseur jusqu'à reproduction sur vos propres audios d'appel.
Grok Voice Transcribe 2.0 coûte 0,10 $ par heure d'audio en batch et 0,20 $ par heure en streaming, identique à Grok Voice Transcribe 1.0. La diarisation, les horodatages par mot et le biais sur termes clés sont inclus dans ces tarifs, sans suppléments.
| Mode | Prix | Inclus |
|---|---|---|
| Batch (fichier ou URL) | 0,10 $ par heure d'audio | Diarisation, horodatages, termes clés, formatage |
| Streaming (WebSocket) | 0,20 $ par heure d'audio | Diarisation, horodatages, termes clés, formatage, tour de parole intelligent |
Ces tarifs comptent parmi les plus bas du classement streaming. Artificial Analysis indique Grok 2.0 à 3,33 $ pour 1 000 minutes, contre 3,00 $ pour Muse Voice Transcribe de Meta et 6,50 $ pour ElevenLabs Scribe v2 Realtime comme pour Deepgram Flux. Parmi les quatre modèles les plus précis de l'indice, seul Muse est moins cher, mais avec une précision inférieure.
Le modèle est généralement disponible via l'API SpaceXAI, sans liste d'attente ni restriction régionale mentionnées dans l'annonce ou la documentation. Il n'y a pas d'offre grand public, car il s'agit d'un produit API, et ni l'annonce ni la documentation ne mentionnent de palier gratuit pour le speech-to-text.
Le défaut est en cours de transition. SpaceXAI indique que la 2.0 deviendra bientôt le défaut de l'API Speech-to-Text et que la 1.0 sera dépréciée dans les prochaines semaines. D'ici là, fixez l'ID du modèle explicitement.
L'ID du modèle est grok-voice-transcribe-2.0, transmis comme champ de formulaire sur l'endpoint REST ou comme paramètre de requête sur l'endpoint WebSocket. Pour rester sur l'ancien modèle pendant la période de dépréciation, indiquez grok-voice-transcribe-1.0.
Le modèle fonctionne sur deux surfaces : l'API SpaceXAI, avec le batch sur https://api.x.ai/v1/stt et le streaming sur wss://api.x.ai/v1/stt, et la console SpaceXAI, qui propose un bac à sable de transcription vocale en direct. Il n'apparaît pas dans le catalogue OpenRouter au 21 septembre 2026.
Voici l'appel batch minimal qui renvoie une transcription avec diarisation :
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
Pour les agents vocaux construits sur les APIs vocales WebSocket de xAI, consultez notre tutoriel sur l'API Grok Voice Think Fast 2.0, qui couvre le modèle speech-to-speech, ainsi que notre guide de l'API Grok Voice Agent. Si vous appelez aussi les modèles texte de Grok depuis le même code, notre tutoriel API Grok 4.6 couvre les clés et l'orchestration d'outils.
Grok Voice Transcribe 2.0 est aujourd'hui la façon la moins chère d'obtenir la transcription streaming la plus précise du classement public, une combinaison rare. xAI envoie le signal que sa pile vocale vise OpenAI, Google et ElevenLabs, pas seulement la compétition sur les modèles texte.
Je basculerais si mon audio est de qualité téléphonique, multilingue ou plein de nombres dictés : c'est là que la 2.0 se démarque de la 1.0 et de la plupart des rivaux. J'attendrais en revanche pour un agent vocal très sensible à la latence, le temps que xAI comble l'écart avec Scribe v2 sur le délai de transcription finale.
Si vous souhaitez construire vous-même des pipelines de transcription, nous vous recommandons notre cours Spoken Language Processing in Python, qui va des fichiers audio bruts jusqu'à la transcription et la classification d'appels.
Apprenez l'IA avec DataCamp !
Cours
Cursus
Cours