
Corso
Elaborazione del linguaggio parlato in Python
4 h
9.3K
Lo speech-to-text in streaming è diventato una classifica affollata. OpenAI, Google, ElevenLabs, Meta e Deepgram offrono tutti modelli di trascrizione in tempo reale, e Artificial Analysis ora ne ordina decine su un unico indice di word error rate. Il modello più recente di SpaceXAI, Grok Voice Transcribe 2.0, ha appena conquistato la vetta di quell’indice.
In questo articolo, ti racconto tutte le novità di Grok Voice Transcribe 2.0: nuove funzionalità, benchmark pubblici e interni, prezzi e accesso API. Puoi anche consultare le nostre guide alle API di Grok Voice Think Fast 2.0 e alle GPT Live Transcribe API.
Grok Voice Transcribe 2.0 è il modello speech-to-text di seconda generazione di SpaceXAI, e quello che xAI definisce il suo miglior modello di trascrizione. Si basa sul foundation model audio dietro Grok Voice, che secondo SpaceXAI già gestisce decine di migliaia di chiamate di assistenza clienti al giorno, trascrive milioni di ore di narrazione video e alimenta l’assistente Grok nei veicoli Tesla.
Rispetto alla 1.0 è cambiato l’addestramento, non l’API. SpaceXAI ha addestrato la 2.0 su audio live, rumoroso e multilingue registrato in ambienti diversi, poi l’ha raffinato con post-training mirato alle condizioni reali più difficili:
Il claim principale è che la 2.0 sia due volte più accurata della 1.0 nelle valutazioni reali di xAI, con prezzi invariati rispetto alla prima generazione. Analizzo meglio questo claim nella sezione benchmark, perché la classifica pubblica racconta una storia più prudente rispetto ai set interni.
La lista delle feature è la stessa con cui è uscita la 1.0, ed è proprio questo il punto: xAI ha investito tutto il salto nell’accuratezza, lasciando invariata la superficie dell’API.
Puoi inviare un file registrato o un URL all’endpoint batch, oppure trasmettere audio grezzo via WebSocket e ricevere eventi di trascrizione mentre l’oratore parla. Entrambi i percorsi usano lo stesso modello, quindi la trascrizione di una registrazione di chiamata e quella della chiamata live dovrebbero risultare identiche.
Il batch accetta file fino a 500 MB in 12 formati audio, inclusi WAV, MP3, FLAC e contenitori MP4, oltre a PCM grezzo e codec telefonici G.711. Lo streaming può emettere trascrizioni parziali circa ogni 500 ms ed etichetta ogni risultato come blocco bloccato o enunciato finale, così un’interfaccia di sottotitolazione può mostrare testo in anticipo e sostituirlo in seguito.
Ogni parola torna con un tempo di inizio e fine, e attivare la diarizzazione aggiunge un’etichetta parlante a ogni parola senza costi aggiuntivi. Per l’audio da call center con l’agente su un canale e il cliente su un altro, la modalità multicanale trascrive fino a 8 canali in modo indipendente, evitando del tutto la diarizzazione.
La risposta è un unico oggetto JSON con il testo completo, la lingua rilevata come codice BCP-47, la durata dell’audio e l’array delle parole. Non serve alcuna chiamata separata per i timestamp.
Puoi passare fino a 100 termini chiave per richiesta, ciascuno fino a 50 caratteri, per orientare il modello verso nomi di prodotto, farmaci o qualunque termine del tuo dominio che non compaia in un dizionario. Il text formatting scrive numeri, date, valute, numeri di telefono e indirizzi email nella loro forma scritta quando imposti il parametro della lingua, che SpaceXAI supporta per 25 lingue.
Parole riempitive come "ehm" e "uh" vengono rimosse per default. È l’impostazione giusta per trascrizioni destinate alla lettura e quella sbagliata per l’analisi conversazionale, quindi trovi il flag se vuoi reinserire i filler.
La smart turn detection permette a un voice agent di aspettare la fine del pensiero invece di intervenire a ogni pausa. Imposti una soglia di confidenza tra 0 e 1, e il modello segna l’enunciato come concluso solo quando è così sicuro che l’oratore abbia finito; SpaceXAI suggerisce 0,5 per un uso bilanciato e 0,7 quando si dettano numeri o indirizzi.
Un timeout complementare forza la chiusura del turno dopo un silenzio fisso, così un chiamante che si allontana non blocca la sessione. Senza smart turn, l’endpointing predefinito scatta dopo 400 ms di silenzio: va bene per comandi brevi, ma è doloroso per chi detta un numero di telefono.
Il modello rileva la lingua automaticamente e gestisce i passaggi tra lingue all’interno di un’unica registrazione in un solo passaggio, senza bisogno di suggerire la lingua. SpaceXAI indica l’accuratezza multilingue come il maggiore miglioramento rispetto alla 1.0, e i numeri su frasi brevi nella prossima sezione lo confermano.
Una nota: il parametro della lingua conta ancora per il formatting. Impostalo quando vuoi numeri e valute in forma scritta, e lascialo vuoto quando l’audio mescola lingue e preferisci le parole grezze.
Grok Voice Transcribe 2.0 guida la classifica pubblica dello streaming per accuratezza e batte la 1.0 su ogni set interno riportato da SpaceXAI, ma l’entità del guadagno dipende molto dall’audio considerato.
Sull’indice speech-to-text in streaming di Artificial Analysis, Grok Voice Transcribe 2.0 registra un word error rate (WER) del 2,7%, il più basso tra i 34 modelli in streaming elencati al 21 settembre 2026. Segue Muse Voice Transcribe di Meta al 3,1%, ElevenLabs Scribe v2 Realtime al 3,6% e Grok Voice Transcribe 1.0 al 3,9%. L’annuncio di SpaceXAI contava 32 modelli sulla stessa classifica al lancio.
Cosa misura il WER: il WER è la quota di parole che il modello sbaglia, quindi più basso è, meglio è.
Cosa misura l’indice speech-to-text: l’indice di Artificial Analysis fa la media del WER su 3 set di test (AA-AgentTalk, VoxPopuli ed Earnings-22). Il distacco maggiore di Grok 2.0 è su VoxPopuli, dove il suo WER dell’1,4% è meno della metà del 3,1% della 1.0.
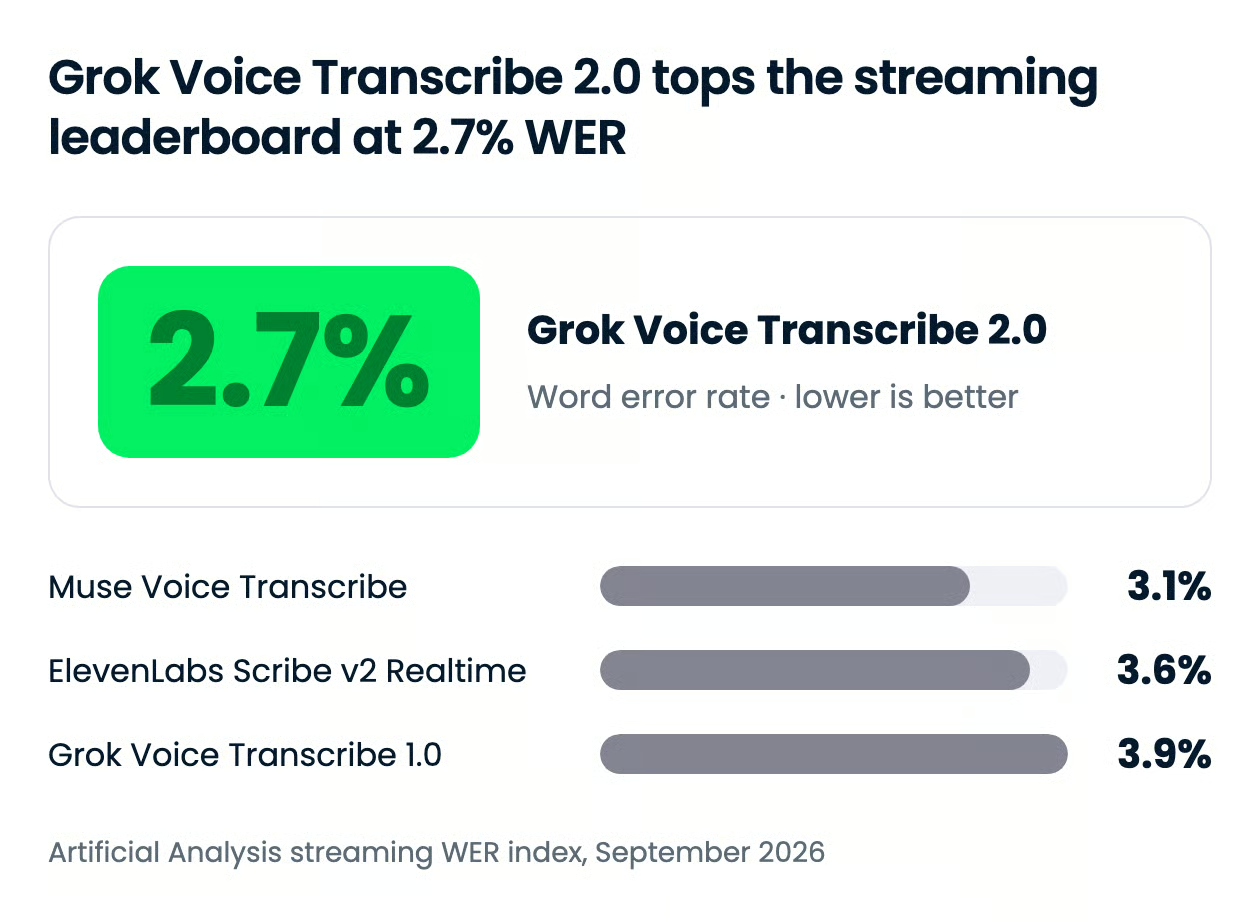
Il gap con la 1.0 su questo indice è del 31%, non il 2x sottolineato nell’annuncio. Quel claim più ampio arriva dai set di produzione di SpaceXAI, che tratto tra poco. La stessa classifica registra anche il tempo che ogni modello impiega a consolidare la trascrizione finale, e qui il quadro si ribalta.
| Modello | Indice WER (trascrizione finale) | Tempo alla trascrizione finale |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2,7% | 0,49 s |
| Muse Voice Transcribe (Meta) | 3,1% | 0,16 s |
| ElevenLabs Scribe v2 Realtime | 3,6% | 0,14 s |
| Grok Voice Transcribe 1.0 | 3,9% | 0,37 s |
| Deepgram Flux | 7,4% | 0,02 s |
La latenza è il prezzo da pagare. Grok 2.0 impiega 0,49 s per restituire la trascrizione finale, contro 0,37 s della 1.0 e 0,14 s di Scribe v2 Realtime. Per i sottotitoli è invisibile. Per un voice agent che deve rispondere a ogni turno, quei decimi di secondo si sommano.
SpaceXAI misura il WER su quattro set interni tratti dal traffico di produzione:
Grok Voice Transcribe 2.0 migliora rispetto alla 1.0 su tutti e quattro, e sulla telefonia SpaceXAI afferma di superare ogni modello testato.
L’unico numero che SpaceXAI pubblica da questi set è il risultato sulle frasi brevi: il WER scende dal 20,6% con la 1.0 al 6,8% con la 2.0. I comandi brevi in auto offrono al modello quasi nessun contesto per identificare la lingua, che è proprio dove la 1.0 faticava, e un miglioramento di 3x lì è la prova più forte a sostegno del claim "due volte più accurata".
Il resto dei grafici interni, inclusi i confronti multilingue con ElevenLabs Scribe v2 e Deepgram Nova-3, arriva come barre senza valori etichettati. Tratterei "guida ogni modello testato" sulla telefonia come un claim del fornitore finché qualcuno non lo riproduce sul proprio audio di chiamata.
Grok Voice Transcribe 2.0 costa $0,10 all’ora di audio per la trascrizione batch e $0,20 all’ora per lo streaming, identico a Grok Voice Transcribe 1.0. Diarizzazione, timestamp delle parole e bias dei termini chiave sono inclusi in quelle tariffe, non fatturati come add-on.
| Modalità | Prezzo | Incluso |
|---|---|---|
| Batch (file o URL) | $0,10 per ora di audio | Diarizzazione, timestamp, termini chiave, formattazione |
| Streaming (WebSocket) | $0,20 per ora di audio | Diarizzazione, timestamp, termini chiave, formattazione, smart turn |
Queste tariffe sono tra le più basse nella classifica streaming. Artificial Analysis riporta Grok 2.0 a $3,33 per 1.000 minuti, accanto a $3,00 per Muse Voice Transcribe di Meta e $6,50 per ElevenLabs Scribe v2 Realtime e Deepgram Flux. Tra i quattro modelli più accurati sull’indice, solo Muse costa meno, e Muse ha un’accuratezza inferiore.
Il modello è generalmente disponibile nella API di SpaceXAI, senza lista d’attesa o restrizioni di regione menzionate nell’annuncio o nella documentazione. Non c’è un piano consumer da scegliere, perché è un prodotto API, e né l’annuncio né i docs menzionano un livello gratuito per lo speech-to-text.
Il default è in transizione. SpaceXAI afferma che la 2.0 diventerà presto il default nella Speech-to-Text API e che la 1.0 verrà deprecata nelle prossime settimane. Fino ad allora, imposta esplicitamente l’ID del modello.
L’ID del modello è grok-voice-transcribe-2.0, passato come campo form sull’endpoint REST o come parametro query sull’endpoint WebSocket. Per restare sul modello precedente durante la finestra di deprecazione, fissa grok-voice-transcribe-1.0.
Funziona su due superfici: l’API di SpaceXAI, con batch su https://api.x.ai/v1/stt e streaming su wss://api.x.ai/v1/stt, e la console SpaceXAI, che offre un playground live per lo speech-to-text. Non è nel catalogo di OpenRouter al 21 settembre 2026.
Ecco la chiamata batch minima che restituisce una trascrizione con diarizzazione:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
Per i voice agent costruiti sulle API vocali WebSocket di xAI, vedi il nostro tutorial sull’API Grok Voice Think Fast 2.0, che copre il modello speech-to-speech, e la nostra guida all’API Grok Voice Agent. Se chiami i modelli testuali di Grok dallo stesso codebase, il nostro tutorial sull’API Grok 4.6 copre chiavi e tool calling.
Grok Voice Transcribe 2.0 è il modo più economico per ottenere la trascrizione in streaming più accurata sulla classifica pubblica, e questa combinazione è rara. xAI manda un segnale: il suo stack vocale vuole competere con OpenAI, Google ed ElevenLabs, non solo con i modelli testuali.
Io passerei a 2.0 se il mio audio è di qualità telefonica, multilingue o pieno di numeri dettati: è lì che si allontana dalla 1.0 e da molti rivali. Aspetterei invece per un voice agent sensibile alla latenza finché xAI non colma il divario con Scribe v2 sul tempo alla trascrizione finale.
Se vuoi costruire pipeline di trascrizione in autonomia, ti consiglio il nostro corso Spoken Language Processing in Python, che va dai file audio grezzi a chiamate telefoniche trascritte e classificate.
Impara l’AI con DataCamp!
Corso
Programma
Corso