Courses
Spoken Language Processing ด้วย Python
4 ชม.
9.3K
การถอดเสียงแบบสตรีมมิงกลายเป็นสนามแข่งขันที่คึกคัก OpenAI, Google, ElevenLabs, Meta และ Deepgram ต่างก็ปล่อยโมเดลถอดเสียงแบบเรียลไทม์ ขณะที่ Artificial Analysis จัดอันดับพวกมันหลายสิบโมเดลด้วยดัชนีอัตราความผิดพลาดของคำเพียงตัวเดียว ล่าสุดโมเดลใหม่ของ SpaceXAI คือ Grok Voice Transcribe 2.0 ขึ้นนำบนดัชนีนั้นแล้ว
บทความนี้จะสรุปทุกอย่างที่ใหม่ใน Grok Voice Transcribe 2.0 ทั้งฟีเจอร์ที่เพิ่มมา ผลทดสอบทั้งสาธารณะและภายใน ตลอดจนราคาและการเข้าถึง API นอกจากนี้ยังมีคู่มือของเราเกี่ยวกับ Grok Voice Think Fast 2.0 API และ GPT Live Transcribe API ให้ศึกษาเพิ่มเติม
Grok Voice Transcribe 2.0 คือโมเดลพูดเป็นข้อความยุคที่สองของ SpaceXAI และเป็นโมเดลถอดเสียงที่ xAI ระบุว่าดีที่สุด สร้างบนโมเดลฐานด้านเสียงที่อยู่หลัง Grok Voice ซึ่ง SpaceXAI ระบุว่าวันนี้รองรับสายสนับสนุนลูกค้าหลายหมื่นสายต่อวัน ถอดเสียงการบรรยายวิดีโอนับล้านชั่วโมง และขับเคลื่อนผู้ช่วย Grok ในรถ Tesla
สิ่งที่เปลี่ยนจากรุ่น 1.0 คือการเทรน ไม่ใช่ API SpaceXAI เทรนรุ่น 2.0 ด้วยเสียงจริงที่มีสัญญาณรบกวนและหลายภาษา บันทึกจากสภาพแวดล้อมที่หลากหลาย แล้วปรับแต่งหลังการเทรนให้เหมาะกับเงื่อนไขหน้างานที่ยากที่สุด:
ข้ออ้างหลักคือรุ่น 2.0 แม่นยำกว่ารุ่น 1.0 สองเท่าในชุดประเมินผลโลกจริงของ xAI โดยที่ราคาคงเดิมจากเจเนอเรชันแรก จะลงรายละเอียดข้ออ้างนี้ในส่วนเบนช์มาร์ก เพราะตารางจัดอันดับสาธารณะสะท้อนภาพที่พอประมาณกว่าชุดทดสอบภายใน
รายการฟีเจอร์เหมือนที่รุ่น 1.0 มี และนั่นคือประเด็น: xAI ทุ่มให้อัปเกรดด้านความแม่นยำทั้งหมด โดยไม่เปลี่ยนผิวสัมผัสของ API
สามารถส่งไฟล์บันทึกหรือ URL ไปยังเอ็นด์พอยต์แบบแบตช์ หรือสตรีมเสียงดิบผ่าน WebSocket และรับอีเวนต์ถอดความกลับมาได้ขณะผู้พูดยังพูดอยู่ ทั้งสองเส้นทางใช้โมเดลเดียวกัน ดังนั้นถอดความของบันทึกการโทรและถอดความของสายสดควรอ่านเหมือนกัน
โหมดแบตช์รับไฟล์ได้สูงสุด 500 MB ใน 12 ฟอร์แมตเสียง รวมถึง WAV, MP3, FLAC และคอนเทนเนอร์ MP4 ตลอดจน PCM ดิบและโค้ดेकโทรคมนาคม G.711 โหมดสตรีมมิงส่งถอดความบางส่วนได้ทุก ๆ ราว 500 มิลลิวินาที และติดแท็กผลลัพธ์แต่ละรายการว่าเป็นชิ้นที่ล็อกแล้วหรือเป็นประโยคที่จบแล้ว เพื่อให้ UI คำบรรยายโชว์ข้อความได้เร็วและแทนที่ในภายหลัง
ทุกคำจะมีเวลาเริ่มและสิ้นสุด และเมื่อเปิดไดอาริไซชันจะมีป้ายชื่อผู้พูดกำกับทุกคำโดยไม่คิดค่าใช้จ่ายเพิ่ม สำหรับเสียงคอลเซ็นเตอร์ที่เอเจนต์กับลูกค้าอยู่คนละแชนเนล โหมดหลายแชนเนลถอดเสียงได้อิสระสูงสุด 8 แชนเนล ซึ่งหลีกเลี่ยงความจำเป็นต้องทำไดอาริไซชันไปเลย
การตอบกลับเป็นออบเจ็กต์ JSON เดียวที่มีข้อความเต็ม ภาษาในรูปแบบโค้ด BCP-47 ระยะเวลาของเสียง และอาเรย์คำ โดยไม่ต้องเรียกขอตราประทับเวลาแยกต่างหาก
สามารถส่งคำสำคัญได้สูงสุด 100 คำต่อคำขอ แต่ละคำยาวได้ถึง 50 อักขระ เพื่อไบแอสโมเดลให้เอนเอียงไปทางชื่อผลิตภัณฑ์ ชื่อยา หรือศัพท์โดเมนที่พูดกันแต่ไม่มีในพจนานุกรม การจัดรูปแบบข้อความจะเขียนตัวเลข วันที่ สกุลเงิน หมายเลขโทรศัพท์ และอีเมลให้อยู่ในรูปแบบตัวเขียนเมื่อกำหนดพารามิเตอร์ภาษา ซึ่ง SpaceXAI รองรับ 25 ภาษา
คำฟิลเลอร์อย่าง "um" และ "uh" จะถูกลบโดยค่าเริ่มต้น ซึ่งเหมาะกับถอดความที่คนจะอ่าน และไม่เหมาะกับงานวิเคราะห์บทสนทนา จึงมีแฟลกให้เปิดกลับหากต้องการ
การตรวจจับการผลัดกันพูดอัจฉริยะช่วยให้เอเจนต์เสียงรอจบความคิด แทนที่จะขัดจังหวะทุกครั้งที่มีหยุดหายใจ สามารถตั้งเกณฑ์ความเชื่อมั่นระหว่าง 0 ถึง 1 และโมเดลจะทำเครื่องหมายว่าจบประโยคเมื่อมั่นใจถึงระดับนั้น SpaceXAI แนะนำ 0.5 สำหรับการใช้งานแบบสมดุล และ 0.7 เมื่อผู้ใช้พูดตัวเลขหรือที่อยู่
ตัวตั้งเวลาคู่กันจะบังคับให้ผลัดจบหลังความเงียบคงที่ เพื่อไม่ให้ผู้โทรที่เดินจากไปทำให้เซสชันค้าง หากไม่ใช้การผลัดอัจฉริยะ ระบบจะปิดผลัดโดยอัตโนมัติหลังความเงียบ 400 มิลลิวินาที ซึ่งพอเหมาะกับคำสั่งสั้น ๆ แต่ลำบากสำหรับผู้ที่อ่านหมายเลขโทรศัพท์
โมเดลตรวจจับภาษาอัตโนมัติและรองรับการสลับภาษาในบันทึกเดียวได้ในการรันครั้งเดียว โดยไม่ต้องมีคำใบ้ภาษา SpaceXAI ระบุว่าความแม่นยำแบบหลายภาษาคือการพัฒนาที่ใหญ่ที่สุดเหนือรุ่น 1.0 และตัวเลขในวลีสั้น ๆ ส่วนถัดไปก็สนับสนุนประเด็นนี้
มีข้อควรระวัง: พารามิเตอร์ภาษายังสำคัญต่อการจัดรูปแบบ กำหนดเมื่ออยากให้ตัวเลขและสกุลเงินออกมาในรูปแบบตัวเขียน และเว้นว่างเมื่อเสียงผสมหลายภาษาและอยากได้คำดิบมากกว่า
Grok Voice Transcribe 2.0 นำตารางจัดอันดับสตรีมมิงสาธารณะด้านความแม่นยำ และชนะรุ่น 1.0 ในทุกชุดทดสอบภายในที่ SpaceXAI รายงาน แต่ขนาดของการพัฒนาขึ้นอยู่มากกับประเภทเสียงที่พิจารณา
บนดัชนีพูดเป็นข้อความแบบสตรีมมิงของ Artificial Analysis, Grok Voice Transcribe 2.0 ทำอัตราความผิดพลาดของคำ (WER) ที่ 2.7% ซึ่งต่ำสุดในบรรดา 34 โมเดลสตรีมมิง ณ วันที่ 21 กันยายน 2026 โมเดล Muse Voice Transcribe ของ Meta ตามมาที่ 3.1%, ElevenLabs Scribe v2 Realtime อยู่ที่ 3.6% และ Grok Voice Transcribe 1.0 ตามมาที่ 3.9% คำประกาศของ SpaceXAI นับได้ 32 โมเดลบนตารางเดียวกันในวันเปิดตัว
WER วัดอะไร: WER คือสัดส่วนของคำที่โมเดลทายผิด ยิ่งต่ำยิ่งดี
ดัชนีพูดเป็นข้อความวัดอย่างไร: ดัชนีของ Artificial Analysis เฉลี่ย WER ข้าม 3 ชุดทดสอบ (AA-AgentTalk, VoxPopuli และ Earnings-22) ช่องว่างที่กว้างที่สุดของ Grok 2.0 อยู่ที่ VoxPopuli ซึ่ง WER 1.4% ต่ำกว่าครึ่งของรุ่น 1.0 ที่ 3.1%
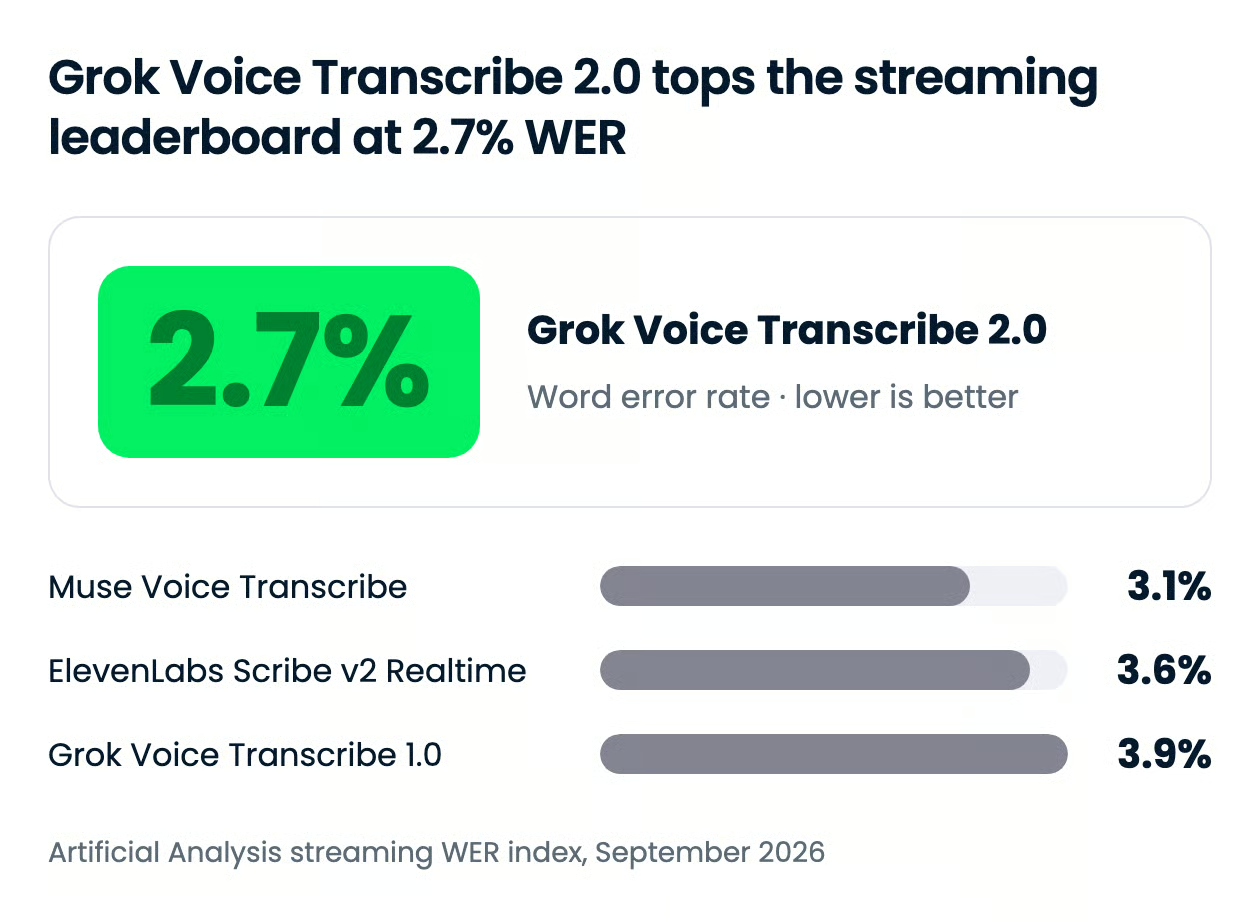
ช่องว่างกับรุ่น 1.0 บนดัชนีนี้คือ 31% ไม่ใช่ 2 เท่าตามที่ประกาศชู จุดอ้างขนาดใหญ่กว่านั้นมาจากชุดผลิตจริงของ SpaceXAI ซึ่งจะกล่าวต่อไป ตารางเดียวกันยังบันทึกเวลาที่แต่ละโมเดลใช้ในการยืนยันถอดความสุดท้าย ซึ่งภาพจะกลับด้าน
| โมเดล | ดัชนี WER (ถอดความสุดท้าย) | เวลาไปยังถอดความสุดท้าย |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2.7% | 0.49 วินาที |
| Muse Voice Transcribe (Meta) | 3.1% | 0.16 วินาที |
| ElevenLabs Scribe v2 Realtime | 3.6% | 0.14 วินาที |
| Grok Voice Transcribe 1.0 | 3.9% | 0.37 วินาที |
| Deepgram Flux | 7.4% | 0.02 วินาที |
เวลาแฝงคือราคาที่ต้องจ่าย Grok 2.0 ใช้เวลา 0.49 วินาทีในการคืนถอดความสุดท้าย เทียบกับ 0.37 วินาทีของรุ่น 1.0 และ 0.14 วินาทีของ Scribe v2 Realtime สำหรับคำบรรยายแทบไม่เห็นความต่าง แต่สำหรับเอเจนต์เสียงที่ต้องตอบทุกผลัด ความต่างหลักเสี้ยววินาทีจะทบกัน
SpaceXAI วัด WER บนชุดภายใน 4 ชุดที่มาจากทราฟฟิกผลิตจริง:
Grok Voice Transcribe 2.0 ดีขึ้นจากรุ่น 1.0 ในทั้งสี่ชุด และบนเสียงโทรคมนาคม SpaceXAI ระบุว่านำหน้าทุกโมเดลที่ทดสอบ
ตัวเลขเดียวที่ SpaceXAI เผยจากชุดเหล่านี้คือผลวลีสั้น: WER ลดจาก 20.6% ในรุ่น 1.0 เหลือ 6.8% ในรุ่น 2.0 คำสั่งสั้น ๆ ในรถให้บริบทน้อยมากต่อการระบุภาษา ซึ่งเป็นจุดที่รุ่น 1.0 ลำบาก และการดีขึ้น 3 เท่าตรงนี้คือหลักฐานที่เข้มแข็งที่สุดรองรับคำกล่าวว่า "แม่นยำขึ้นสองเท่า"
กราฟภายในที่เหลือ รวมถึงการเทียบหลายภาษากับ ElevenLabs Scribe v2 และ Deepgram Nova-3 แสดงเป็นแท่งโดยไม่มีตัวเลขกำกับ จึงควรมอง "นำทุกโมเดลที่เราทดสอบ" บนโทรคมนาคมว่าเป็นคำกล่าวของผู้ขาย จนกว่าจะมีผู้ทำซ้ำได้บนเสียงโทรของตนเอง
Grok Voice Transcribe 2.0 คิด $0.10 ต่อชั่วโมงเสียงสำหรับถอดเสียงแบบแบตช์ และ $0.20 ต่อชั่วโมงสำหรับสตรีมมิง เหมือนกับ Grok Voice Transcribe 1.0 การไดอาริไซชัน ตราประทับเวลาระดับคำ และไบแอสคำสำคัญถูกรวมไว้ในอัตรานี้โดยไม่คิดเป็นส่วนเสริม
| โหมด | ราคา | รวม |
|---|---|---|
| แบตช์ (ไฟล์หรือ URL) | $0.10 ต่อชั่วโมงเสียง | ไดอาริไซชัน ตราประทับเวลา คำสำคัญ การจัดรูปแบบ |
| สตรีมมิง (WebSocket) | $0.20 ต่อชั่วโมงเสียง | ไดอาริไซชัน ตราประทับเวลา คำสำคัญ การจัดรูปแบบ การผลัดอัจฉริยะ |
อัตรานี้อยู่ในกลุ่มที่ต่ำที่สุดบนตารางสตรีมมิง Artificial Analysis ระบุ Grok 2.0 ที่ $3.33 ต่อ 1,000 นาที เทียบกับ $3.00 สำหรับ Muse Voice Transcribe ของ Meta และ $6.50 สำหรับทั้ง ElevenLabs Scribe v2 Realtime และ Deepgram Flux ในบรรดา 4 โมเดลที่แม่นยำที่สุดบนดัชนี มีเพียง Muse ที่ถูกกว่า และ Muse ได้คะแนนความแม่นยำต่ำกว่า
โมเดลเปิดให้ใช้งานทั่วไปผ่าน SpaceXAI API โดยในคำประกาศและเอกสารไม่ได้ระบุว่ามีวิดต์ลิสต์หรือจำกัดภูมิภาค ไม่มีแพ็กเกจผู้บริโภคให้เลือก เพราะนี่คือผลิตภัณฑ์ API และทั้งคำประกาศและเอกสารไม่ได้กล่าวถึงระดับใช้ฟรีสำหรับพูดเป็นข้อความ
ค่าดีฟอลต์กำลังอยู่ในช่วงเปลี่ยนผ่าน SpaceXAI ระบุว่ารุ่น 2.0 จะกลายเป็นค่าเริ่มต้นใน Speech-to-Text API ในเร็ว ๆ นี้ และรุ่น 1.0 จะยกเลิกใช้งานในอีกไม่กี่สัปดาห์ ขณะนี้ควรกำหนดรหัสโมเดลโดยชัดเจน
รหัสโมเดลคือ grok-voice-transcribe-2.0 ส่งเป็นฟิลด์ฟอร์มบนเอ็นด์พอยต์ REST หรือเป็นพารามิเตอร์คิวรีบนเอ็นด์พอยต์ WebSocket หากต้องการค้างอยู่บนรุ่นเก่าระหว่างช่วงยกเลิก ให้ระบุ grok-voice-transcribe-1.0
ให้บริการบนสองพื้นผิว: SpaceXAI API โดยแบตช์ที่ https://api.x.ai/v1/stt และสตรีมมิงที่ wss://api.x.ai/v1/stt และคอนโซลของ SpaceXAI ซึ่งมีสนามทดลองพูดเป็นข้อความแบบสด ขณะวันที่ 21 กันยายน 2026 ยังไม่อยู่ในแคตตาล็อกของ OpenRouter
นี่คือคำเรียกแบบแบตช์ที่เล็กที่สุดซึ่งคืนถอดความพร้อมไดอาริไซชัน:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
สำหรับเอเจนต์เสียงที่สร้างบน WebSocket voice API ของ xAI ดู บทเรียน Grok Voice Think Fast 2.0 API ของเรา ซึ่งครอบคลุมโมเดลพูดสู่เสียง และ คู่มือ Grok Voice Agent API หากเรียกใช้โมเดลข้อความของ Grok จากโค้ดเบสเดียวกัน บทเรียน Grok 4.6 API ของเราครอบคลุมการจัดการคีย์และการเรียกเครื่องมือ
Grok Voice Transcribe 2.0 เป็นทางเลือกที่ถูกที่สุดในการได้ถอดความสตรีมมิงที่แม่นยำที่สุดบนตารางสาธารณะ ซึ่งเป็นส่วนผสมที่หาได้ยาก xAI ส่งสัญญาณชัดว่าเทคโนโลยีเสียงของตนตั้งใจแข่งกับ OpenAI, Google และ ElevenLabs ไม่ใช่แค่ในด้านโมเดลข้อความ
จะแนะนำให้เปลี่ยนหากเสียงเป็นคุณภาพโทรศัพท์ หลายภาษา หรือมีตัวเลขที่พูดเยอะ ๆ ซึ่งเป็นจุดที่รุ่น 2.0 ทิ้งห่างรุ่น 1.0 และคู่แข่งส่วนใหญ่ แต่จะชะลอการใช้กับเอเจนต์เสียงที่ไวต่อเวลา จนกว่า xAI จะลดช่องว่างเวลาไปยังถอดความสุดท้ายให้ใกล้ Scribe v2
หากอยากสร้างไปป์ไลน์ถอดเสียงเอง แนะนำคอร์ส Spoken Language Processing in Python ของเรา ซึ่งพาจากไฟล์เสียงดิบไปจนถึงการถอดความและจัดหมวดหมู่สายโทรศัพท์
เรียนรู้ AI กับ DataCamp!
Courses
Tracks
Courses