courses
Python으로 배우는 음성 언어 처리
4
9.3K
스트리밍 음성 인식 시장은 이제 치열한 순위 경쟁 구도가 되었습니다. OpenAI, Google, ElevenLabs, Meta, Deepgram 등 다양한 기업이 실시간 전사 모델을 출시하고 있고, Artificial Analysis는 이들 모델 수십 개를 단어 오류율(WER) 지수 하나로 비교합니다. SpaceXAI의 최신 모델인 Grok Voice Transcribe 2.0이 현재 그 지수에서 1위를 차지했습니다.
이 글에서는 Grok Voice Transcribe 2.0의 모든 새로운 점을 다룹니다. 새 기능을 살펴보고, 공개 및 내부 벤치마크를 비교하며, 요금과 API 액세스 방법까지 정리합니다. 또한 Grok Voice Think Fast 2.0 API와 GPT Live Transcribe API 가이드도 참고하세요.
Grok Voice Transcribe 2.0은 SpaceXAI의 2세대 음성 인식 모델로, xAI가 현 시점에서 최고의 전사 모델이라고 부르는 제품입니다. Grok Voice의 오디오 기반 모델을 토대로 하며, SpaceXAI에 따르면 이미 하루 수만 건의 고객 지원 전화를 처리하고, 수백만 시간 분량의 비디오 내레이션을 전사하며, 테슬라 차량 내 Grok 어시스턴트를 구동하고 있습니다.
1.0과 달라진 점은 API가 아니라 학습입니다. SpaceXAI는 2.0을 다양한 환경에서 녹음된 실시간, 소음 많은, 다국어 오디오로 학습하고, 실제 환경에서 가장 어려운 조건을 겨냥해 사후 학습으로 다듬었습니다:
핵심 주장은 2.0이 xAI의 실제 평가 전반에서 1.0 대비 정확도가 2배이며, 가격은 1세대와 동일하다는 것입니다. 다만 공개 리더보드가 내부 세트보다 더 온건한 그림을 보여주므로, 벤치마크 섹션에서 이 주장에 대해 더 자세히 살펴보겠습니다.
기능 목록은 1.0과 동일합니다. 의도한 바대로, xAI는 업그레이드의 초점을 정확도에만 두고 API 표면은 그대로 유지했습니다.
배치 엔드포인트에 녹음 파일이나 URL을 보낼 수 있고, WebSocket으로 원시 오디오를 스트리밍하면 화자가 말하는 동안 전사 이벤트를 받을 수 있습니다. 두 경로 모두 동일한 모델을 사용하므로, 통화 녹취 전사와 실시간 통화 전사의 결과는 동일하게 읽혀야 합니다.
배치는 WAV, MP3, FLAC, MP4 컨테이너는 물론 원시 PCM과 G.711 전화 코덱 등 12개 오디오 형식으로 최대 500MB 파일을 받습니다. 스트리밍은 약 500ms마다 부분 전사를 출력할 수 있으며, 각 결과를 잠금 청크 또는 완료 발화로 태그해 자막 UI가 텍스트를 먼저 보여주고 이후 교체할 수 있게 합니다.
모든 단어에는 시작 및 종료 시간이 함께 반환되며, 화자 분리(diarization)를 켜면 추가 비용 없이 각 단어에 화자 레이블이 붙습니다. 콜센터 오디오에서 상담원과 고객이 각기 다른 채널에 있는 경우, 멀티채널 모드는 최대 8개 채널을 독립적으로 전사하여 화자 분리를 건너뛸 수 있습니다.
응답은 전체 텍스트, BCP-47 코드로 표시된 감지 언어, 오디오 길이, 단어 배열을 포함한 하나의 JSON 객체입니다. 타임스탬프만 별도로 호출할 필요가 없습니다.
요청당 최대 100개의 핵심 용어(각 50자 이내)를 전달해 제품명, 의약품명 등 사전에 없는 분야별 표현을 모델이 더 잘 인식하도록 바이어싱할 수 있습니다. 텍스트 서식 지정은 언어 파라미터를 설정하면 숫자, 날짜, 통화, 전화번호, 이메일 주소를 문어체로 표기하며, SpaceXAI는 25개 언어를 지원합니다.
"um", "uh" 같은 군더더기 말은 기본적으로 제거됩니다. 사람이 읽는 전사에는 적합하지만 대화 분석에는 부적합할 수 있으므로, 필요하면 플래그로 다시 포함할 수 있습니다.
스마트 턴 감지는 음성 에이전트가 매 정적마다 끼어들지 않고 생각의 끝을 기다리도록 합니다. 0~1 사이의 신뢰도 임계를 설정하면, 모델은 화자가 끝냈다고 그만큼 확신할 때만 발화를 완료로 표시합니다. SpaceXAI는 일반 용도로 0.5, 숫자나 주소를 받아 적을 때는 0.7을 권장합니다.
동반 타임아웃은 정해진 무음 시간이 지나면 턴을 강제 종료시켜, 발화자가 자리를 비워도 세션이 멈추지 않게 합니다. 스마트 턴이 없으면 기본 엔드포인트는 400ms 무음 후 작동하는데, 짧은 명령에는 무난하지만 전화번호를 읽어주는 상황에는 불편합니다.
모델은 언어를 자동 감지하고, 하나의 녹음 내 언어 전환도 힌트 없이 한 번에 처리합니다. SpaceXAI는 다국어 정확도가 1.0 대비 가장 큰 개선이라고 하며, 다음 섹션의 짧은 구문 결과가 이를 뒷받침합니다.
단, 서식 지정에는 언어 파라미터가 여전히 중요합니다. 숫자와 통화를 문어체로 표기하려면 설정하고, 오디오에 여러 언어가 섞여 있고 원문 그대로를 원한다면 설정하지 마세요.
Grok Voice Transcribe 2.0은 공개 스트리밍 리더보드에서 정확도 1위를 기록했으며, SpaceXAI가 보고한 모든 내부 세트에서도 1.0을 앞섰습니다. 다만 개선 폭은 오디오 유형에 크게 좌우됩니다.
Artificial Analysis의 스트리밍 음성 인식 지수에서 Grok Voice Transcribe 2.0의 단어 오류율(WER)은 2.7%로, 2026년 9월 21일 기준 등재된 34개 스트리밍 모델 중 가장 낮습니다. Meta의 Muse Voice Transcribe가 3.1%로 뒤를 잇고, ElevenLabs Scribe v2 Realtime은 3.6%, Grok Voice Transcribe 1.0은 3.9%입니다. SpaceXAI의 발표 당시에는 같은 리더보드에 32개 모델이 집계되었습니다.
WER의 의미: WER은 모델이 틀린 단어의 비율로, 낮을수록 좋습니다.
음성 인식 지수가 측정하는 것: Artificial Analysis의 지수는 3개 테스트 세트(AA-AgentTalk, VoxPopuli, Earnings-22)의 WER 평균입니다. Grok 2.0이 가장 크게 앞선 것은 VoxPopuli로, WER 1.4%로 1.0의 3.1%의 절반 이하입니다.
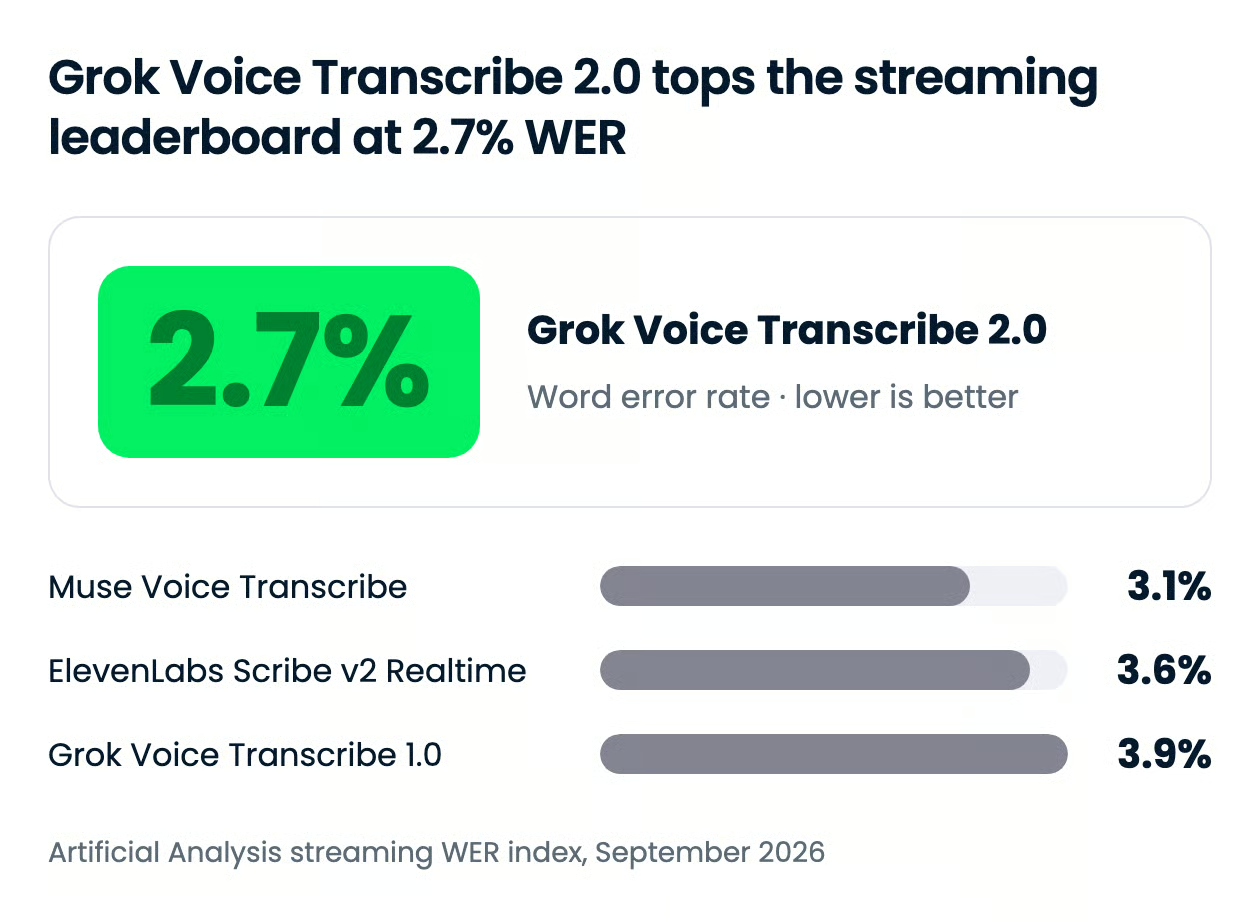
이 지수에서 1.0과의 격차는 31%로, 발표에서 강조한 ‘2배’와는 다릅니다. 더 큰 수치는 SpaceXAI의 자체 운영 세트에서 나온 것으로, 다음에서 다룹니다. 같은 리더보드는 최종 전사를 확정하는 데 걸리는 시간도 기록하는데, 여기서는 결과가 반전됩니다.
| Model | WER index (final transcript) | Time to final transcript |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2.7% | 0.49 s |
| Muse Voice Transcribe (Meta) | 3.1% | 0.16 s |
| ElevenLabs Scribe v2 Realtime | 3.6% | 0.14 s |
| Grok Voice Transcribe 1.0 | 3.9% | 0.37 s |
| Deepgram Flux | 7.4% | 0.02 s |
대가는 지연 시간입니다. Grok 2.0은 최종 전사를 반환하는 데 0.49초가 걸리며, 1.0은 0.37초, Scribe v2 Realtime은 0.14초입니다. 자막에는 티 나지 않지만, 턴마다 응답해야 하는 음성 에이전트에는 0.1~0.2초가 누적됩니다.
SpaceXAI는 운영 트래픽에서 추출한 네 가지 내부 세트에서 WER을 측정합니다:
Grok Voice Transcribe 2.0은 네 세트 모두에서 1.0을 개선했으며, 전화 오디오에서는 테스트한 모든 모델 중에서 앞선다고 SpaceXAI는 말합니다.
이 세트에서 SpaceXAI가 공개한 유일한 수치는 짧은 구문 결과입니다. 1.0의 WER 20.6%에서 2.0은 6.8%로 떨어졌습니다. 차량 내 짧은 명령은 언어 식별에 쓸 문맥이 거의 없어 1.0이 특히 어려워하던 영역이었고, 3배 개선은 ‘정확도 2배’ 주장에 힘을 실어줍니다.
나머지 내부 차트(예: ElevenLabs Scribe v2 및 Deepgram Nova-3와의 다국어 비교)는 수치 라벨 없이 막대로만 제공됩니다. 전화 오디오에서의 “테스트한 모든 모델 중 선도” 주장은, 누군가 자체 통화 오디오로 재현하기 전까지는 공급업체의 주장으로 보는 편이 타당해 보입니다.
Grok Voice Transcribe 2.0의 요금은 배치 전사가 오디오 1시간당 $0.10, 스트리밍이 1시간당 $0.20로, Grok Voice Transcribe 1.0과 동일합니다. 화자 분리, 단어 단위 타임스탬프, 키워드 바이어싱은 추가 과금 없이 포함됩니다.
| Mode | Price | Included |
|---|---|---|
| Batch (file or URL) | $0.10 per hour of audio | Diarization, timestamps, key terms, formatting |
| Streaming (WebSocket) | $0.20 per hour of audio | Diarization, timestamps, key terms, formatting, smart turn |
이 요금은 스트리밍 리더보드에서도 낮은 축에 속합니다. Artificial Analysis는 Grok 2.0을 1,000분당 $3.33으로, Meta의 Muse Voice Transcribe는 $3.00, ElevenLabs Scribe v2 Realtime과 Deepgram Flux는 각각 $6.50로 기재합니다. 지수에서 가장 정확한 네 모델 중에서는 Muse만 더 저렴하며, Muse는 정확도가 더 낮습니다.
모델은 SpaceXAI API에서 일반 제공 중이며, 발표나 문서에는 대기자 명단이나 지역 제한이 언급되지 않았습니다. 이는 API 제품이므로 소비자 요금제를 선택할 필요는 없고, 음성 인식에 대한 무료 티어도 문서에 언급되어 있지 않습니다.
기본값은 전환 중입니다. SpaceXAI는 2.0이 곧 Speech-to-Text API의 기본이 되고, 1.0은 몇 주 내 사용 중단 예정이라고 밝혔습니다. 그때까지는 모델 ID를 명시적으로 설정해야 합니다.
모델 ID는 grok-voice-transcribe-2.0이며, REST 엔드포인트에서는 폼 필드로, WebSocket 엔드포인트에서는 쿼리 파라미터로 전달합니다. 사용 중단 기간 동안 기존 모델을 고정하려면 grok-voice-transcribe-1.0을 지정하세요.
두 가지 방식으로 사용할 수 있습니다. SpaceXAI API에서는 배치가 https://api.x.ai/v1/stt, 스트리밍이 wss://api.x.ai/v1/stt이며, SpaceXAI 콘솔에는 실시간 음성 인식 플레이그라운드가 있습니다. 2026년 9월 21일 기준 OpenRouter 카탈로그에는 없습니다.
다음은 화자 분리 전사를 반환하는 최소 배치 호출 예시입니다:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
xAI의 WebSocket 음성 API로 구축하는 음성 에이전트는, 음성-음성 모델을 다루는 Grok Voice Think Fast 2.0 API 튜토리얼과 Grok Voice Agent API 가이드를 참고하세요. 같은 코드베이스에서 Grok의 텍스트 모델도 호출한다면, Grok 4.6 API 튜토리얼에서 키와 도구 호출을 확인할 수 있습니다.
Grok Voice Transcribe 2.0은 공개 리더보드에서 가장 정확한 스트리밍 전사를 가장 저렴한 비용으로 제공하며, 이 조합은 드뭅니다. xAI는 음성 스택으로 OpenAI, Google, ElevenLabs와 정면 경쟁하겠다는 메시지를 분명히 하고 있습니다. 텍스트 모델만이 아닙니다.
제 오디오가 전화 품질이거나, 다국어이거나, 구두 숫자가 많다면 2.0으로 전환하겠습니다. 이는 2.0이 1.0 및 다수 경쟁사보다 앞서는 영역입니다. 반면, 지연 시간에 민감한 음성 에이전트라면, 최종 전사 시간에서 Scribe v2와의 격차가 줄어들 때까지는 보류하겠습니다.
전사 파이프라인을 직접 구축하고 싶다면, 원시 오디오 파일부터 통화 전사·분류까지 다루는 Spoken Language Processing in Python 과정을 추천합니다.
DataCamp과 함께 AI를 배워보세요!
courses
tracks
courses