Curso
Processamento de Linguagem Falada em Python
4 h
9.3K
O streaming de fala-para-texto virou um ranking disputado. OpenAI, Google, ElevenLabs, Meta e Deepgram oferecem modelos de transcrição em tempo real, e a Artificial Analysis agora avalia dezenas deles em um índice único de taxa de erro de palavras. O modelo mais recente da SpaceXAI, Grok Voice Transcribe 2.0, assumiu o topo desse índice.
Neste artigo, vou cobrir tudo o que há de novo no Grok Voice Transcribe 2.0: os recursos, os benchmarks públicos e internos, além de preços e acesso via API. Você também pode conferir nossos guias da API Grok Voice Think Fast 2.0 e da GPT Live Transcribe API.
Grok Voice Transcribe 2.0 é o modelo de segunda geração de fala-para-texto da SpaceXAI, que a xAI agora chama de seu melhor modelo de transcrição. Ele é construído sobre o modelo de base de áudio por trás do Grok Voice, que, segundo a SpaceXAI, já atende dezenas de milhares de ligações de suporte por dia, transcreve milhões de horas de narração de vídeo e alimenta o assistente Grok nos veículos da Tesla.
O que mudou em relação ao 1.0 foi o treinamento, não a API. A SpaceXAI treinou o 2.0 com áudio ao vivo, ruidoso e multilíngue, gravado em ambientes variados, e depois fez um pós-treinamento voltado para as condições reais mais difíceis:
A grande promessa é que o 2.0 é duas vezes mais preciso que o 1.0 nas avaliações de mundo real da xAI, com preços inalterados em relação à primeira geração. Vou analisar essa afirmação na seção de benchmarks, porque o ranking público conta uma história mais modesta do que os conjuntos internos.
A lista de recursos é a mesma que veio com o 1.0 — e esse é o ponto: a xAI colocou todo o upgrade na precisão e manteve a API intacta.
Você pode enviar um arquivo gravado ou uma URL para o endpoint batch, ou transmitir áudio bruto via WebSocket e receber eventos de transcrição enquanto o falante ainda está falando. Ambos os caminhos rodam o mesmo modelo, então a transcrição de uma gravação de ligação e a transcrição da chamada ao vivo devem ficar iguais.
O modo batch aceita arquivos de até 500 MB em 12 formatos de áudio, incluindo WAV, MP3, FLAC e contêineres MP4, além de PCM bruto e os codecs de telefonia G.711. O streaming pode emitir transcrições parciais a cada ~500 ms e marca cada resultado como um trecho bloqueado ou um enunciado finalizado, para que uma interface de legendas mostre o texto cedo e substitua depois.
Cada palavra volta com horário de início e fim, e ativar a diarização adiciona um rótulo de falante a cada palavra sem custo extra. Para áudio de call center com o agente em um canal e o cliente em outro, o modo multicanal transcreve até 8 canais de forma independente, o que dispensa a diarização.
A resposta é um objeto JSON com o texto completo, o idioma detectado como um código BCP-47, a duração do áudio e o array de palavras. Não há chamada separada para timestamps.
Você pode enviar até 100 termos-chave por requisição, cada um com até 50 caracteres, para direcionar o modelo a nomes de produtos, medicamentos ou qualquer termo do seu domínio que apareça no áudio e não conste no dicionário. A formatação de texto escreve números, datas, moedas, telefones e e-mails na forma escrita quando você define o parâmetro de idioma, que a SpaceXAI oferece para 25 idiomas.
Palavras de preenchimento como "ã" e "é" são removidas por padrão. Isso é ideal para transcrições voltadas à leitura por pessoas, mas ruim para analytics de conversação, então a flag existe se você quiser mantê-las.
A detecção inteligente de turnos permite que um agente de voz espere o fim de uma ideia em vez de interromper a cada pausa. Você define um limiar de confiança entre 0 e 1, e o modelo só marca o enunciado como finalizado quando atinge essa confiança de que o falante terminou; a SpaceXAI sugere 0,5 para uso balanceado e 0,7 quando as pessoas ditam números ou endereços.
Um timeout complementar força o fim do turno após um período fixo de silêncio, evitando que um usuário que se afasta deixe a sessão travada. Sem o turno inteligente, o endpoint padrão dispara após 400 ms de silêncio — ok para comandos curtos e sofrido para quem está ditando um número de telefone.
O modelo detecta o idioma automaticamente e lida com trocas de idioma dentro de uma única gravação em uma passada, sem dica de idioma. A SpaceXAI aponta a precisão multilíngue como a maior melhoria em relação ao 1.0, e os números de frases curtas na próxima seção confirmam isso.
Um porém: o parâmetro de idioma ainda importa para formatação. Defina-o quando quiser números e moedas na forma escrita e deixe-o desligado quando o áudio misturar idiomas e você preferir as palavras cruas.
O Grok Voice Transcribe 2.0 lidera o ranking público de streaming em precisão e supera o 1.0 em todos os conjuntos internos relatados pela SpaceXAI, mas o tamanho do ganho depende bastante do tipo de áudio.
No índice de fala-para-texto em streaming da Artificial Analysis, o Grok Voice Transcribe 2.0 marca uma taxa de erro de palavras (WER) de 2,7%, a mais baixa entre os 34 modelos de streaming listados em 21 de setembro de 2026. O Muse Voice Transcribe da Meta vem a seguir com 3,1%, o ElevenLabs Scribe v2 Realtime fica em 3,6% e o Grok Voice Transcribe 1.0 aparece com 3,9%. O anúncio da SpaceXAI contou 32 modelos no mesmo ranking no lançamento.
O que o WER mede: WER é a fração de palavras que o modelo erra — quanto menor, melhor.
O que o índice mede: o índice da Artificial Analysis faz a média do WER em 3 conjuntos de teste (AA-AgentTalk, VoxPopuli e Earnings-22). A maior vantagem do Grok 2.0 é no VoxPopuli, onde seu WER de 1,4% é menos da metade dos 3,1% do 1.0.
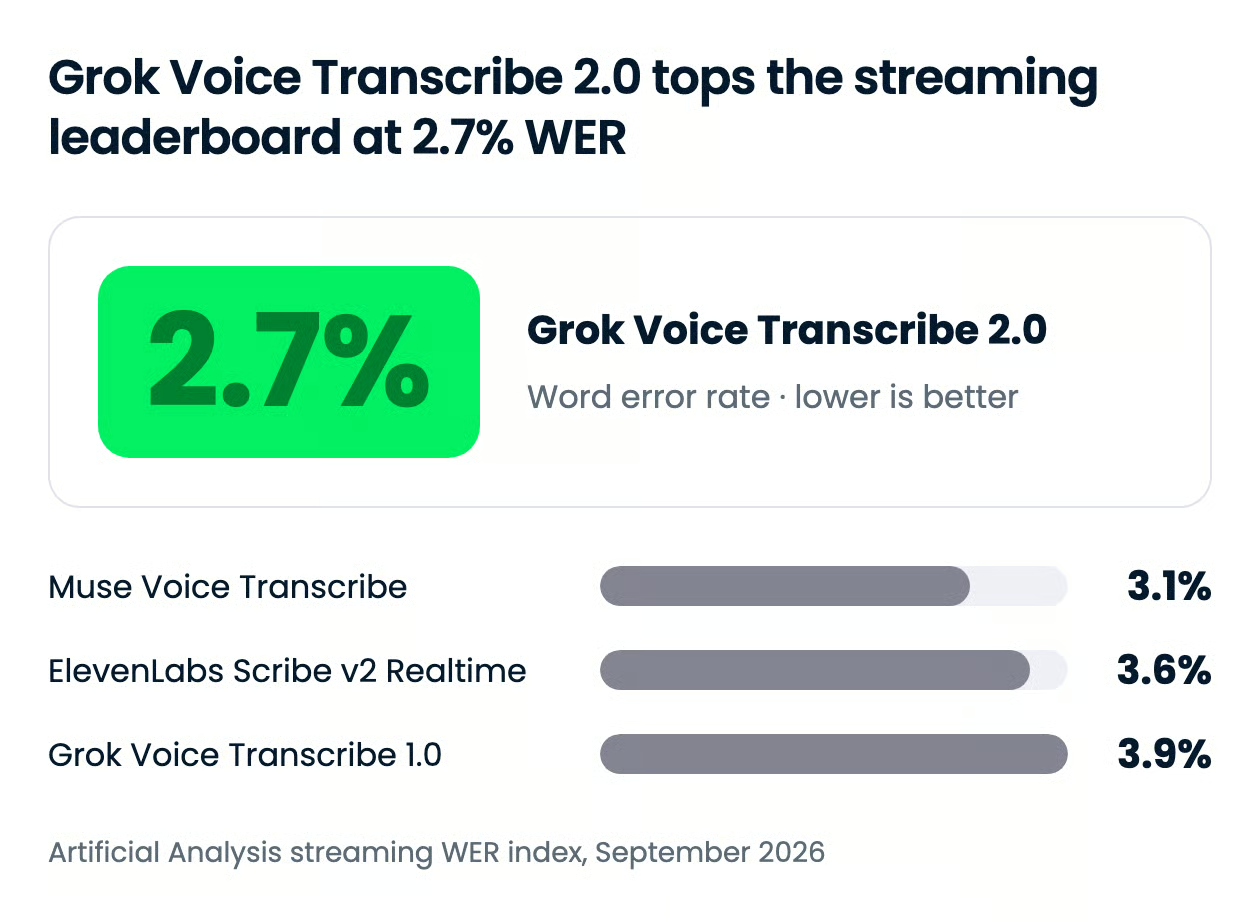
A diferença para o 1.0 nesse índice é de 31%, não o 2x destacado no anúncio. Essa afirmação maior vem dos conjuntos de produção da própria SpaceXAI, que cubro a seguir. O mesmo ranking também registra o tempo que cada modelo leva para consolidar a transcrição final — e aí o quadro se inverte.
| Modelo | Índice de WER (transcrição final) | Tempo até a transcrição final |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2,7% | 0,49 s |
| Muse Voice Transcribe (Meta) | 3,1% | 0,16 s |
| ElevenLabs Scribe v2 Realtime | 3,6% | 0,14 s |
| Grok Voice Transcribe 1.0 | 3,9% | 0,37 s |
| Deepgram Flux | 7,4% | 0,02 s |
A latência é o custo. O Grok 2.0 leva 0,49 s para devolver a transcrição final, contra 0,37 s do 1.0 e 0,14 s do Scribe v2 Realtime. Para legendas isso é imperceptível. Para um agente de voz que precisa responder a cada turno, esses décimos de segundo se somam.
A SpaceXAI mede o WER em quatro conjuntos internos extraídos de tráfego de produção:
O Grok Voice Transcribe 2.0 melhora em relação ao 1.0 nos quatro, e em telefonia a SpaceXAI diz liderar todos os modelos que testou.
O único número publicado desses conjuntos é o de frases curtas: o WER cai de 20,6% no 1.0 para 6,8% no 2.0. Comandos curtos no carro quase não dão contexto para identificar o idioma — exatamente onde o 1.0 sofria — e um ganho de 3x ali é a evidência mais forte por trás do "duas vezes mais preciso".
O restante dos gráficos internos, incluindo a comparação multilíngue com o ElevenLabs Scribe v2 e o Deepgram Nova-3, vem em barras sem valores rotulados. Eu trataria "lidera todos os modelos que testamos" em telefonia como uma afirmação do fornecedor até que alguém reproduza com seu próprio áudio de chamadas.
O Grok Voice Transcribe 2.0 custa US$ 0,10 por hora de áudio no modo batch e US$ 0,20 por hora no streaming, idêntico ao Grok Voice Transcribe 1.0. Diarização, timestamps por palavra e viés para termos-chave estão incluídos nessas tarifas, sem cobrança adicional.
| Modo | Preço | Incluso |
|---|---|---|
| Batch (arquivo ou URL) | US$ 0,10 por hora de áudio | Diarização, timestamps, termos-chave, formatação |
| Streaming (WebSocket) | US$ 0,20 por hora de áudio | Diarização, timestamps, termos-chave, formatação, turno inteligente |
Essas tarifas estão entre as mais baixas do ranking de streaming. A Artificial Analysis lista o Grok 2.0 a US$ 3,33 por 1.000 minutos, ao lado de US$ 3,00 do Muse Voice Transcribe da Meta e US$ 6,50 do ElevenLabs Scribe v2 Realtime e do Deepgram Flux. Entre os quatro modelos mais precisos do índice, só o Muse é mais barato — e ele marca menos em precisão.
O modelo está geralmente disponível na API da SpaceXAI, sem fila de espera ou restrição regional mencionadas no anúncio ou na documentação. Não há plano para consumidor porque este é um produto de API, e nem o anúncio nem a documentação mencionam camada gratuita para fala-para-texto.
O padrão está em transição. A SpaceXAI diz que o 2.0 em breve será o padrão na Speech-to-Text API e que o 1.0 será descontinuado nas próximas semanas. Até lá, defina o ID do modelo explicitamente.
O ID do modelo é grok-voice-transcribe-2.0, passado como campo de formulário no endpoint REST ou como parâmetro de query no endpoint WebSocket. Para permanecer no modelo antigo durante a janela de descontinuação, fixe grok-voice-transcribe-1.0.
Ele roda em duas superfícies: a API da SpaceXAI, com batch em https://api.x.ai/v1/stt e streaming em wss://api.x.ai/v1/stt, e o console da SpaceXAI, que tem um playground de fala-para-texto ao vivo. Ele não está no catálogo do OpenRouter em 21 de setembro de 2026.
Aqui vai a menor chamada batch que retorna uma transcrição com diarização:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
Para agentes de voz construídos nas APIs de voz via WebSocket da xAI, veja nosso tutorial da API Grok Voice Think Fast 2.0, que cobre o modelo de fala-para-fala, e nosso guia da API Grok Voice Agent. Se você chama os modelos de texto do Grok no mesmo codebase, nosso tutorial da API Grok 4.6 cobre chaves e tool calling.
O Grok Voice Transcribe 2.0 é o jeito mais barato de obter a transcrição em streaming mais precisa do ranking público — uma combinação rara. A xAI deixa claro que seu stack de voz quer competir com OpenAI, Google e ElevenLabs, não apenas com modelos de texto.
Eu migraria se meu áudio for qualidade de telefone, multilíngue ou cheio de números ditados — onde o 2.0 se destaca em relação ao 1.0 e à maioria dos rivais. Eu aguardaria em um agente de voz sensível à latência até a xAI reduzir a diferença para o Scribe v2 no tempo até a transcrição final.
Se você quer construir pipelines de transcrição por conta própria, recomendo nosso curso Spoken Language Processing in Python, que vai de arquivos de áudio brutos até chamadas telefônicas transcritas e classificadas.
Aprenda IA com a DataCamp!
Curso
Programa
Curso
blog
Richie Cotton
7 min
blog
Richie Cotton
blog
Javier Canales Luna
14 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Abid Ali Awan
Tutorial
Moez Ali
11 min