course
Przetwarzanie mowy w Pythonie
4 godz.
9.3K
Strumieniowe rozpoznawanie mowy na tekst zamieniło się w tłoczny ranking. OpenAI, Google, ElevenLabs, Meta i Deepgram oferują modele transkrypcji w czasie rzeczywistym, a Artificial Analysis zestawia dziś dziesiątki z nich w jednym indeksie błędu słowa. Najnowszy model SpaceXAI, Grok Voice Transcribe 2.0, wskoczył właśnie na pierwsze miejsce tego indeksu.
W tym artykule omawiam wszystko, co nowe w Grok Voice Transcribe 2.0: nowe funkcje, publiczne i wewnętrzne benchmarki oraz ceny i dostęp przez API. Zobacz też nasze poradniki do Grok Voice Think Fast 2.0 API i GPT Live Transcribe API.
Grok Voice Transcribe 2.0 to druga generacja modelu mowa–tekst od SpaceXAI i model, który xAI określa obecnie jako najlepszy do transkrypcji. Bazuje na fundamencie audio stojącym za Grok Voice, który według SpaceXAI już obsługuje dziesiątki tysięcy połączeń wsparcia dziennie, transkrybuje miliony godzin narracji wideo i napędza asystenta Grok w pojazdach Tesli.
W porównaniu z 1.0 zmieniło się szkolenie, a nie API. SpaceXAI uczyło 2.0 na żywym, zaszumionym, wielojęzycznym audio nagranym w różnych warunkach, a następnie dopracowało je post-treningiem ukierunkowanym na najtrudniejsze scenariusze z życia:
Kluczowa teza: 2.0 jest dwukrotnie dokładniejszy niż 1.0 w ocenach xAI na danych z życia, przy niezmienionej cenie względem pierwszej generacji. Do tej tezy wracam w sekcji benchmarków, bo publiczny leaderboard rysuje bardziej umiarkowany obraz niż zestawy wewnętrzne.
Lista funkcji jest taka sama jak w 1.0 — i o to chodzi: xAI całą aktualizację włożyło w dokładność, zostawiając powierzchnię API bez zmian.
Możesz wysłać nagrany plik lub URL do endpointu wsadowego albo strumieniować surowe audio przez WebSocket i dostawać zdarzenia z transkrypcją, gdy mówca wciąż mówi. Obie ścieżki używają tego samego modelu, więc transkrypcja nagrania rozmowy i transkrypcja na żywo powinny wyglądać tak samo.
Tryb wsadowy przyjmuje pliki do 500 MB w 12 formatach audio, m.in. WAV, MP3, FLAC i kontenery MP4, plus surowe PCM i telekomunikacyjne kodeki G.711. Strumieniowanie może emitować częściowe transkrypcje co ~500 ms i oznacza każdy wynik jako zablokowany fragment lub zakończoną wypowiedź, dzięki czemu UI napisów może pokazywać tekst wcześnie i później go podmienić.
Każde słowo zawiera czas początku i końca, a włączenie diarizacji dodaje do każdego słowa etykietę mówcy bez dodatkowych kosztów. Dla audio z call center, gdzie agent i klient są na osobnych kanałach, tryb wielokanałowy transkrybuje do 8 kanałów niezależnie, całkowicie omijając diarizację.
Odpowiedź to jeden obiekt JSON z pełnym tekstem, wykrytym językiem w kodzie BCP-47, długością audio oraz tablicą słów. Nie trzeba wykonywać osobnego wywołania po znaczniki czasu.
Możesz przekazać do 100 haseł na żądanie, każde do 50 znaków, aby zbiastować model w stronę nazw produktów, leków lub dowolnych terminów twojej domeny, które są wypowiadane, a nie ma ich w słowniku. Formatowanie tekstu zapisuje liczby, daty, waluty, numery telefonów i adresy e-mail w formie pisanej, gdy ustawisz parametr języka, który SpaceXAI wspiera dla 25 języków.
Wypełniacze typu „yyy” i „eem” są domyślnie usuwane. To dobre domyślne ustawienie dla transkrypcji do czytania i złe dla analityki rozmów, więc flaga jest dostępna, jeśli chcesz przywrócić wypełniacze.
Inteligentne wykrywanie zakończenia wypowiedzi pozwala agentowi głosowemu poczekać na koniec myśli zamiast wchodzić przy każdej pauzie. Ustawiasz próg ufności między 0 a 1, a model oznacza wypowiedź jako zakończoną tylko wtedy, gdy z taką ufnością uzna, że mówca skończył; SpaceXAI sugeruje 0,5 do zrównoważonych zastosowań i 0,7 przy dyktowaniu numerów lub adresów.
Towarzyszący timeout wymusza zakończenie tury po określonej ciszy, żeby rozmówca, który odszedł, nie zawiesił sesji. Bez inteligentnego wykrywania domyślne domykanie następuje po 400 ms ciszy, co jest OK dla krótkich komend, a bolesne, gdy ktoś dyktuje numer telefonu.
Model automatycznie wykrywa język i obsługuje przełączenia językowe w obrębie jednego nagrania w jednym przebiegu, bez podpowiedzi języka. SpaceXAI wskazuje wielojęzyczną dokładność jako największą poprawę względem 1.0, a liczby dla krótkich fraz w następnej sekcji to potwierdzają.
Jedno zastrzeżenie: parametr języka wciąż ma znaczenie dla formatowania. Ustaw go, gdy chcesz zapisu liczb i walut w formie pisanej, a pomiń, gdy audio miesza języki i wolisz surowe słowa.
Grok Voice Transcribe 2.0 prowadzi na publicznym leaderboardzie strumieniowym pod względem dokładności i bije 1.0 na każdym wewnętrznym zestawie raportowanym przez SpaceXAI, ale skala poprawy bardzo zależy od rodzaju audio.
W indeksie strumieniowego mowa–tekst Artificial Analysis Grok Voice Transcribe 2.0 osiąga WER (word error rate) 2,7%, najniższy wśród 34 modeli strumieniowych na dzień 21 września 2026. Dalej jest Muse Voice Transcribe od Met y z 3,1%, ElevenLabs Scribe v2 Realtime z 3,6%, a Grok Voice Transcribe 1.0 z 3,9%. Ogłoszenie SpaceXAI liczyło 32 modele na tym samym leaderboardzie w momencie premiery.
Co mierzy WER: WER to odsetek słów rozpoznanych błędnie — im niższy, tym lepiej.
Co mierzy indeks mowa–tekst: Indeks Artificial Analysis uśrednia WER w 3 zestawach testowych (AA-AgentTalk, VoxPopuli i Earnings-22). Najszerszą przewagę Grok 2.0 ma na VoxPopuli, gdzie jego WER 1,4% jest mniej niż połową WER 1.0 wynoszącego 3,1%.
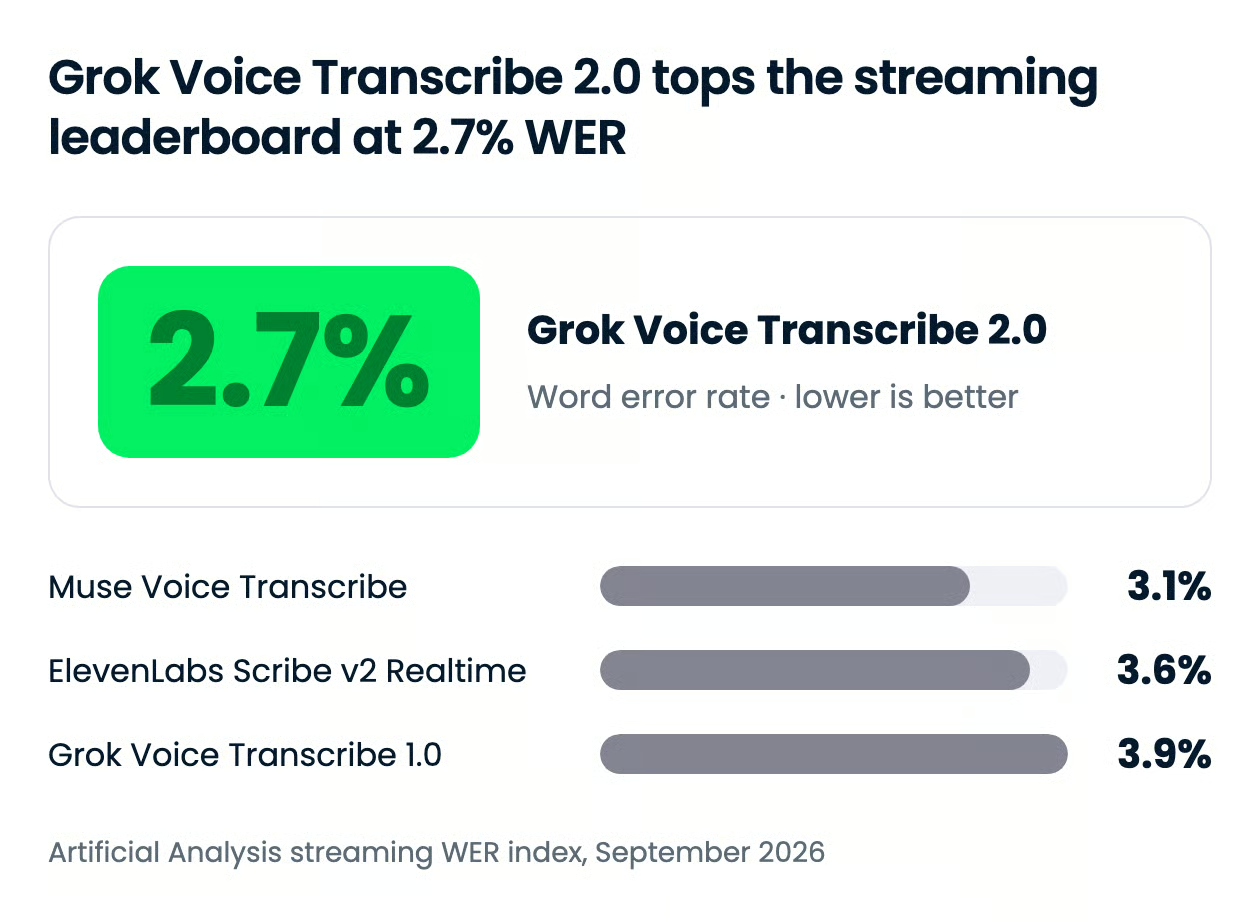
Różnica wobec 1.0 w tym indeksie to 31%, a nie 2x, jak sugeruje ogłoszenie. Większe roszczenie pochodzi z wewnętrznych zestawów produkcyjnych SpaceXAI, do których zaraz przejdę. Ten sam leaderboard rejestruje też czas potrzebny modelom na zatwierdzenie finalnej transkrypcji — i tu obraz się odwraca.
| Model | Indeks WER (finalna transkrypcja) | Czas do finalnej transkrypcji |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2,7% | 0,49 s |
| Muse Voice Transcribe (Meta) | 3,1% | 0,16 s |
| ElevenLabs Scribe v2 Realtime | 3,6% | 0,14 s |
| Grok Voice Transcribe 1.0 | 3,9% | 0,37 s |
| Deepgram Flux | 7,4% | 0,02 s |
Opóźnienie to koszt. Grok 2.0 potrzebuje 0,49 s na zwrot finalnej transkrypcji, wobec 0,37 s dla 1.0 i 0,14 s dla Scribe v2 Realtime. Dla napisów to niewidoczne. Dla agenta głosowego, który musi odpowiadać w każdej turze, dodatkowe dziesiąte sekundy się sumują.
SpaceXAI mierzy WER na czterech wewnętrznych zestawach z ruchu produkcyjnego:
Grok Voice Transcribe 2.0 poprawia wyniki 1.0 we wszystkich czterech, a w telefonii SpaceXAI twierdzi, że prowadzi przed każdym testowanym modelem.
Jedyna liczba, którą SpaceXAI publikuje z tych zestawów, to wynik krótkich fraz: WER spada z 20,6% w 1.0 do 6,8% w 2.0. Krótkie komendy w samochodzie dają modelowi niemal zerowy kontekst do rozpoznania języka — dokładnie tam 1.0 sobie nie radził — a 3x poprawa to najmocniejszy argument za tezą „dwa razy dokładniejszy”.
Pozostałe wykresy wewnętrzne, w tym porównania wielojęzyczne z ElevenLabs Scribe v2 i Deepgram Nova-3, są słupkami bez opisanych wartości. Traktowałbym „prowadzimy przed każdym testowanym modelem” w telefonii jako twierdzenie dostawcy, dopóki ktoś nie odtworzy tego na własnych nagraniach połączeń.
Grok Voice Transcribe 2.0 kosztuje $0,10 za godzinę audio w transkrypcji wsadowej i $0,20 za godzinę w strumieniowej — identycznie jak Grok Voice Transcribe 1.0. Diarizacja, znaczniki czasu słów i zbiastowanie słów kluczowych są wliczone w stawki, a nie rozliczane jako dodatki.
| Tryb | Cena | W cenie |
|---|---|---|
| Wsadowy (plik lub URL) | $0,10 za godzinę audio | Diarizacja, znaczniki czasu, słowa kluczowe, formatowanie |
| Strumieniowy (WebSocket) | $0,20 za godzinę audio | Diarizacja, znaczniki czasu, słowa kluczowe, formatowanie, inteligentne kończenie tury |
Te stawki należą do najniższych na strumieniowym leaderboardzie. Artificial Analysis podaje cenę Grok 2.0 jako $3,33 za 1000 minut, obok $3,00 dla Muse Voice Transcribe od Met y i $6,50 dla ElevenLabs Scribe v2 Realtime oraz Deepgram Flux. Wśród czterech najdokładniejszych modeli w indeksie tylko Muse jest tańszy, a Muse ma niższą dokładność.
Model jest ogólnie dostępny w API SpaceXAI, bez listy oczekujących lub ograniczeń regionalnych wspomnianych w ogłoszeniu lub dokumentacji. Nie ma planu konsumenckiego do wyboru, bo to produkt API, a ani ogłoszenie, ani dokumentacja nie wspominają o darmowym progu dla mowa–tekst.
Domyślna wersja jest w trakcie zmiany. SpaceXAI zapowiada, że 2.0 wkrótce stanie się domyślna w Speech-to-Text API, a 1.0 zostanie wycofana w nadchodzących tygodniach. Do tego czasu identyfikator modelu ustawiaj jawnie.
Identyfikator modelu to grok-voice-transcribe-2.0, przekazywany jako pole formularza w endpointzie REST lub jako parametr zapytania w endpointzie WebSocket. Aby pozostać przy starym modelu podczas okna wycofania, przypnij grok-voice-transcribe-1.0.
Działa w dwóch miejscach: w API SpaceXAI, z trybem wsadowym pod https://api.x.ai/v1/stt i strumieniowym pod wss://api.x.ai/v1/stt, oraz w konsoli SpaceXAI, która ma playground mowa–tekst na żywo. Nie ma go w katalogu OpenRouter na dzień 21 września 2026.
Oto najmniejsze wywołanie wsadowe zwracające transkrypcję z diarizacją:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
Dla agentów głosowych opartych na głosowych API WebSocket xAI, zobacz nasz poradnik Grok Voice Think Fast 2.0 API, który obejmuje model mowa–mowa, oraz nasz przewodnik po Grok Voice Agent API. Jeśli wywołujesz tekstowe modele Grok z tego samego kodu, nasz poradnik Grok 4.6 API omawia klucze i wywoływanie narzędzi.
Grok Voice Transcribe 2.0 to najtańszy sposób na uzyskanie najdokładniejszej transkrypcji strumieniowej na publicznym leaderboardzie — a takie połączenie rzadko się zdarza. xAI wysyła sygnał, że jego stos głosowy ma konkurować z OpenAI, Google i ElevenLabs, a nie tylko w modelach tekstowych.
Przeszedłbym na 2.0, jeśli moje audio jest jakości telefonicznej, wielojęzyczne lub pełne dyktowanych numerów — tam 2.0 odjeżdża 1.0 i większości rywali. Wstrzymałbym się przy agencie wrażliwym na opóźnienia, dopóki xAI nie zmniejszy dystansu do Scribe v2 w czasie do finalnej transkrypcji.
Jeśli chcesz samodzielnie budować potoki transkrypcyjne, polecam nasz kurs Spoken Language Processing in Python, który prowadzi od surowych plików audio do transkrybowanych i klasyfikowanych połączeń telefonicznych.
Ucz się AI z DataCamp!
course
Track
course