Curso
Procesamiento del lenguaje hablado en Python
4 h
9.3K
El streaming de voz a texto se ha convertido en un campo muy concurrido. OpenAI, Google, ElevenLabs, Meta y Deepgram ofrecen modelos de transcripción en tiempo real, y Artificial Analysis ya clasifica decenas de ellos con un índice único de tasa de error por palabra. El modelo más reciente de SpaceXAI, Grok Voice Transcribe 2.0, acaba de alcanzar el primer puesto de ese índice.
En este artículo, repasamos todas las novedades de Grok Voice Transcribe 2.0: sus nuevas funciones, los benchmarks públicos e internos y los precios y el acceso por API. También puedes consultar nuestras guías de la API de Grok Voice Think Fast 2.0 y de la API de GPT Live Transcribe.
Grok Voice Transcribe 2.0 es la segunda generación del modelo de voz a texto de SpaceXAI, y xAI lo presenta como su mejor modelo de transcripción hasta la fecha. Se basa en el modelo fundacional de audio detrás de Grok Voice, que según SpaceXAI ya resuelve decenas de miles de llamadas de soporte al día, transcribe millones de horas de narración de vídeo y da servicio al asistente Grok en vehículos Tesla.
Lo que cambia respecto a la 1.0 es el entrenamiento, no la API. SpaceXAI entrenó la 2.0 con audio en vivo, ruidoso y multilingüe en entornos muy variados, y luego la afinó con postentrenamiento orientado a las condiciones reales más complicadas:
La gran promesa es que la 2.0 duplica la precisión de la 1.0 en las evaluaciones de xAI con audio real, sin cambiar los precios respecto a la primera generación. En la sección de benchmarks analizamos esa afirmación, porque el leaderboard público muestra una mejora más modesta que los conjuntos internos.
La lista de funciones es la misma que trajo la 1.0, y ese es el objetivo: xAI ha invertido la mejora en la precisión y ha mantenido intacta la superficie de la API.
Puedes enviar un archivo grabado o una URL al endpoint batch, o transmitir audio en crudo por WebSocket y recibir eventos de transcripción mientras la persona sigue hablando. Ambos caminos usan el mismo modelo, así que la transcripción de una llamada grabada y la de la llamada en directo deberían coincidir.
Batch acepta archivos de hasta 500 MB en 12 formatos de audio, incluidos WAV, MP3, FLAC y contenedores MP4, además de PCM en crudo y los códecs de telefonía G.711. En streaming puede emitir transcripciones parciales cada ~500 ms y etiqueta cada resultado como fragmento bloqueado o intervención finalizada, para que una interfaz de subtitulado muestre texto pronto y lo sustituya al confirmarse.
Cada palabra vuelve con tiempo de inicio y fin, y si activas la diarización añade una etiqueta de hablante a cada palabra sin coste adicional. Para audio de call center con el agente en un canal y la persona cliente en otro, el modo multicanal transcribe hasta 8 canales de forma independiente, con lo que puedes prescindir de la diarización.
La respuesta es un único objeto JSON con el texto completo, el idioma detectado como código BCP-47, la duración del audio y el array de palabras. No hay que hacer una llamada separada para obtener marcas de tiempo.
Puedes pasar hasta 100 términos clave por solicitud, de hasta 50 caracteres cada uno, para sesgar el modelo hacia nombres de productos, fármacos o cualquier término de tu dominio que se pronuncie pero no figure en un diccionario. El formateo de texto escribe números, fechas, divisas, teléfonos y correos en su forma escrita cuando defines el parámetro de idioma, que SpaceXAI admite en 25 idiomas.
Las muletillas como "em" y "eh" se eliminan por defecto. Es la opción adecuada para transcripciones que alguien va a leer y la inadecuada para analítica conversacional, así que tienes la bandera para recuperarlas si las necesitas.
La detección inteligente de turnos permite a un agente de voz esperar al final de una idea en lugar de interrumpir en cada pausa. Fijas un umbral de confianza entre 0 y 1, y el modelo solo marca la intervención como finalizada cuando alcanza esa confianza de que la persona ha terminado; SpaceXAI sugiere 0.5 para un uso equilibrado y 0.7 cuando se dictan números o direcciones.
Un tiempo de espera complementario fuerza el fin del turno tras un silencio fijo, para que si alguien se aleja del teléfono no se quede colgada la sesión. Sin el modo inteligente, el endpointing por defecto se dispara tras 400 ms de silencio, suficiente para comandos cortos y desesperante si alguien dicta un número de teléfono.
El modelo detecta el idioma automáticamente y gestiona cambios de idioma dentro de una misma grabación en una sola pasada, sin pista previa. SpaceXAI señala la precisión multilingüe como la mayor mejora respecto a la 1.0, y las cifras en frases cortas de la siguiente sección lo respaldan.
Un matiz: el parámetro de idioma sigue siendo relevante para el formateo. Defínelo cuando quieras números y divisas en forma escrita, y déjalo vacío si el audio mezcla idiomas y prefieres las palabras tal cual.
Grok Voice Transcribe 2.0 lidera el leaderboard público de streaming en precisión y supera a la 1.0 en todos los conjuntos internos que reporta SpaceXAI, pero el tamaño de la mejora depende mucho del tipo de audio.
En el índice de voz a texto en streaming de Artificial Analysis, Grok Voice Transcribe 2.0 marca una tasa de error por palabra (WER) del 2,7%, la más baja de los 34 modelos en streaming listados a 21 de septiembre de 2026. Le sigue Muse Voice Transcribe de Meta con un 3,1%, ElevenLabs Scribe v2 Realtime con un 3,6%, y Grok Voice Transcribe 1.0 con un 3,9%. El anuncio de SpaceXAI contaba 32 modelos en el mismo leaderboard en su lanzamiento.
Qué mide WER: WER es el porcentaje de palabras que el modelo falla; cuanto menor, mejor.
Qué mide el índice de voz a texto: El índice de Artificial Analysis promedia el WER en 3 conjuntos (AA-AgentTalk, VoxPopuli y Earnings-22). La mayor ventaja de Grok 2.0 está en VoxPopuli, donde su WER del 1,4% es menos de la mitad que el 3,1% de la 1.0.
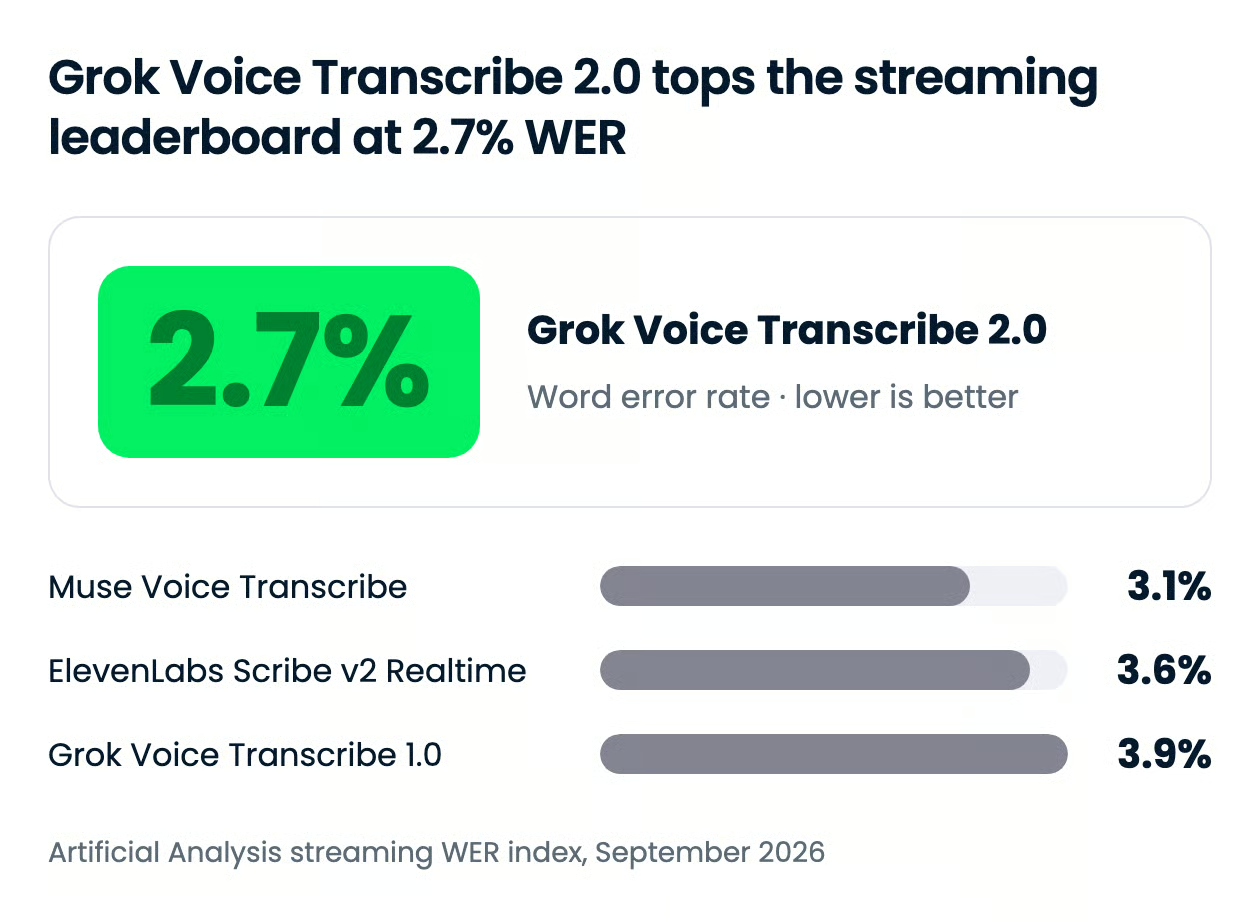
La brecha frente a la 1.0 en este índice es del 31%, no el doble que sugiere el anuncio. Esa afirmación mayor viene de los conjuntos de producción de SpaceXAI, que repasamos a continuación. El mismo leaderboard también recoge el tiempo que cada modelo tarda en fijar una transcripción final, y aquí la foto se invierte.
| Modelo | Índice WER (transcripción final) | Tiempo hasta la transcripción final |
|---|---|---|
| Grok Voice Transcribe 2.0 | 2,7% | 0,49 s |
| Muse Voice Transcribe (Meta) | 3,1% | 0,16 s |
| ElevenLabs Scribe v2 Realtime | 3,6% | 0,14 s |
| Grok Voice Transcribe 1.0 | 3,9% | 0,37 s |
| Deepgram Flux | 7,4% | 0,02 s |
La latencia es el peaje. Grok 2.0 tarda 0,49 s en devolver la transcripción final, frente a 0,37 s de la 1.0 y 0,14 s de Scribe v2 Realtime. Para subtítulos es imperceptible. Para un agente de voz que debe contestar en cada turno, esas décimas se acumulan.
SpaceXAI mide el WER en cuatro conjuntos internos extraídos de tráfico en producción:
Grok Voice Transcribe 2.0 mejora a la 1.0 en los cuatro, y en telefonía SpaceXAI afirma liderar frente a todos los modelos que probó.
El único dato que SpaceXAI publica de estos conjuntos es el de frases cortas: el WER cae del 20,6% con la 1.0 al 6,8% con la 2.0. Los comandos breves en el coche dan casi cero contexto para identificar el idioma, justo donde flojeaba la 1.0, y una mejora de 3x ahí es la mejor prueba detrás del "el doble de precisa".
El resto de gráficos internos, incluida la comparación multilingüe con ElevenLabs Scribe v2 y Deepgram Nova-3, llegan como barras sin valores etiquetados. Yo tomaría el "lideramos en telefonía" como una afirmación de proveedor hasta que alguien lo reproduzca con su propio audio de llamadas.
Grok Voice Transcribe 2.0 cuesta $0,10 por hora de audio en transcripción batch y $0,20 por hora en streaming, idéntico a Grok Voice Transcribe 1.0. La diarización, las marcas de tiempo por palabra y el sesgo por términos clave están incluidos en esas tarifas, no se facturan aparte.
| Modo | Precio | Incluye |
|---|---|---|
| Batch (archivo o URL) | $0,10 por hora de audio | Diarización, marcas de tiempo, términos clave, formato |
| Streaming (WebSocket) | $0,20 por hora de audio | Diarización, marcas de tiempo, términos clave, formato, turno inteligente |
Estas tarifas están entre las más bajas del leaderboard de streaming. Artificial Analysis lista Grok 2.0 a $3,33 por 1.000 minutos, frente a $3,00 de Muse Voice Transcribe de Meta y $6,50 tanto de ElevenLabs Scribe v2 Realtime como de Deepgram Flux. Entre los cuatro modelos más precisos del índice, solo Muse es más barato, y Muse puntúa peor en precisión.
El modelo está disponible de forma general en la API de SpaceXAI, sin lista de espera ni restricción regional mencionada en el anuncio o la documentación. No hay un plan de consumo que elegir, porque es un producto de API, y ni el anuncio ni la documentación mencionan una capa gratuita para voz a texto.
El valor por defecto está en transición. SpaceXAI indica que la 2.0 será pronto el valor por defecto en la API de Speech-to-Text y que la 1.0 quedará obsoleta en las próximas semanas. Hasta entonces, conviene fijar el ID del modelo explícitamente.
El ID del modelo es grok-voice-transcribe-2.0, que se pasa como campo de formulario en el endpoint REST o como parámetro de consulta en el endpoint WebSocket. Si quieres mantenerte en el modelo antiguo durante la ventana de deprecación, fija grok-voice-transcribe-1.0.
Funciona en dos superficies: la API de SpaceXAI, con batch en https://api.x.ai/v1/stt y streaming en wss://api.x.ai/v1/stt, y la consola de SpaceXAI, que incluye un playground en vivo de voz a texto. No figura en el catálogo de OpenRouter a 21 de septiembre de 2026.
Este es el ejemplo mínimo de llamada batch que devuelve una transcripción con diarización:
import os
import requests

response = requests.post(
    "https://api.x.ai/v1/stt",
    headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
    data=[("model", "grok-voice-transcribe-2.0"), ("diarize", "true")],
    files={"file": open("standup.wav", "rb")},
)
print(response.json()["text"])
Para agentes de voz basados en las APIs de voz por WebSocket de xAI, consulta nuestro tutorial de la API Grok Voice Think Fast 2.0, que cubre el modelo de voz a voz, y nuestra guía de la API Grok Voice Agent. Si llamas a los modelos de texto de Grok desde el mismo código, nuestro tutorial de la API Grok 4.6 cubre claves y tool calling.
Grok Voice Transcribe 2.0 es la forma más barata de conseguir la transcripción en streaming más precisa del leaderboard público, una combinación poco común. xAI deja claro que su stack de voz compite con OpenAI, Google y ElevenLabs, no solo con sus modelos de texto.
Yo me cambiaría si mi audio es de calidad telefónica, multilingüe o lleno de números dictados, que es donde la 2.0 se distancia de la 1.0 y de buena parte de la competencia. Para un agente de voz muy sensible a la latencia, esperaría a que xAI recorte la brecha con Scribe v2 en tiempo hasta la transcripción final.
Si quieres montar tú mismo pipelines de transcripción, te recomendamos nuestro curso Spoken Language Processing in Python, que va desde audio en crudo hasta llamadas transcritas y clasificadas.
¡Aprende IA con DataCamp!
Curso
programa
Curso
blog
Matt Crabtree
13 min
blog
Ryan Ong
8 min
Tutorial
Abid Ali Awan
9 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Moez Ali
11 min