Corso
Lavorare con Llama 3
2 ore
15.6K
Secondo gli esempi di Meta, i modelli possono analizzare grafici incorporati nei documenti e riassumere le tendenze chiave. Possono anche interpretare mappe, stabilire quale tratto di un sentiero è il più ripido o calcolare la distanza tra due punti.
Questa integrazione di ragionamento su testo e immagini offre un'ampia gamma di applicazioni potenziali, tra cui:
I modelli di visione di Llama 3.2 sono aperti e personalizzabili. Gli sviluppatori possono effettuare fine-tuning sia delle versioni pre-addestrate sia di quelle allineate utilizzando il framework Torchtune di Meta.
Inoltre, questi modelli possono essere distribuiti in locale tramite Torchchat, riducendo la dipendenza dall'infrastruttura cloud e offrendo una soluzione a chi desidera distribuire sistemi di IA on-prem o in ambienti con risorse limitate.
I modelli di visione sono disponibili anche per test tramite Meta AI, l'assistente intelligente di Meta.
Per consentire ai modelli di visione Llama 3.2 di comprendere sia testo sia immagini, Meta ha integrato un image encoder pre-addestrato nel modello linguistico esistente utilizzando speciali adattatori. Questi adattatori collegano i dati delle immagini alle parti del modello deputate all'elaborazione del testo, consentendogli di gestire entrambi i tipi di input.
Il processo di addestramento è iniziato dal modello linguistico Llama 3.1. Prima, il team lo ha addestrato su grandi set di immagini abbinate a descrizioni testuali per insegnargli a connettere i due domini. Poi lo ha affinato usando dati più puliti e specifici per migliorarne la capacità di comprendere e ragionare sui contenuti visivi.
Nelle fasi finali, Meta ha utilizzato tecniche come il fine-tuning e la generazione di dati sintetici per garantire che il modello fornisca risposte utili e si comporti in modo sicuro.
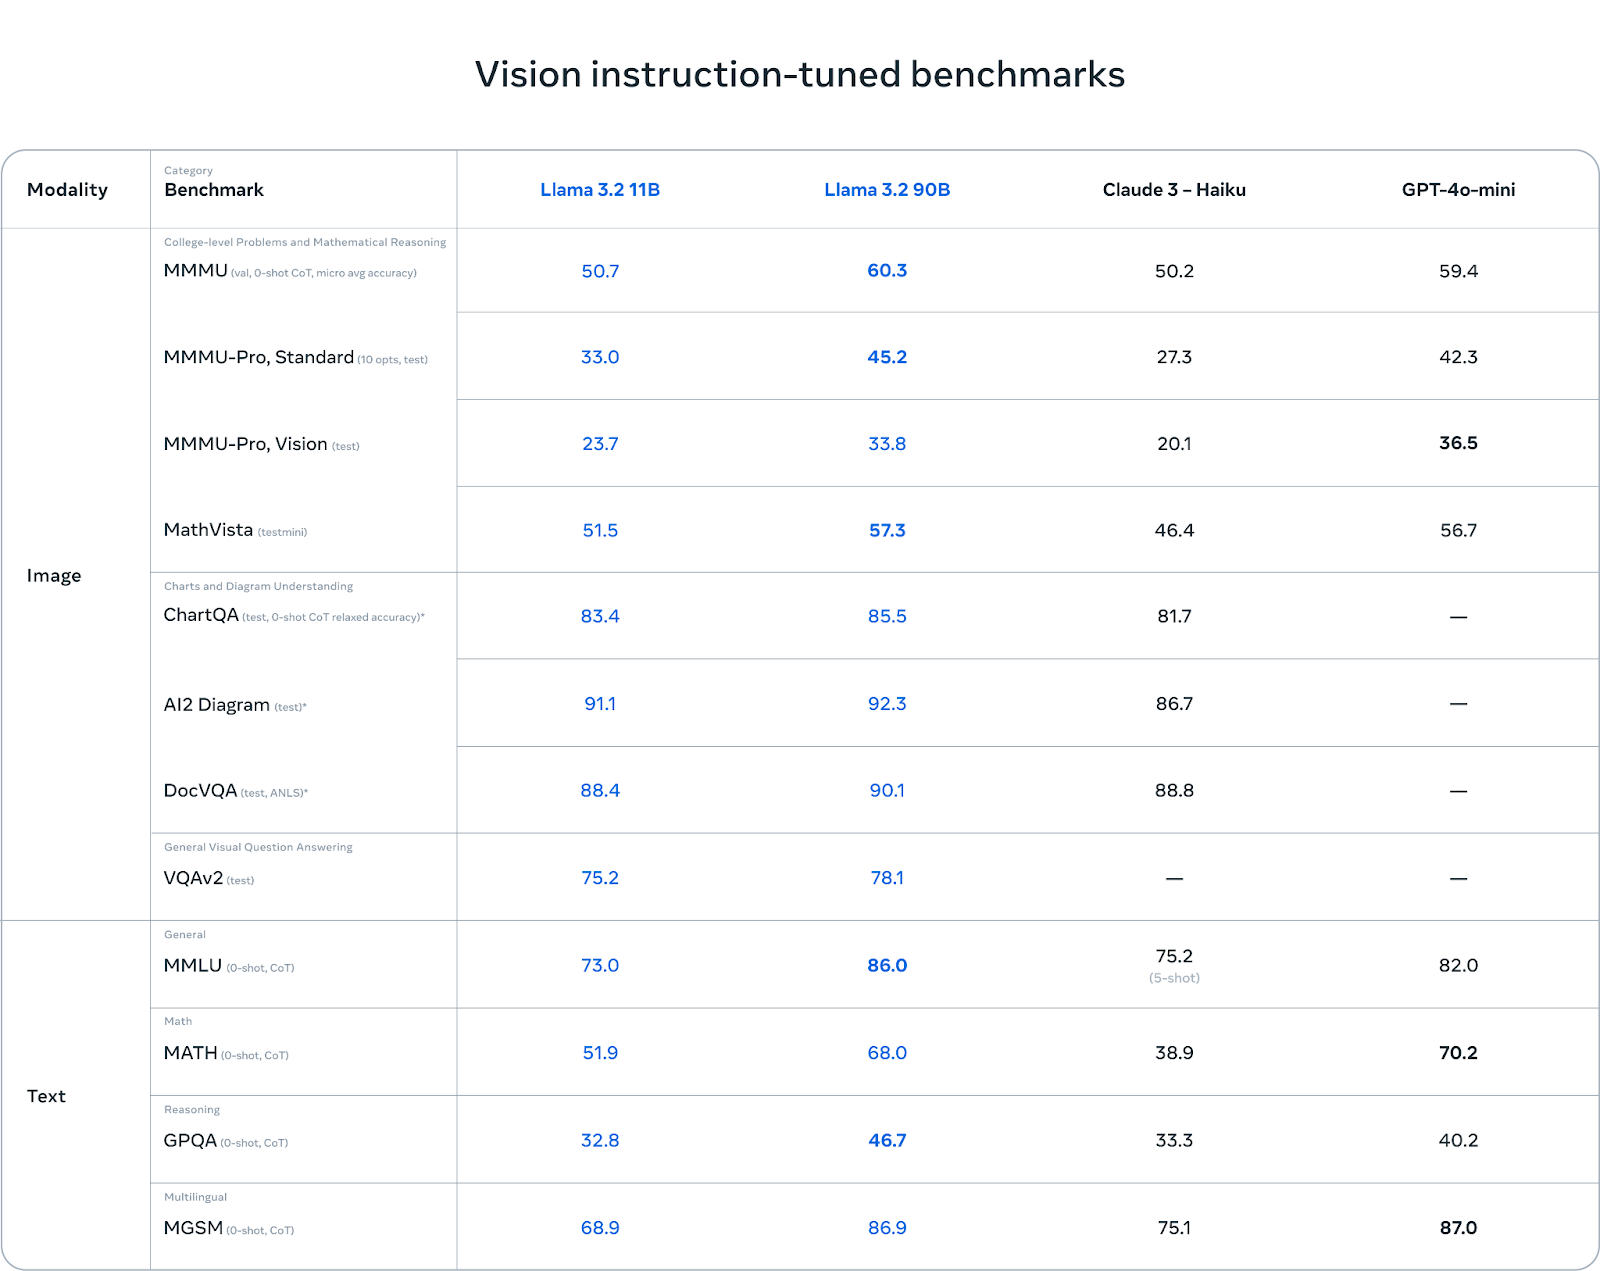
I modelli di visione Llama 3.2 brillano nella comprensione di grafici e diagrammi. In benchmark come AI2 Diagram (92,3) e DocVQA (90,1), Llama 3.2 supera Claude 3 Haiku. È dunque un'ottima scelta per attività che coinvolgono comprensione a livello di documento, visual question answering ed estrazione di dati da grafici.
Nei compiti multilingue (MGSM), Llama 3.2 si comporta bene, avvicinandosi a GPT-4o-mini con un punteggio di 86,9, risultando una scelta solida per gli sviluppatori che lavorano con più lingue.
Fonte: Meta AI
Sebbene Llama 3.2 si comporti bene nei compiti basati sulla visione, incontra difficoltà in altre aree. In MMMU-Pro Vision, che testa il ragionamento matematico su dati visivi, GPT-4o-mini supera Llama 3.2 con un punteggio di 36,5 rispetto ai 33,8 di Llama.
Allo stesso modo, nel benchmark MATH, le prestazioni di GPT-4o-mini (70,2) superano nettamente quelle di Llama 3.2 (51,9), indicando che Llama ha ancora margini di miglioramento nei compiti di ragionamento matematico.
Un altro avanzamento significativo in Llama 3.2 è l'introduzione di modelli leggeri progettati per dispositivi edge e mobili. Questi modelli, con 1 e 3 miliardi di parametri, sono ottimizzati per funzionare su hardware più piccolo mantenendo un ragionevole compromesso in termini di prestazioni.
Questi modelli sono progettati per essere eseguiti su dispositivi mobili, offrendo elaborazione rapida e locale senza dover inviare dati al cloud. Eseguire i modelli in locale su dispositivi edge offre due principali vantaggi:
I modelli leggeri di Llama 3.2 sono ottimizzati per processori Arm e abilitati su hardware Qualcomm e MediaTek, che alimenta molti dispositivi mobili ed edge attuali.
I modelli leggeri sono progettati per una varietà di applicazioni pratiche on-device, come:
1. Riassunto: gli utenti possono riassumere grandi quantità di testo, come email o note di riunioni, direttamente sul proprio dispositivo senza dipendere dai servizi cloud.
I modelli leggeri Llama 3.2 (1B e 3B) sono stati costruiti per adattarsi in modo efficiente a dispositivi mobili ed edge mantenendo buone prestazioni. Per riuscirci, Meta ha utilizzato due tecniche chiave: pruning e distillazione.
Fonte: Meta AI
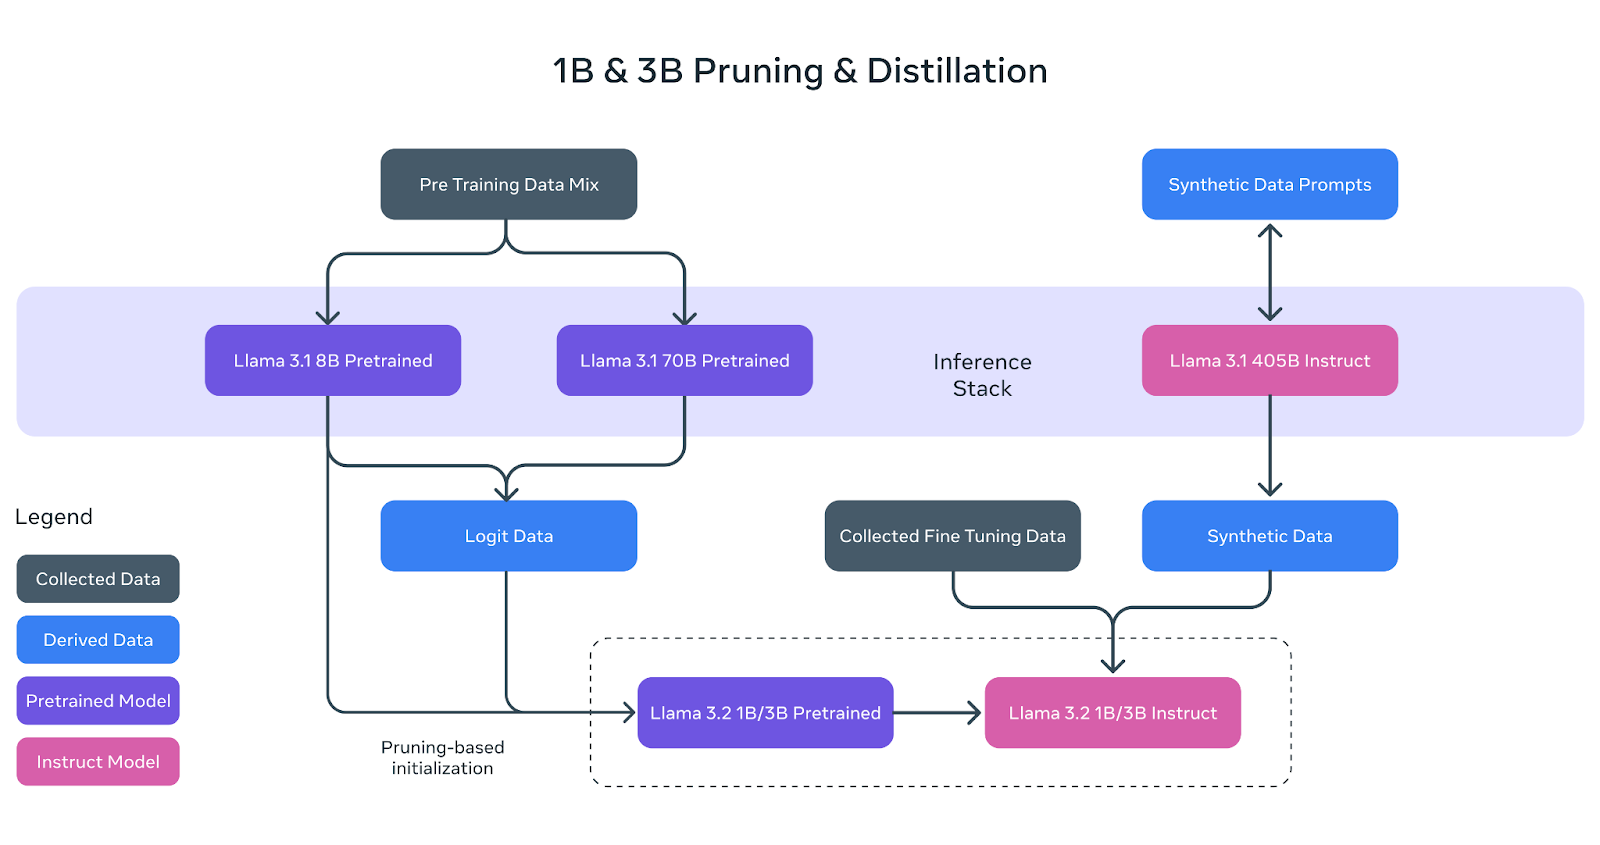
Il pruning aiuta a ridurre le dimensioni dei modelli Llama originali rimuovendo le parti meno critiche della rete, preservando al contempo quanta più conoscenza possibile. Nel caso dei modelli da 1B e 3B di Llama 3.2, questo processo è partito dal più grande Llama 3.1 8B pre-addestrato.
Attraverso un pruning sistematico, il team di Meta AI è riuscito a creare versioni più piccole ed efficienti del modello senza perdite significative di prestazioni. Ciò è rappresentato nel diagramma sopra, dove il modello 8B pre-addestrato (riquadro viola) viene potato e affinato per diventare la base dei modelli Llama 3.2 1B/3B più piccoli.
La distillazione è il processo di trasferire conoscenza da un modello più grande e potente (il "maestro") a un modello più piccolo (lo "studente"). In Llama 3.2, i logit (predizioni) dei modelli Llama 3.1 8B e Llama 3.1 70B sono stati usati per insegnare ai modelli più piccoli.
In questo modo, i modelli da 1B e 3B hanno potuto imparare a svolgere i compiti in modo più efficace, nonostante le dimensioni ridotte. Il diagramma sopra mostra come questo processo utilizzi i dati dei logit dei modelli più grandi per guidare i modelli 1B e 3B durante il pre-training.
Dopo pruning e distillazione, i modelli da 1B e 3B hanno subito un post-training, simile ai precedenti modelli Llama. Questo ha previsto tecniche come supervised fine-tuning, rejection sampling e direct preference optimization per allineare le uscite dei modelli alle aspettative degli utenti.
Sono stati inoltre generati dati sintetici per garantire che i modelli potessero gestire un'ampia gamma di attività, come riassunto, riscrittura e follow delle istruzioni.
Come mostrato nel diagramma, i modelli instruct Llama 3.2 1B/3B finali sono il risultato di pruning, distillazione ed esteso post-training.
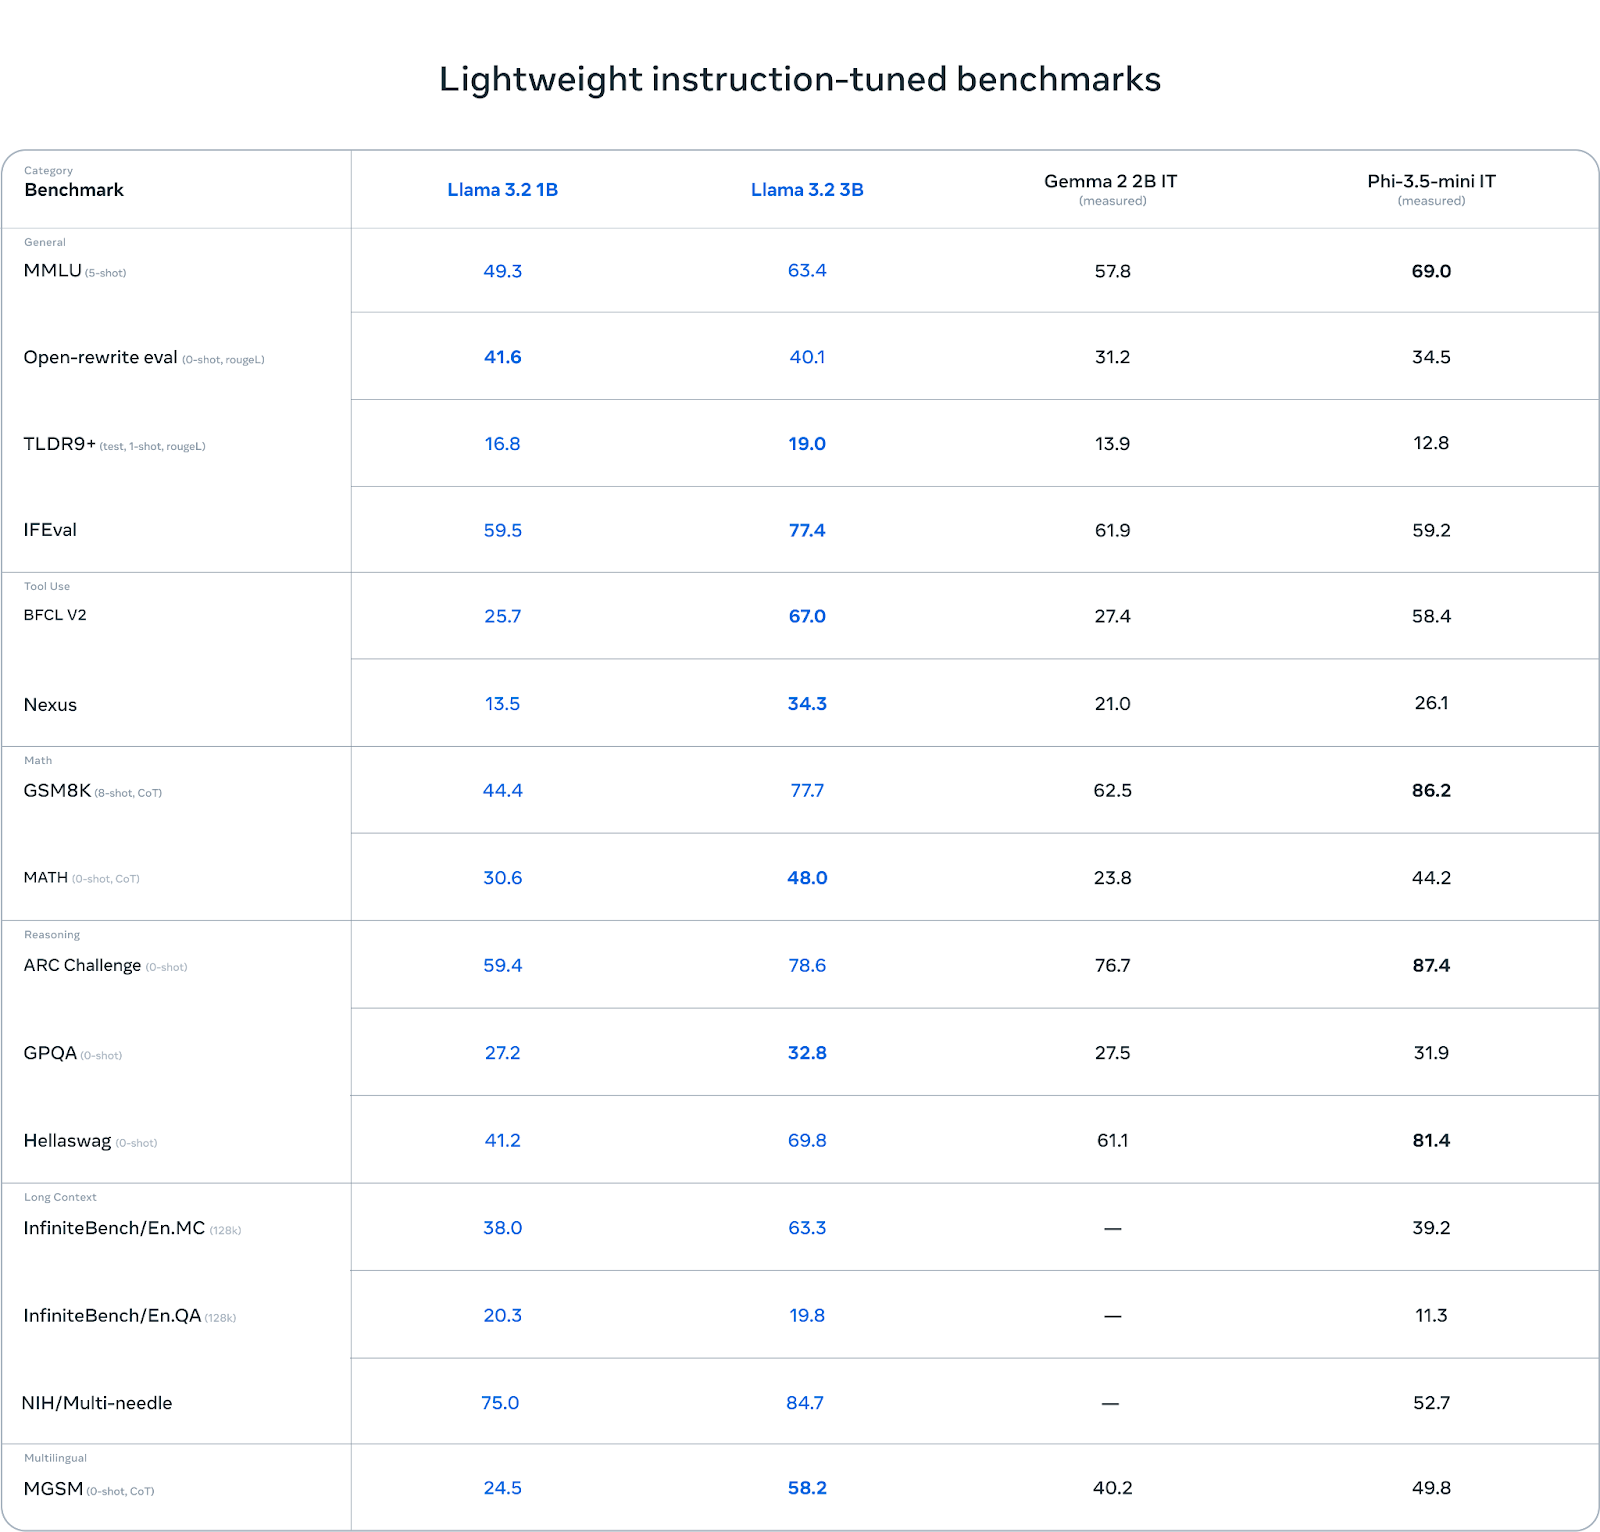
Llama 3.2 3B si distingue in alcune categorie, soprattutto in compiti che coinvolgono il ragionamento. Ad esempio, nell'ARC Challenge ottiene 78,6, superando Gemma (76,7) e restando di poco dietro a Phi-3.5-mini (87,4). Analogamente, si comporta bene nel benchmark Hellawag, raggiungendo 69,8, battendo Gemma e rimanendo competitivo con Phi.
Nei compiti di uso degli strumenti come BFCL V2, Llama 3.2 3B eccelle con un punteggio di 67,0, davanti a entrambi i concorrenti. Ciò dimostra che il modello 3B gestisce efficacemente il follow delle istruzioni e i compiti legati agli strumenti.
Fonte: Meta AI
Per completare il rilascio di Llama 3.2, Meta introduce la Llama Stack. Per gli sviluppatori, usare la Llama Stack significa non doversi preoccupare dei dettagli complessi dell'installazione o della distribuzione di modelli di grandi dimensioni. Possono concentrarsi sulla costruzione delle applicazioni, confidando che la Llama Stack gestisca gran parte del lavoro più pesante.
Ecco le caratteristiche chiave della Llama Stack:
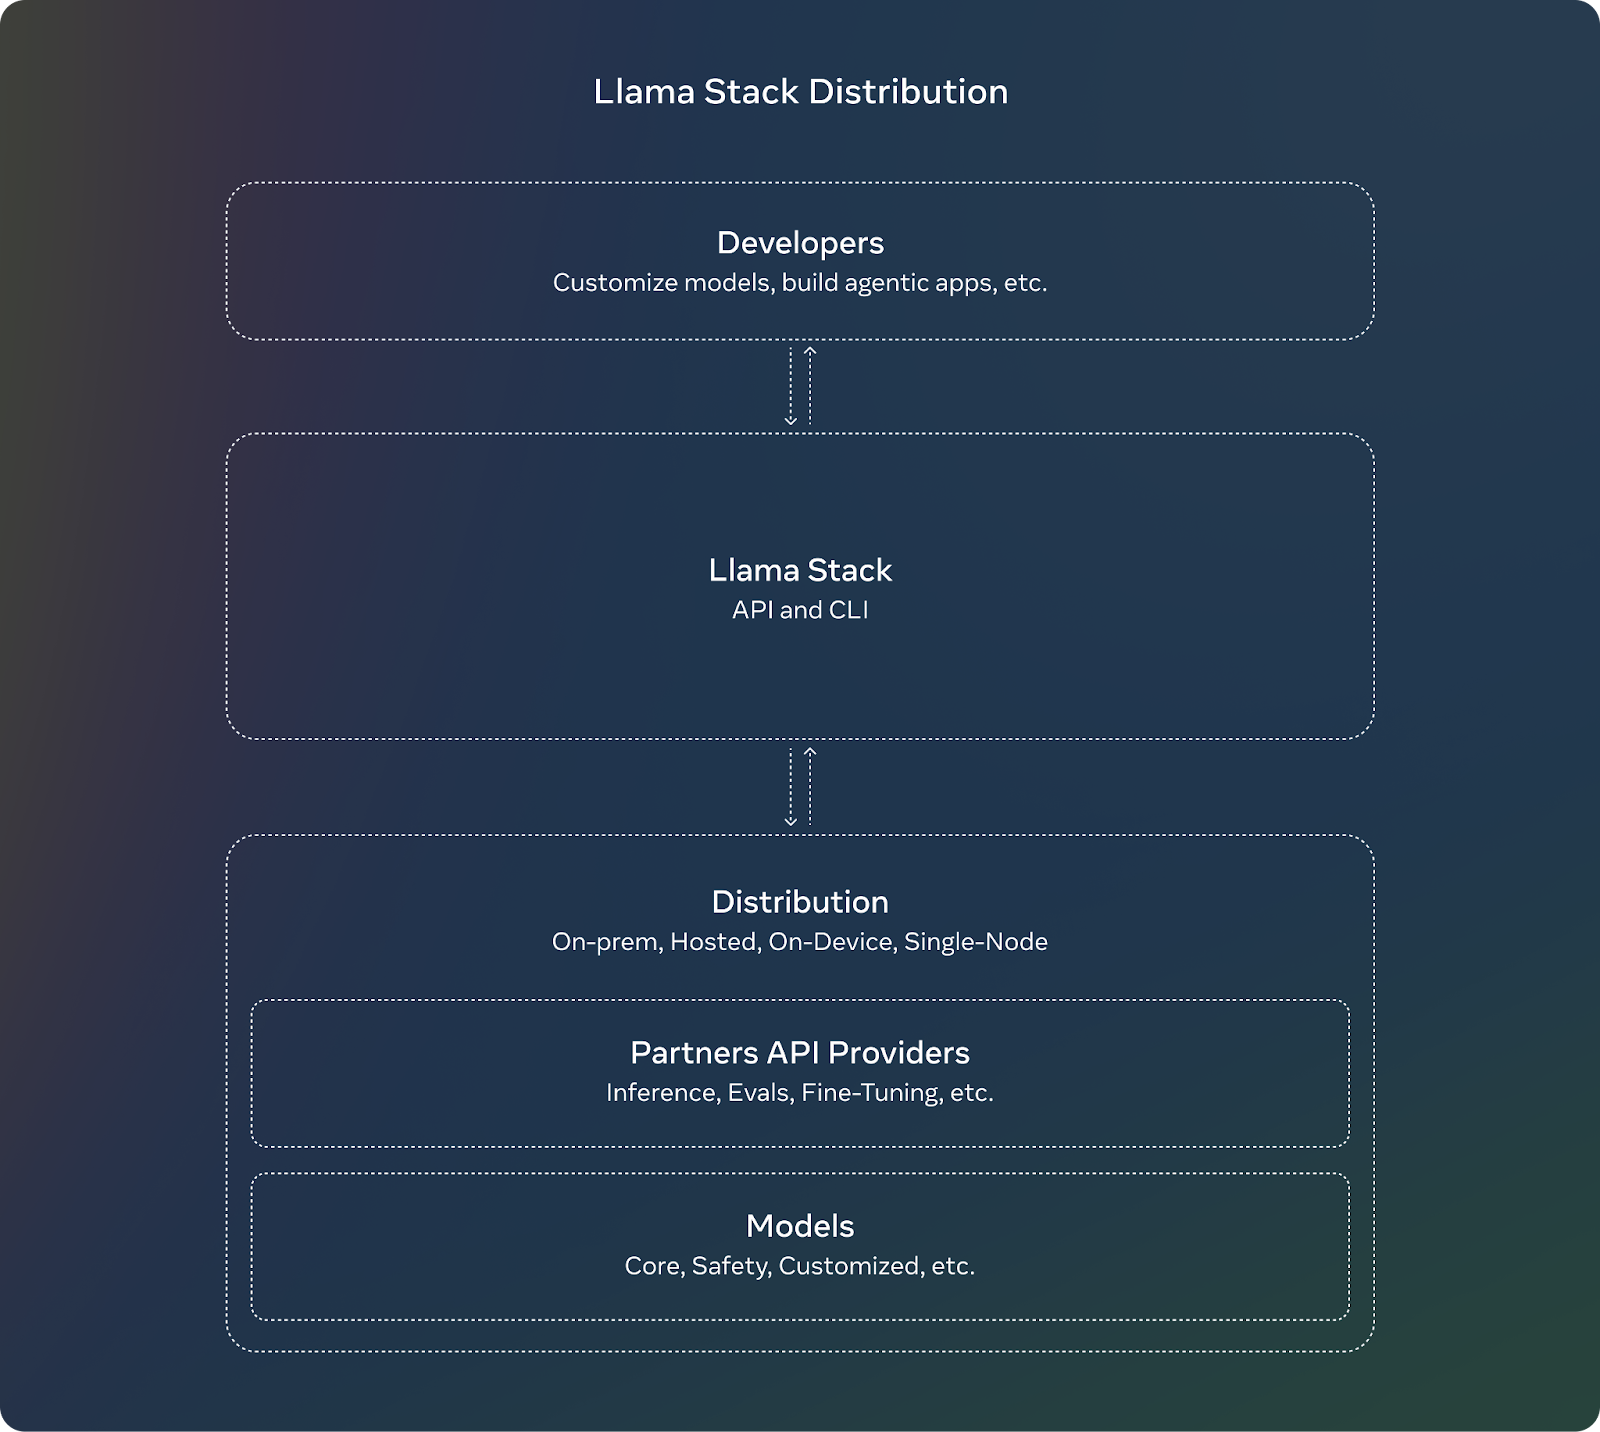
Fonte: Meta AI
Meta prosegue il suo impegno per una IA responsabile con Llama 3.2. Llama Guard 3 è stato aggiornato includendo una versione con visione integrata che supporta le nuove capacità multimodali di Llama 3.2. Questo garantisce che le applicazioni che utilizzano le nuove funzionalità di comprensione delle immagini rimangano sicure e conformi alle linee guida etiche.
Inoltre, Llama Guard 3 1B è stato ottimizzato per la distribuzione in ambienti con risorse più limitate, risultando più piccolo ed efficiente rispetto alle versioni precedenti.
Accedere e scaricare i modelli Llama 3.2 è piuttosto semplice. Meta ha reso questi modelli disponibili su più piattaforme, inclusi il proprio sito e Hugging Face, una piattaforma popolare per l'hosting e la condivisione di modelli di IA.
Puoi scaricare i modelli Llama 3.2 direttamente dal sito ufficiale di Llama. Meta offre sia i modelli più piccoli e leggeri (1B e 3B) sia i modelli più grandi con visione integrata (11B e 90B) a disposizione degli sviluppatori.
Hugging Face è un'altra piattaforma su cui sono disponibili i modelli Llama 3.2. Fornisce un accesso semplice ed è comunemente usata dagli sviluppatori nella community dell'IA.
I modelli Llama 3.2 sono immediatamente disponibili per lo sviluppo sul nostro ampio ecosistema di piattaforme partner, tra cui AMD, AWS, Databricks, Dell, Google Cloud, Groq, IBM, Intel, Microsoft Azure, NVIDIA, Oracle Cloud, Snowflake e altri.
Il rilascio di Llama 3.2 da parte di Meta introduce i primi modelli multimodali della serie, concentrandosi su due aree chiave: modelli con visione integrata e modelli leggeri per dispositivi edge e mobili.
I modelli multimodali da 11B e 90B ora possono gestire sia l'elaborazione del testo sia delle immagini, mentre i modelli da 1B e 3B sono ottimizzati per un uso locale ed efficiente su dispositivi più piccoli.
In questo articolo ho presentato l'essenziale: come funzionano questi modelli, le loro applicazioni pratiche e come puoi accedervi.
Impara l'IA con questi corsi!
Corso
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



