
Program
Deploy Production-Ready Agents
2 jam
Kebanyakan percakapan tentang AI agenik berfokus pada model penalaran frontier yang melakukan perencanaan.
Argumen NVIDIA dengan Nemotron 3.5 Lightning adalah bahwa model frontier bukanlah alat yang tepat untuk sebagian besar pekerjaan yang sebenarnya dilakukan agen.
Agen yang berjalan lama menghabiskan sebagian besar anggaran token untuk pemanggilan alat, memvalidasi keluaran, dan mendelegasikan ke subagen, dan menjalankan model frontier untuk setiap langkah tersebut itu mahal dan lambat.
Nemotron 3.5 Lightning, dirilis pada 11 Agustus 2026, adalah model mixture-of-experts (MoE) terbuka 30B dengan 3B parameter aktif yang ditujukan tepat untuk lapisan eksekusi tersebut.
NVIDIA mengklaim memenangkan Pareto frontier akurasi versus kecepatan pada Artificial Analysis Intelligence Index, dan melaporkan hingga 4x kecepatan keluaran dibanding model berukuran serupa. Model ini dikirimkan di bawah lisensi permisif OpenMDW-1.1 dengan bobot, data pelatihan, dan resep yang dirilis.
Di artikel ini, saya akan membahas semua hal baru pada Nemotron 3.5 Lightning, melihat fiturnya dan mengeksplorasi tolak ukurnya. Jika Anda ingin melihat bagaimana model MoE berukuran serupa berperilaku dalam praktik, tutorial kami tentang fine-tuning Qwen3.6 pada dataset tanya jawab medis memandu alur kerja dari awal hingga akhir.
Nemotron 3.5 Lightning adalah anggota terkecil dari keluarga model terbuka Nemotron 3 milik NVIDIA, yang dibuat khusus untuk eksekusi bervolume tinggi dan berlatensi rendah pada agen otonom.
Model ini menggunakan arsitektur hibrida Mamba-2 + MoE + attention dengan total 30B parameter dan 3B aktif per token, serta mendukung panjang konteks hingga 1M token.
Desain MoE-lah yang membuatnya cepat.
Sebuah router mengirim setiap token hanya ke beberapa dari banyak ekspertnya, sehingga hanya sebagian parameter yang berjalan per token.
Anda mendapatkan kapasitas model dens besar dengan biaya komputasi model kecil, yang merupakan kompromi yang sama seperti pada Qwen3.6-35B-A3B dengan 3B parameter aktif.
Klaim besar dari NVIDIA bersifat posisional alih-alih satu skor tunggal: pada Artificial Analysis Intelligence Index, yang menggabungkan 9 evaluasi lintas tugas agenik, pengodean, penalaran ilmiah, dan kecerdasan umum, Lightning berada pada Pareto frontier akurasi-kecepatan untuk model terbuka kecil.
Secara sederhana, tidak ada yang sekelas ukurannya yang sekaligus lebih akurat dan lebih cepat pada saat yang sama.
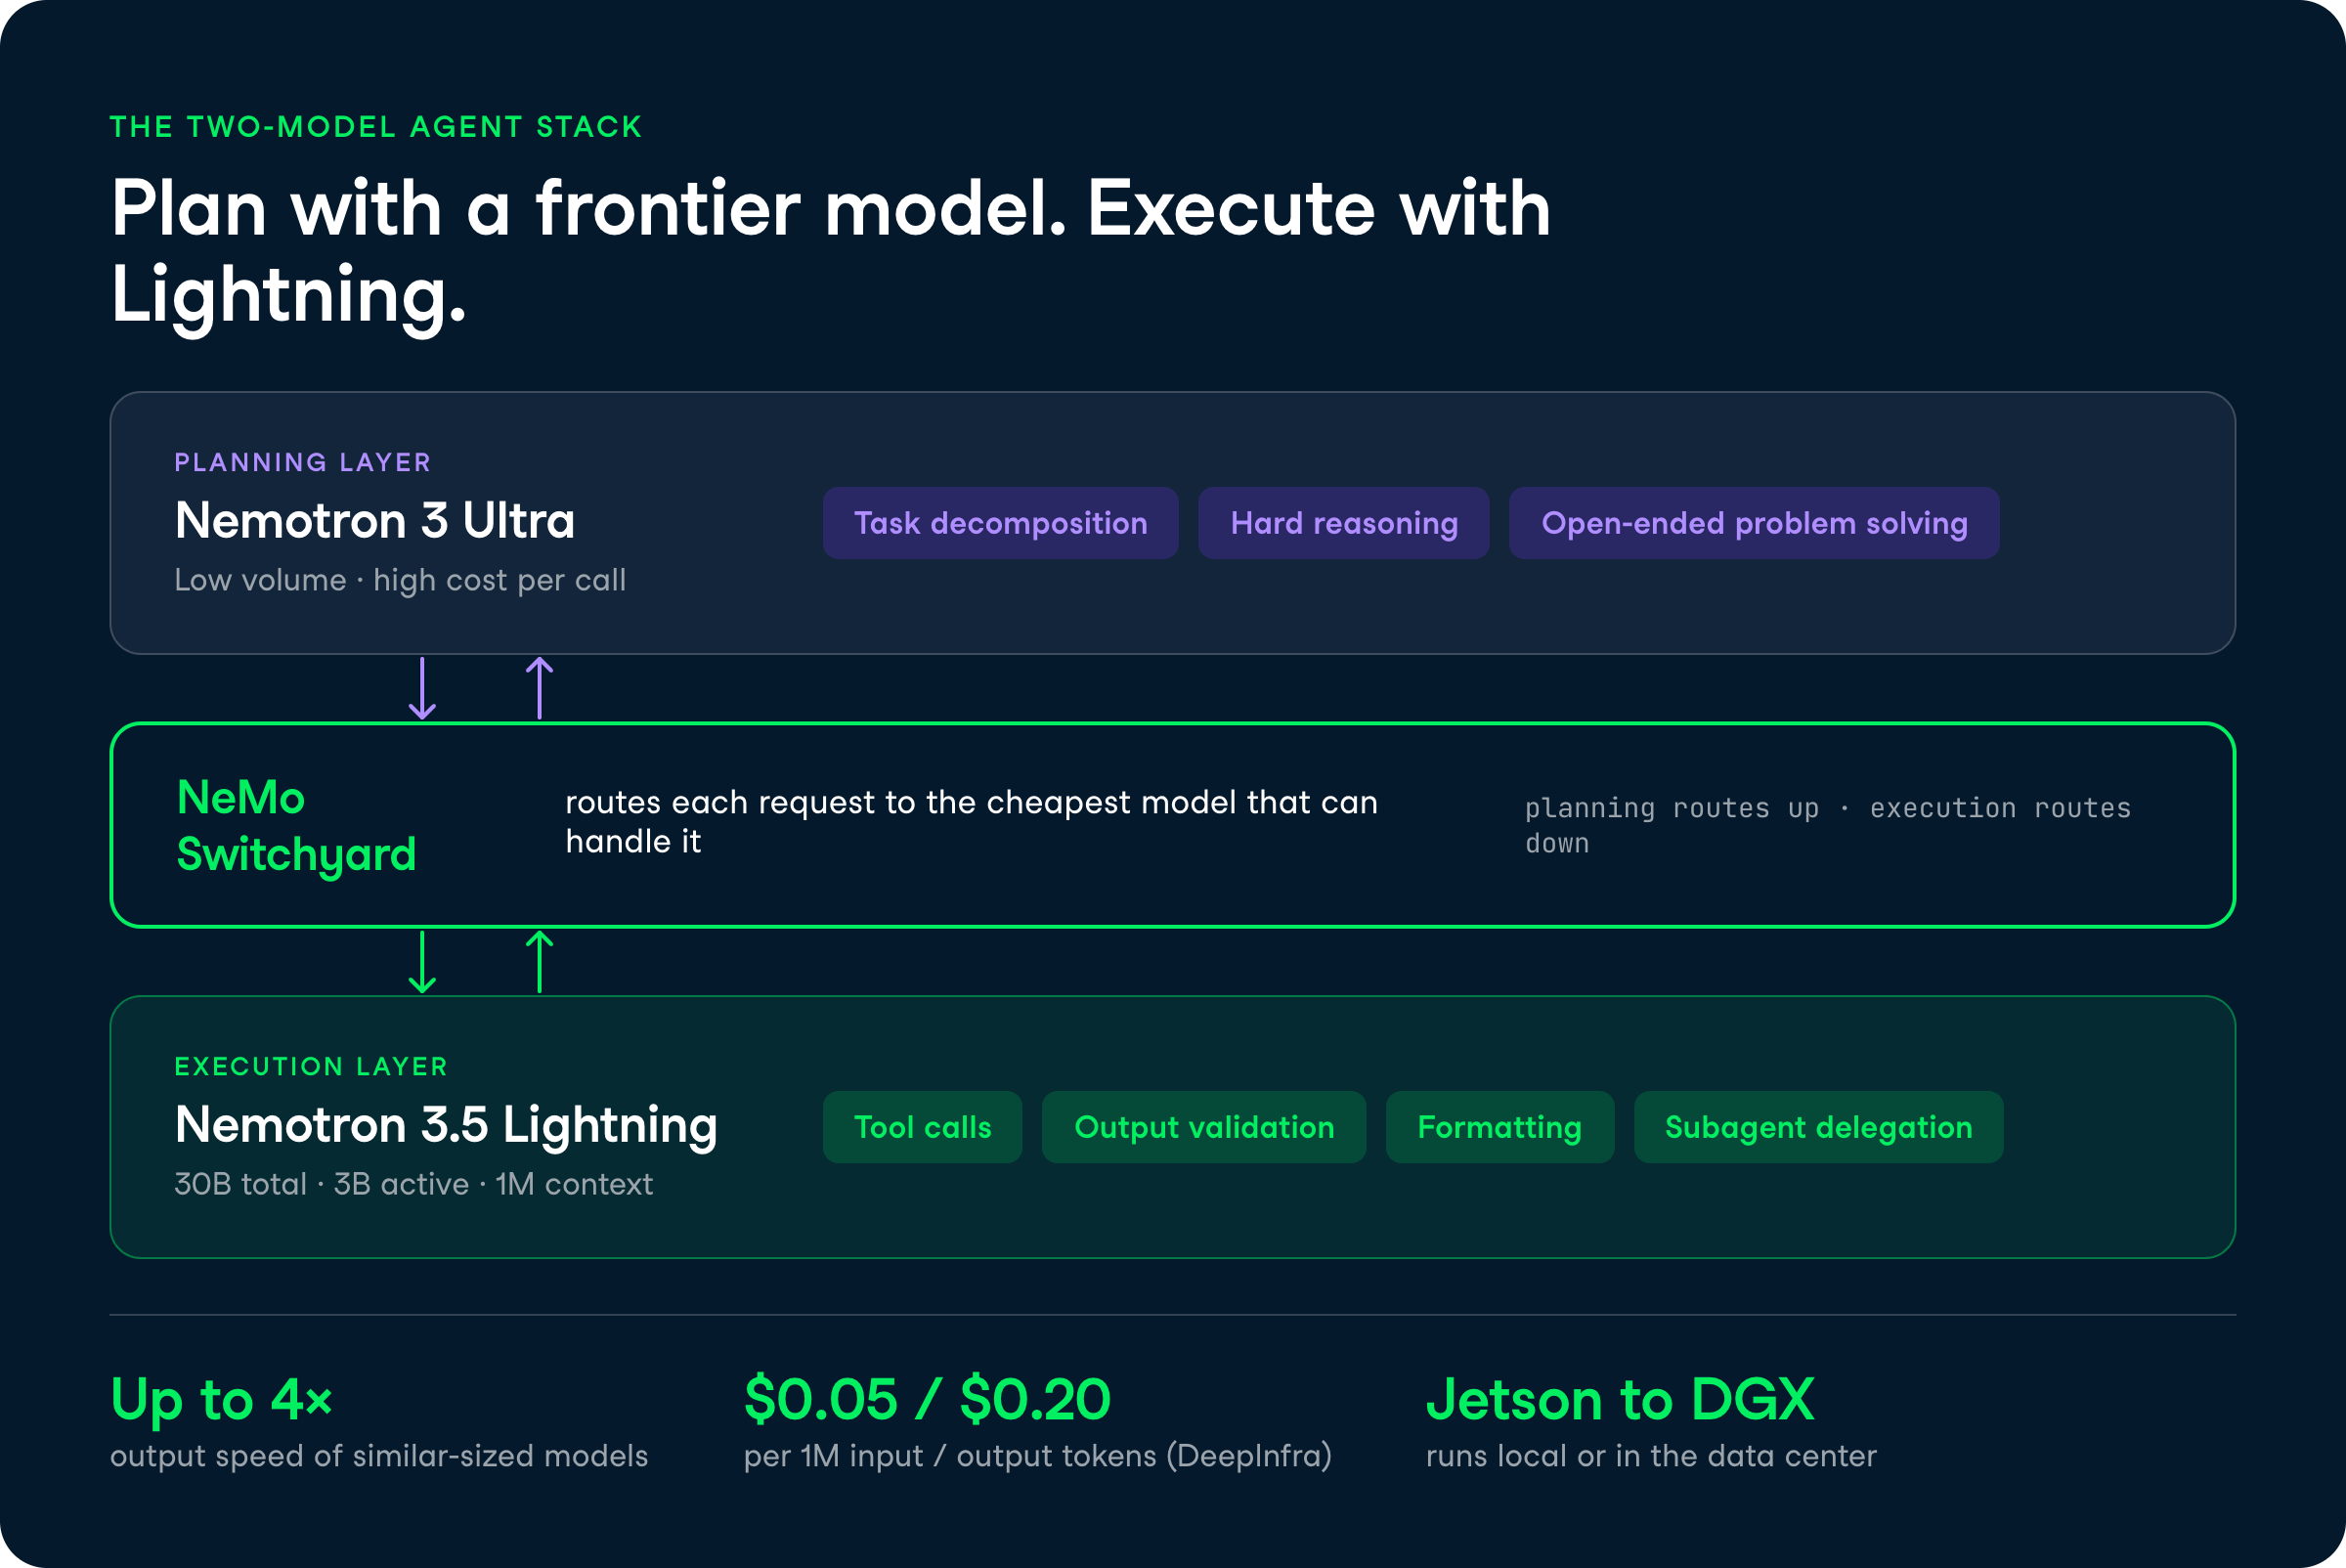
Semua fitur di sini melayani satu tujuan: menjalankan pekerjaan rutin sebuah agen dengan cepat tanpa membuat model jatuh pada aspek akurasi.
Berikut hal yang benar-benar bisa Anda lakukan dengannya.
Karena model ini cukup kecil untuk dipasang pada NVIDIA DGX Spark, GeForce RTX 5090, atau Jetson, Anda dapat menjalankan beban kerja agenik di desktop tanpa pusat data.
NVIDIA bekerja sama dengan EXO Labs untuk memprofilkan Lightning pada DGX Spark, dan melaporkan bahwa model ini berada pada Pareto frontier untuk model terbuka kecil pada leaderboard local.ai milik EXO Labs.
Bagi praktisi, ini berarti agen yang selalu aktif yang menangani pemanggilan alat dan validasi hasil dapat berjalan pada perangkat keras yang sudah Anda miliki.
Anda juga dapat menyajikannya melalui LM Studio, llama.cpp, Ollama, dan Unsloth, sehingga ekosistem alat lokalnya sudah matang sejak peluncuran.
NVIDIA merilis NeMo Switchyard bersamaan dengan model ini, sebuah pustaka yang mengarahkan setiap permintaan ke model paling efisien yang dapat menanganinya.
Switchyard mengekspos Nemotron 3.5 Lightning sebagai target perutean di samping model terbuka dan tertutup Anda, sehingga perencanaan diarahkan ke model frontier seperti Nemotron 3 Ultra sementara eksekusi diarahkan ke Lightning.
Dampak praktisnya adalah efisiensi token.
Alih-alih membayar tarif model frontier untuk menjalankan git pull, memvalidasi keluaran alat, atau memformat hasil, panggilan tersebut mendarat pada model murah, dan model mahal disisihkan untuk langkah perencanaan sulit yang menentukan kualitas namun bukan volume.
Model kecil lebih cepat, lebih murah, dan dapat di-fine-tune pada perangkat keras yang lebih sederhana dibanding model besar, dan Lightning dibangun untuk diadaptasi ke pekerjaan spesifik.
NVIDIA merilis bobot, data pelatihan, dan resep di bawah OpenMDW-1.1, dan Anda dapat melakukan fine-tuning dengan LoRA atau SFT penuh menggunakan NeMo Automodel dan NeMo Megatron Bridge, atau menjalankan reinforcement learning dengan NeMo RL dan NeMo Gym.
Rilis ini juga menyertakan Nemotron-RL Agentic Terminal Pivot, sebuah dataset RL agenik terbuka yang digunakan untuk melatih sebagian perilaku agen pengodean.
Ada satu klaim yang berorientasi komunitas yang menurut saya patut disorot di sini.
MindStudio melaporkan fine-tuning mitra selesai dalam waktu kurang dari 3 jam dengan biaya sekitar $100, yang merupakan biaya adaptasi yang hanya masuk akal dengan model berukuran seperti ini.
Lightning menghasilkan beberapa token per langkah melalui speculative decoding, di mana model draf mengusulkan token yang kemudian ditinjau secara efisien.
Model ini menjalani tahap prapelatihan khusus untuk membenamkan multi-token prediction (MTP) ke dalam model, diikuti fase peningkat MTP, pendekatan yang sama seperti pada Nemotron 3 Super dan Ultra.
Di luar MTP, NVIDIA menyediakan dua model draf.
DSpark direkomendasikan untuk DGX Spark dan beban kerja pusat data berkonkurensi rendah, sementara MTP cocok untuk konkurensi menengah hingga tinggi, dan model draf DFlash juga disediakan sehingga Anda dapat membandingkan mana yang paling sesuai untuk pola penyajian Anda.
NVIDIA melaporkan skor untuk checkpoint BF16 dan NVFP4, dan keduanya berjalan beriringan di sebagian besar tugas, yang penting karena NVFP4 adalah checkpoint terkuantisasi yang sebenarnya akan Anda terapkan. Angka di bawah ini berasal dari kartu model dan blog peluncuran NVIDIA sendiri. Belum tersedia reproduksi pihak ketiga independen saat penulisan, jadi perlakukan ini sebagai publikasi vendor.
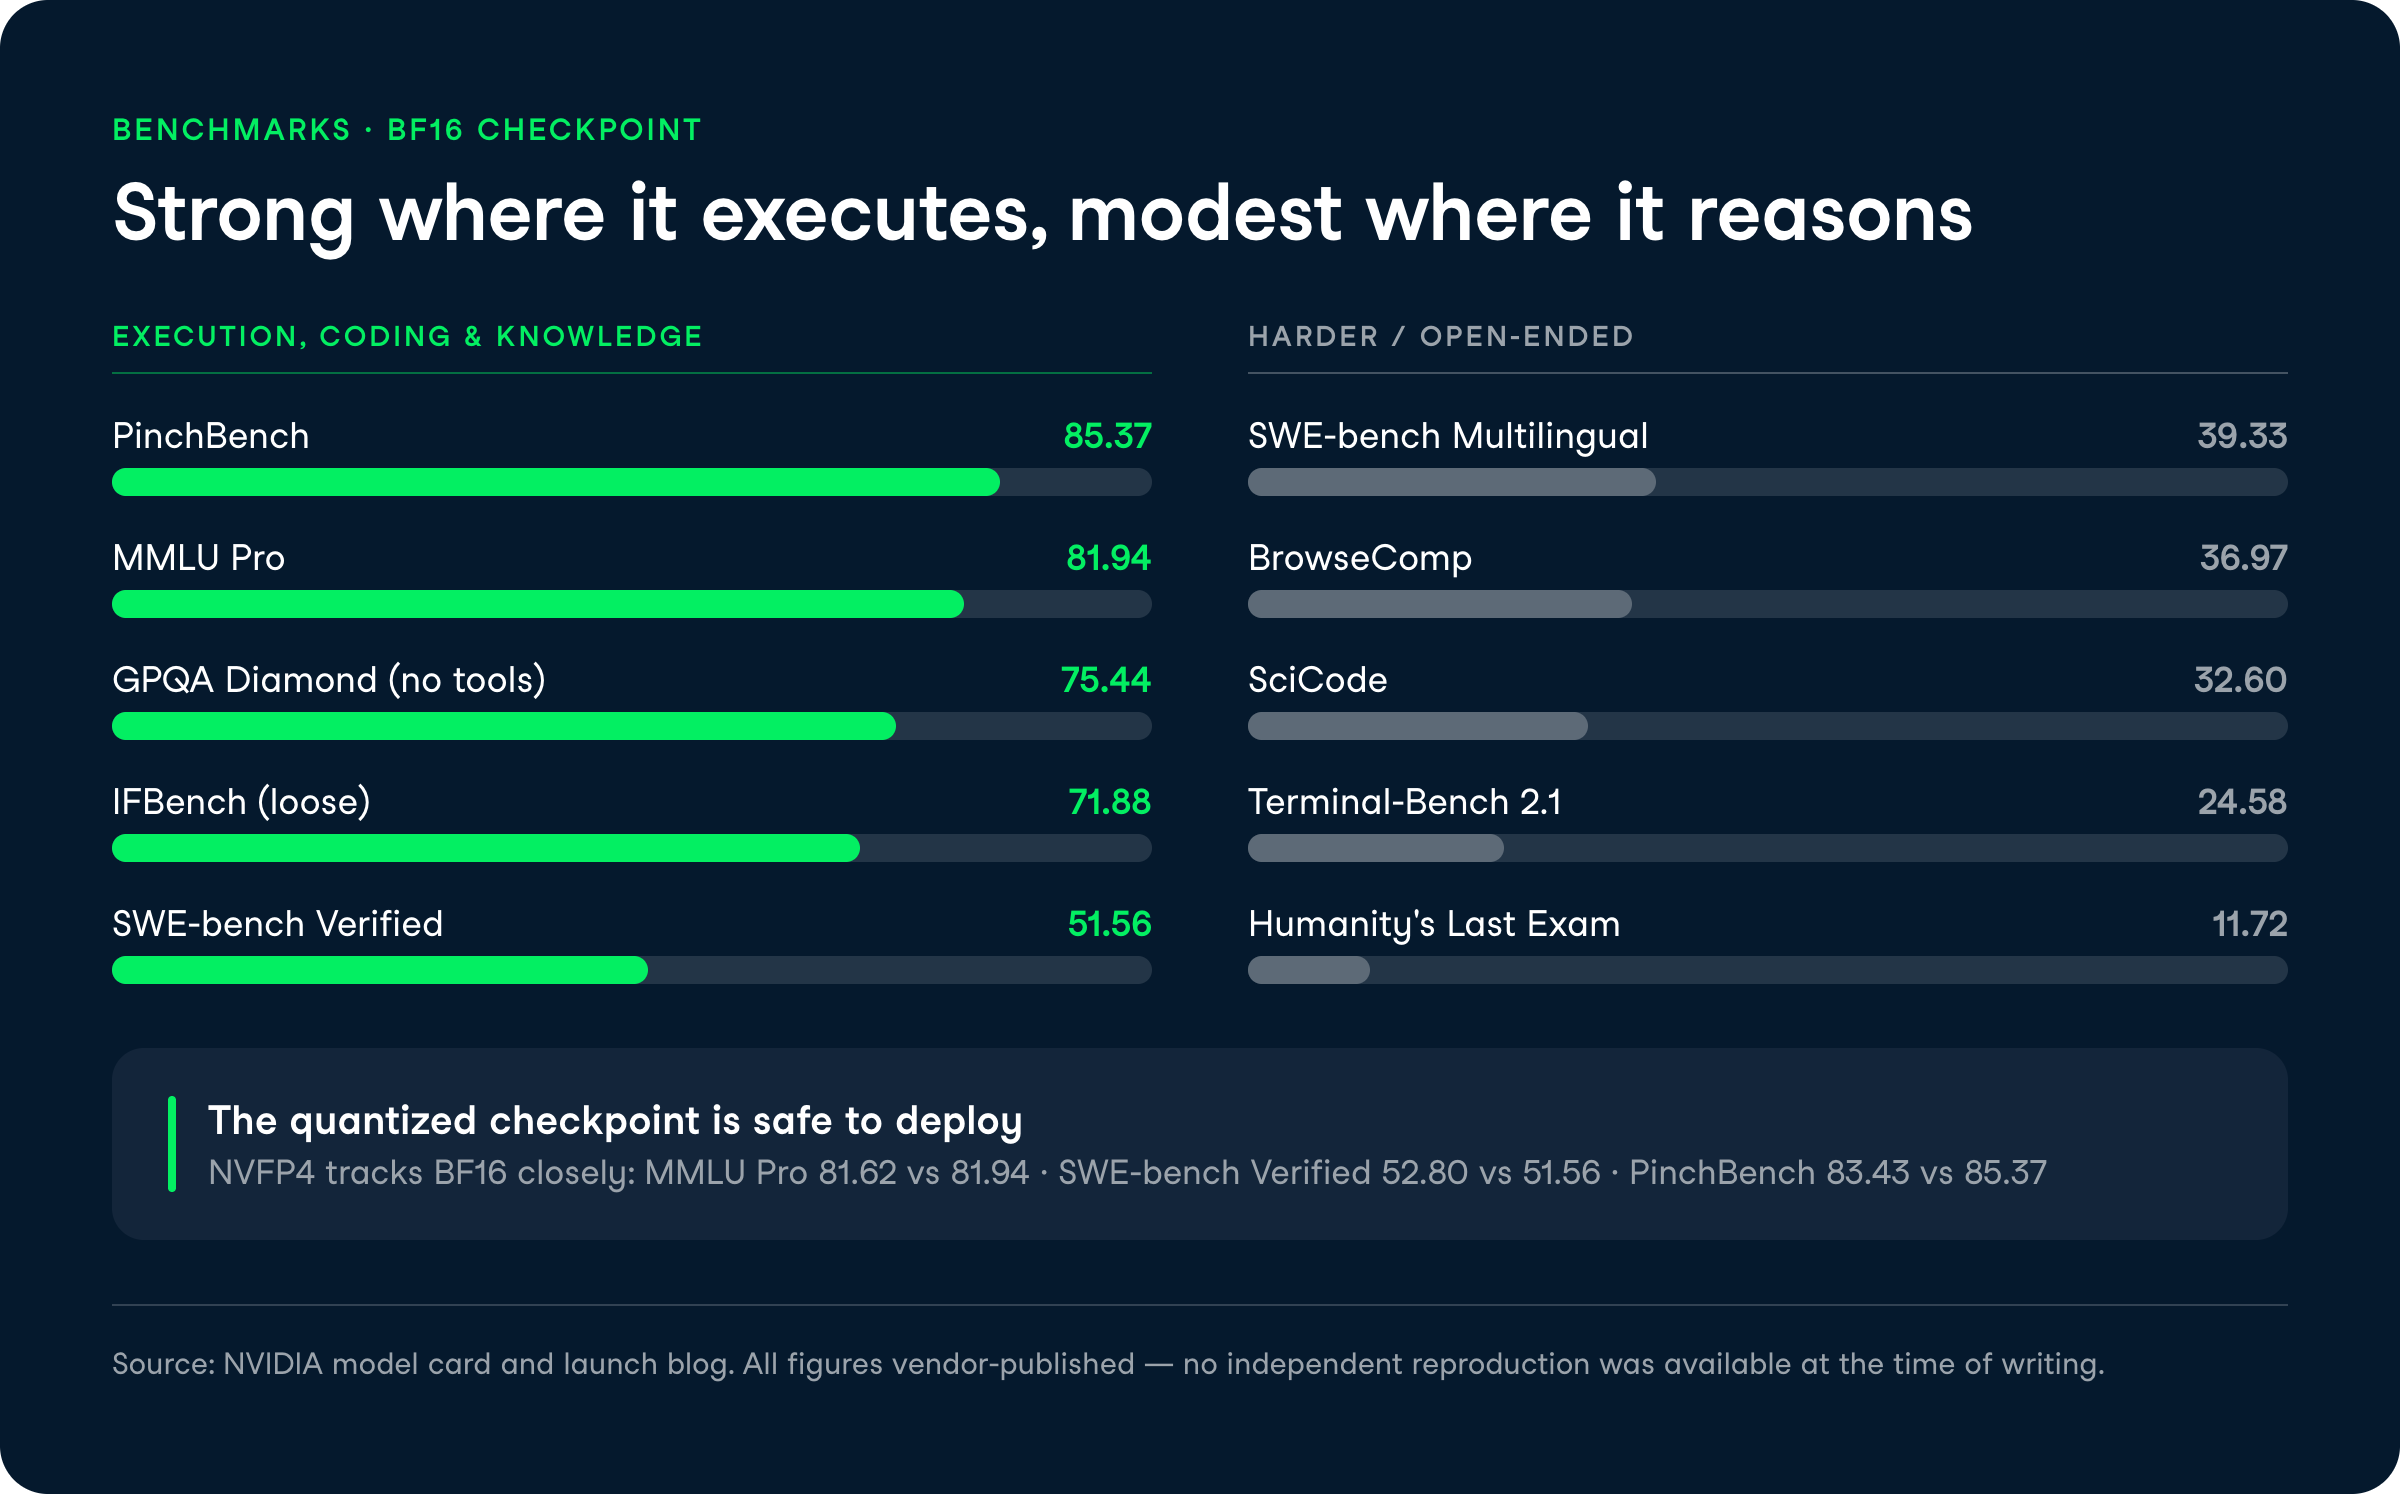
Lightning mencetak 51,56 (BF16) dan 52,80 (NVFP4) pada SWE-bench Verified, sebuah tolak ukur yang mengukur apakah model dapat menyelesaikan isu GitHub nyata dengan menghasilkan patch kode yang berfungsi. Untuk MoE 30B dengan 3B parameter aktif, menembus 50% pada ini adalah hasil solid dan langsung mendukung use case agen pengodean.
SWE-bench Multilingual lebih rendah di 39,33 (BF16), yang diharapkan mengingat sebaran basis kode multibahasa yang lebih sulit.
Pada PinchBench, Lightning mencapai 85,37 (BF16) dan 83,43 (NVFP4), dan OpenRouter melaporkan model ini menyelesaikan 10.000 tugas 30% lebih cepat daripada Qwen3.6-35B pada akurasi serupa.
Ini adalah tolak ukur yang paling menangkap proposisi model sebenarnya, karena efisiensi agen bermuara pada seberapa cepat model menyelesaikan pekerjaan yang berguna, bukan sekadar kecepatan generasi token mentah.
Perbandingan dengan Qwen3.6 patut dicermati. Saat kami meninjau Qwen3.6-35B-A3B, kami mencatat 3B parameter aktif dan kinerja SWE-bench serta Terminal-Bench yang kuat, jadi NVIDIA memilihnya sebagai titik acuan adalah pertarungan seimbang pada kelas ukuran yang sama.
Lightning mencetak 75,44 (BF16) pada GPQA Diamond tanpa alat, sekumpulan pertanyaan sains setingkat pascasarjana yang dirancang sulit bagi non-ahli bahkan dengan akses web.
Itu angka yang kuat untuk model kecil, meski kartu model secara eksplisit menyatakan bahwa Lightning tidak diposisikan sebagai mesin penalaran.
Humanity's Last Exam (hanya teks, tanpa alat) menunjukkan sisi lain cerita di 11,72 (BF16), dan SciCode berada di 32,60.
Skor yang lebih rendah ini konsisten dengan kerangka NVIDIA: ini adalah model eksekusi, dan penalaran terbuka yang sulit dimaksudkan untuk diarahkan ke model frontier.
Terminal-Bench 2.1 berada di 24,58 (BF16) dan BrowseComp di 36,97, sementara IFBench (longgar) mencapai 71,88, menunjukkan model ini mengikuti instruksi terstruktur dengan andal.
Pengetahuan umum juga terjaga, dengan MMLU Pro di 81,94 (BF16) dan 81,62 (NVFP4), selisih yang dapat diabaikan yang menegaskan checkpoint terkuantisasi aman untuk diterapkan.
Keduanya adalah model MoE dengan 3B parameter aktif yang ditujukan untuk beban kerja pengodean dan agenik, jadi perbandingan berdampingan adalah cara paling jelas untuk melihat posisi Lightning.
| Atribut | Nemotron 3.5 Lightning | Qwen3.6-35B-A3B |
|---|---|---|
| Total / parameter aktif | 30B / 3B | 35B / 3B |
| Jendela konteks | Hingga 1M token | 262K token |
| SWE-bench Verified | 51,56 (BF16) | Kuat (menurut ulasan kami) |
| Lisensi | OpenMDW-1.1 (terbuka) | Terbuka |
| Posisioning | Lapisan eksekusi agen | Pengodean, penalaran, konteks panjang |
Anda dapat mencoba Nemotron 3.5 Lightning di build.nvidia.com atau melalui OpenRouter, dan mengunduh bobotnya dari Hugging Face dan ModelScope. Model ini mengekspos endpoint yang kompatibel dengan OpenAI melalui NVIDIA NIM, termasuk /v1/chat/completions, /v1/completions, dan /v1/responses, sehingga dapat langsung masuk ke pipeline agenik yang sudah ada tanpa penulisan ulang.
Harga hosted bervariasi menurut penyedia:
Batas OpenRouter itu patut dicatat. Panjang konteks 1M adalah kemampuan model, tetapi batas praktis yang Anda dapatkan bergantung pada penyedia dan rutenya, jadi periksa endpoint sebelum berasumsi Anda memiliki jendela penuh.
Nemotron 3.5 Lightning adalah pertaruhan spesifik dari NVIDIA: bahwa masa depan agen produksi adalah sistem model, di mana model eksekusi murah menangani volume dan model frontier menangani perencanaan. Merilis NeMo Switchyard pada peluncuran yang sama adalah petunjuknya, karena model ini hanya masuk akal jika Anda dapat merutekan pekerjaan kepadanya secara cerdas.
Yang paling berguna bagi saya adalah kejujuran tentang cakupan. NVIDIA tidak berpura-pura ini adalah model penalaran, dan tolak ukurnya mendukung itu: kuat pada SWE-bench Verified (51,56) dan PinchBench (85,37), moderat pada Humanity's Last Exam (11,72). Jika beban kerja Anda adalah pemanggilan alat, validasi, dan pemformatan pada agen yang selalu aktif, pertukaran itu memang tepat.
Rilis terbuka di bawah OpenMDW-1.1 dengan bobot, data, dan resep, ditambah checkpoint yang cukup kecil untuk berjalan di DGX Spark, membuat ini benar-benar berguna bagi tim yang ingin melakukan fine-tuning dan self-host alih-alih membayar per token. Satu catatan utama adalah semua angka tolak ukur saat ini dipublikasikan vendor, jadi saya ingin reproduksi independen sebelum menganggap klaim 4x kecepatan dan 30% penyelesaian lebih cepat sebagai hal yang final.
Jika Anda ingin membangun keterampilan fine-tuning untuk mengadaptasi model seperti ini ke beban kerja Anda sendiri, tutorial kami tentang fine-tuning Qwen3.6 pada dataset tanya jawab medis membahas alur kerja QLoRA pada model MoE yang sebanding langkah demi langkah.
Kursus DataCamp Teratas
Program
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt



