
Last chance! 50% off DataCamp Premium
Sale ends in
La maggior parte delle conversazioni sull’AI agentica si concentra sui modelli di ragionamento di frontiera che fanno la pianificazione.
La tesi di NVIDIA con Nemotron 3.5 Lightning è che il modello di frontiera sia lo strumento sbagliato per gran parte di ciò che un agente fa davvero.
Gli agenti di lunga durata consumano la maggior parte del budget di token in chiamate a strumenti, validazione degli output e delega a sottoagenti, e far girare un modello di frontiera per ognuno di questi passaggi è costoso e lento.
Nemotron 3.5 Lightning, rilasciato l’11 agosto 2026, è un modello open mixture-of-experts (MoE) da 30B con 3B di parametri attivi, pensato precisamente per quello strato di esecuzione.
NVIDIA sostiene di collocarsi sulla frontiera di Pareto accuratezza-velocità nell’Artificial Analysis Intelligence Index e riporta fino a 4x di velocità di output rispetto a modelli di dimensioni simili. È distribuito con licenza permissiva OpenMDW-1.1, con pesi, dati di training e ricette pubblicati.
In questo articolo vedremo tutte le novità di Nemotron 3.5 Lightning, passando in rassegna funzionalità e benchmark. Se vuoi capire come si comporta in pratica un MoE di dimensioni simili, il nostro tutorial su fine-tuning di Qwen3.6 su un dataset di Q&A medico illustra il flusso di lavoro end-to-end.
Nemotron 3.5 Lightning è il membro più piccolo della famiglia open Nemotron 3 di NVIDIA, progettato specificamente per un’esecuzione ad alto volume e bassa latenza negli agenti autonomi.
Utilizza un’architettura ibrida Mamba-2 + MoE + attention con 30B di parametri totali e 3B attivi per token, e supporta una lunghezza di contesto fino a 1M token.
Il design MoE è ciò che lo rende veloce.
Un router invia ogni token solo ad alcuni dei suoi molti esperti, così per token gira solo una frazione dei parametri.
Ottieni la capacità di un modello denso più grande al costo computazionale di uno piccolo, lo stesso trade-off che fa Qwen3.6-35B-A3B con i suoi 3B di parametri attivi.
La grande affermazione di NVIDIA è più posizionale che un singolo punteggio: sull’Artificial Analysis Intelligence Index, che combina 9 valutazioni tra task agentici, coding, ragionamento scientifico e intelligenza generale, Lightning si colloca sulla frontiera di Pareto accuratezza-velocità tra i piccoli modelli open.
In parole semplici, nulla nella sua classe dimensionale è allo stesso tempo più accurato e più veloce.
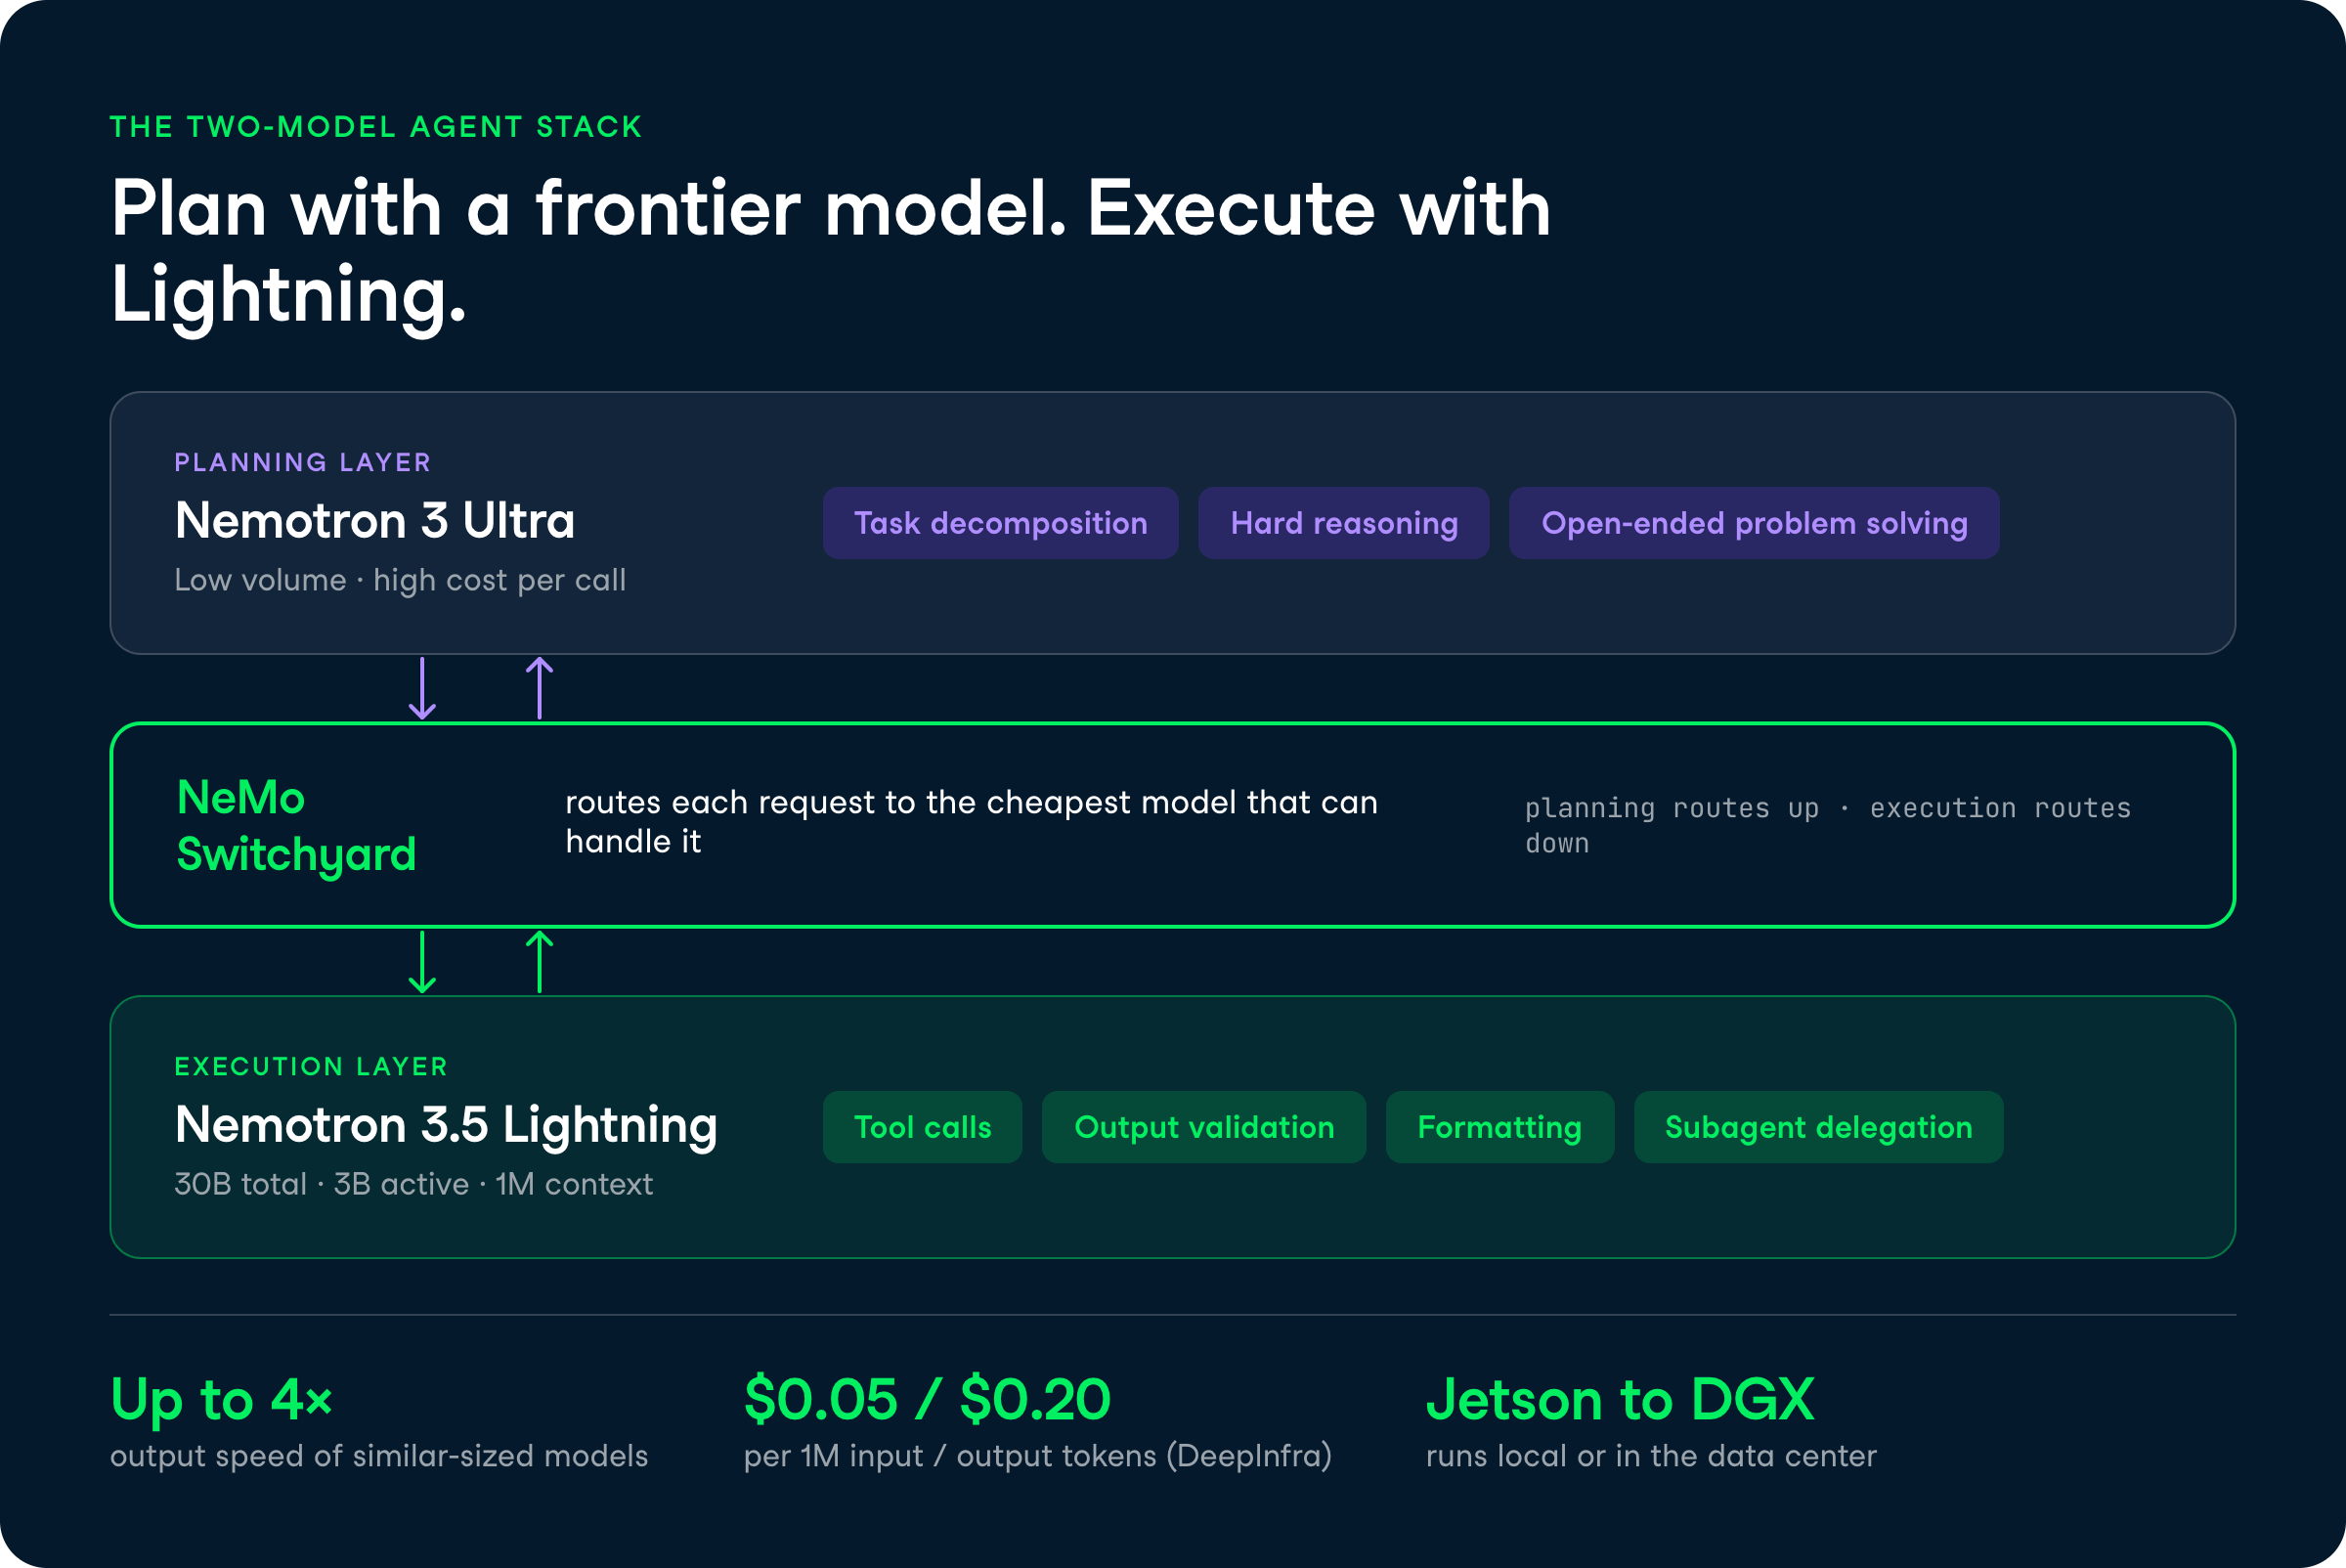
Tutte le funzionalità puntano a un obiettivo: eseguire rapidamente il lavoro di routine di un agente senza compromettere l’accuratezza.
Ecco cosa puoi farci concretamente.
Poiché il modello è abbastanza piccolo da essere distribuito su NVIDIA DGX Spark, GeForce RTX 5090 o Jetson, puoi eseguire workload agentici su un desktop senza un data center.
NVIDIA ha collaborato con EXO Labs per profilare Lightning su DGX Spark e riporta che si colloca sulla frontiera di Pareto per i piccoli modelli open nella leaderboard local.ai di EXO Labs.
Per i professionisti, questo significa che un agente always-on che gestisce chiamate a strumenti e validazione dei risultati può girare sull’hardware che possiedi già.
Puoi anche servirlo tramite LM Studio, llama.cpp, Ollama e Unsloth, quindi l’ecosistema di tool locali è già maturo al lancio.
NVIDIA rilascia NeMo Switchyard insieme al modello, una libreria che instrada ogni richiesta al modello più efficiente in grado di gestirla.
Switchyard espone Nemotron 3.5 Lightning come target di routing accanto ai tuoi modelli open e closed, così la pianificazione sale a un modello di frontiera come Nemotron 3 Ultra mentre l’esecuzione scende su Lightning.
Il vantaggio pratico è l’efficienza in token.
Invece di pagare tariffe da modello di frontiera per eseguire un git pull, validare l’output di uno strumento o formattare un risultato, quelle chiamate finiscono sul modello economico, e quello costoso è riservato ai passaggi di pianificazione difficili che incidono sulla qualità ma non sul volume.
I modelli piccoli si fine-tunano più velocemente, a costi inferiori e su hardware più modesto rispetto a quelli grandi, e Lightning è costruito per essere adattato a un compito specifico.
NVIDIA ha rilasciato pesi, dati di training e ricette sotto OpenMDW-1.1, e puoi fare fine-tuning con LoRA o SFT completo usando NeMo Automodel e NeMo Megatron Bridge, oppure eseguire reinforcement learning con NeMo RL e NeMo Gym.
Il rilascio include anche Nemotron-RL Agentic Terminal Pivot, un dataset RL agentico open usato per addestrare parte del comportamento da coding agent.
C’è un punto per la community che vale la pena evidenziare.
MindStudio riporta fine-tuning di partner completati in meno di 3 ore per circa 100 $, un costo di adattamento che ha senso solo con un modello di queste dimensioni.
Lightning genera più token per step tramite decodifica speculativa, dove un modello di bozza propone token che vengono poi verificati in modo efficiente.
Ha seguito una fase di pretraining dedicata per integrare la multi-token prediction (MTP) nel modello, seguita da una fase di potenziamento MTP, lo stesso approccio usato in Nemotron 3 Super e Ultra.
Oltre all’MTP, NVIDIA fornisce due modelli di bozza.
DSpark è consigliato per DGX Spark e carichi a bassa concorrenza in data center, mentre MTP è adatto a concorrenza media-alta, e viene fornito anche un modello di bozza DFlash così puoi benchmarkare quale si comporta meglio per il tuo pattern di serving.
NVIDIA riporta punteggi sia per i checkpoint BF16 sia per NVFP4, e i due si allineano strettamente nella maggior parte dei task, il che conta perché NVFP4 è il checkpoint quantizzato che effettivamente distribuisci. I numeri sotto provengono dalla model card e dal blog di lancio di NVIDIA. Non erano disponibili riproduzioni indipendenti di terze parti al momento della stesura, quindi trattali come dati del vendor.
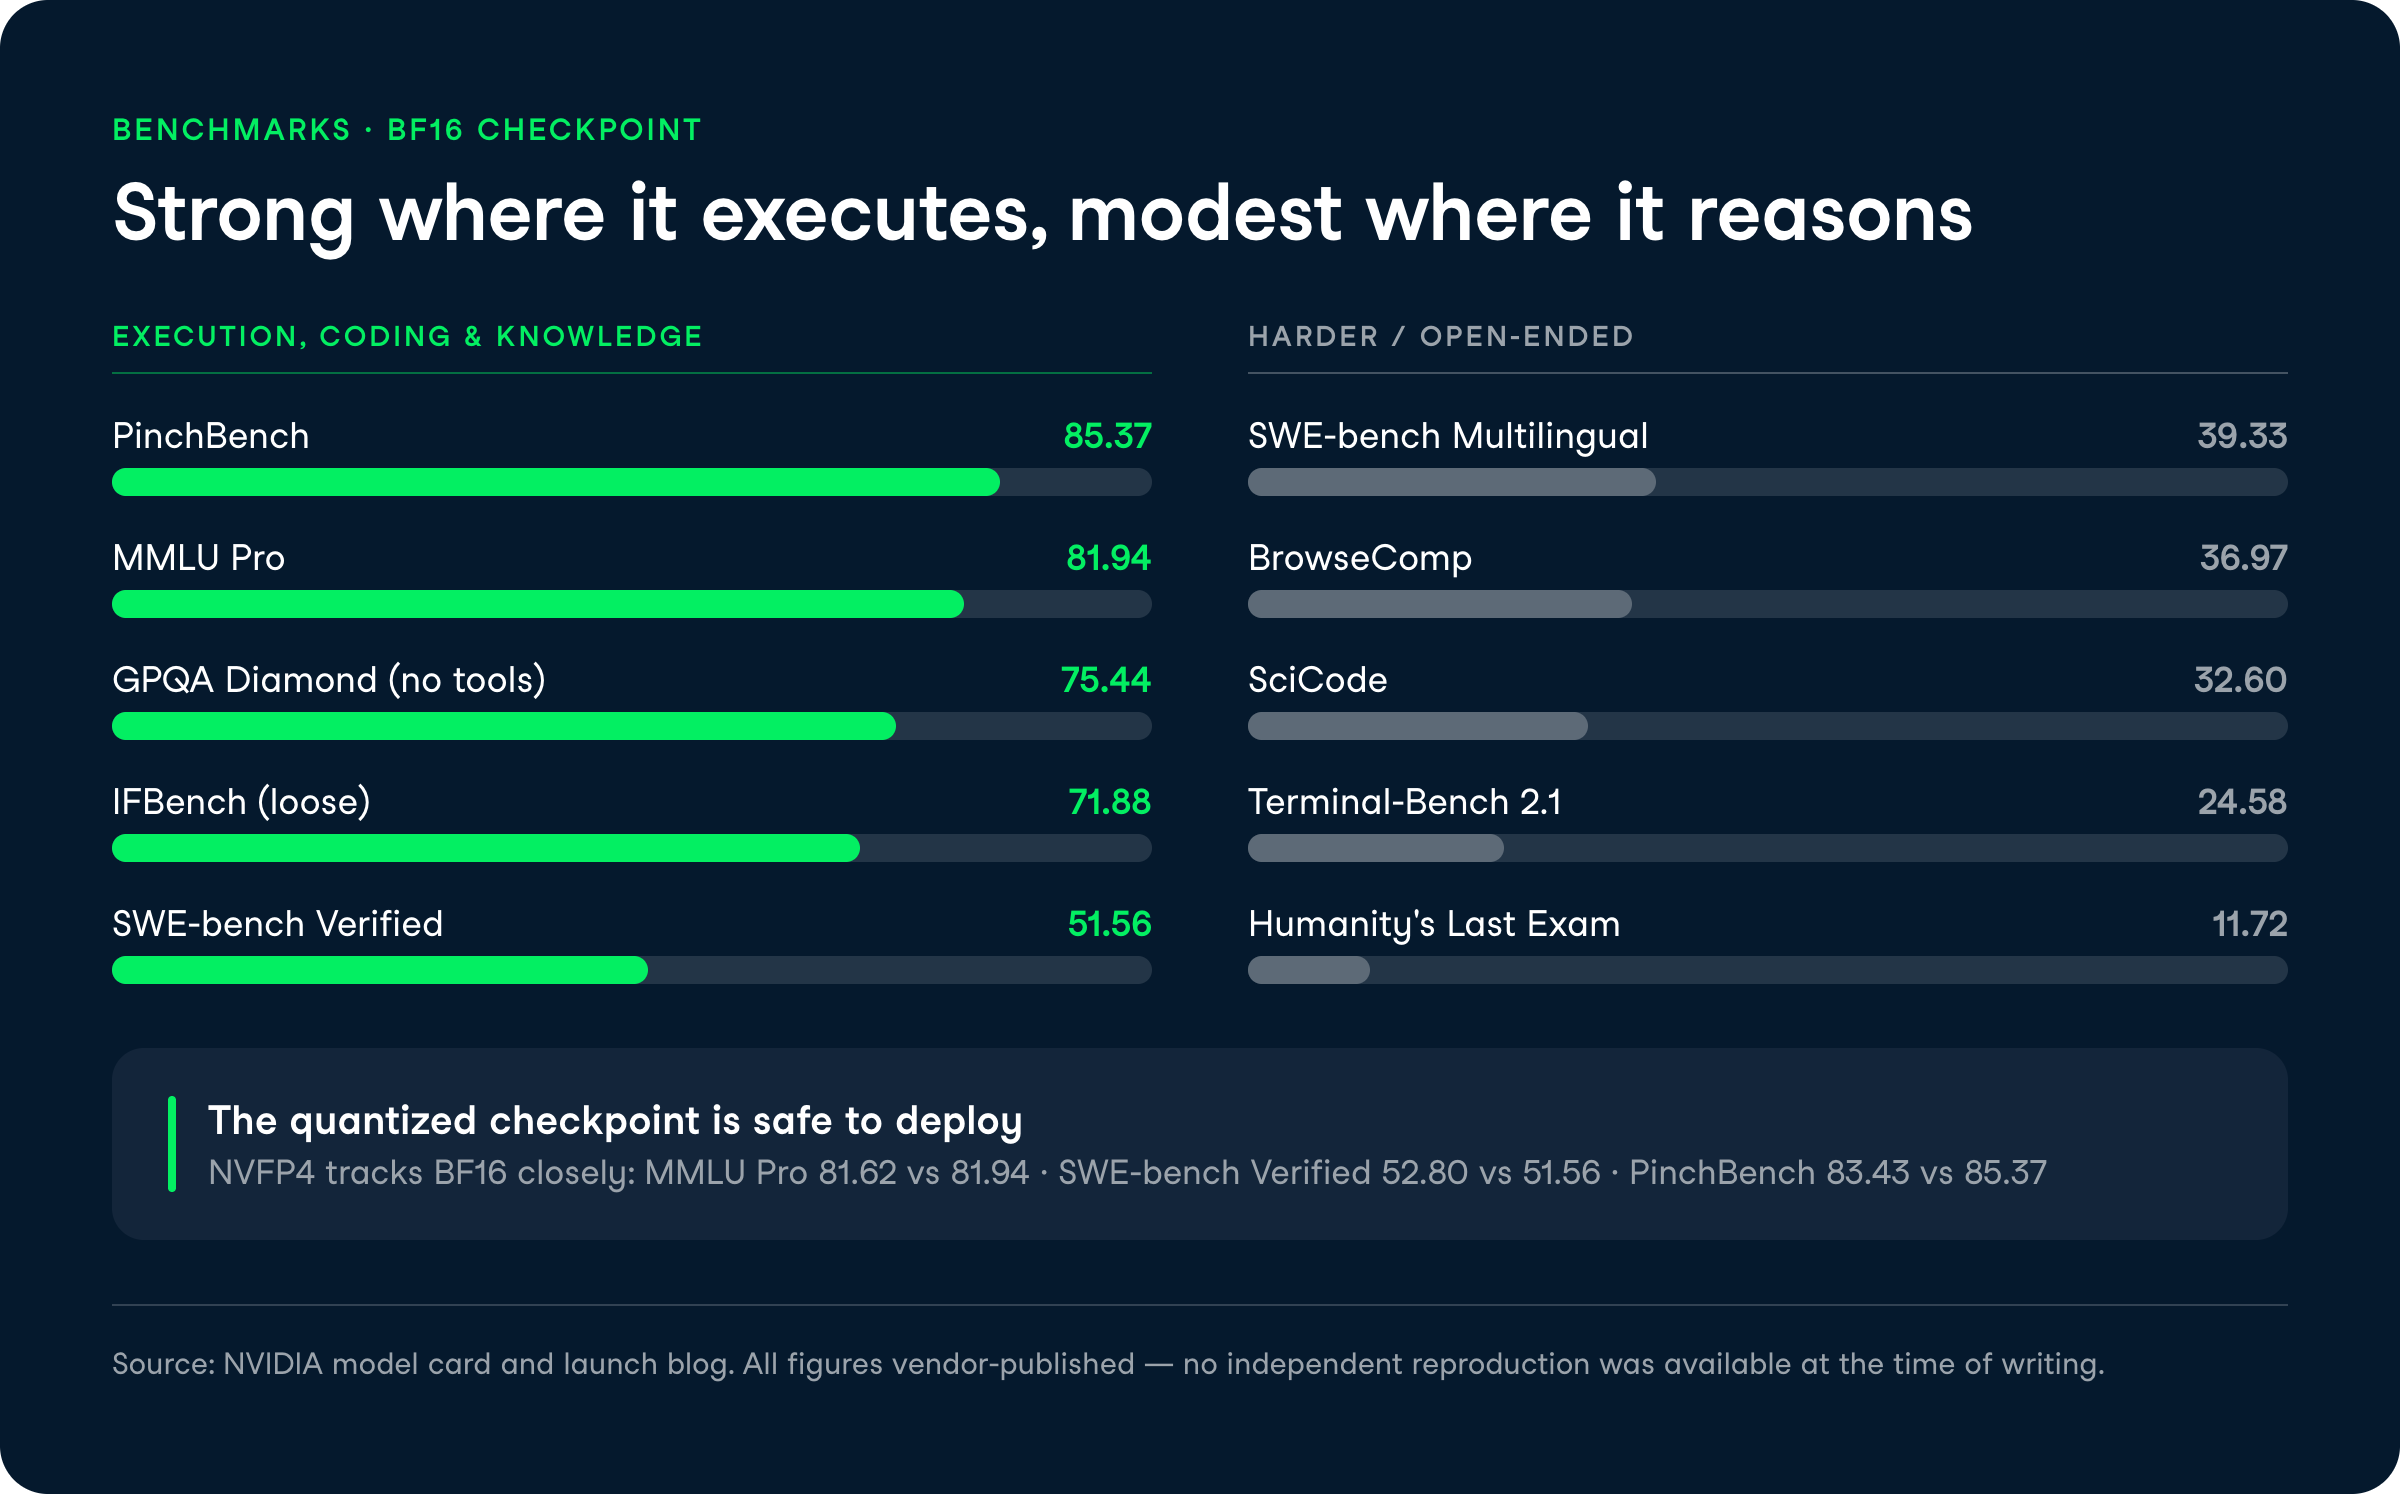
Lightning totalizza 51,56 (BF16) e 52,80 (NVFP4) su SWE-bench Verified, un benchmark che misura se un modello riesce a risolvere reali issue GitHub producendo una patch di codice funzionante. Per un 30B MoE con 3B di parametri attivi, superare il 50% è un risultato solido e supporta direttamente l’uso come coding agent.
SWE-bench Multilingual è più basso a 39,33 (BF16), come previsto dato il set multilingue più difficile.
Su PinchBench, Lightning raggiunge 85,37 (BF16) e 83,43 (NVFP4), e OpenRouter riporta che completa 10.000 task il 30% più velocemente di Qwen3.6-35B con accuratezza simile.
È il benchmark che coglie meglio il posizionamento del modello, dato che l’efficienza dell’agente dipende da quanto velocemente un modello porta a termine lavoro utile, non dalla mera velocità di generazione token.
Il confronto con Qwen3.6 merita attenzione. Quando abbiamo recensito Qwen3.6-35B-A3B, abbiamo sottolineato i suoi 3B di parametri attivi e le buone prestazioni su SWE-bench e Terminal-Bench, quindi la scelta di NVIDIA come riferimento è un confronto alla pari nella stessa classe dimensionale.
Lightning totalizza 75,44 (BF16) su GPQA Diamond senza strumenti, un set di domande scientifiche a livello graduate progettate per essere difficili anche con accesso al web.
È un numero forte per un modello piccolo, anche se la model card è chiara: Lightning non è posizionato come motore di ragionamento.
Humanity’s Last Exam (solo testo, senza strumenti) racconta l’altro lato con 11,72 (BF16), e SciCode si attesta a 32,60.
Questi punteggi più bassi sono coerenti con l’impostazione di NVIDIA: questo è un modello di esecuzione, e il ragionamento aperto e complesso va instradato a un modello di frontiera.
Terminal-Bench 2.1 raggiunge 24,58 (BF16) e BrowseComp 36,97, mentre IFBench (loose) arriva a 71,88, a indicare che il modello segue in modo affidabile istruzioni strutturate.
La conoscenza generale tiene bene, con MMLU Pro a 81,94 (BF16) e 81,62 (NVFP4), un divario trascurabile che conferma che il checkpoint quantizzato è sicuro da distribuire.
Entrambi sono modelli MoE con 3B di parametri attivi destinati a workload di coding e agentici, quindi un confronto fianco a fianco è il modo più pulito per capire dove si colloca Lightning.
| Attributo | Nemotron 3.5 Lightning | Qwen3.6-35B-A3B |
|---|---|---|
| Parametri totali / attivi | 30B / 3B | 35B / 3B |
| Finestra di contesto | Fino a 1M token | 262K token |
| SWE-bench Verified | 51,56 (BF16) | Forte (secondo la nostra review) |
| Licenza | OpenMDW-1.1 (open) | Open |
| Posizionamento | Strato di esecuzione degli agenti | Coding, ragionamento, contesto lungo |
Puoi provare Nemotron 3.5 Lightning su build.nvidia.com o tramite OpenRouter, e scaricare i pesi da Hugging Face e ModelScope. Il modello espone endpoint compatibili con OpenAI via NVIDIA NIM, inclusi /v1/chat/completions, /v1/completions e /v1/responses, così si integra nelle pipeline agentiche esistenti senza riscritture.
I prezzi in hosting variano in base al provider:
Vale la pena evidenziare quel limite di OpenRouter. La lunghezza di contesto da 1M è una capacità del modello, ma il limite pratico dipende dal provider e dalla route, quindi verifica l’endpoint prima di dare per scontata la finestra completa.
Nemotron 3.5 Lightning rappresenta una scommessa precisa di NVIDIA: il futuro degli agenti in produzione è un sistema di modelli, dove un modello di esecuzione economico gestisce il volume e un modello di frontiera fa la pianificazione. Il rilascio di NeMo Switchyard nello stesso lancio è indicativo, perché il modello ha senso solo se riesci a instradargli il lavoro in modo intelligente.
Trovo utile soprattutto la chiarezza sul perimetro. NVIDIA non finge che questo sia un modello di ragionamento, e i benchmark lo confermano: forte su SWE-bench Verified (51,56) e PinchBench (85,37), modesto su Humanity’s Last Exam (11,72). Se il tuo workload è fatto di chiamate a strumenti, validazione e formattazione su agenti always-on, questo trade-off è quello giusto.
Il rilascio open sotto OpenMDW-1.1 con pesi, dati e ricette, più un checkpoint abbastanza piccolo da girare su un DGX Spark, lo rende davvero utile per i team che vogliono fare fine-tuning e self-hosting invece di pagare a token. La principale avvertenza è che tutti i benchmark attuali sono pubblicati dal vendor, quindi vorrei riproduzioni indipendenti prima di considerare assodati i claim di 4x velocità e 30% di completamenti più rapidi.
Se vuoi costruire le competenze di fine-tuning per adattare un modello come questo al tuo workload, il nostro tutorial su fine-tuning di Qwen3.6 su un dataset di Q&A medico copre passo passo il workflow QLoRA su un MoE comparabile.
I migliori corsi DataCamp
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min




