Phần lớn cuộc thảo luận về AI mang tính agent tập trung vào các mô hình suy luận tuyến đầu đảm nhiệm hoạch định.
Lập luận của NVIDIA với Nemotron 3.5 Lightning là mô hình tuyến đầu không phải công cụ phù hợp cho phần lớn những gì một agent thực sự làm.
Các agent chạy dài tiêu tốn phần lớn ngân sách token vào gọi công cụ, kiểm định đầu ra và ủy quyền cho các subagent, và việc chạy mô hình tuyến đầu cho mọi bước như vậy vừa tốn kém vừa chậm.
Nemotron 3.5 Lightning, phát hành ngày 11 tháng 8 năm 2026, là mô hình mixture-of-experts (MoE) 30B mở với 3B tham số hoạt động, nhắm trực diện vào lớp thực thi đó.
NVIDIA cho biết mô hình đạt vị trí biên Pareto về độ chính xác so với tốc độ trên Artificial Analysis Intelligence Index, và báo cáo tốc độ sinh đầu ra nhanh hơn tới 4 lần so với các mô hình cùng cỡ. Mô hình phát hành theo giấy phép OpenMDW-1.1 thoáng với trọng số, dữ liệu huấn luyện và quy trình kèm theo.
Trong bài viết này, tôi sẽ điểm qua mọi điểm mới của Nemotron 3.5 Lightning, xem xét tính năng và khám phá các điểm chuẩn. Nếu bạn muốn xem mô hình MoE cùng cỡ hoạt động thực tế ra sao, hướng dẫn của chúng tôi về fine-tune Qwen3.6 trên tập dữ liệu Hỏi & Đáp y khoa sẽ dẫn bạn qua toàn bộ quy trình.
Nemotron 3.5 Lightning tóm lược
- Nemotron 3.5 Lightning là mô hình MoE 30B mở với 3B tham số hoạt động, phát hành ngày 11/08/2026, được xây dựng cho lớp thực thi khối lượng lớn của các agent luôn bật.
- NVIDIA cho biết tốc độ sinh đầu ra nhanh hơn tới 4 lần so với các mô hình cùng cỡ và hoàn thành 10.000 tác vụ nhanh hơn 30% so với Qwen3.6-35B ở độ chính xác tương đương.
- Các điểm chuẩn chính (BF16): SWE-bench Verified 51,56; PinchBench 85,37; GPQA Diamond 75,44; MMLU Pro 81,94.
- Phát hành theo OpenMDW-1.1 với trọng số, dữ liệu và quy trình; chạy được trên phần cứng từ Jetson đến DGX Spark tới trung tâm dữ liệu.
- NeMo Switchyard định tuyến công việc thực thi cho Lightning và hoạch định cho các mô hình tuyến đầu như Nemotron 3 Ultra.
Nemotron 3.5 Lightning là gì?
Nemotron 3.5 Lightning là thành viên nhỏ nhất trong họ mô hình mở Nemotron 3 của NVIDIA, được xây dựng riêng cho thực thi khối lượng lớn, độ trễ thấp trong các agent tự động.
Mô hình dùng kiến trúc lai Mamba-2 + MoE + attention với tổng 30B tham số và 3B tham số hoạt động mỗi token, hỗ trợ ngữ cảnh dài tới 1M token.
Thiết kế MoE chính là yếu tố khiến nó nhanh.
Một bộ định tuyến sẽ gửi mỗi token tới chỉ một vài chuyên gia trong số nhiều chuyên gia, nên chỉ một phần nhỏ tham số chạy trên mỗi token.
Bạn nhận được dung lượng của một mô hình dày lớn ở chi phí tính toán của mô hình nhỏ, giống phép đánh đổi mà Qwen3.6-35B-A3B thực hiện với 3B tham số hoạt động.
Tuyên bố lớn của NVIDIA mang tính vị thế hơn là một điểm số đơn lẻ: trên Artificial Analysis Intelligence Index, kết hợp 9 đánh giá về tác vụ agent, lập trình, suy luận khoa học và trí tuệ tổng quát, Lightning nằm trên biên Pareto độ chính xác-tốc độ cho các mô hình mở nhỏ.
Nói đơn giản, không có mô hình nào cùng hạng vừa chính xác hơn vừa nhanh hơn cùng lúc.
Điểm mới ở Nemotron 3.5 Lightning
Các tính năng đều phục vụ một mục tiêu: chạy công việc thường nhật của agent thật nhanh mà không đánh rơi độ chính xác.
Dưới đây là những gì bạn có thể làm thực tế.
Chạy agent mạnh trên phần cứng tại chỗ
Vì mô hình đủ nhỏ để triển khai trên NVIDIA DGX Spark, GeForce RTX 5090 hoặc Jetson, bạn có thể chạy tải công việc mang tính agent trên máy bàn mà không cần trung tâm dữ liệu.
NVIDIA hợp tác với EXO Labs để đo Lightning trên DGX Spark và cho biết mô hình nằm trên biên Pareto cho các mô hình mở nhỏ trên bảng xếp hạng local.ai của EXO Labs.
Với người làm thực hành, điều này có nghĩa một agent luôn bật đảm nhiệm gọi công cụ và kiểm định kết quả có thể chạy trên phần cứng bạn đã sở hữu.
Bạn cũng có thể phục vụ mô hình qua LM Studio, llama.cpp, Ollama và Unsloth, nên hệ công cụ cục bộ đã chín muồi ngay khi ra mắt.
Định tuyến thực thi xuống và hoạch định lên với NeMo Switchyard
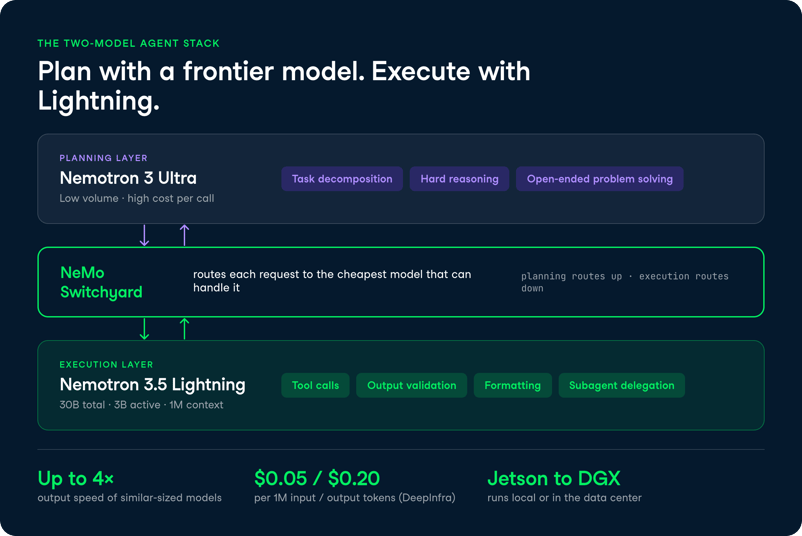
NVIDIA phát hành NeMo Switchyard cùng lúc với mô hình, một thư viện định tuyến mỗi yêu cầu tới mô hình hiệu quả nhất có thể xử lý nó.
Switchyard phơi bày Nemotron 3.5 Lightning như một đích định tuyến cạnh các mô hình mở và đóng của bạn, để hoạch định được định tuyến lên một mô hình tuyến đầu như Nemotron 3 Ultra trong khi thực thi được định tuyến xuống Lightning.
Lợi ích thực tế là hiệu suất token.
Thay vì trả mức giá mô hình tuyến đầu để chạy git pull, kiểm định đầu ra công cụ hoặc định dạng kết quả, những lời gọi đó sẽ rơi vào mô hình rẻ, còn mô hình đắt chỉ dành cho các bước hoạch định khó vốn quyết định chất lượng nhưng không chiếm đa số về khối lượng.
Tùy biến ngay từ đầu
Mô hình nhỏ fine-tune nhanh hơn, rẻ hơn và trên phần cứng khiêm tốn hơn so với mô hình lớn, và Lightning được thiết kế để thích ứng với công việc cụ thể.
NVIDIA phát hành trọng số, dữ liệu huấn luyện và quy trình theo OpenMDW-1.1, và bạn có thể fine-tune với LoRA hoặc SFT đầy đủ bằng NeMo Automodel và NeMo Megatron Bridge, hoặc chạy học tăng cường với NeMo RL và NeMo Gym.
Bản phát hành cũng bao gồm Nemotron-RL Agentic Terminal Pivot, một tập dữ liệu RL agent mở dùng để huấn luyện một phần hành vi agent lập trình.
Có một tuyên bố hướng tới cộng đồng mà tôi nghĩ đáng lưu ý ở đây.
MindStudio báo cáo việc fine-tune với đối tác hoàn tất trong chưa đầy 3 giờ với chi phí khoảng 100 đô, mức chi phí thích ứng chỉ hợp lý với mô hình cỡ này.
Giải mã suy đoán để tăng thông lượng
Lightning sinh nhiều token mỗi bước thông qua giải mã suy đoán, nơi một mô hình nháp đề xuất token và sau đó được rà soát hiệu quả.
Mô hình trải qua một giai đoạn tiền huấn luyện dành riêng để “nướng” dự đoán đa token (MTP) vào mô hình, tiếp theo là pha tăng cường MTP, cùng cách tiếp cận dùng trong Nemotron 3 Super và Ultra.
Ngoài MTP, NVIDIA cung cấp hai mô hình nháp.
DSpark được khuyến nghị cho DGX Spark và tải trung tâm dữ liệu độ đồng thời thấp, trong khi MTP phù hợp đồng thời trung bình tới cao; một mô hình nháp DFlash cũng được cung cấp để bạn benchmark xem mô hình nào phù hợp nhất với kiểu phục vụ của mình.
Điểm chuẩn Nemotron 3.5 Lightning
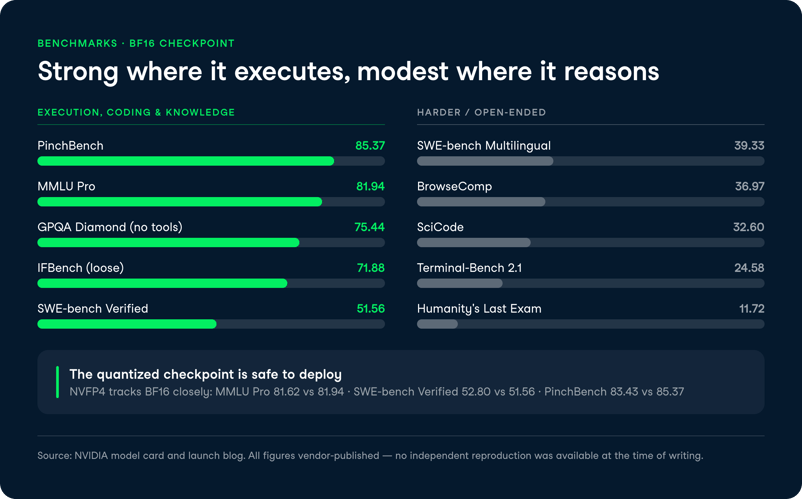
NVIDIA báo cáo điểm cho cả checkpoint BF16 và NVFP4, và hai loại này bám sát nhau trên hầu hết tác vụ, điều quan trọng vì NVFP4 là checkpoint đã lượng tử mà bạn thực sự sẽ triển khai. Các con số dưới đây lấy từ model card và blog ra mắt của chính NVIDIA. Chưa có tái hiện độc lập từ bên thứ ba tại thời điểm viết, nên hãy coi đây là số liệu do nhà cung cấp công bố.
SWE-bench Verified
Lightning đạt 51,56 (BF16) và 52,80 (NVFP4) trên SWE-bench Verified, một điểm chuẩn đo lường liệu mô hình có thể giải quyết issue GitHub thực bằng cách tạo bản vá mã hoạt động hay không. Với MoE 30B có 3B tham số hoạt động, vượt 50% ở bài này là kết quả vững và trực tiếp hỗ trợ bài toán agent lập trình.
SWE-bench Multilingual thấp hơn ở mức 39,33 (BF16), điều dễ hiểu do phạm vi đa ngôn ngữ khó hơn của codebase.
PinchBench và hiệu suất tác vụ
Trên PinchBench, Lightning đạt 85,37 (BF16) và 83,43 (NVFP4), và OpenRouter cho biết mô hình hoàn thành 10.000 tác vụ nhanh hơn 30% so với Qwen3.6-35B ở độ chính xác tương đương.
Đây là điểm chuẩn phản ánh đúng “lời chào hàng” của mô hình nhất, vì hiệu suất agent phụ thuộc vào việc mô hình hoàn tất công việc hữu ích nhanh đến đâu, không chỉ tốc độ sinh token thuần túy.
So sánh với Qwen3.6 đáng để suy nghĩ. Khi chúng tôi đánh giá Qwen3.6-35B-A3B, chúng tôi ghi nhận 3B tham số hoạt động và hiệu suất mạnh trên SWE-bench và Terminal-Bench, vì vậy NVIDIA chọn nó làm điểm đối chiếu là một cuộc so tài ngang cơ trong cùng hạng kích thước.
GPQA Diamond và suy luận
Lightning đạt 75,44 (BF16) trên GPQA Diamond không dùng công cụ, bộ câu hỏi khoa học trình độ sau đại học được viết để khó với người không chuyên ngay cả khi có truy cập web.
Đó là con số mạnh đối với mô hình nhỏ, dù model card nêu rõ Lightning không được định vị như một động cơ suy luận.
Humanity's Last Exam (chỉ văn bản, không công cụ) kể câu chuyện ở mặt còn lại với 11,72 (BF16), và SciCode đạt 32,60.
Những điểm thấp hơn này phù hợp với cách NVIDIA đóng khung: đây là mô hình thực thi, còn suy luận mở khó được định tuyến cho mô hình tuyến đầu.
Agentic và tuân thủ hướng dẫn
Terminal-Bench 2.1 đạt 24,58 (BF16) và BrowseComp đạt 36,97, trong khi IFBench (lỏng) đạt 71,88, cho thấy mô hình tuân theo hướng dẫn có cấu trúc một cách đáng tin cậy.
Kiến thức tổng quát cũng ổn, với MMLU Pro ở mức 81,94 (BF16) và 81,62 (NVFP4), chênh lệch không đáng kể xác nhận checkpoint đã lượng tử an toàn để triển khai.
Nemotron 3.5 Lightning so với Qwen3.6-35B-A3B
Cả hai đều là mô hình MoE với 3B tham số hoạt động, nhắm vào tác vụ lập trình và agent, nên so sánh song song là cách gọn gàng nhất để thấy Lightning nằm ở đâu.
| Thuộc tính | Nemotron 3.5 Lightning | Qwen3.6-35B-A3B |
|---|
| Tổng / hoạt động | 30B / 3B | 35B / 3B |
| Cửa sổ ngữ cảnh | Tối đa 1M token | 262K token |
| SWE-bench Verified | 51,56 (BF16) | Mạnh (theo đánh giá của chúng tôi) |
| Giấy phép | OpenMDW-1.1 (mở) | Mở |
| Định vị | Lớp thực thi của agent | Lập trình, suy luận, ngữ cảnh dài |
Giá và khả dụng của Nemotron 3.5 Lightning
Bạn có thể dùng thử Nemotron 3.5 Lightning trên build.nvidia.com hoặc qua OpenRouter, và tải trọng số từ Hugging Face và ModelScope. Mô hình cung cấp endpoint tương thích OpenAI qua NVIDIA NIM, gồm /v1/chat/completions, /v1/completions và /v1/responses, nên có thể cắm vào pipeline agent hiện có mà không cần viết lại.
Giá lưu trữ tùy nhà cung cấp:
- DeepInfra: 0,05 đô cho mỗi 1M token đầu vào và 0,20 đô cho mỗi 1M token đầu ra, sẵn dùng ngay ngày phát hành, không cần cấp phát GPU.
- OpenRouter: một gói miễn phí với 0 đô đầu vào và 0 đô đầu ra, nhưng lưu ý rằng dù tuyến này hỗ trợ cửa sổ ngữ cảnh 1M token, nó áp trần 65.536 token tối đa cho phần sinh đầu ra.
- Tự lưu trữ: miễn phí theo OpenMDW-1.1, triển khai được qua vLLM, SGLang và TensorRT-LLM.
Giới hạn của OpenRouter đáng lưu ý. Độ dài ngữ cảnh 1M là khả năng của mô hình, nhưng giới hạn thực tế bạn nhận được phụ thuộc vào nhà cung cấp và tuyến, nên hãy kiểm tra endpoint trước khi giả định bạn có toàn bộ cửa sổ.
Kết luận
Nemotron 3.5 Lightning thể hiện một canh bạc cụ thể của NVIDIA: tương lai của agent sản xuất là một hệ mô hình, nơi mô hình thực thi rẻ xử lý khối lượng, còn mô hình tuyến đầu đảm nhiệm hoạch định. Việc phát hành NeMo Switchyard cùng đợt là dấu hiệu rõ ràng, vì mô hình chỉ thực sự hợp lý khi bạn có thể định tuyến công việc tới nó một cách thông minh.
Điều tôi thấy hữu ích nhất là sự minh bạch về phạm vi. NVIDIA không giả vờ đây là mô hình suy luận, và các điểm chuẩn chứng thực điều đó: mạnh ở SWE-bench Verified (51,56) và PinchBench (85,37), khiêm tốn ở Humanity's Last Exam (11,72). Nếu tải công việc của bạn là gọi công cụ, kiểm định và định dạng trên các agent luôn bật, phép đánh đổi này là chính xác.
Bản phát hành mở theo OpenMDW-1.1 với trọng số, dữ liệu và quy trình, cộng với checkpoint đủ nhỏ để chạy trên DGX Spark, khiến mô hình thực sự hữu ích cho các đội muốn fine-tune và tự lưu trữ thay vì trả tiền theo token. Lưu ý chính là mọi số liệu điểm chuẩn hiện tại đều do nhà cung cấp công bố, nên tôi muốn có tái hiện độc lập trước khi coi các tuyên bố nhanh hơn 4x và hoàn thành nhanh hơn 30% là chốt hạ.
Nếu bạn muốn xây kỹ năng fine-tune để thích ứng một mô hình như thế này với tải công việc của riêng mình, hướng dẫn của chúng tôi về fine-tune Qwen3.6 trên tập dữ liệu Hỏi & Đáp y khoa bao quát quy trình QLoRA trên một mô hình MoE tương đương từng bước.


Phần lớn cuộc thảo luận về AI mang tính agent tập trung vào các mô hình suy luận tuyến đầu đảm nhiệm hoạch định.
Lập luận của NVIDIA với Nemotron 3.5 Lightning là mô hình tuyến đầu không phải công cụ phù hợp cho phần lớn những gì một agent thực sự làm.
Các agent chạy dài tiêu tốn phần lớn ngân sách token vào gọi công cụ, kiểm định đầu ra và ủy quyền cho các subagent, và việc chạy mô hình tuyến đầu cho mọi bước như vậy vừa tốn kém vừa chậm.
Nemotron 3.5 Lightning, phát hành ngày 11 tháng 8 năm 2026, là mô hình mixture-of-experts (MoE) 30B mở với 3B tham số hoạt động, nhắm trực diện vào lớp thực thi đó.
NVIDIA cho biết mô hình đạt vị trí biên Pareto về độ chính xác so với tốc độ trên Artificial Analysis Intelligence Index, và báo cáo tốc độ sinh đầu ra nhanh hơn tới 4 lần so với các mô hình cùng cỡ. Mô hình phát hành theo giấy phép OpenMDW-1.1 thoáng với trọng số, dữ liệu huấn luyện và quy trình kèm theo.
Trong bài viết này, tôi sẽ điểm qua mọi điểm mới của Nemotron 3.5 Lightning, xem xét tính năng và khám phá các điểm chuẩn. Nếu bạn muốn xem mô hình MoE cùng cỡ hoạt động thực tế ra sao, hướng dẫn của chúng tôi về fine-tune Qwen3.6 trên tập dữ liệu Hỏi & Đáp y khoa sẽ dẫn bạn qua toàn bộ quy trình.
Nemotron 3.5 Lightning tóm lược
Nemotron 3.5 Lightning là gì?
Nemotron 3.5 Lightning là thành viên nhỏ nhất trong họ mô hình mở Nemotron 3 của NVIDIA, được xây dựng riêng cho thực thi khối lượng lớn, độ trễ thấp trong các agent tự động.
Mô hình dùng kiến trúc lai Mamba-2 + MoE + attention với tổng 30B tham số và 3B tham số hoạt động mỗi token, hỗ trợ ngữ cảnh dài tới 1M token.
Thiết kế MoE chính là yếu tố khiến nó nhanh.
Một bộ định tuyến sẽ gửi mỗi token tới chỉ một vài chuyên gia trong số nhiều chuyên gia, nên chỉ một phần nhỏ tham số chạy trên mỗi token.
Bạn nhận được dung lượng của một mô hình dày lớn ở chi phí tính toán của mô hình nhỏ, giống phép đánh đổi mà Qwen3.6-35B-A3B thực hiện với 3B tham số hoạt động.
Tuyên bố lớn của NVIDIA mang tính vị thế hơn là một điểm số đơn lẻ: trên Artificial Analysis Intelligence Index, kết hợp 9 đánh giá về tác vụ agent, lập trình, suy luận khoa học và trí tuệ tổng quát, Lightning nằm trên biên Pareto độ chính xác-tốc độ cho các mô hình mở nhỏ.
Nói đơn giản, không có mô hình nào cùng hạng vừa chính xác hơn vừa nhanh hơn cùng lúc.
Điểm mới ở Nemotron 3.5 Lightning
Các tính năng đều phục vụ một mục tiêu: chạy công việc thường nhật của agent thật nhanh mà không đánh rơi độ chính xác.
Dưới đây là những gì bạn có thể làm thực tế.
Chạy agent mạnh trên phần cứng tại chỗ
Vì mô hình đủ nhỏ để triển khai trên NVIDIA DGX Spark, GeForce RTX 5090 hoặc Jetson, bạn có thể chạy tải công việc mang tính agent trên máy bàn mà không cần trung tâm dữ liệu.
NVIDIA hợp tác với EXO Labs để đo Lightning trên DGX Spark và cho biết mô hình nằm trên biên Pareto cho các mô hình mở nhỏ trên bảng xếp hạng local.ai của EXO Labs.
Với người làm thực hành, điều này có nghĩa một agent luôn bật đảm nhiệm gọi công cụ và kiểm định kết quả có thể chạy trên phần cứng bạn đã sở hữu.
Bạn cũng có thể phục vụ mô hình qua LM Studio, llama.cpp, Ollama và Unsloth, nên hệ công cụ cục bộ đã chín muồi ngay khi ra mắt.
Định tuyến thực thi xuống và hoạch định lên với NeMo Switchyard
NVIDIA phát hành NeMo Switchyard cùng lúc với mô hình, một thư viện định tuyến mỗi yêu cầu tới mô hình hiệu quả nhất có thể xử lý nó.
Switchyard phơi bày Nemotron 3.5 Lightning như một đích định tuyến cạnh các mô hình mở và đóng của bạn, để hoạch định được định tuyến lên một mô hình tuyến đầu như Nemotron 3 Ultra trong khi thực thi được định tuyến xuống Lightning.
Lợi ích thực tế là hiệu suất token.
Thay vì trả mức giá mô hình tuyến đầu để chạy
git pull, kiểm định đầu ra công cụ hoặc định dạng kết quả, những lời gọi đó sẽ rơi vào mô hình rẻ, còn mô hình đắt chỉ dành cho các bước hoạch định khó vốn quyết định chất lượng nhưng không chiếm đa số về khối lượng.Tùy biến ngay từ đầu
Mô hình nhỏ fine-tune nhanh hơn, rẻ hơn và trên phần cứng khiêm tốn hơn so với mô hình lớn, và Lightning được thiết kế để thích ứng với công việc cụ thể.
NVIDIA phát hành trọng số, dữ liệu huấn luyện và quy trình theo OpenMDW-1.1, và bạn có thể fine-tune với LoRA hoặc SFT đầy đủ bằng NeMo Automodel và NeMo Megatron Bridge, hoặc chạy học tăng cường với NeMo RL và NeMo Gym.
Bản phát hành cũng bao gồm Nemotron-RL Agentic Terminal Pivot, một tập dữ liệu RL agent mở dùng để huấn luyện một phần hành vi agent lập trình.
Có một tuyên bố hướng tới cộng đồng mà tôi nghĩ đáng lưu ý ở đây.
MindStudio báo cáo việc fine-tune với đối tác hoàn tất trong chưa đầy 3 giờ với chi phí khoảng 100 đô, mức chi phí thích ứng chỉ hợp lý với mô hình cỡ này.
Giải mã suy đoán để tăng thông lượng
Lightning sinh nhiều token mỗi bước thông qua giải mã suy đoán, nơi một mô hình nháp đề xuất token và sau đó được rà soát hiệu quả.
Mô hình trải qua một giai đoạn tiền huấn luyện dành riêng để “nướng” dự đoán đa token (MTP) vào mô hình, tiếp theo là pha tăng cường MTP, cùng cách tiếp cận dùng trong Nemotron 3 Super và Ultra.
Ngoài MTP, NVIDIA cung cấp hai mô hình nháp.
DSpark được khuyến nghị cho DGX Spark và tải trung tâm dữ liệu độ đồng thời thấp, trong khi MTP phù hợp đồng thời trung bình tới cao; một mô hình nháp DFlash cũng được cung cấp để bạn benchmark xem mô hình nào phù hợp nhất với kiểu phục vụ của mình.
Điểm chuẩn Nemotron 3.5 Lightning
NVIDIA báo cáo điểm cho cả checkpoint BF16 và NVFP4, và hai loại này bám sát nhau trên hầu hết tác vụ, điều quan trọng vì NVFP4 là checkpoint đã lượng tử mà bạn thực sự sẽ triển khai. Các con số dưới đây lấy từ model card và blog ra mắt của chính NVIDIA. Chưa có tái hiện độc lập từ bên thứ ba tại thời điểm viết, nên hãy coi đây là số liệu do nhà cung cấp công bố.
SWE-bench Verified
Lightning đạt 51,56 (BF16) và 52,80 (NVFP4) trên SWE-bench Verified, một điểm chuẩn đo lường liệu mô hình có thể giải quyết issue GitHub thực bằng cách tạo bản vá mã hoạt động hay không. Với MoE 30B có 3B tham số hoạt động, vượt 50% ở bài này là kết quả vững và trực tiếp hỗ trợ bài toán agent lập trình.
SWE-bench Multilingual thấp hơn ở mức 39,33 (BF16), điều dễ hiểu do phạm vi đa ngôn ngữ khó hơn của codebase.
PinchBench và hiệu suất tác vụ
Trên PinchBench, Lightning đạt 85,37 (BF16) và 83,43 (NVFP4), và OpenRouter cho biết mô hình hoàn thành 10.000 tác vụ nhanh hơn 30% so với Qwen3.6-35B ở độ chính xác tương đương.
Đây là điểm chuẩn phản ánh đúng “lời chào hàng” của mô hình nhất, vì hiệu suất agent phụ thuộc vào việc mô hình hoàn tất công việc hữu ích nhanh đến đâu, không chỉ tốc độ sinh token thuần túy.
So sánh với Qwen3.6 đáng để suy nghĩ. Khi chúng tôi đánh giá Qwen3.6-35B-A3B, chúng tôi ghi nhận 3B tham số hoạt động và hiệu suất mạnh trên SWE-bench và Terminal-Bench, vì vậy NVIDIA chọn nó làm điểm đối chiếu là một cuộc so tài ngang cơ trong cùng hạng kích thước.
GPQA Diamond và suy luận
Lightning đạt 75,44 (BF16) trên GPQA Diamond không dùng công cụ, bộ câu hỏi khoa học trình độ sau đại học được viết để khó với người không chuyên ngay cả khi có truy cập web.
Đó là con số mạnh đối với mô hình nhỏ, dù model card nêu rõ Lightning không được định vị như một động cơ suy luận.
Humanity's Last Exam (chỉ văn bản, không công cụ) kể câu chuyện ở mặt còn lại với 11,72 (BF16), và SciCode đạt 32,60.
Những điểm thấp hơn này phù hợp với cách NVIDIA đóng khung: đây là mô hình thực thi, còn suy luận mở khó được định tuyến cho mô hình tuyến đầu.
Agentic và tuân thủ hướng dẫn
Terminal-Bench 2.1 đạt 24,58 (BF16) và BrowseComp đạt 36,97, trong khi IFBench (lỏng) đạt 71,88, cho thấy mô hình tuân theo hướng dẫn có cấu trúc một cách đáng tin cậy.
Kiến thức tổng quát cũng ổn, với MMLU Pro ở mức 81,94 (BF16) và 81,62 (NVFP4), chênh lệch không đáng kể xác nhận checkpoint đã lượng tử an toàn để triển khai.
Nemotron 3.5 Lightning so với Qwen3.6-35B-A3B
Cả hai đều là mô hình MoE với 3B tham số hoạt động, nhắm vào tác vụ lập trình và agent, nên so sánh song song là cách gọn gàng nhất để thấy Lightning nằm ở đâu.
Giá và khả dụng của Nemotron 3.5 Lightning
Bạn có thể dùng thử Nemotron 3.5 Lightning trên build.nvidia.com hoặc qua OpenRouter, và tải trọng số từ Hugging Face và ModelScope. Mô hình cung cấp endpoint tương thích OpenAI qua NVIDIA NIM, gồm
/v1/chat/completions,/v1/completionsvà/v1/responses, nên có thể cắm vào pipeline agent hiện có mà không cần viết lại.Giá lưu trữ tùy nhà cung cấp:
Giới hạn của OpenRouter đáng lưu ý. Độ dài ngữ cảnh 1M là khả năng của mô hình, nhưng giới hạn thực tế bạn nhận được phụ thuộc vào nhà cung cấp và tuyến, nên hãy kiểm tra endpoint trước khi giả định bạn có toàn bộ cửa sổ.
Kết luận
Nemotron 3.5 Lightning thể hiện một canh bạc cụ thể của NVIDIA: tương lai của agent sản xuất là một hệ mô hình, nơi mô hình thực thi rẻ xử lý khối lượng, còn mô hình tuyến đầu đảm nhiệm hoạch định. Việc phát hành NeMo Switchyard cùng đợt là dấu hiệu rõ ràng, vì mô hình chỉ thực sự hợp lý khi bạn có thể định tuyến công việc tới nó một cách thông minh.
Điều tôi thấy hữu ích nhất là sự minh bạch về phạm vi. NVIDIA không giả vờ đây là mô hình suy luận, và các điểm chuẩn chứng thực điều đó: mạnh ở SWE-bench Verified (51,56) và PinchBench (85,37), khiêm tốn ở Humanity's Last Exam (11,72). Nếu tải công việc của bạn là gọi công cụ, kiểm định và định dạng trên các agent luôn bật, phép đánh đổi này là chính xác.
Bản phát hành mở theo OpenMDW-1.1 với trọng số, dữ liệu và quy trình, cộng với checkpoint đủ nhỏ để chạy trên DGX Spark, khiến mô hình thực sự hữu ích cho các đội muốn fine-tune và tự lưu trữ thay vì trả tiền theo token. Lưu ý chính là mọi số liệu điểm chuẩn hiện tại đều do nhà cung cấp công bố, nên tôi muốn có tái hiện độc lập trước khi coi các tuyên bố nhanh hơn 4x và hoàn thành nhanh hơn 30% là chốt hạ.
Nếu bạn muốn xây kỹ năng fine-tune để thích ứng một mô hình như thế này với tải công việc của riêng mình, hướng dẫn của chúng tôi về fine-tune Qwen3.6 trên tập dữ liệu Hỏi & Đáp y khoa bao quát quy trình QLoRA trên một mô hình MoE tương đương từng bước.