
Last chance! 50% off DataCamp Premium
Sale ends in
Het meeste gesprek over agentische AI draait om de frontier-reasoningmodellen die het plannen doen.
NVIDIA’s stelling met Nemotron 3.5 Lightning is dat het frontier-model voor het meeste werk dat een agent daadwerkelijk doet, het verkeerde gereedschap is.
Lange-running agents verbranden het grootste deel van hun tokenbudget aan tool-calls, het valideren van outputs en delegeren aan subagents, en een frontier-model voor elke stap draaien is duur en traag.
Nemotron 3.5 Lightning, uitgebracht op 11 augustus 2026, is een open mixture-of-experts (MoE)-model van 30B met 3B actieve parameters, gericht op precies die executielaag.
NVIDIA claimt dat het de nauwkeurigheid-versus-snelheid-Paretofrontier wint op de Artificial Analysis Intelligence Index, en meldt tot 4x uitvoersnelheid ten opzichte van modellen van vergelijkbare grootte. Het wordt geleverd onder de permissieve OpenMDW-1.1-licentie met gewichten, trainingsdata en recepten.
In dit artikel behandel ik alles wat nieuw is aan Nemotron 3.5 Lightning, kijk ik naar de functies en verken ik de benchmarks. Wil je zien hoe een vergelijkbaar MoE-model zich in de praktijk gedraagt, dan loopt onze tutorial over fijn-afstellen van Qwen3.6 op een medisch vraag-en-antwoorddataset de workflow end-to-end door.
Nemotron 3.5 Lightning is het kleinste lid van NVIDIA’s open Nemotron 3-modelfamilie, specifiek gebouwd voor hoge volumes en lage latency in autonome agents.
Het gebruikt een Mamba-2 + MoE + attention hybride architectuur met in totaal 30B parameters en 3B actief per token, en ondersteunt een contextlengte tot 1M tokens.
Het MoE-ontwerp is wat het snel maakt.
Een router stuurt elk token naar slechts enkele van zijn vele experts, zodat per token maar een fractie van de parameters draait.
Je krijgt de capaciteit van een groter dense model tegen de rekenschaal van een klein model, dezelfde trade-off die Qwen3.6-35B-A3B maakt met zijn 3B actieve parameters.
De grote claim van NVIDIA is positioneel en geen enkele score: op de Artificial Analysis Intelligence Index, die 9 evaluaties combineert over agentische taken, coderen, wetenschappelijke redenering en algemene intelligentie, zit Lightning op de nauwkeurigheid-snelheid-Paretofrontier voor kleine open modellen.
In gewone taal: niets in zijn grootteklasse is tegelijk nauwkeuriger én sneller.
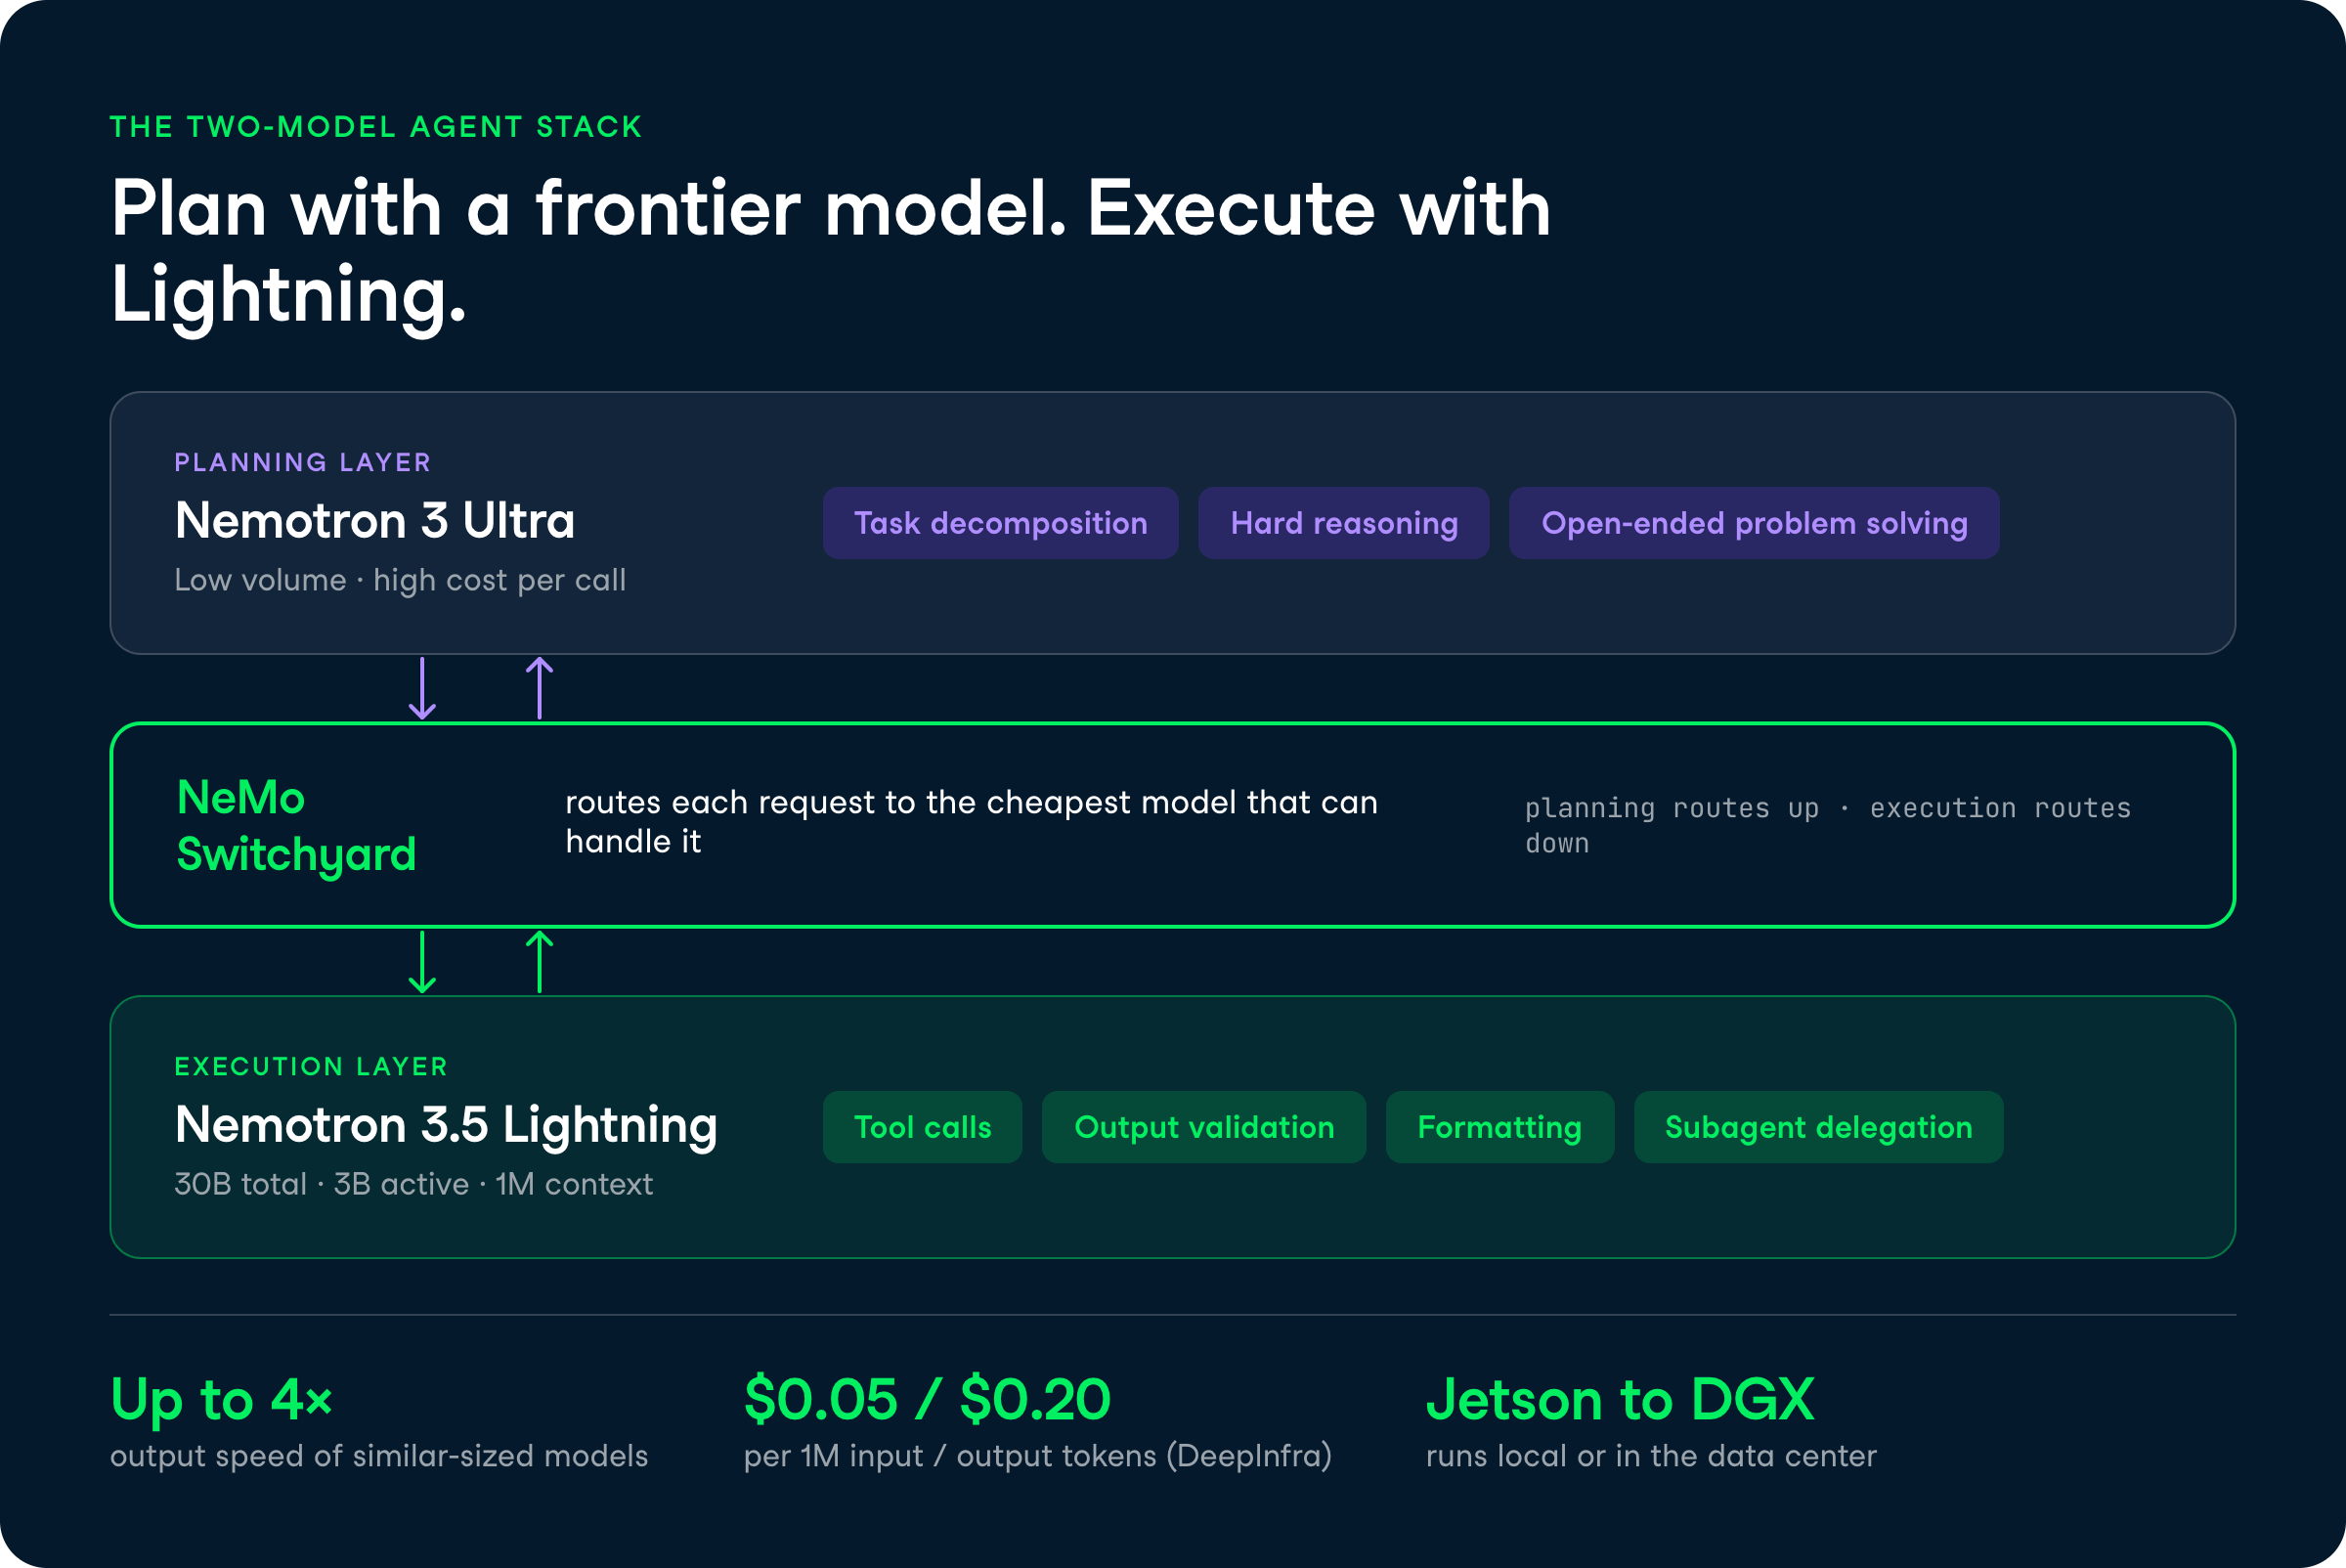
De functies hier dienen één doel: het routinematige werk van een agent snel afhandelen zonder dat het model inlevert op nauwkeurigheid.
Dit is wat je er daadwerkelijk mee kunt doen.
Omdat het model klein genoeg is om te deployen op een NVIDIA DGX Spark, GeForce RTX 5090 of Jetson, kun je agentische workloads op een desktop draaien zonder datacenter.
NVIDIA werkte samen met EXO Labs om Lightning te profileren op DGX Spark, en meldt dat het op de Paretofrontier staat voor kleine open modellen op het EXO Labs local.ai-leaderboard.
Voor praktijkmensen betekent dit dat een always-on agent die tool-calls en resultaatvalidatie afhandelt, kan draaien op hardware die je al hebt.
Je kunt het ook serven via LM Studio, llama.cpp, Ollama en Unsloth, dus het lokale toolingverhaal is bij lancering al volwassen.
NVIDIA brengt NeMo Switchyard tegelijk met het model uit, een bibliotheek die elke aanvraag routeert naar het meest efficiënte model dat het aankan.
Switchyard stelt Nemotron 3.5 Lightning bloot als routingdoel naast je open en gesloten modellen, zodat planning omhoog routeert naar een frontier-model zoals Nemotron 3 Ultra, terwijl executie omlaag routeert naar Lightning.
De praktische winst is tokenefficiëntie.
In plaats van frontier-tarieven te betalen om een git pull te draaien, een tool-output te valideren of een resultaat te formatteren, landen die calls op het goedkope model, en het dure model blijft gereserveerd voor de lastige planningsstappen die de kwaliteit bepalen maar niet het volume.
Kleine modellen zijn sneller en goedkoper te fine-tunen en op bescheidener hardware dan grote, en Lightning is gebouwd om te worden aangepast aan een specifieke taak.
NVIDIA heeft de gewichten, trainingsdata en recepten vrijgegeven onder OpenMDW-1.1, en je kunt fine-tunen met LoRA of volledige SFT met NeMo Automodel en NeMo Megatron Bridge, of reinforcement learning draaien met NeMo RL en NeMo Gym.
De release bevat ook Nemotron-RL Agentic Terminal Pivot, een open agentische RL-dataset die is gebruikt om een deel van het codeeragent-gedrag te trainen.
Eén communitygerichte claim die ik het noemen waard vind.
MindStudio meldt partner-fine-tuning in minder dan 3 uur voor ongeveer $100, het soort aanpassingskosten dat alleen logisch is met een model van deze omvang.
Lightning genereert meerdere tokens per stap via speculatieve decodering, waarbij een draftmodel tokens voorstelt die vervolgens efficiënt worden beoordeeld.
Het onderging een speciale pretrainingfase om multi-token prediction (MTP) in het model te bakken, gevolgd door een MTP-boostfase, dezelfde aanpak als in Nemotron 3 Super en Ultra.
Naast MTP levert NVIDIA twee draftmodellen mee.
DSpark wordt aanbevolen voor DGX Spark en datacenterworkloads met lage gelijktijdigheid, terwijl MTP geschikt is voor middelhoge tot hoge gelijktijdigheid, en er is ook een DFlash-draftmodel meegeleverd zodat je kunt benchmarken wat het beste presteert voor jouw serveerpatroon.
NVIDIA rapporteert scores voor zowel de BF16- als NVFP4-checkpoints, en de twee liggen dicht bij elkaar over de meeste taken, wat ertoe doet omdat NVFP4 het gequantiseerde checkpoint is dat je daadwerkelijk zou deployen. De onderstaande cijfers komen uit NVIDIA’s eigen modelkaart en launchblog. Er was op het moment van schrijven geen onafhankelijke reproductie door derden beschikbaar, dus beschouw dit als vendor-publicaties.
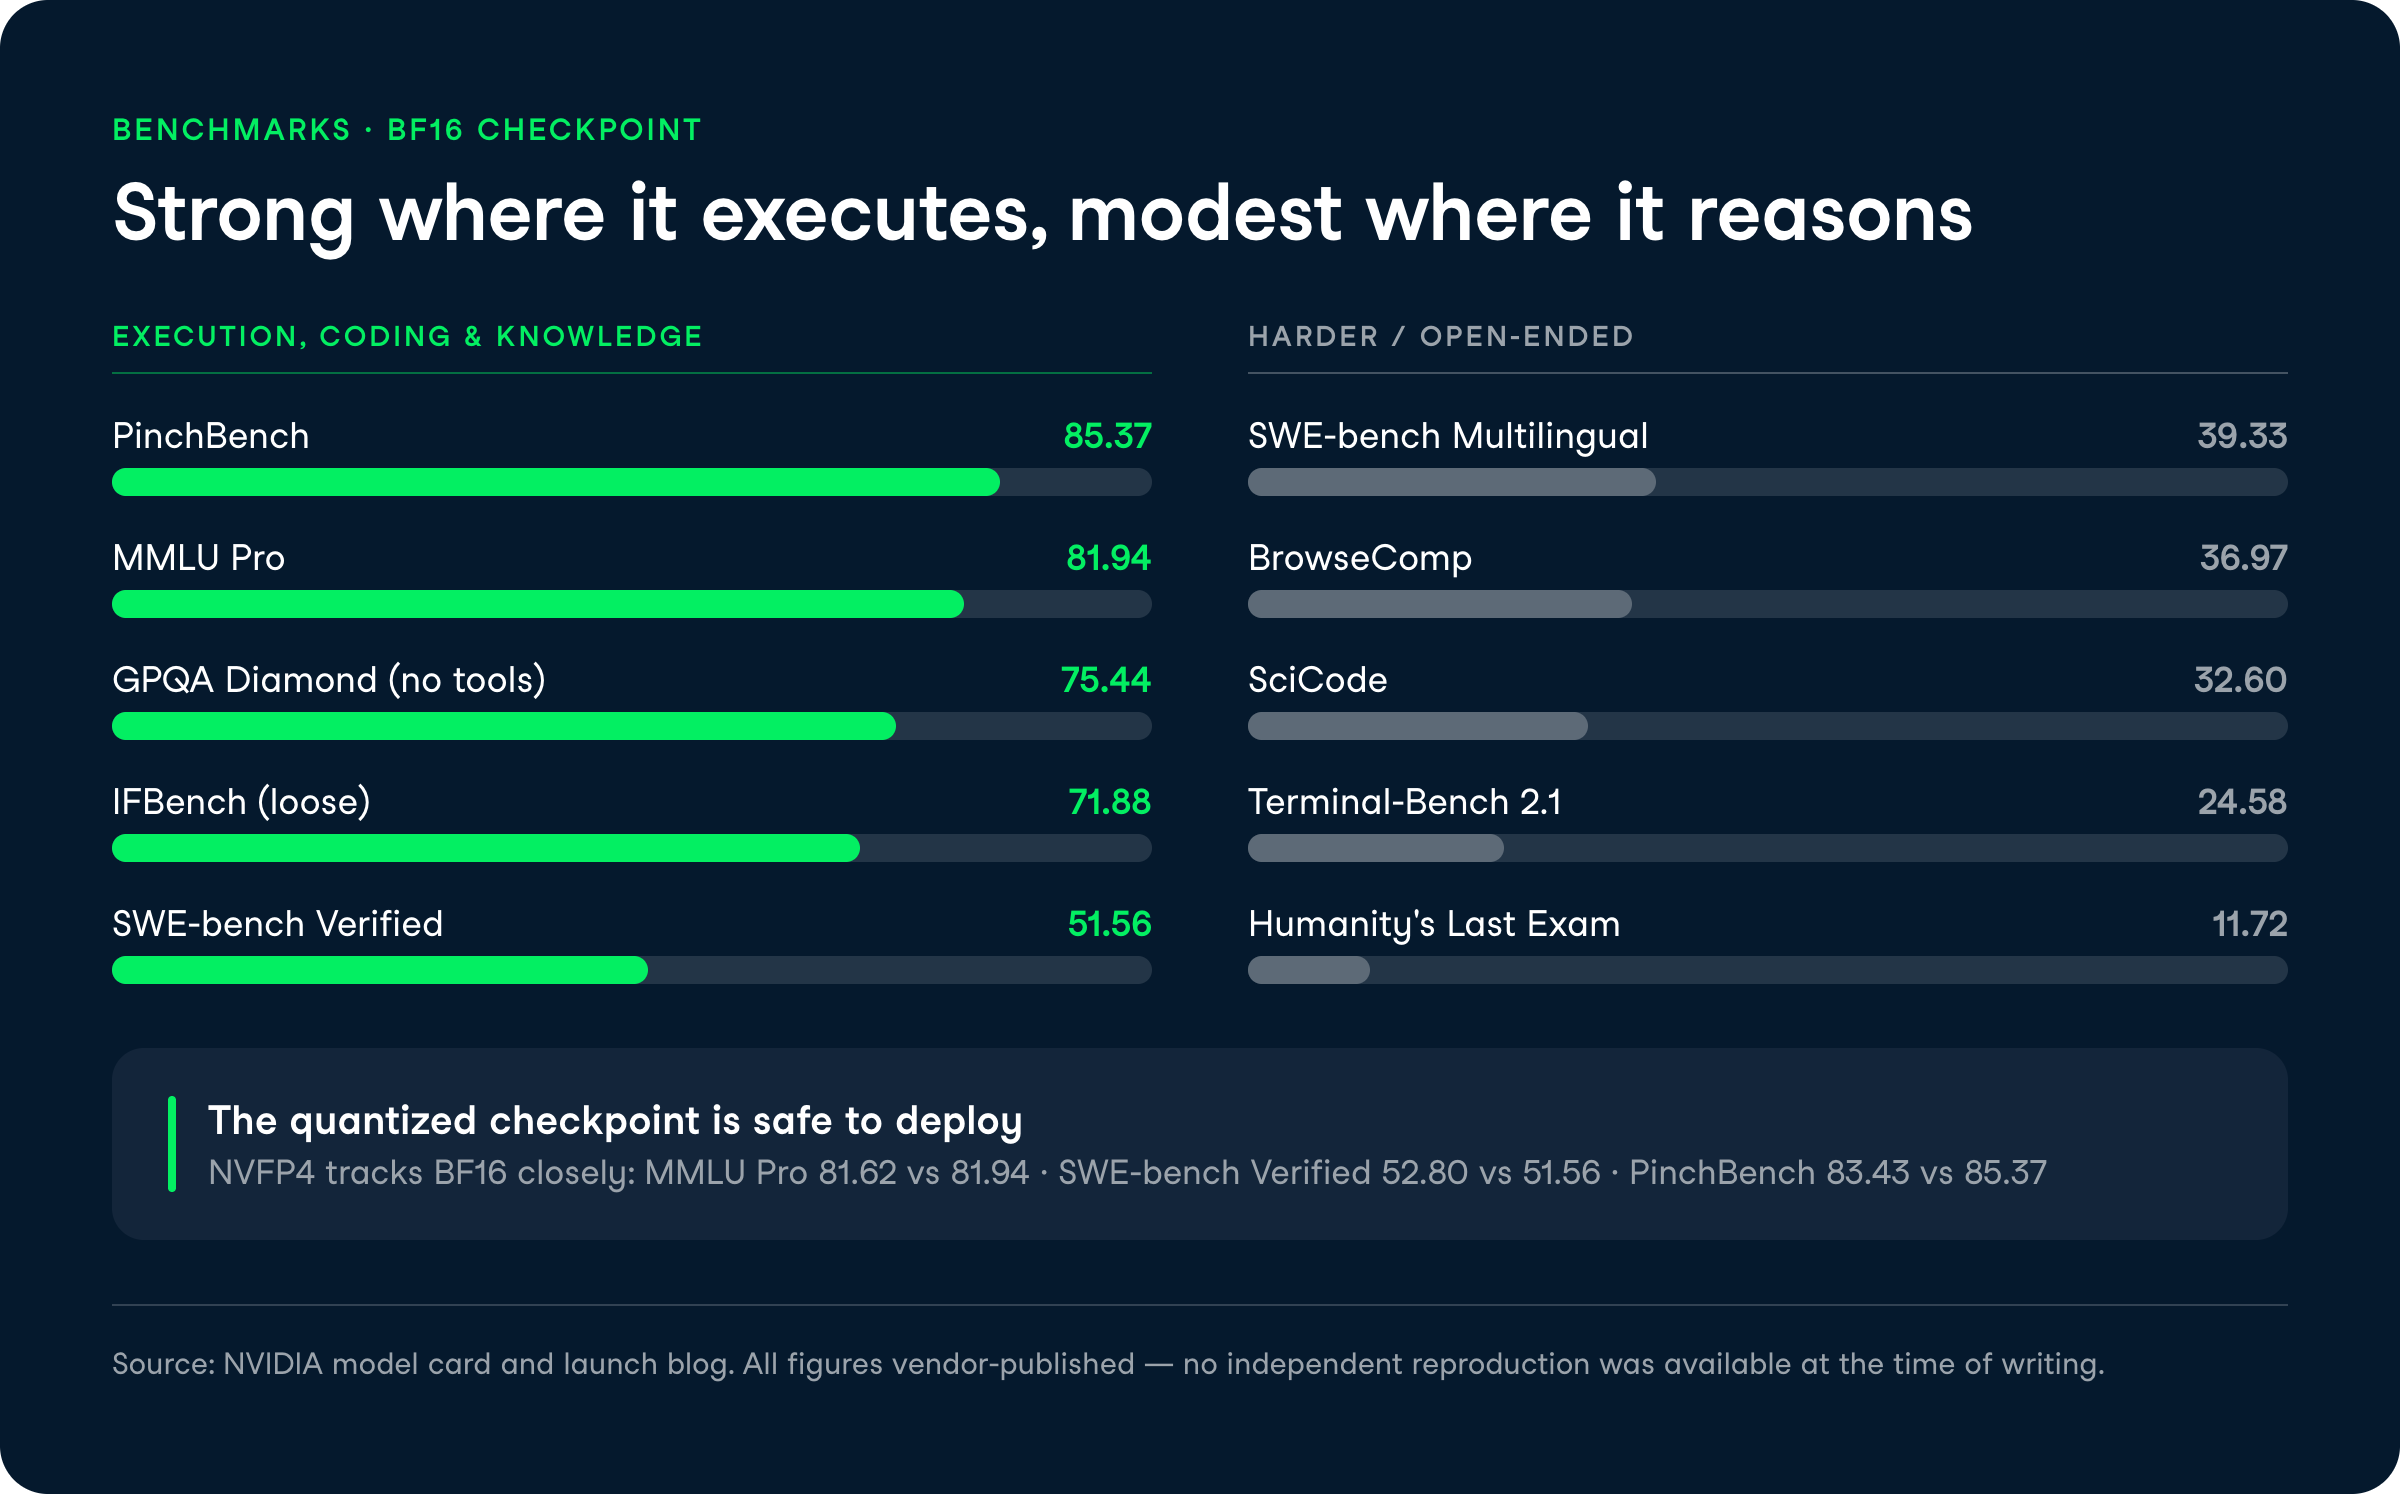
Lightning scoort 51,56 (BF16) en 52,80 (NVFP4) op SWE-bench Verified, een benchmark die meet of een model echte GitHub-issues kan oplossen door een werkende codepatch te produceren. Voor een 30B MoE met 3B actieve parameters is boven de 50% breken een solide resultaat en directe steun voor de codeeragent-usecase.
SWE-bench Multilingual komt lager uit op 39,33 (BF16), wat verwacht is gezien de moeilijkere meertalige codebasespreiding.
Op PinchBench haalt Lightning 85,37 (BF16) en 83,43 (NVFP4), en OpenRouter meldt dat het 10.000 taken 30% sneller voltooit dan Qwen3.6-35B bij vergelijkbare nauwkeurigheid.
Dit is de benchmark die de eigenlijke pitch van het model het beste vangt, aangezien agent-efficiëntie neerkomt op hoe snel een model nuttig werk afrondt, niet op ruwe tokengeneratiesnelheid.
De vergelijking met Qwen3.6 is het bekijken waard. Toen we Qwen3.6-35B-A3B bespraken, wezen we op de 3B actieve parameters en de sterke SWE-bench- en Terminal-Bench-prestaties, dus NVIDIA kiest een referentiepunt dat een eerlijke vergelijking in dezelfde grootteklasse is.
Lightning scoort 75,44 (BF16) op GPQA Diamond zonder tools, een set wetenschappelijke vragen op graduate-niveau die moeilijk zijn voor niet-experts, zelfs met webtoegang.
Dat is een sterk cijfer voor een klein model, al is de modelkaart expliciet dat Lightning niet is gepositioneerd als een reasoning-engine.
Humanity’s Last Exam (alleen tekst, geen tools) laat de andere kant van het verhaal zien met 11,72 (BF16), en SciCode komt uit op 32,60.
Deze lagere scores zijn consistent met NVIDIA’s framing: dit is een executiemodel, en het moeilijke, open-einde redeneren is bedoeld om naar een frontier-model te worden gerouteerd.
Terminal-Bench 2.1 komt uit op 24,58 (BF16) en BrowseComp op 36,97, terwijl IFBench (loose) 71,88 haalt, wat laat zien dat het model gestructureerde instructies betrouwbaar volgt.
Algemene kennis houdt ook stand, met MMLU Pro op 81,94 (BF16) en 81,62 (NVFP4), een verwaarloosbaar verschil dat bevestigt dat het gequantiseerde checkpoint veilig te deployen is.
Beide zijn MoE-modellen met 3B actieve parameters, gericht op codeer- en agentische workloads, dus een vergelijking naast elkaar is de duidelijkste manier om te zien waar Lightning past.
| Attribuut | Nemotron 3.5 Lightning | Qwen3.6-35B-A3B |
|---|---|---|
| Totaal / actieve params | 30B / 3B | 35B / 3B |
| Contextvenster | Tot 1M tokens | 262K tokens |
| SWE-bench Verified | 51,56 (BF16) | Sterk (volgens onze review) |
| Licentie | OpenMDW-1.1 (open) | Open |
| Positionering | Executielaag van agents | Coderen, redeneren, lange context |
Je kunt Nemotron 3.5 Lightning proberen op build.nvidia.com of via OpenRouter, en de gewichten downloaden van Hugging Face en ModelScope. Het model biedt OpenAI-compatibele endpoints via NVIDIA NIM, waaronder /v1/chat/completions, /v1/completions en /v1/responses, zodat het zonder herschrijven in bestaande agentische pipelines past.
Gehoste prijzen variëren per aanbieder:
Die OpenRouter-cap is het vermelden waard. De 1M contextlengte is een modelcapability, maar de praktische limiet die je krijgt hangt af van de aanbieder en route, dus check het endpoint voordat je ervan uitgaat dat je het volledige venster hebt.
Nemotron 3.5 Lightning is NVIDIA’s specifieke gok: dat de toekomst van productieagents een systeem van modellen is, waarbij een goedkoop executiemodel het volume doet en een frontier-model het plannen. Het feit dat NeMo Switchyard tegelijk wordt uitgebracht, is veelzeggend, omdat het model alleen zin heeft als je er slim naartoe kunt routeren.
Wat ik het nuttigst vind, is de eerlijkheid over de scope. NVIDIA doet niet alsof dit een reasoningmodel is, en de benchmarks ondersteunen dat: sterk op SWE-bench Verified (51,56) en PinchBench (85,37), bescheiden op Humanity’s Last Exam (11,72). Als jouw workload tool-calls, validatie en formattering in always-on agents is, dan is die trade precies goed.
De open release onder OpenMDW-1.1 met gewichten, data en recepten, plus een checkpoint dat klein genoeg is om op een DGX Spark te draaien, maakt dit echt nuttig voor teams die willen fine-tunen en zelf hosten in plaats van per token te betalen. De belangrijkste kanttekening is dat alle huidige benchmarkcijfers vendor-publicaties zijn, dus ik zou onafhankelijke reproductie willen zien voordat ik de claims van 4x snelheid en 30% snellere voltooiing als vaststaand beschouw.
Als je de fine-tuningvaardigheden wilt opbouwen om een model als dit aan je eigen workload aan te passen, behandelt onze tutorial over fijn-afstellen van Qwen3.6 op een medisch vraag-en-antwoorddataset de QLoRA-workflow stap voor stap op een vergelijkbaar MoE-model.
Topcursussen op DataCamp
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min


