Programa
Deploy Production-Ready Agents
2 h
Grande parte das conversas sobre IA agentiva foca nos modelos de raciocínio de fronteira que fazem o planejamento.
O argumento da NVIDIA com o Nemotron 3.5 Lightning é que o modelo de fronteira é a ferramenta errada para a maior parte do que um agente realmente faz.
Agentes de longa duração gastam a maior parte do orçamento de tokens em chamadas de ferramentas, validação de saídas e delegação para subagentes — e rodar um modelo de fronteira em cada uma dessas etapas é caro e lento.
Lançado em 11 de agosto de 2026, o Nemotron 3.5 Lightning é um modelo aberto mixture-of-experts (MoE) de 30B com 3B de parâmetros ativos, projetado exatamente para essa camada de execução.
A NVIDIA afirma que ele vence a fronteira de Pareto entre precisão e velocidade no Artificial Analysis Intelligence Index, e reporta até 4x mais velocidade de saída que modelos de porte similar. Ele é distribuído sob a licença permissiva OpenMDW-1.1 com pesos, dados de treino e receitas disponibilizados.
Neste artigo, vou cobrir tudo que há de novo no Nemotron 3.5 Lightning, seus recursos e os benchmarks. Se você quer ver como um MoE de porte parecido se comporta na prática, nosso tutorial sobre fine-tuning do Qwen3.6 em um dataset de perguntas e respostas médicas mostra o fluxo de trabalho de ponta a ponta.
O Nemotron 3.5 Lightning é o menor membro da família aberta de modelos Nemotron 3 da NVIDIA, criado especificamente para execução de alto volume e baixa latência em agentes autônomos.
Ele usa uma arquitetura híbrida Mamba-2 + MoE + attention, com 30B de parâmetros totais e 3B ativos por token, e suporta janelas de contexto de até 1M de tokens.
É o design MoE que o torna rápido.
Um roteador envia cada token para apenas alguns de seus vários experts, então só uma fração dos parâmetros roda por token.
Você obtém a capacidade de um modelo denso maior com o custo computacional de um menor — a mesma troca feita pelo Qwen3.6-35B-A3B com seus 3B de parâmetros ativos.
A grande afirmação da NVIDIA é mais posicional que um único número: no Artificial Analysis Intelligence Index, que combina 9 avaliações em tarefas agentivas, código, raciocínio científico e inteligência geral, o Lightning fica na fronteira de Pareto entre precisão e velocidade para modelos abertos pequenos.
Em termos simples, nada na sua faixa de tamanho é ao mesmo tempo mais preciso e mais rápido.
Os recursos aqui servem a um objetivo: executar o trabalho rotineiro de um agente com rapidez, sem o modelo tropeçar na precisão.
Veja o que dá para fazer na prática.
Como o modelo é pequeno o suficiente para ser implantado em um NVIDIA DGX Spark, GeForce RTX 5090 ou Jetson, você pode rodar workloads agentivos em um desktop, sem data center.
A NVIDIA trabalhou com a EXO Labs para perfilar o Lightning no DGX Spark e reporta que ele está na fronteira de Pareto para modelos abertos pequenos no ranking local.ai da EXO Labs.
Para quem está na prática, isso significa que um agente always-on, lidando com chamadas de ferramentas e validação de resultados, pode rodar no hardware que você já tem.
Você também pode servi-lo via LM Studio, llama.cpp, Ollama e Unsloth, então o ecossistema local já chega maduro no lançamento.
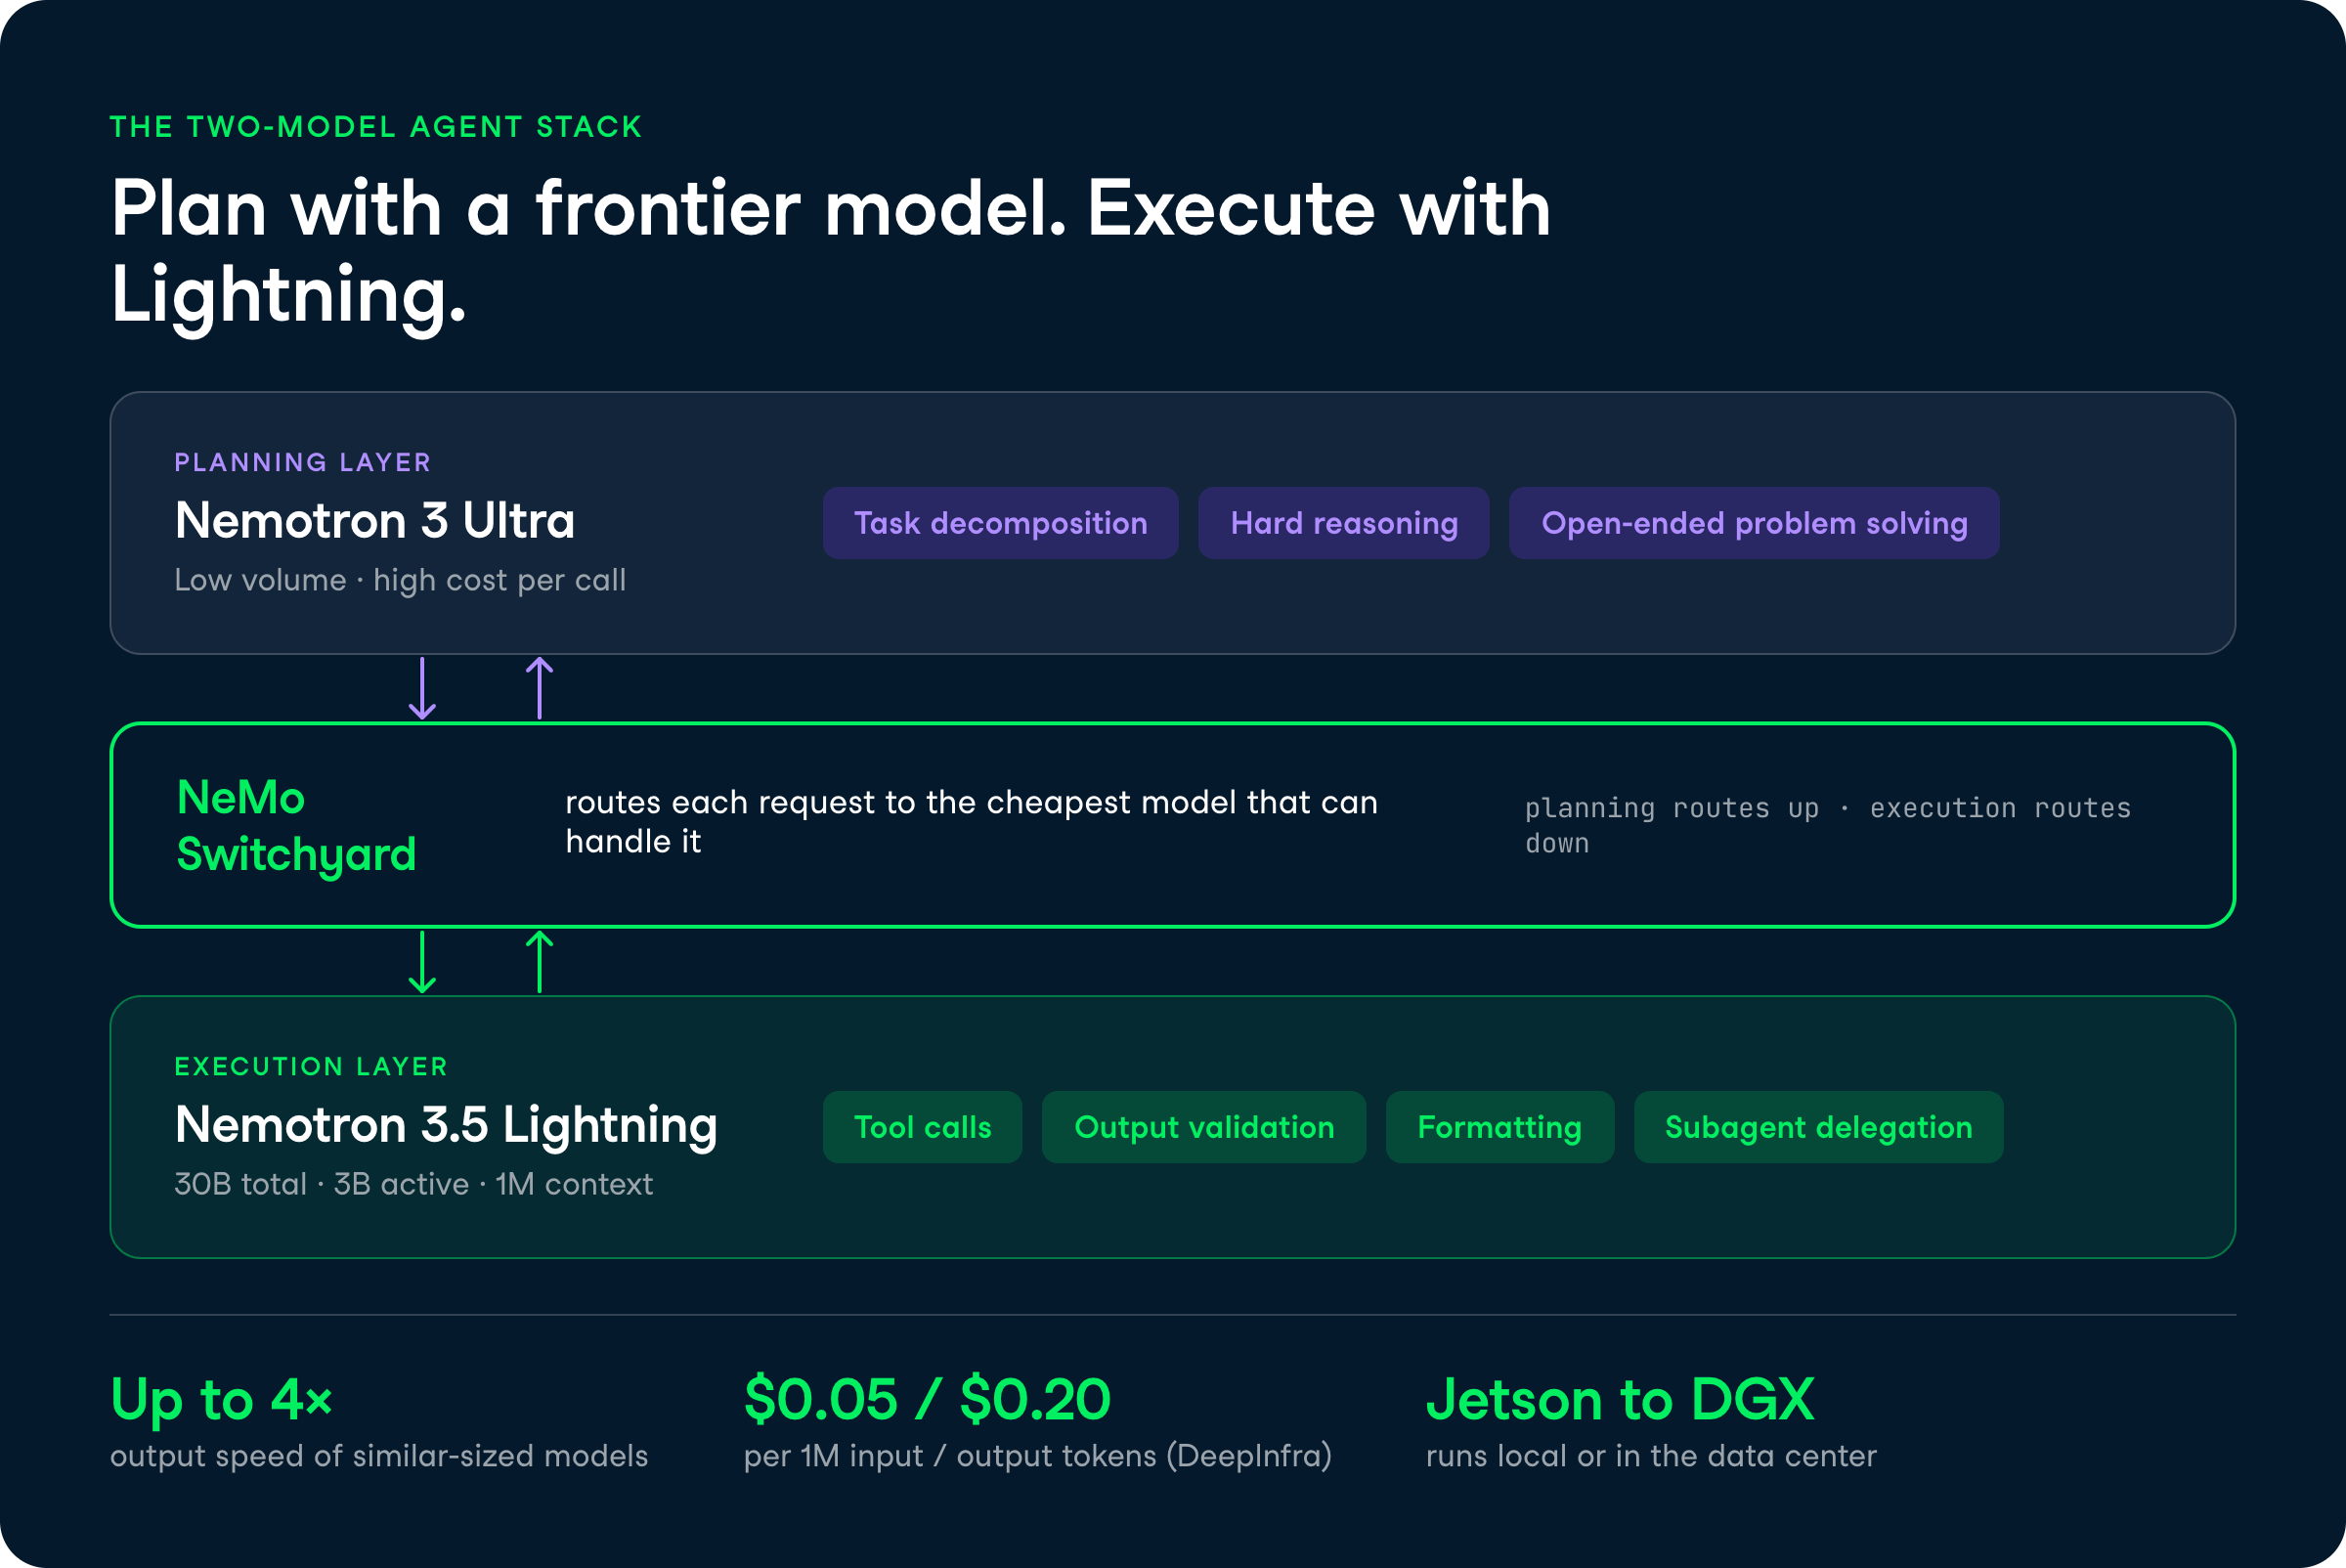
A NVIDIA está lançando o NeMo Switchyard junto com o modelo — uma biblioteca que direciona cada requisição para o modelo mais eficiente que consegue atendê-la.
O Switchyard expõe o Nemotron 3.5 Lightning como alvo de roteamento ao lado dos seus modelos abertos e fechados, de modo que o planejamento sobe para um modelo de fronteira como o Nemotron 3 Ultra, enquanto a execução desce para o Lightning.
O ganho prático é eficiência de tokens.
Em vez de pagar tarifa de modelo de fronteira para rodar um git pull, validar a saída de uma ferramenta ou formatar um resultado, essas chamadas caem no modelo barato, e o caro fica reservado para os passos difíceis de planejamento, que dominam a qualidade, mas não o volume.
Modelos menores fazem fine-tuning mais rápido, mais barato e em hardware mais modesto do que os grandes — e o Lightning foi feito para ser adaptado a um trabalho específico.
A NVIDIA liberou pesos, dados de treino e receitas sob a OpenMDW-1.1, e você pode fazer fine-tuning com LoRA ou SFT completo usando o NeMo Automodel e o NeMo Megatron Bridge, ou rodar reinforcement learning com o NeMo RL e o NeMo Gym.
O lançamento também inclui o Nemotron-RL Agentic Terminal Pivot, um dataset aberto de RL agentivo usado para treinar parte do comportamento de agentes de código.
Há um ponto voltado à comunidade que vale destacar.
A MindStudio reporta fine-tuning feito por parceiros em menos de 3 horas por cerca de US$ 100 — um custo de adaptação que só faz sentido com um modelo desse porte.
O Lightning gera múltiplos tokens por passo via decodificação especulativa, em que um modelo de rascunho propõe tokens que são então revisados com eficiência.
Ele passou por uma etapa dedicada de pré-treinamento para incorporar a predição multi-token (MTP) ao modelo, seguida de uma fase de reforço de MTP — a mesma abordagem usada no Nemotron 3 Super e no Ultra.
Além do MTP, a NVIDIA fornece dois modelos de rascunho.
O DSpark é indicado para DGX Spark e workloads de data center com baixa concorrência, enquanto o MTP atende concorrência média a alta, e um modelo de rascunho DFlash também é fornecido para você comparar qual rende melhor no seu padrão de serving.
A NVIDIA reporta pontuações tanto para os checkpoints BF16 quanto NVFP4, e ambos se acompanham de perto na maioria das tarefas — o que importa porque o NVFP4 é o checkpoint quantizado que você realmente implantaria. Os números abaixo vêm do próprio model card e do post de lançamento da NVIDIA. Não havia reprodução independente de terceiros no momento da escrita, então trate-os como dados do fornecedor.
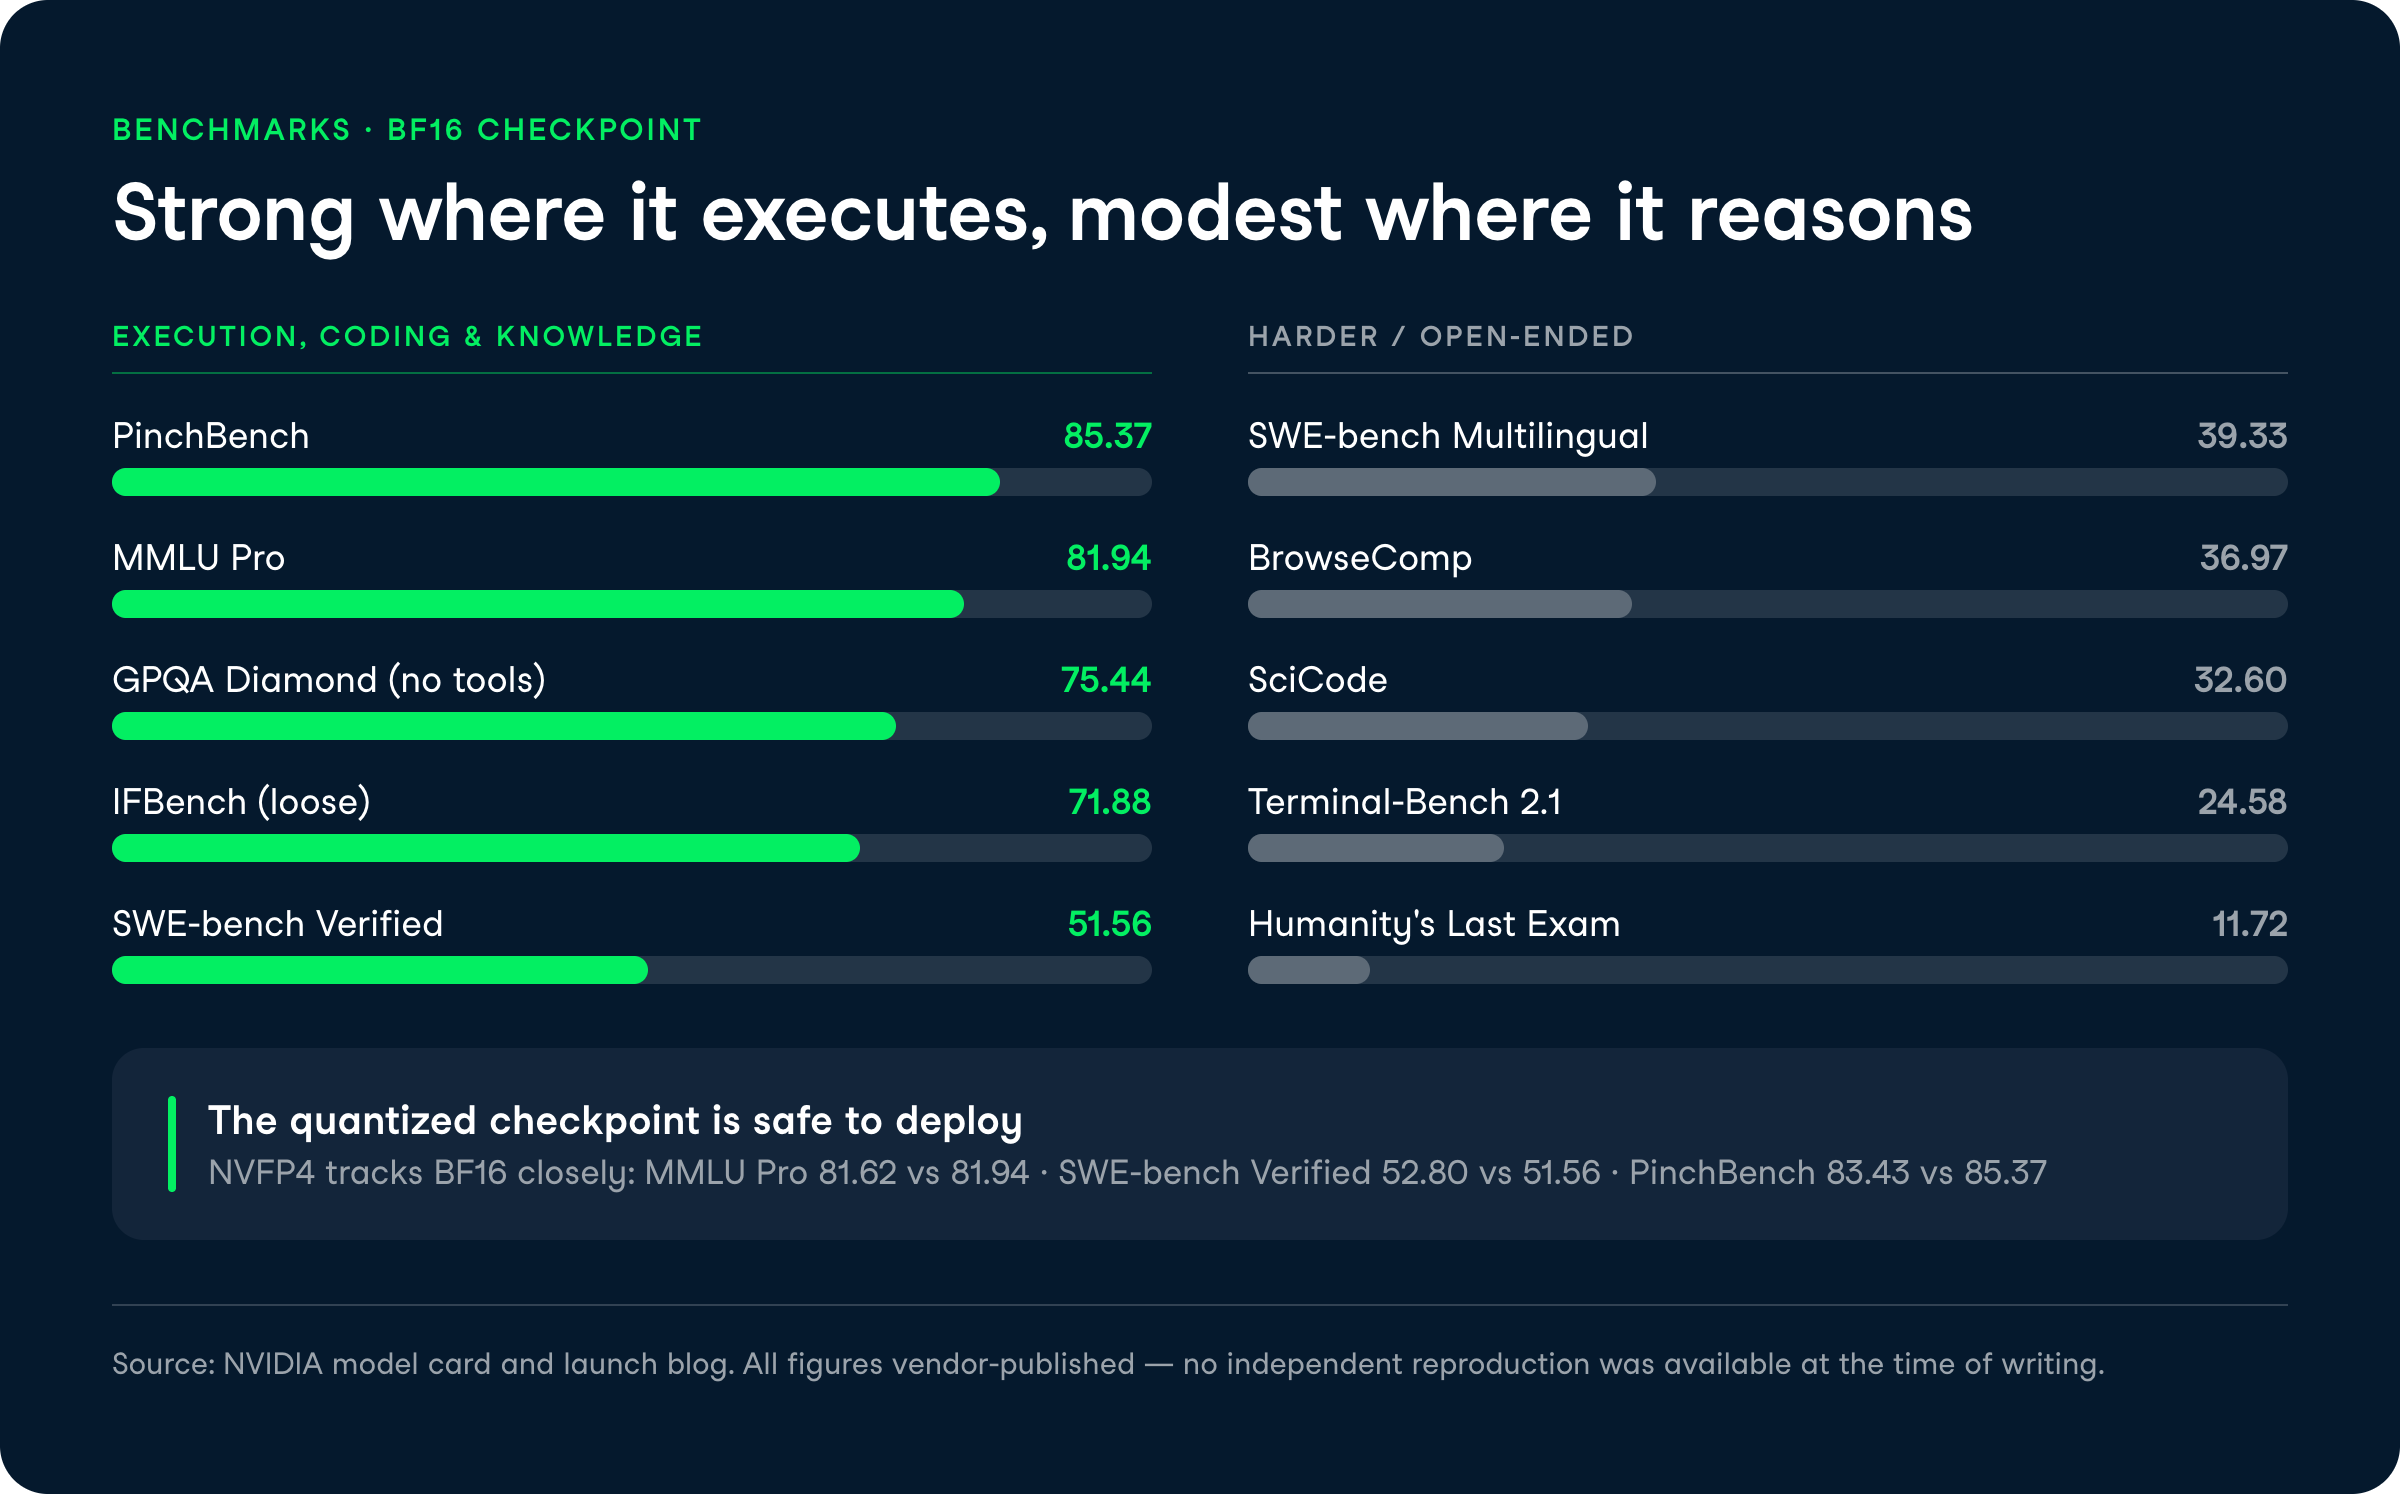
O Lightning marca 51,56 (BF16) e 52,80 (NVFP4) no SWE-bench Verified, um benchmark que mede se um modelo consegue resolver issues reais do GitHub produzindo um patch de código funcional. Para um MoE de 30B com 3B de parâmetros ativos, passar de 50% é um resultado sólido e dá suporte direto ao caso de uso de agentes de código.
O SWE-bench Multilingual vem mais baixo, em 39,33 (BF16), o que é esperado dada a maior dificuldade e diversidade de bases de código multilíngues.
No PinchBench, o Lightning alcança 85,37 (BF16) e 83,43 (NVFP4), e o OpenRouter reporta que ele conclui 10.000 tarefas 30% mais rápido que o Qwen3.6-35B com precisão semelhante.
Esse é o benchmark que melhor captura a proposta do modelo, já que a eficiência de um agente depende de quão rápido o modelo termina trabalhos úteis — e não apenas da velocidade bruta de geração de tokens.
A comparação com o Qwen3.6 merece atenção. Quando analisamos o Qwen3.6-35B-A3B, destacamos seus 3B de parâmetros ativos e o bom desempenho em SWE-bench e Terminal-Bench, então a NVIDIA escolhê-lo como referência é um duelo justo na mesma faixa de tamanho.
O Lightning marca 75,44 (BF16) no GPQA Diamond sem ferramentas — um conjunto de perguntas de ciência em nível de pós-graduação, feito para ser difícil até para não especialistas mesmo com acesso à web.
É um número forte para um modelo pequeno, embora o model card deixe claro que o Lightning não se posiciona como motor de raciocínio.
O Humanity's Last Exam (apenas texto, sem ferramentas) mostra o outro lado da moeda com 11,72 (BF16), e o SciCode fica em 32,60.
Essas pontuações mais baixas estão alinhadas com o enquadramento da NVIDIA: este é um modelo de execução, e o raciocínio aberto difícil deve ser roteado para um modelo de fronteira.
O Terminal-Bench 2.1 fica em 24,58 (BF16) e o BrowseComp em 36,97, enquanto o IFBench (loose) chega a 71,88, mostrando que o modelo segue instruções estruturadas com confiabilidade.
O conhecimento geral também se sustenta, com o MMLU Pro em 81,94 (BF16) e 81,62 (NVFP4) — uma diferença desprezível que confirma que o checkpoint quantizado é seguro para produção.
Ambos são modelos MoE com 3B de parâmetros ativos voltados para código e workloads agentivos, então um comparativo lado a lado é a forma mais clara de ver onde o Lightning se encaixa.
| Atributo | Nemotron 3.5 Lightning | Qwen3.6-35B-A3B |
|---|---|---|
| Parâmetros totais / ativos | 30B / 3B | 35B / 3B |
| Janela de contexto | Até 1M de tokens | 262K tokens |
| SWE-bench Verified | 51,56 (BF16) | Forte (segundo nossa análise) |
| Licença | OpenMDW-1.1 (aberta) | Aberta |
| Posicionamento | Camada de execução de agentes | Código, raciocínio, longo contexto |
Você pode testar o Nemotron 3.5 Lightning no build.nvidia.com ou via OpenRouter, e baixar os pesos no Hugging Face e no ModelScope. O modelo expõe endpoints compatíveis com OpenAI via NVIDIA NIM, incluindo /v1/chat/completions, /v1/completions e /v1/responses, então ele entra em pipelines agentivos existentes sem reescritas.
Os preços hospedados variam por provedor:
Vale observar esse limite do OpenRouter. O contexto de 1M é uma capacidade do modelo, mas o limite prático depende do provedor e da rota — confira o endpoint antes de assumir que terá a janela completa.
O Nemotron 3.5 Lightning revela a aposta da NVIDIA: o futuro de agentes em produção é um sistema de modelos, onde um modelo barato de execução faz o volume e um modelo de fronteira faz o planejamento. Lançar o NeMo Switchyard junto é a pista — o modelo só faz sentido se você conseguir rotear o trabalho com inteligência.
O que acho mais útil é a clareza sobre o escopo. A NVIDIA não finge que este é um modelo de raciocínio, e os benchmarks confirmam: forte no SWE-bench Verified (51,56) e no PinchBench (85,37), modesto no Humanity's Last Exam (11,72). Se o seu workload é chamar ferramentas, validar e formatar em agentes always-on, essa troca é exatamente a certa.
O lançamento aberto sob OpenMDW-1.1 com pesos, dados e receitas — mais um checkpoint pequeno o suficiente para rodar em um DGX Spark — torna o modelo realmente útil para times que querem fazer fine-tuning e hospedar por conta própria em vez de pagar por token. A principal ressalva é que todos os números atuais de benchmark são do fornecedor; eu aguardaria reprodução independente antes de tratar as alegações de 4x de velocidade e 30% de conclusão mais rápida como liquidadas.
Se você quer desenvolver as habilidades de fine-tuning para adaptar um modelo como este ao seu workload, nosso tutorial sobre fine-tuning do Qwen3.6 em um dataset de perguntas e respostas médicas cobre o fluxo QLoRA em um MoE comparável, passo a passo.
Principais cursos da DataCamp
Programa
Curso
Curso
blog
Richie Cotton
7 min
blog
Abid Ali Awan
9 min
blog
Dr Ana Rojo-Echeburúa
9 min
Tutorial
Moez Ali
11 min
Tutorial
Josep Ferrer
11 min
Tutorial
Dimitri Didmanidze
9 min