
Last chance! 50% off DataCamp Premium
Sale ends in
एजेंटिक AI पर होने वाली ज़्यादातर चर्चा उन फ्रंटियर रीजनिंग मॉडलों पर टिकती है जो प्लानिंग करते हैं।
NVIDIA का Nemotron 3.5 Lightning के साथ तर्क है कि एजेंट के अधिकांश काम के लिए फ्रंटियर मॉडल सही औज़ार नहीं है।
लंबे समय तक चलने वाले एजेंट अपने टोकन बजट का अधिकांश हिस्सा टूल कॉल्स, आउटपुट वैलिडेशन, और सब-एजेंट्स को काम सौंपने में खर्च करते हैं, और हर चरण में फ्रंटियर मॉडल चलाना महंगा और धीमा है।
11 अगस्त, 2026 को जारी Nemotron 3.5 Lightning एक खुला 30B मिश्रण-ऑफ-एक्सपर्ट्स (MoE) मॉडल है जिसमें प्रति टोकन 3B सक्रिय पैरामीटर हैं, जो सीधे इसी निष्पादन लेयर को लक्ष्य बनाता है।
NVIDIA का दावा है कि यह Artificial Analysis Intelligence Index पर सटीकता बनाम गति के पारेतो फ्रंटियर पर जीतता है, और समान आकार के मॉडलों की तुलना में 4x तक आउटपुट स्पीड देता है। यह उदार OpenMDW-1.1 लाइसेंस के तहत शिप होता है, जिसमें वेट्स, प्रशिक्षण डेटा, और रेसिपीज़ जारी की गई हैं।
इस लेख में, मैं Nemotron 3.5 Lightning की नई बातें कवर करूंगा, इसकी विशेषताओं पर नज़र डालूंगा और बेंचमार्क्स की पड़ताल करूंगा। यदि आप देखना चाहते हैं कि समान आकार का MoE मॉडल व्यवहार में कैसा चलता है, तो हमारे ट्यूटोरियल मेडिकल Q&A डेटासेट पर Qwen3.6 का फाइन-ट्यूनिंग एंड-टु-एंड वर्कफ़्लो समझाता है।
Nemotron 3.5 Lightning NVIDIA के Nemotron 3 ओपन मॉडल परिवार का सबसे छोटा सदस्य है, जो स्वायत्त एजेंट्स में उच्च-वॉल्यूम, कम-लेटेंसी निष्पादन के लिए विशेष रूप से बनाया गया है।
यह Mamba-2 + MoE + attention हाइब्रिड आर्किटेक्चर का उपयोग करता है, जिसमें कुल 30B पैरामीटर और प्रति टोकन 3B सक्रिय हैं, और 1M टोकन तक की कॉन्टेक्स्ट लंबाई को सपोर्ट करता है।
MoE डिज़ाइन ही इसे तेज़ बनाता है।
एक राउटर प्रत्येक टोकन को उसके कई एक्सपर्ट्स में से केवल कुछ के पास भेजता है, इसलिए प्रति टोकन केवल कुछ पैरामीटर चलते हैं।
आपको बड़े डेंस मॉडल की क्षमता छोटे मॉडल की कंप्यूट लागत पर मिलती है—यही समझौता Qwen3.6-35B-A3B अपने 3B सक्रिय पैरामीटर के साथ करता है।
NVIDIA का बड़ा दावा किसी एक स्कोर से अधिक पोजिशनिंग का है: Artificial Analysis Intelligence Index पर, जो एजेंटिक टास्क, कोडिंग, वैज्ञानिक तर्क, और सामान्य बुद्धिमत्ता में 9 मूल्यांकनों को जोड़ता है, Lightning छोटे ओपन मॉडलों के लिए सटीकता-गति पारेतो फ्रंटियर पर बैठता है।
सरल शब्दों में, अपने आकार वर्ग में कोई भी मॉडल ऐसा नहीं है जो एक साथ इससे अधिक सटीक और तेज़ हो।
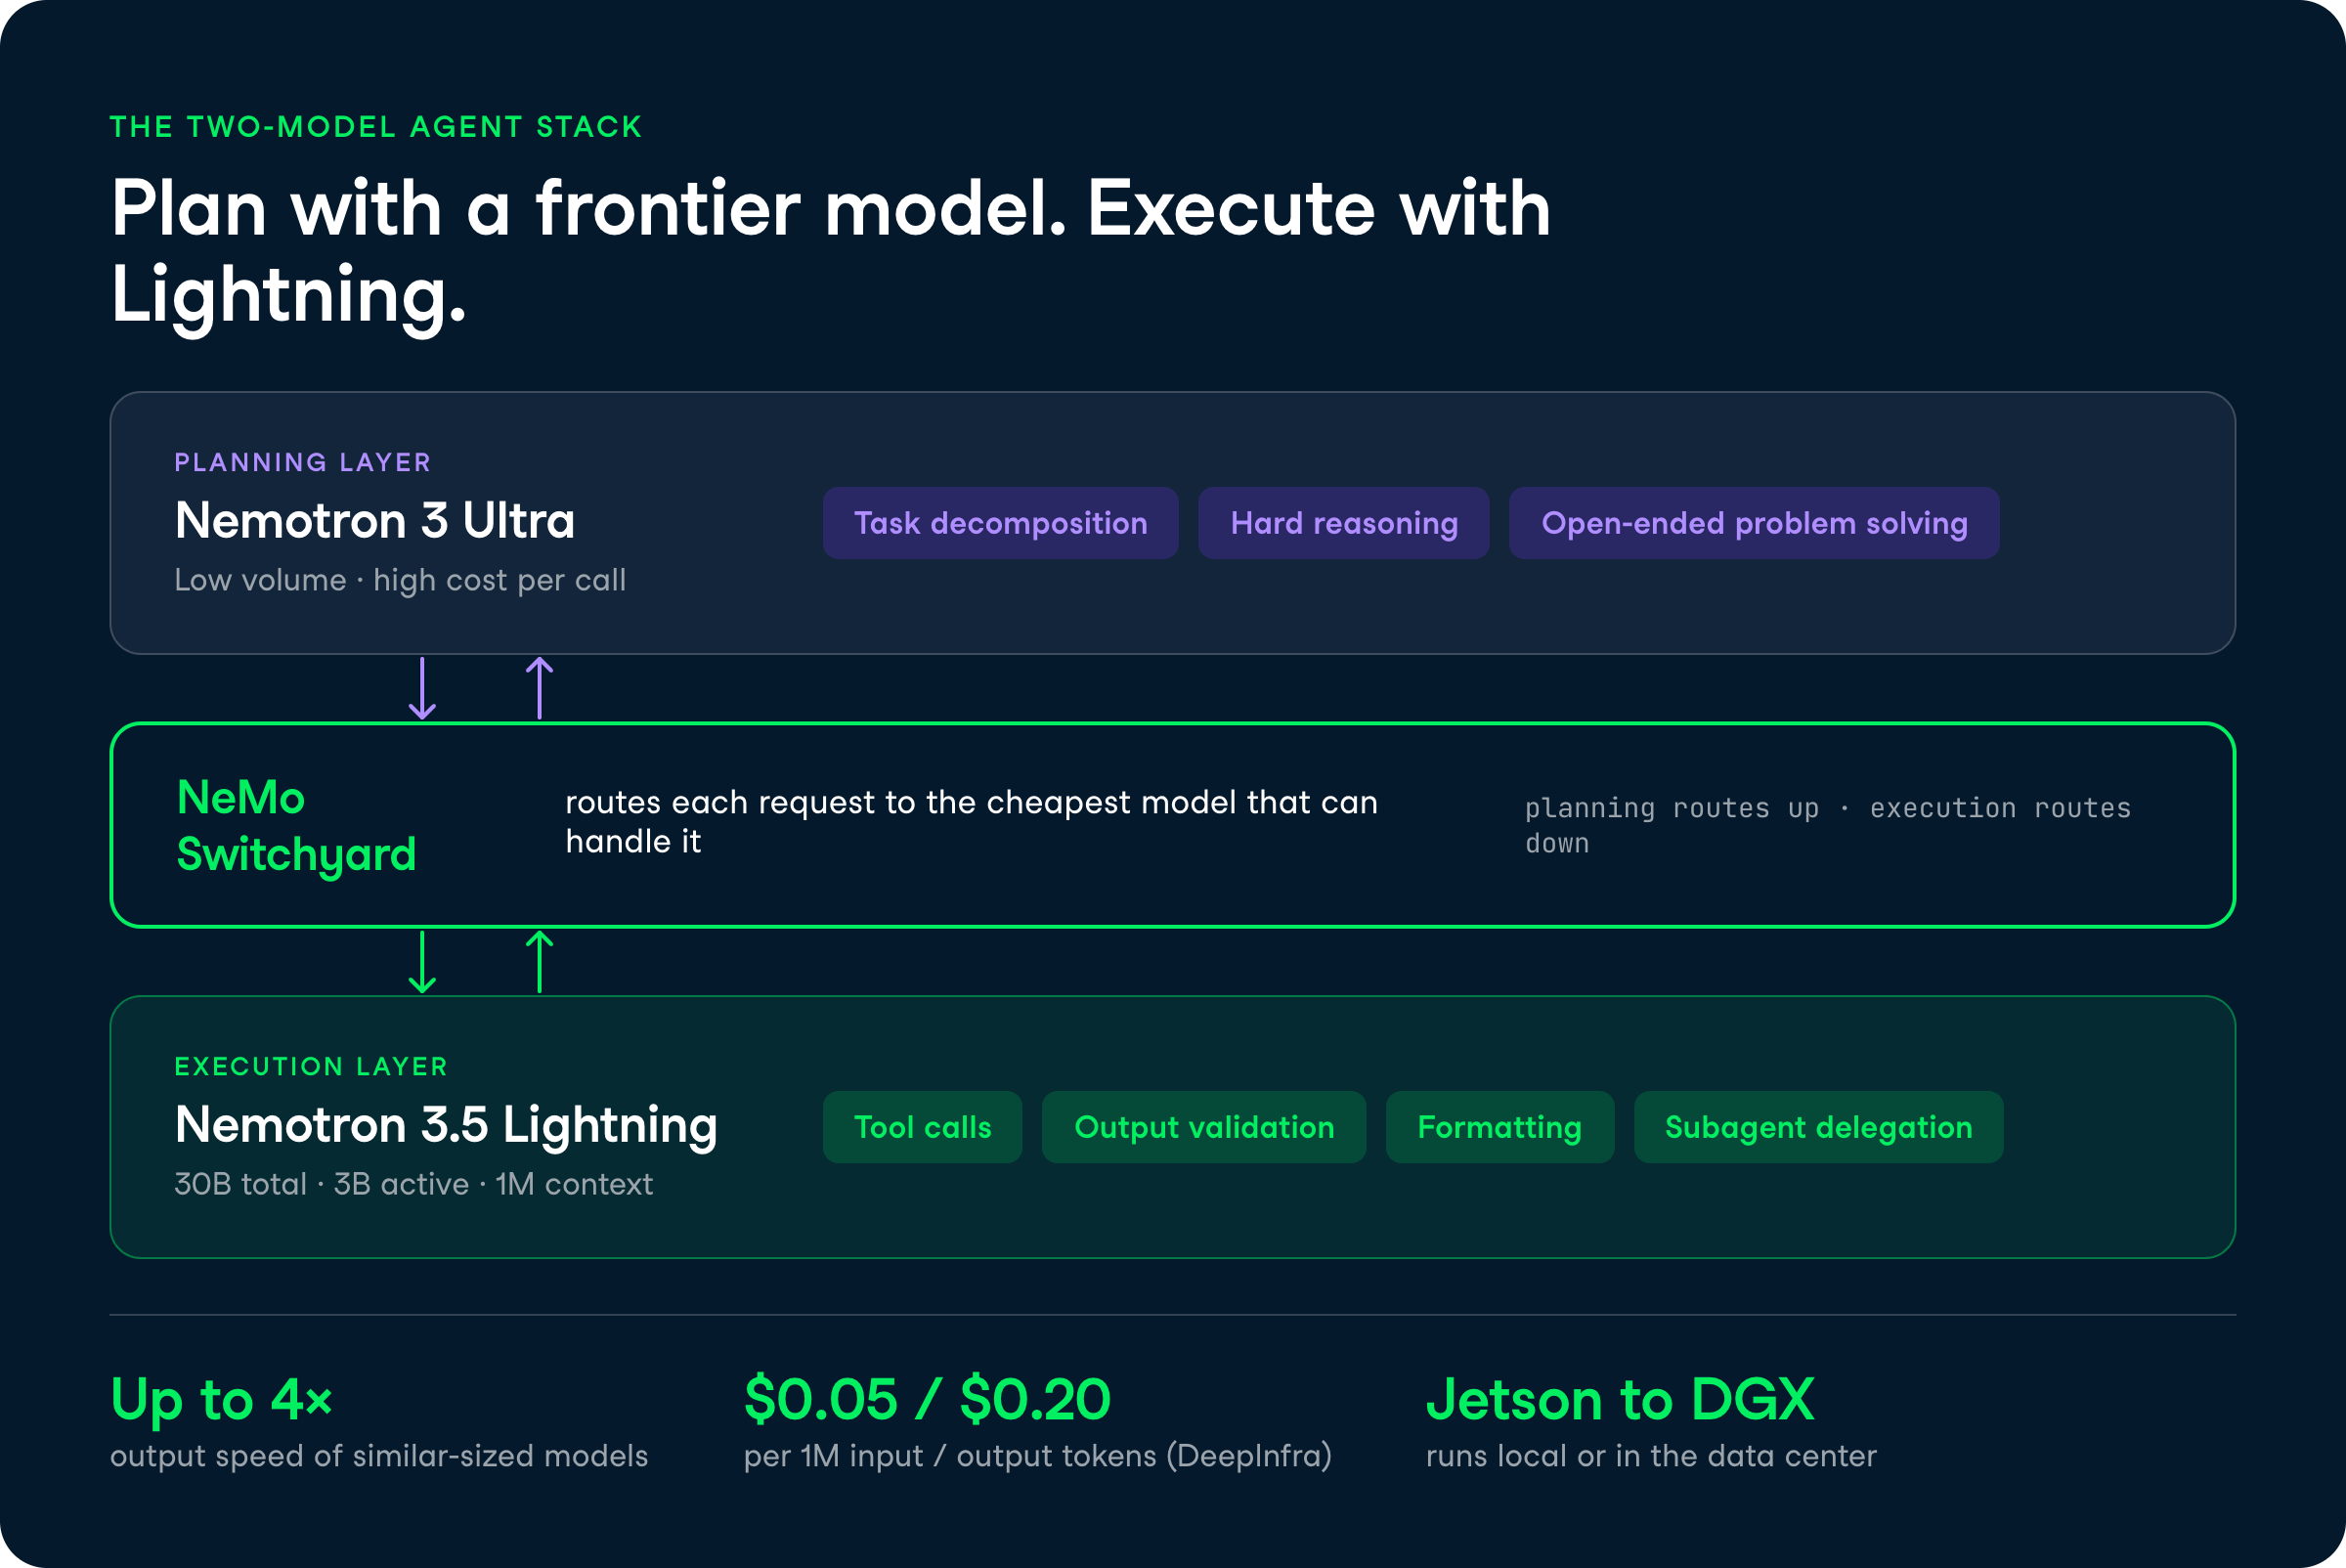
यहाँ सारी विशेषताएँ एक ही लक्ष्य की सेवा में हैं: किसी एजेंट के रूटीन काम को तेज़ी से चलाना, बिना सटीकता गिराए।
यह वह है जो आप वास्तव में इसके साथ कर सकते हैं।
क्योंकि मॉडल इतना छोटा है कि NVIDIA DGX Spark, GeForce RTX 5090, या Jetson पर डिप्लॉय हो सके, आप एजेंटिक वर्कलोड बिना डाटा सेंटर के डेस्कटॉप पर चला सकते हैं।
NVIDIA ने EXO Labs के साथ DGX Spark पर Lightning का प्रोफाइलिंग किया, और रिपोर्ट करता है कि यह EXO Labs local.ai लीडरबोर्ड पर छोटे ओपन मॉडलों के लिए पारेतो फ्रंटियर पर बैठता है।
व्यवहार में, इसका मतलब है कि टूल कॉल्स और रिज़ल्ट वैलिडेशन संभालने वाला हमेशा-ऑन एजेंट आपके मौजूदा हार्डवेयर पर चल सकता है।
आप इसे LM Studio, llama.cpp, Ollama, और Unsloth के ज़रिये भी सर्व कर सकते हैं, इसलिए लोकल टूलिंग कहानी लॉन्च पर ही परिपक्व है।
NVIDIA मॉडल के साथ NeMo Switchyard भी जारी कर रहा है, एक लाइब्रेरी जो प्रत्येक अनुरोध को उस सबसे कुशल मॉडल की ओर रूट करती है जो उसे संभाल सकता है।
Switchyard आपके ओपन और क्लोज़्ड मॉडलों के बराबर में Nemotron 3.5 Lightning को एक रूटिंग टार्गेट के रूप में एक्सपोज़ करता है, ताकि प्लानिंग Nemotron 3 Ultra जैसे फ्रंटियर मॉडल की ओर ऊपर रूट हो, जबकि निष्पादन Lightning की ओर नीचे।
व्यावहारिक लाभ है टोकन दक्षता।
एक git pull चलाने, किसी टूल आउटपुट को वैलिडेट करने, या किसी रिज़ल्ट को फ़ॉर्मैट करने के लिए फ्रंटियर-मॉडल दरें चुकाने के बजाय, वे कॉल्स सस्ते मॉडल पर उतरते हैं, और महंगा मॉडल उन कठिन प्लानिंग चरणों के लिए रिज़र्व रहता है जो गुणवत्ता पर हावी होते हैं, मात्रा पर नहीं।
छोटे मॉडल बड़े मॉडलों की तुलना में तेज़, सस्ते, और हल्के हार्डवेयर पर फाइन-ट्यून हो जाते हैं, और Lightning किसी विशिष्ट काम के अनुरूप ढलने के लिए ही बना है।
NVIDIA ने वेट्स, प्रशिक्षण डेटा, और रेसिपीज़ OpenMDW-1.1 के तहत जारी की हैं, और आप LoRA या NeMo Automodel और NeMo Megatron Bridge का उपयोग कर पूर्ण SFT के साथ फाइन-ट्यून कर सकते हैं, या NeMo RL और NeMo Gym के साथ रिइन्फोर्समेंट लर्निंग चला सकते हैं।
रिलीज़ में Nemotron-RL Agentic Terminal Pivot भी शामिल है, एक ओपन एजेंटिक RL डेटासेट, जिसका उपयोग कुछ कोडिंग-एजेंट व्यवहार को प्रशिक्षित करने के लिए किया गया।
यहाँ एक कम्युनिटी-फेसिंग दावा है जिसे रेखांकित करना उचित है।
MindStudio रिपोर्ट करता है कि पार्टनर फाइन-ट्यूनिंग ~$100 में 3 घंटे से कम में पूरी हुई, जो इसी आकार के मॉडल के साथ ही किफायती लगती है।
Lightning स्पेक्युलेटिव डिकोडिंग के माध्यम से प्रति स्टेप कई टोकन जेनरेट करता है, जहाँ एक ड्राफ्ट मॉडल टोकन प्रस्तावित करता है जिन्हें फिर कुशलतापूर्वक रिव्यू किया जाता है।
इसने मल्टी-टोकन प्रेडिक्शन (MTP) को मॉडल में पका देने के लिए एक समर्पित प्रीट्रेनिंग चरण पार किया, जिसके बाद एक MTP-बूस्टिंग चरण आया—वही अप्रोच जो Nemotron 3 Super और Ultra में उपयोग हुई।
MTP से आगे, NVIDIA दो ड्राफ्ट मॉडल शिप करता है।
DSpark को DGX Spark और लो-कनकरेंसी डाटा सेंटर वर्कलोड्स के लिए अनुशंसित किया गया है, जबकि MTP मीडियम-टू-हाई कनकरेंसी के लिए उपयुक्त है, और DFlash ड्राफ्ट मॉडल भी दिया गया है ताकि आप अपने सर्विंग पैटर्न के लिए सर्वश्रेष्ठ प्रदर्शन करने वाले को बेंचमार्क कर सकें।
NVIDIA BF16 और NVFP4 दोनों चेकपॉइंट्स के लिए स्कोर रिपोर्ट करता है, और अधिकांश टास्क में दोनों क़रीब-क़रीब ट्रैक करते हैं—जो मायने रखता है क्योंकि NVFP4 वह क्वांटाइज़्ड चेकपॉइंट है जिसे आप वास्तव में डिप्लॉय करेंगे। नीचे दिए गए नंबर NVIDIA के अपने मॉडल कार्ड और लॉन्च ब्लॉग से हैं। लेखन के समय किसी स्वतंत्र थर्ड-पार्टी पुनरुत्पादन उपलब्ध नहीं था, इसलिए इन्हें विक्रेता-प्रकाशित मानें।
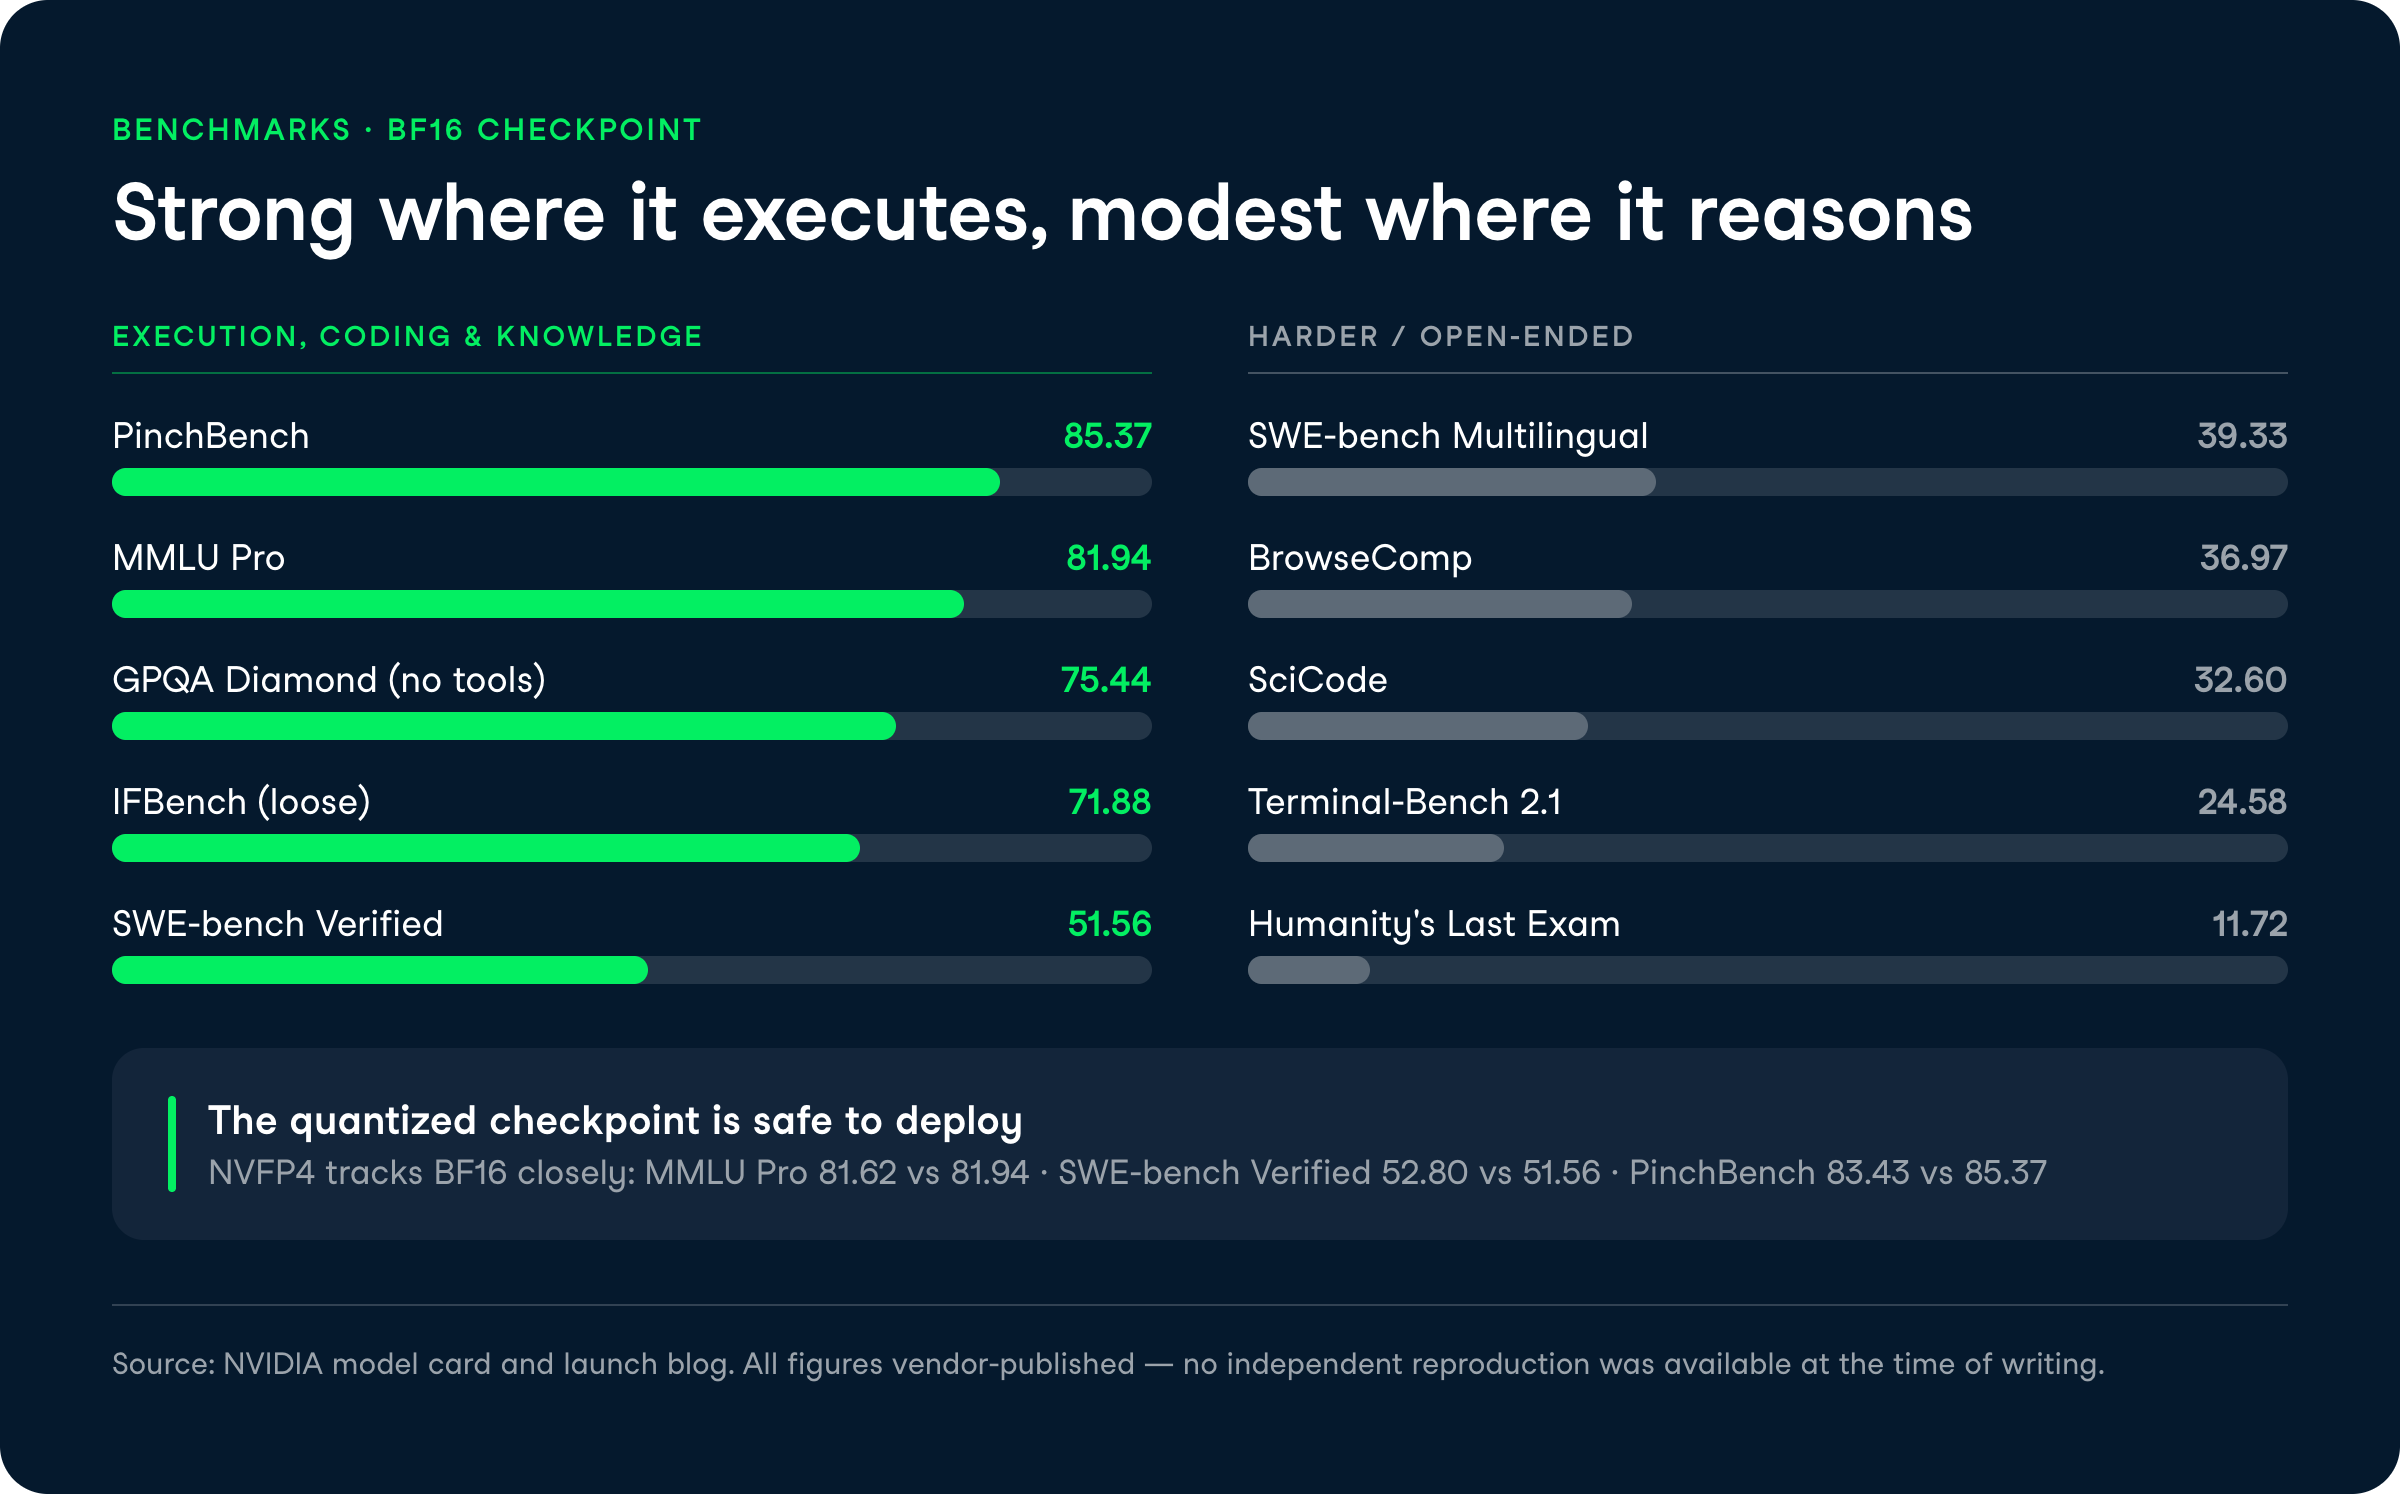
Lightning SWE-bench Verified पर 51.56 (BF16) और 52.80 (NVFP4) स्कोर करता है—एक बेंचमार्क जो मापता है कि क्या कोई मॉडल वास्तविक GitHub इश्यूज़ को काम करने वाले कोड पैच बनाकर सुलझा सकता है। 3B सक्रिय पैरामीटर वाले 30B MoE के लिए 50% से ऊपर जाना मज़बूत परिणाम है और सीधे कोडिंग-एजेंट के उपयोग केस का समर्थन करता है।
SWE-bench Multilingual 39.33 (BF16) पर कम आता है, जो अपेक्षित है क्योंकि बहुभाषी कोडबेस फैलाव ज़्यादा कठिन है।
PinchBench पर, Lightning 85.37 (BF16) और 83.43 (NVFP4) तक पहुँचता है, और OpenRouter रिपोर्ट करता है कि यह 10,000 टास्क Qwen3.6-35B की तुलना में 30% तेज़ पूरी करता है, सटीकता समान रहते हुए।
यही वह बेंचमार्क है जो मॉडल की असल पिच को सबसे अच्छे से पकड़ता है, क्योंकि एजेंट दक्षता इस पर उतरती है कि कोई मॉडल उपयोगी काम कितनी जल्दी पूरा करता है, न कि कच्ची टोकन जेनरेशन स्पीड पर।
Qwen3.6 की तुलना पर ठहरना उचित है। जब हमने Qwen3.6-35B-A3B की समीक्षा की, तो हमने इसके 3B सक्रिय पैरामीटर और मज़बूत SWE-bench और Terminal-Bench प्रदर्शन पर ध्यान दिया था, इसलिए NVIDIA का इसे रेफ़रेंस पॉइंट चुनना उसी आकार वर्ग में समान-से-समान तुलना है।
Lightning GPQA Diamond पर बिना टूल्स के 75.44 (BF16) स्कोर करता है—ग्रेजुएट-स्तरीय विज्ञान प्रश्नों का सेट, जो वेब एक्सेस के बावजूद गैर-विशेषज्ञों के लिए कठिन लिखा गया है।
यह छोटे मॉडल के लिए मज़बूत संख्या है, हालांकि मॉडल कार्ड स्पष्ट है कि Lightning को रीजनिंग इंजन के रूप में पोजिशन नहीं किया गया है।
Humanity's Last Exam (केवल टेक्स्ट, बिना टूल्स) दूसरी तस्वीर दिखाता है—11.72 (BF16), और SciCode 32.60 पर आता है।
ये कम स्कोर NVIDIA की फ़्रेमिंग के अनुरूप हैं: यह एक निष्पादन मॉडल है, और कठिन ओपन-एंडेड रीजनिंग को इसके बजाय किसी फ्रंटियर मॉडल की ओर रूट करना है।
Terminal-Bench 2.1 24.58 (BF16) पर आता है और BrowseComp 36.97 पर, जबकि IFBench (loose) 71.88 तक पहुँचता है—दिखाता है कि मॉडल संरचित निर्देशों का विश्वसनीयता से पालन करता है।
जनरल नॉलेज भी टिकती है—MMLU Pro 81.94 (BF16) और 81.62 (NVFP4) पर—एक नगण्य अंतर, जो पुष्टि करता है कि क्वांटाइज़्ड चेकपॉइंट डिप्लॉय करने के लिए सुरक्षित है।
दोनों MoE मॉडल हैं जिनमें 3B सक्रिय पैरामीटर हैं और कोडिंग व एजेंटिक वर्कलोड्स को लक्ष्य बनाते हैं, इसलिए साइड-बाय-साइड तुलना सबसे साफ़ तरीका है यह देखने का कि Lightning कहाँ फिट बैठता है।
| गुण | Nemotron 3.5 Lightning | Qwen3.6-35B-A3B |
|---|---|---|
| कुल / सक्रिय पैरामीटर | 30B / 3B | 35B / 3B |
| कॉन्टेक्स्ट विंडो | 1M टोकन तक | 262K टोकन |
| SWE-bench Verified | 51.56 (BF16) | मज़बूत (हमारी समीक्षा के अनुसार) |
| लाइसेंस | OpenMDW-1.1 (ओपन) | ओपन |
| पोजिशनिंग | एजेंट्स की निष्पादन लेयर | कोडिंग, रीजनिंग, लंबा कॉन्टेक्स्ट |
आप Nemotron 3.5 Lightning को build.nvidia.com पर या OpenRouter के माध्यम से आज़मा सकते हैं, और वेट्स Hugging Face और ModelScope से डाउनलोड कर सकते हैं। मॉडल NVIDIA NIM के ज़रिये OpenAI-संगत एंडपॉइंट्स एक्सपोज़ करता है—जैसे /v1/chat/completions, /v1/completions, और /v1/responses—ताकि यह मौजूदा एजेंटिक पाइपलाइन्स में बिना री-राइट के फिट हो जाए।
होस्टेड प्राइसिंग प्रदाता के अनुसार बदलती है:
OpenRouter का यह कैप ध्यान रखने योग्य है। 1M कॉन्टेक्स्ट लंबाई मॉडल की क्षमता है, लेकिन आपको जो व्यावहारिक सीमा मिलती है वह प्रदाता और रूट पर निर्भर करती है, इसलिए पूरा विंडो मानकर चलने से पहले एंडपॉइंट जाँच लें।
Nemotron 3.5 Lightning NVIDIA की एक विशेष शर्त है: कि प्रोडक्शन एजेंट्स का भविष्य मॉडलों की एक प्रणाली है—जहाँ सस्ता निष्पादन मॉडल वॉल्यूम संभालता है और फ्रंटियर मॉडल प्लानिंग करता है। उसी लॉन्च में NeMo Switchyard जारी होना इस बात का संकेत है, क्योंकि मॉडल तभी मायने रखता है जब आप काम को बुद्धिमानी से इसकी ओर रूट कर सकें।
मेरे लिए सबसे उपयोगी बात दायरे के बारे में ईमानदारी है। NVIDIA यह दिखावा नहीं कर रहा कि यह एक रीजनिंग मॉडल है, और बेंचमार्क्स इसे साबित करते हैं: SWE-bench Verified (51.56) और PinchBench (85.37) पर मज़बूत, Humanity's Last Exam (11.72) पर विनम्र। यदि आपका वर्कलोड हमेशा-ऑन एजेंट्स पर टूल कॉल्स, वैलिडेशन, और फ़ॉर्मैटिंग है, तो यही सही समझौता है।
OpenMDW-1.1 के तहत वेट्स, डेटा, और रेसिपीज़ के साथ ओपन रिलीज़, साथ ही इतना छोटा चेकपॉइंट कि DGX Spark पर चल सके—यह उन टीमों के लिए वास्तव में उपयोगी है जो प्रति टोकन भुगतान करने के बजाय फाइन-ट्यून करना और सेल्फ-होस्ट करना चाहती हैं। मुख्य सावधानियाँ: फिलहाल सभी बेंचमार्क नंबर विक्रेता-प्रकाशित हैं, इसलिए 4x स्पीड और 30% तेज़-कम्प्लीशन के दावों को अंतिम मानने से पहले मैं स्वतंत्र पुनरुत्पादन देखना चाहूँगा।
यदि आप अपने वर्कलोड के लिए ऐसे मॉडल को अनुकूलित करने की फाइन-ट्यूनिंग स्किल्स बनाना चाहते हैं, तो हमारा ट्यूटोरियल मेडिकल Q&A डेटासेट पर Qwen3.6 का फाइन-ट्यूनिंग तुलनीय MoE मॉडल पर QLoRA वर्कफ़्लो को चरण-दर-चरण कवर करता है।
शीर्ष DataCamp पाठ्यक्रम
लर्निंग पाथ
कोर्स
कोर्स
