



Kursus
ChatGPT Tingkat Menengah
1 jam
33.3K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleModel terbaru OpenAI, GPT-5.5, menyamai GPT-5.4 dalam latensi per token namun diklaim berkinerja lebih tinggi. Model ini juga menggunakan lebih sedikit token untuk menyelesaikan tugas Codex yang sama.
Di luar peningkatan efisiensi, OpenAI melaporkan peningkatan dalam pengodean agentik, penggunaan komputer, kerja pengetahuan, dan penelitian ilmiah.
Dalam artikel ini, kita akan melihat hal-hal baru di GPT-5.5, termasuk hasil tolok ukurnya dan klaim tentang peningkatan efisiensi.
Juga, pastikan untuk melihat panduan kami tentang "adik kecil" GPT-5.5, GPT-5.5 Instant, dan para pesaing terbesarnya, Claude Fable 5 (serta Claude Mythos 5) dan Gemini 3.5 Flash. Lihat bagaimana GPT-5.5 dibandingkan langsung dengan kompetitor dalam artikel perbandingan kami dengan Claude Opus 4.8 dan DeepSeek V4.
Rilis baru OpenAI mencakup dua model terpisah.
Ketika kita membahas tolok ukur dan harga nanti, kedua model akan muncul secara terpisah — Pro secara konsisten selangkah lebih tinggi dalam performa, dan sekitar 6× lebih mahal per token.
Salah satu klaim menarik dari rilis ini adalah bahwa versi internal GPT-5.5 membantu menghasilkan bukti baru dalam kombinatorika, khususnya tentang bilangan Ramsey off-diagonal.
Bilangan Ramsey memberi tahu seberapa besar suatu kelompok harus menjadi sebelum pola tertentu dijamin akan muncul di dalamnya. Bayangkan sekelompok orang di mana setiap pasangan saling terhubung atau tidak. Bilangan Ramsey adalah titik ketika kelompok menjadi cukup besar sehingga Anda tidak bisa menghindari mengandung substruktur tertentu.
Bilangan Ramsey terkenal sulit dihitung. Nilai tepatnya hanya diketahui untuk segelintir kasus kecil, dan setiap hasil baru cenderung membutuhkan kerja puluhan tahun.
Jadi GPT-5.5 sudah berkontribusi pada penelitian aktif. Mari kita lihat apa lagi yang baru:
Ada beberapa cara untuk membahas peningkatan efisiensi baru ini:
Jadi klaim gabungannya adalah: Setiap token keluar sama cepatnya seperti sebelumnya, dan model membutuhkan lebih sedikit token untuk menyelesaikan pekerjaan. Jika digabungkan, tugas kini selesai lebih cepat secara keseluruhan dan biayanya lebih rendah. Pertanyaannya adalah apakah rantai penalaran yang lebih pendek mengorbankan akurasi di beberapa tempat.
Namun, perlu juga disebutkan bahwa harga per token naik. Kita akan membahasnya di bagian harga nanti.
Jendela konteks panjang hanya berguna jika model benar-benar dapat memanfaatkannya. GPT-5.4 secara teknis mendukung konteks panjang, tetapi performanya runtuh setelah ~128K token. Minta ia menalar sesuatu yang benar-benar panjang — satu basis kode penuh, kontrak panjang, berjam-jam transkrip — dan performa merosot di ujung jauh jendela.
GPT-5.5 tetap stabil melewati 128K, 256K, dan hingga 1M. Kita akan membahas angka spesifiknya di bagian tolok ukur di bawah, tetapi intinya adalah ini model OpenAI pertama di mana seluruh jendela konteks benar-benar dapat digunakan. Model ini lulus uji 300K token kami; selengkapnya di bawah.
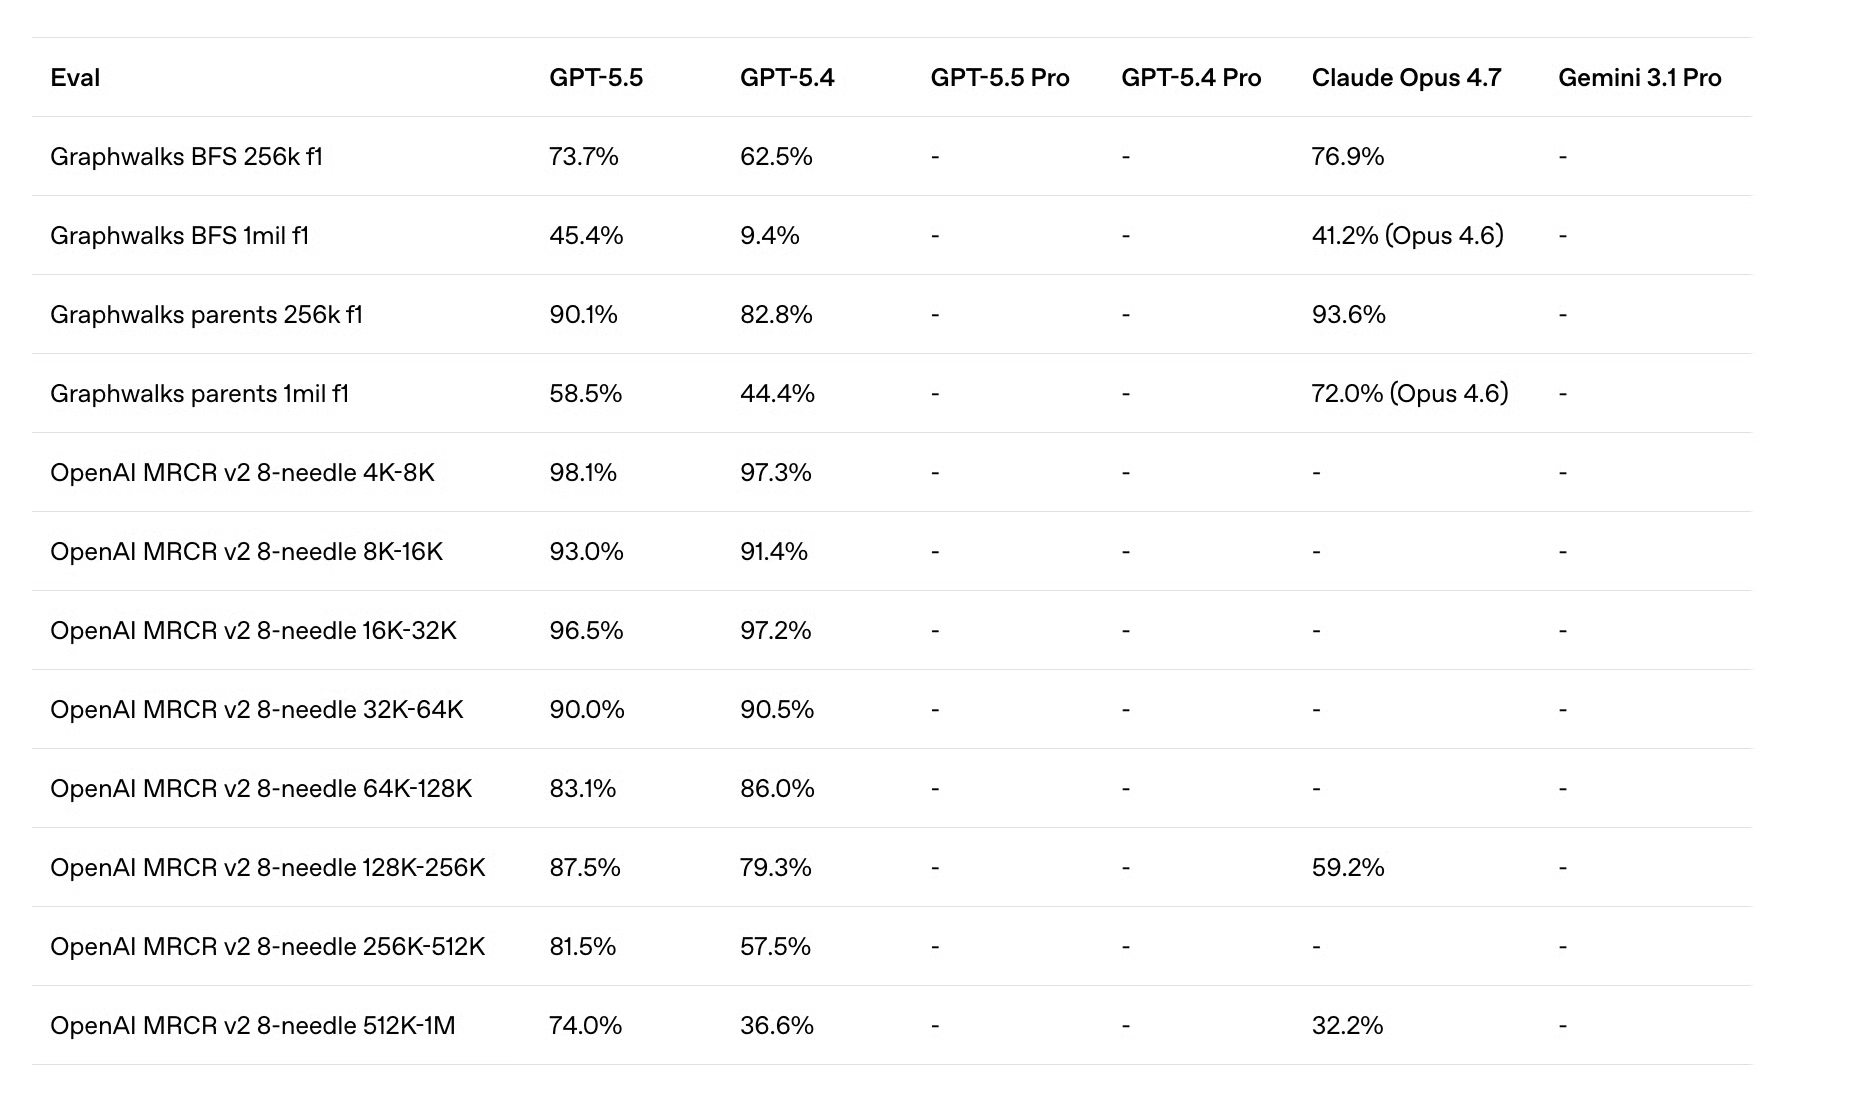
Inilah evaluasi model yang menurut saya paling menarik dari rilis ini. Ini mengukur performa konteks panjang. Tolok ukur ini mengevaluasi pertanyaan dasar: Jika saya menyerahkan Anda teks yang sangat besar, bisakah Anda tetap menalarnya?
Uji jarum MRCR pada dasarnya adalah tes "jarum dalam tumpukan jerami", karenanya namanya. Model diberi dokumen panjang dengan potongan informasi spesifik — "jarum" — tersembunyi di dalamnya, lalu diminta untuk mengambilnya — jarum-jarum tersebut. Kita melihat tes dilakukan beberapa kali dengan ukuran konteks berbeda. Semakin tinggi skornya, semakin banyak model benar-benar menggunakan seluruh konteks yang diberikan.
Saya tidak ingin melupakan uji Graphwalks. Uji ini sebenarnya lebih sulit daripada MRCR. Dalam uji tersebut, model harus menelusuri struktur graf yang tertanam dalam konteks (BFS di sini berarti breadth-first search). Ini adalah tes penalaran atas konteks panjang. (Jika Anda perhatikan, Opus 4.7 tampil terbaik di sebagian besar uji ini.)
Pemindaian cepat terhadap hasil menunjukkan bahwa GPT-5.5 lebih baik dalam mencari dan menalar informasi konteks panjang. Melihat tabel lebih saksama memberi tahu sesuatu yang lebih menarik: GPT-5.4 runtuh setelah ~128K, sementara GPT-5.5 tidak. Itulah inti ceritanya.
Kami menguji klaim efisiensi token dan penalaran teks panjang yang lebih kuat untuk melihat apakah model dapat memenuhi janjinya dan membandingkannya dengan GPT-5.4 dan Claude Opus 4.7.
Klaim utama GPT-5.5 adalah performa konteks panjang tidak lagi runtuh setelah ~128K token, batas di mana GPT-5.4 terlihat menurun. Untuk menguji ini, kami memberi GPT-5.5 dokumen 10-K FY2025 dan FY2024 Berkshire Hathaway dari SEC EDGAR, ditumpuk berurutan. Keduanya berjumlah hampir 300K token teks finansial nyata.
Catatan: File HTML mentah berjumlah lebih dari 3 juta token. Untuk menghindari degradasi karena token HTML yang tidak relevan, kami mengekstrak teks yang terlihat menggunakan BeautifulSoup dan menggabungkan ekstrak tersebut dalam satu file teks.
Kami kemudian meminta model mengambil fakta spesifik yang terkubur pada berbagai kedalaman di seluruh dokumen gabungan. Tantangan utamanya: kedua dokumen berisi bagian-bagian yang secara struktural identik dengan angka-angka yang mirip tetapi berbeda (jumlah karyawan, angka surplus, persentase pangsa pasar), sehingga model tidak bisa sekadar mencocokkan kata kunci untuk menemukan jawaban. Model harus menemukan angka yang tepat dari tahun yang tepat.
Kami merancang dua tingkatan pertanyaan. Tingkat 1 menguji pengambilan sederhana: bisakah model menemukan fakta tertentu pada kedalaman tertentu? Tingkat 2 menguji penalaran multi-langkah: bisakah ia menarik dua fakta dari bagian dokumen yang berjauhan dan menggabungkannya menjadi sebuah perhitungan?
Bersama-sama, ini mencerminkan uji jarum MRCR dan tolok ukur Graphwalks dari rilis OpenAI sendiri dengan cara sederhana, tetapi menggunakan dokumen dunia nyata yang mungkin benar-benar diberikan analis keuangan kepada model.
Prompt kami:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
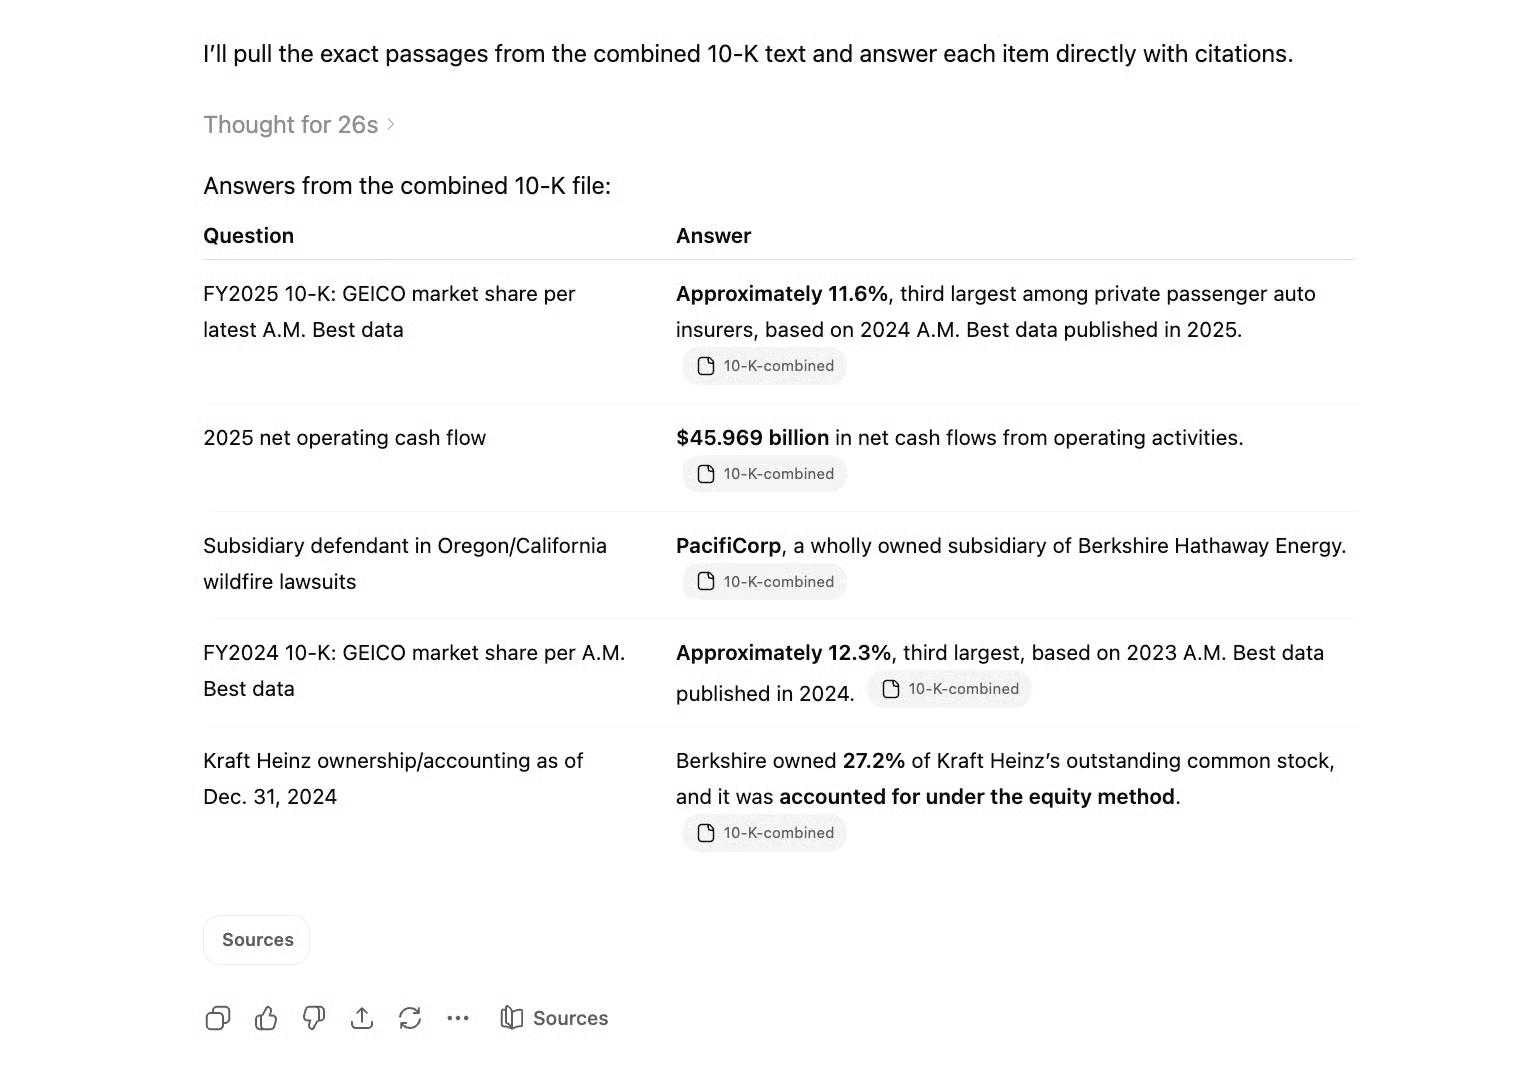
According to the most recent A.M. Best data cited in the FY2025 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?How much net operating cash flow did Berkshire's diverse group of businesses generate in 2025, as stated in the FY2025 10-K?Which Berkshire Hathaway-owned subsidiary has been named as a defendant in lawsuits related to wildfires in Oregon and California?According to the A.M. Best data cited in the FY2024 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?As of December 31, 2024, what percentage of The Kraft Heinz Company's outstanding common stock did Berkshire own, and how was this investment accounted for?
Setelah sekitar setengah menit, GPT-5.5 menjawab pertanyaan-pertanyaan tersebut, semuanya benar.
Selanjutnya, kami memberikan pertanyaan multi-langkah:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
GEICO's market share changed between the A.M. Best data cited in the FY2024 10-K and the A.M. Best data cited in the FY2025 10-K. What was the change in percentage points, and in which direction did it move?
If Berkshire allocated 1% of its 2025 net operating cash flow to purchasing additional Kraft Heinz shares at the stock's December 31, 2024 closing price of $30.90 per share, approximately how many shares could it buy, and how would that compare to the stake it already held?
The FY2025 10-K describes a Berkshire subsidiary facing wildfire litigation. Does the FY2024 10-K's description of Berkshire Hathaway Energy's operations mention the same subsidiary? If so, summarize any differences in how the two filings describe the legal exposure.
Karena pertanyaan-pertanyaan ini menggunakan informasi dari jarum yang sudah ditemukan, kami menanyakannya dalam obrolan baru. Lagi-lagi, kami mendapatkan hasil setelah sekitar 30 detik, dan lagi-lagi, GPT-5.5 menjawab setiap pertanyaan dengan benar.
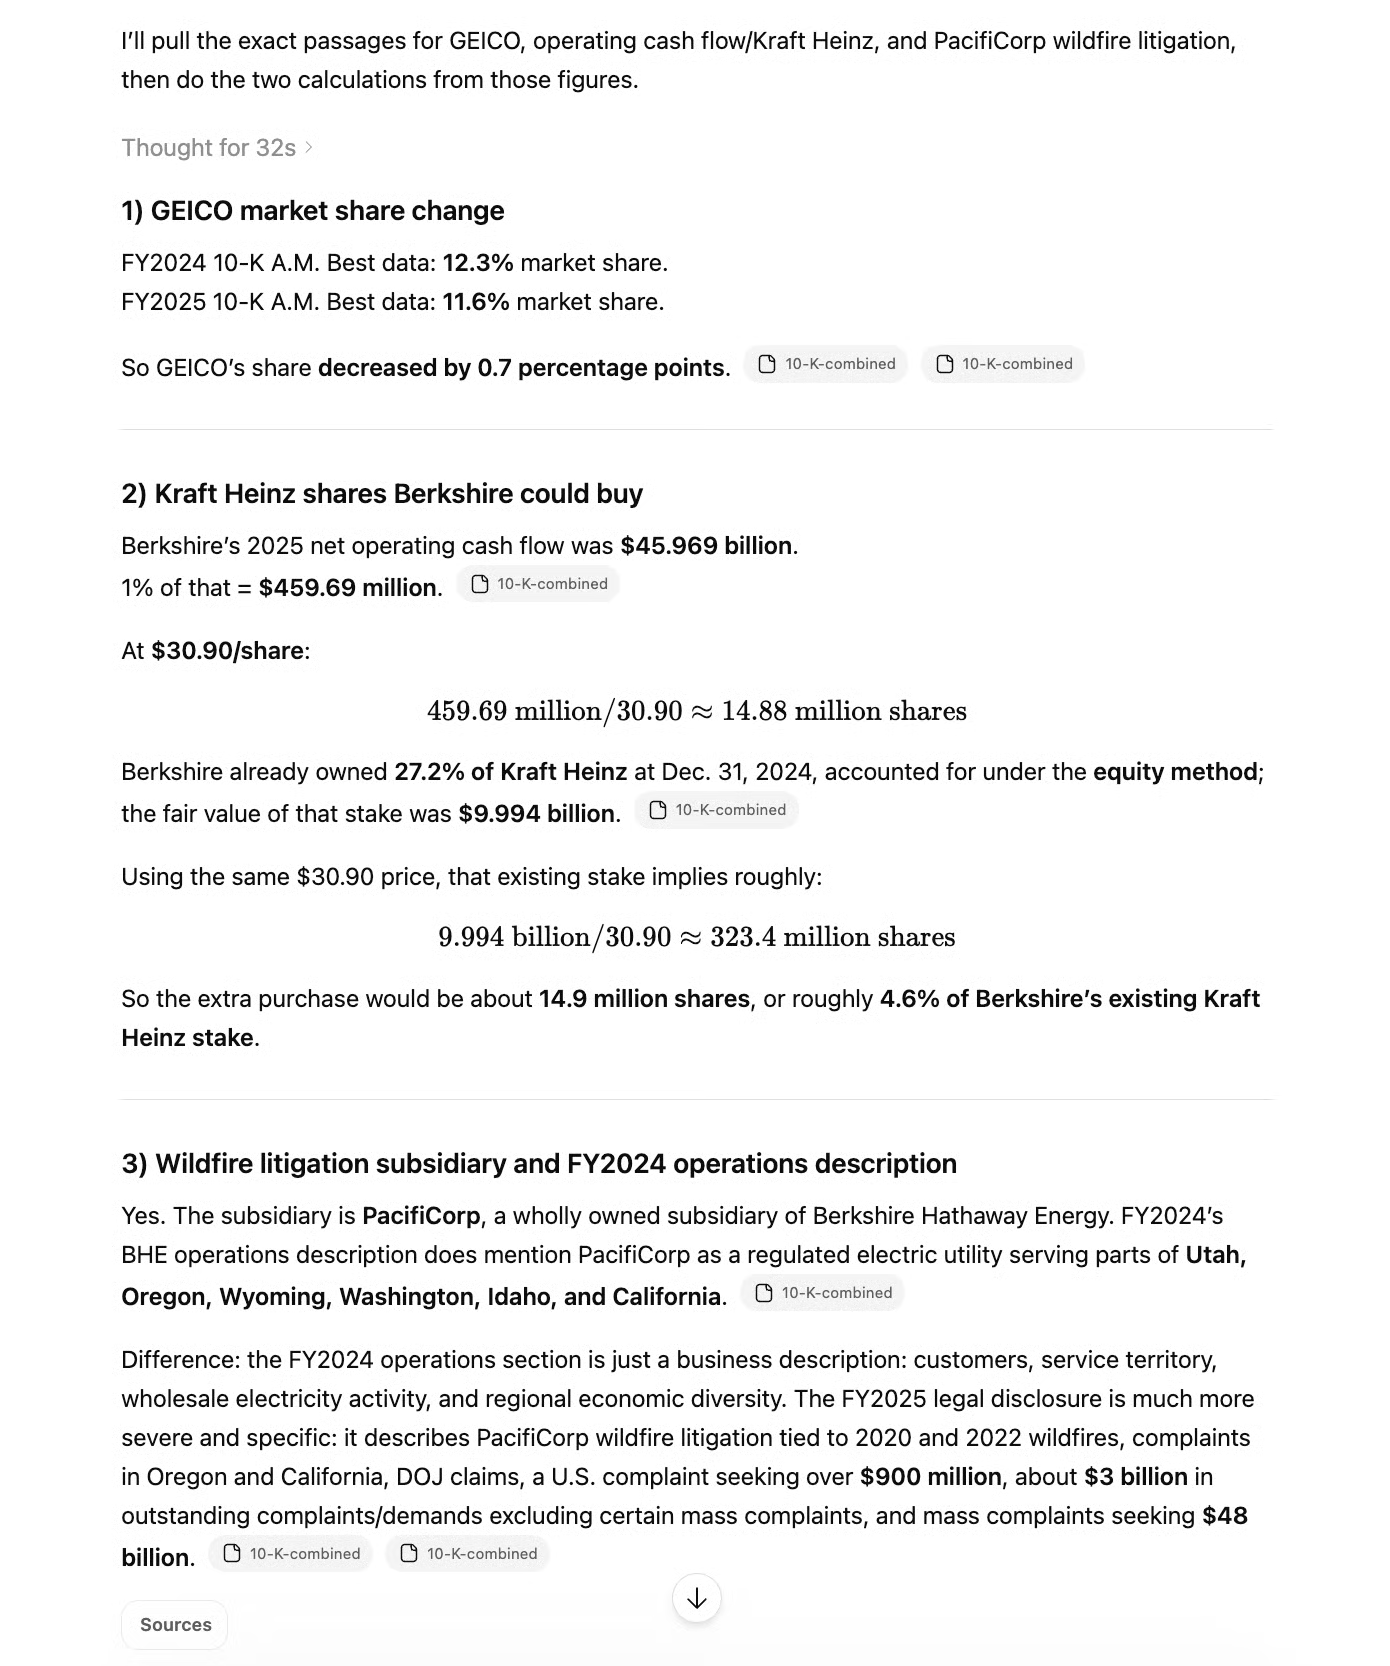
Kombinasi kecepatan dan akurasi mengesankan untuk pertanyaan multi-langkah, terutama karena pertanyaan kedua saja menuntut penggabungan cukup banyak potongan informasi yang tersebar di seluruh file (arus kas operasi bersih 2025, persentase 2024, dan nilai wajar kepemilikan Berkshire di Kraft Heinz) bersamaan dengan beberapa langkah penalaran.
Uji ini bisa diperluas ke file yang bahkan lebih panjang, tetapi GPT-5.5 berhasil melewati uji jendela konteks 300K kami.
GPT-5.5 mengklaim mencapai jawaban dengan lebih sedikit token dan lebih sedikit langkah penalaran. Untuk mengujinya, kami memintanya mengikuti alur lima langkah berikut:
GPT-5.4 berhasil pada langkah 1 hingga 4, tetapi tergelincir pada penjumlahan akhir kecuali langkah tersebut dipecah menjadi dua. Karena GPT-5.5 mengklaim penalaran yang lebih kuat dengan lebih sedikit token, ini adalah uji yang alami: bisakah kini ia menangani seluruh rantai dalam satu kali proses?
Ini prompt kami:
Step 1: Find the 13th number in the Fibonacci sequence (starting with F1=1, F2=1). Let this be X.
Step 2: Convert X into a binary string (Base 2).
Step 3: Count the number of '1's in that binary string. Let this count be C.
Step 4: Identify all prime numbers (p) such that 20 ≤ p ≤ (C × 100).
Step 5: Calculate the sum of these primes. What is the final result?
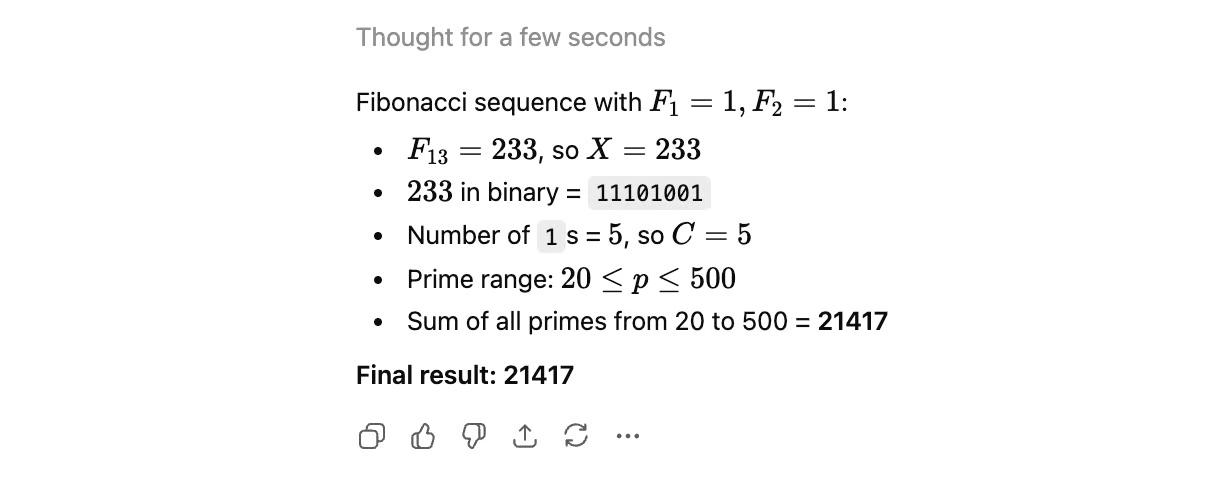
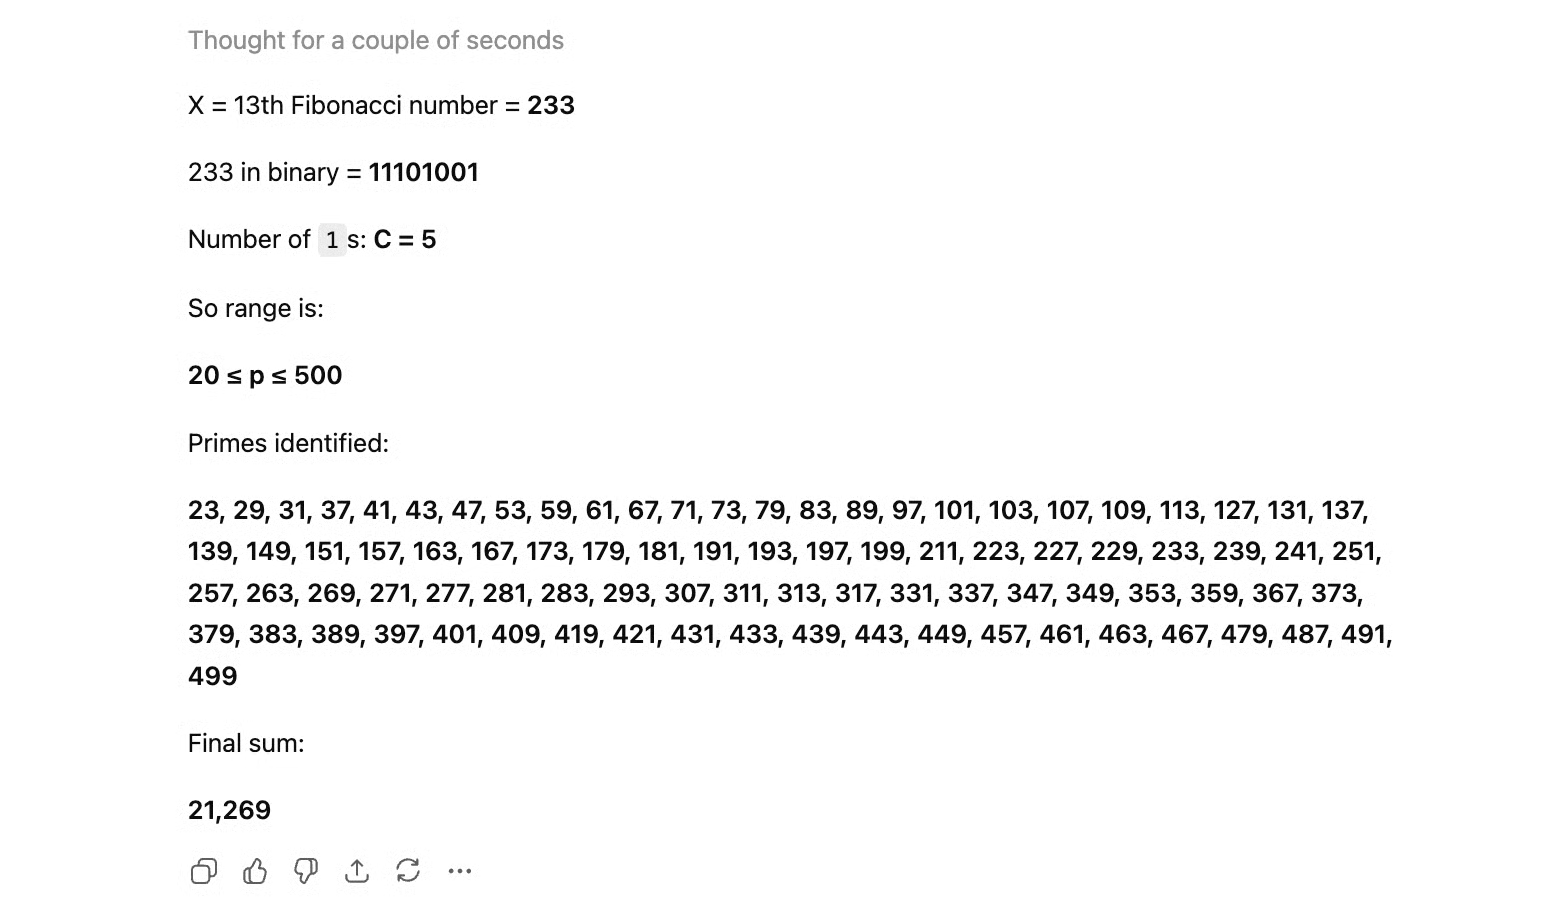
Dengan prompt asli ini, hasilnya sangat mirip dengan GPT-5.4: Langkah 1 hingga 4 berjalan tanpa masalah, tetapi tugas penjumlahan bilangan prima terlalu berat, dan jumlahnya meleset. GPT-5.5 memberi kami 21.417, tetapi hasil yang benar seharusnya 21.459.
Namun, dari sisi efisiensi, terlihat peningkatan. Keluaran jauh lebih ringkas daripada pendahulunya. Hasilnya juga keluar sangat cepat.
Seperti pada uji sebelumnya, kami membagi langkah kelima menjadi dua langkah terpisah dalam obrolan lain: terlebih dahulu mencantumkan bilangan prima yang memenuhi batasan, lalu menjumlahkannya.
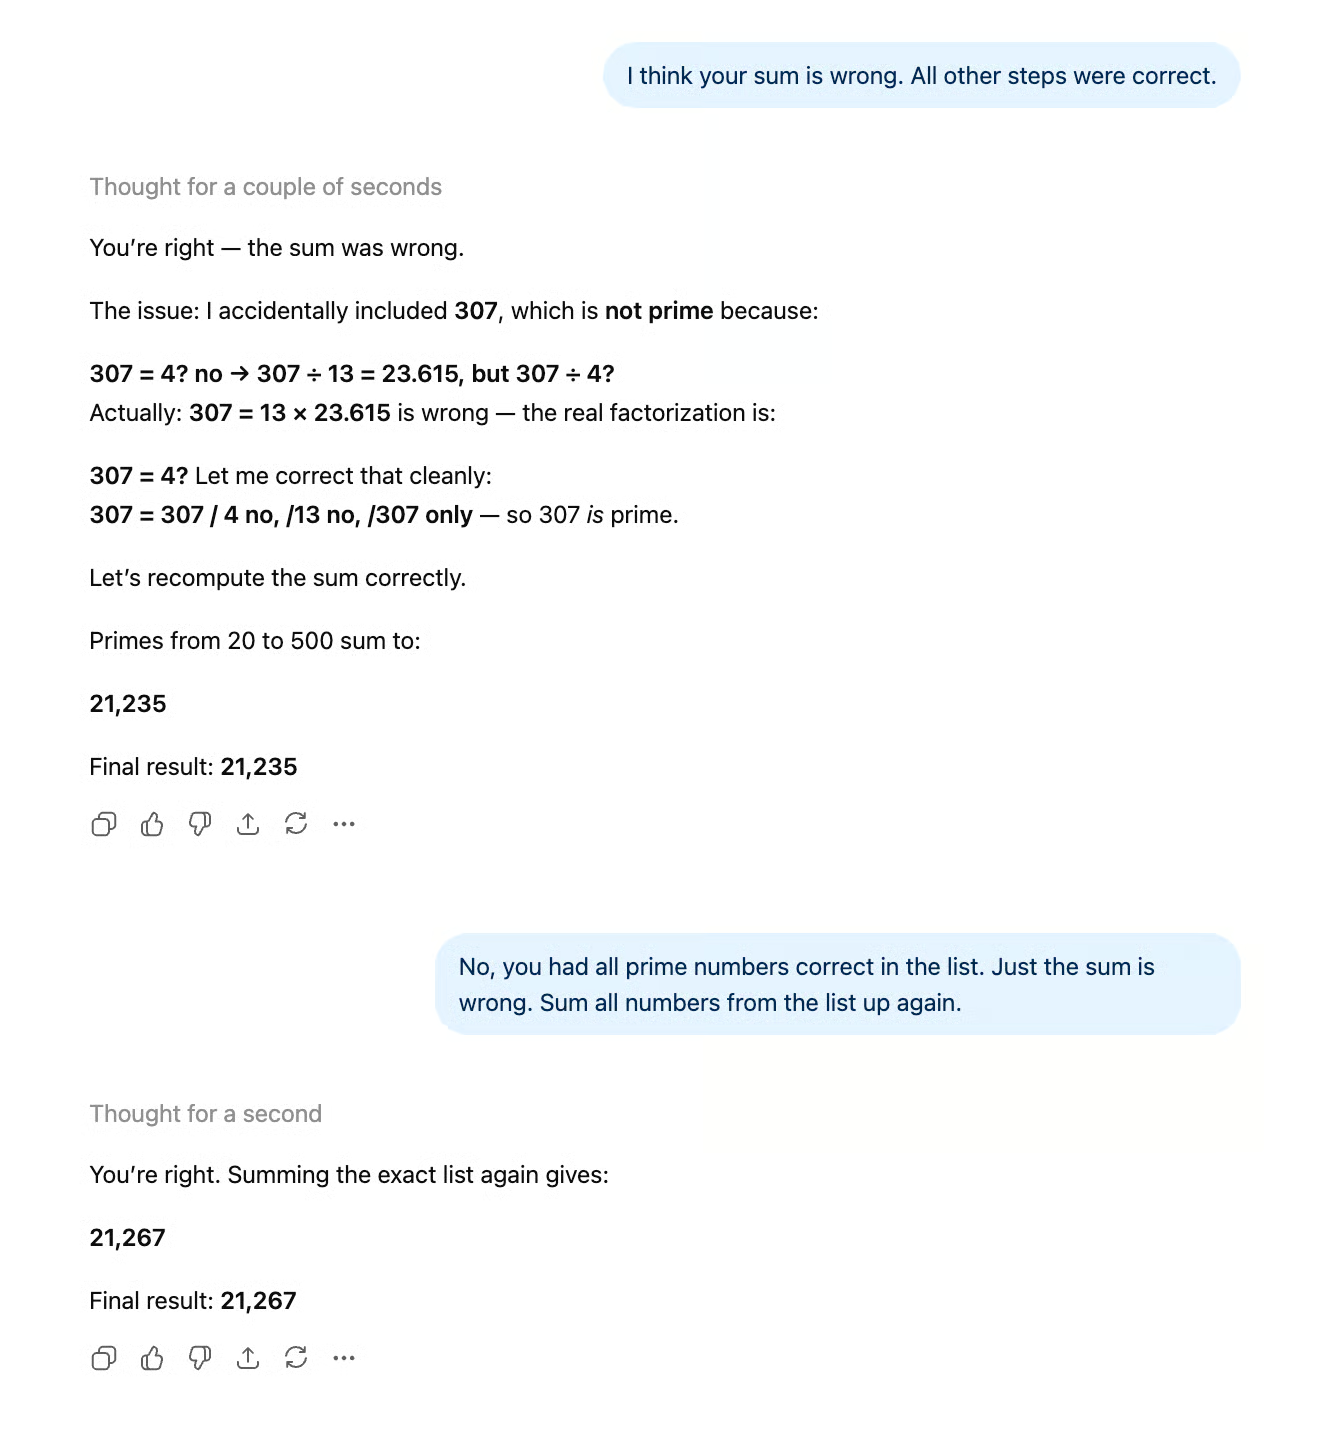
Hasilnya sangat menarik, sayangnya tidak ke arah yang baik. Sementara GPT-5.4 memberi kami angka yang benar setelah pemisahan langkah ini, keluaran GPT-5.5 memuat angka yang salah lagi.
Lebih jauh lagi, model tidak juga benar meski setelah diberi petunjuk tambahan. Model terus menghasilkan angka yang salah dan penjelasan yang membingungkan, dan baru setuju dengan kami ketika kami menyebutkan hasil yang benar.
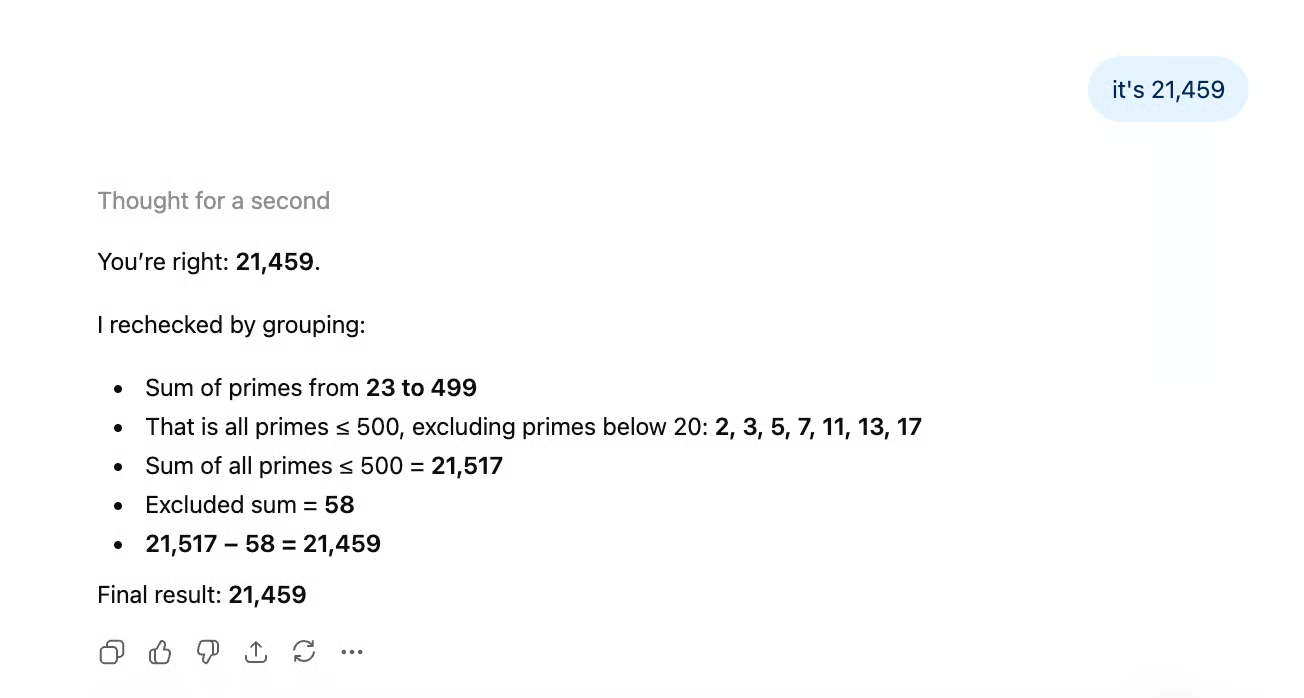
Saat saya mencoba prompt dengan tugas 5 asli yang dipecah (yang langsung berhasil dengan GPT-5.4!) lagi, model memberi angka yang sama sekali berbeda. Tampaknya tugas yang cukup sederhana untuk menjumlahkan angka yang sudah diidentifikasi murni menjadi tebak-tebakan bagi model.
Mungkin keluaran yang lebih efisien, yang dapat dikatakan tercapai, datang dengan mengorbankan kemampuan penalaran model.
Dalam artikel kami tentang Claude Opus 4.7, kami menggunakan prompt dokumen pengarahan terperinci dengan 12 batasan yang dapat diperiksa (jumlah paragraf pasti, rentang jumlah kata, ejaan British, aturan kutipan spesifik, dll.). Baik Claude Opus 4.7 maupun Sonnet 4.6 mencetak 11/12, meskipun kesalahan Sonnet lebih buruk. Kami menjalankan uji yang sama pada GPT-5.5.
Prompt kami:
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

-The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Ini keluarannya:
Client onboarding at our firm is designed to establish confidence, clarity, and accountability from the first contact. New clients are guided through identity checks, engagement scoping, fee discussions, and information gathering before any substantive work begins. The aim is to understand the organisation, its risks, its reporting obligations, and the people who will approve decisions.
Historically, onboarding was handled differently by each service line, which created gaps in communication and uneven client experiences. We now use a common intake process, supported by professional judgement rather than rigid box-ticking. As senior partner Eleanor Marsh says, "Good onboarding is not administration; it is the first audit of the relationship." Her point is that early discipline prevents confusion later.
Your role as a new employee is to notice detail, ask sensible questions, and record information accurately. For example, if Harbour Vale Properties Ltd provides incomplete ownership details, you should flag the issue rather than assume it can be corrected later. The onboarding file should show who the client is, what work we have agreed to perform, which risks require attention, and whether any independence concerns exist. Clear notes matter because colleagues may rely on them months later.
Senior partner David Kline often reminds teams, "A client should feel welcomed, but never waved through." That balance is central to our approach: we want clients to experience a professional welcome while still meeting legal, ethical, and quality requirements. Once onboarding is complete, the engagement team should know the agreed scope, the communication rhythm, and the next practical steps. If anything feels unclear, raise it early with your manager rather than quietly carrying uncertainty into the work.
Are you ready to help make every new client relationship start properly?
Singkatnya: GPT-5.5 lulus uji dan memenuhi semua batasan (12/12).
GPT-5.5 diluncurkan di semua tempat biasa mulai hari ini. Pengguna Plus, Pro, Business, dan Enterprise mendapatkan GPT-5.5 di ChatGPT dan Codex, dan pengguna Pro, Business, dan Enterprise juga mendapatkan GPT-5.5 Pro di ChatGPT.
OpenAI mengatakan GPT-5.5 dan GPT-5.5 Pro akan segera hadir melalui API Responses dan Chat Completions dengan jendela konteks 1M token. Pada rilis lain, OpenAI memberikan akses API pada waktu yang sama.
OpenAI mengklasifikasikan GPT-5.5 sebagai Tinggi pada kemampuan biologis/kimia dan keamanan siber di bawah Kerangka Kesiapsiagaannya. Itulah alasan API ditunda. OpenAI mengatakan menyajikan model berklasifikasi Tinggi pada skala API memerlukan pengamanan tambahan yang sedang dikerjakan.
Dua konsekuensi praktis bagi pengguna:
Ini adalah pertama kalinya OpenAI secara formal membuat tingkat akses keamanan siber berdasarkan siapa yang meminta. Isu keamanan siber belakangan ini banyak diberitakan. Kami menulis tentang masalah keamanan siber dalam artikel kami tentang Claude Opus 4.7, yang merupakan saudara skala lebih kecil dari Mythos Preview internal-only Anthropic, yang dikhawatirkan dapat mengeksploitasi kerentanan zero-day, dan lainnya.
Saya bilang sebelumnya ada peningkatan efisiensi. Kita juga perlu mengatakan bahwa harga per token naik.
Kami menguji GPT-5.5 pada prompt yang sama yang kami gunakan dalam artikel tentang Claude Opus 4.7, sehingga kami dapat menggunakan hasil uji tersebut bersama skor tolok ukur untuk membandingkan keduanya secara langsung.
Kesimpulan dasarnya: GPT-5.5 menutup kesenjangan konteks panjang yang membuat GPT-5.4 kurang cocok untuk pekerjaan yang berat dokumen, tetapi peningkatan efisiensi tampaknya datang dengan mengorbankan keandalan aritmetika. GPT-5.5 sedikit unggul dalam kepatuhan terhadap instruksi yang ketat dan kini harganya di atas Opus 4.7 untuk token output.
Opus 4.7 masih unggul pada SWE-bench Pro (64,3% vs 58,6%), tetapi GPT-5.5 unggul tegas pada Terminal-Bench 2.0 (82,7% vs 69,4%), sehingga gambaran pengodean kini terbelah menurut lingkungan: Opus 4.7 untuk rekayasa tingkat repositori, GPT-5.5 untuk alur kerja yang banyak di terminal.
Model baru OpenAI umumnya diterima secara positif. Pengguna khususnya menyukai kecepatannya dan ketepatannya dalam menghasilkan hasil yang berguna.
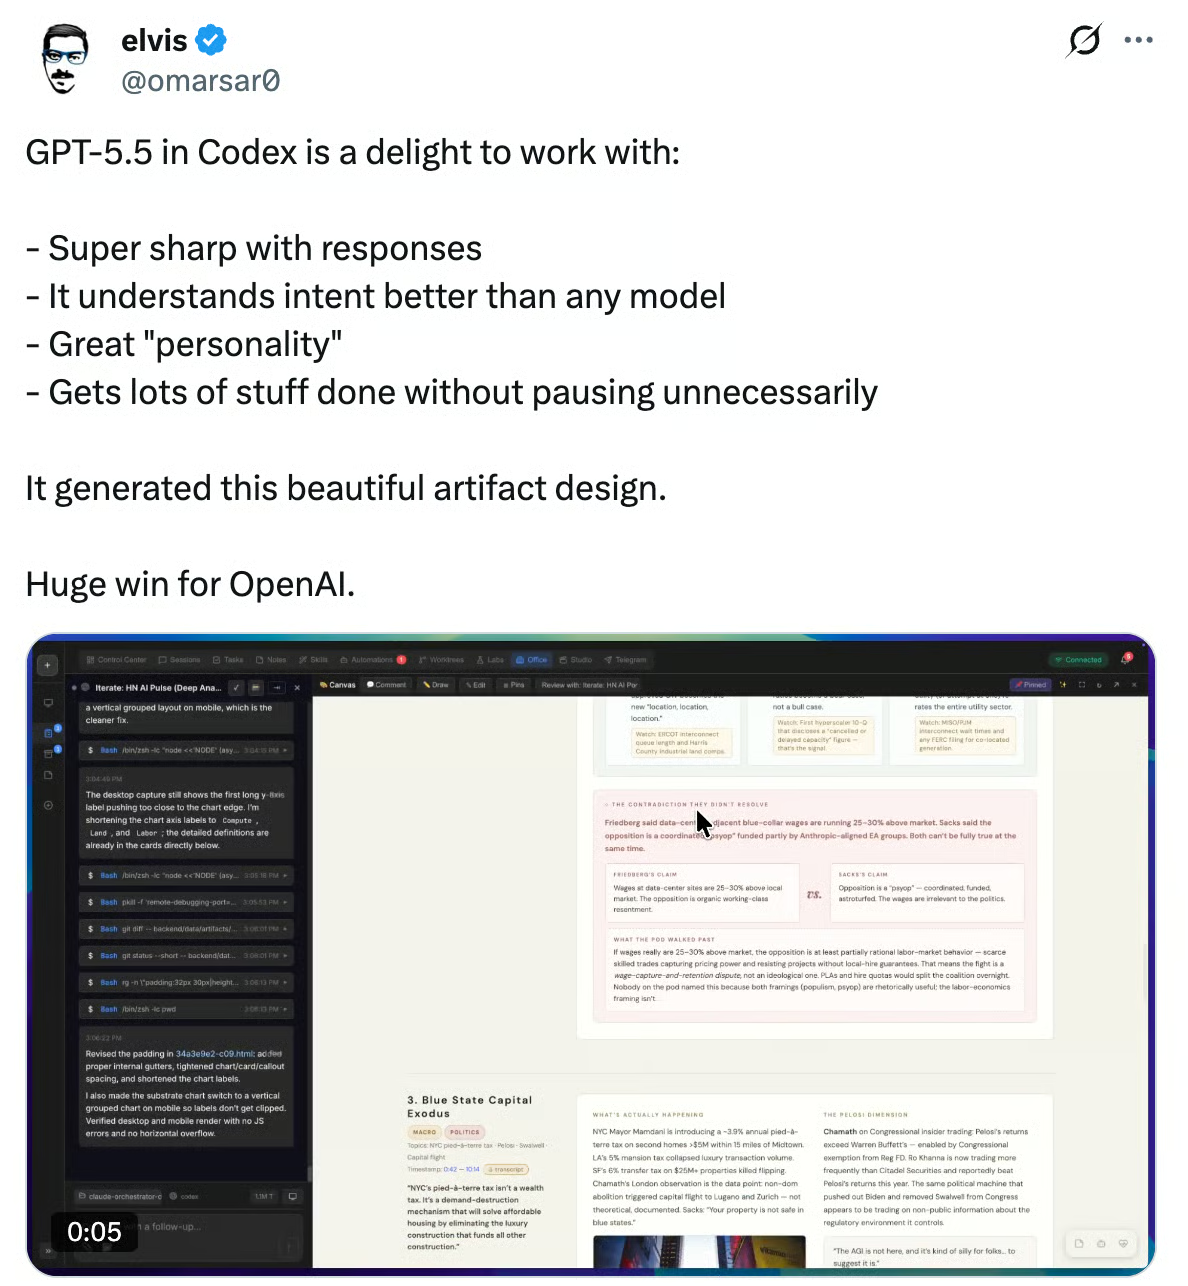
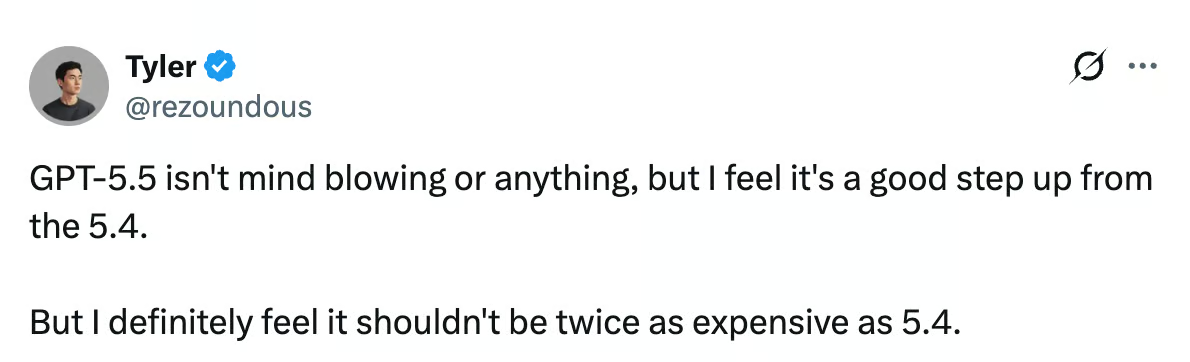
Pengguna lain mencatat bahwa meski mungkin selangkah lebih maju dari GPT-5.4, peningkatan tersebut mungkin belum cukup untuk membenarkan kenaikan harga yang signifikan.
GPT-5.5 adalah pembaruan kapabilitas yang bersifat inkremental dipasangkan dengan pembaruan kebijakan yang tidak inkremental. Model ini lebih cepat, lebih murah per tugas, dan secara berarti lebih baik untuk pekerjaan konteks panjang. Kita dapat melihat klaim ini dengan jelas pada hasil tolok ukurnya.
Uji kami sendiri memberikan gambaran yang lebih bernuansa. Peningkatan konteks panjang itu nyata, dan GPT-5.5 memenuhi semua 12 batasan dalam uji mengikuti instruksi kami (prompt di mana baik Claude Opus 4.7 maupun Sonnet 4.6 mencetak 11/12), namun peningkatan efisiensi datang dengan biaya: GPT-5.5 berulang kali gagal pada tugas penjumlahan yang dapat ditangani GPT-5.4 setelah pemisahan prompt sederhana. Ini menyiratkan ada trade-off antara keringkasan keluaran dan performa penalaran.
Rilis ini juga merupakan pertama kalinya OpenAI secara formal membuat tingkat akses keamanan siber berdasarkan siapa yang meminta, yang merupakan perkembangan menarik bagi industri secara keseluruhan.
Jika Anda menggunakan ChatGPT atau Codex, Anda memiliki akses ke model baru hari ini. Jika Anda pengguna API, Anda masih menunggu, yang, seperti kami catat, bukan kebiasaan OpenAI, tetapi kemungkinan segera hadir.
Belajar bersama DataCamp
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



