Program
Dasar-Dasar Bisnis Kecerdasan Buatan
12 jam
QwQ-32B bukan sekadar model AI bergaya chatbot—model ini berada dalam kategori berbeda: model penalaran.
Sementara sebagian besar model AI serbaguna, seperti GPT-4.5 atau DeepSeek-V3, dirancang untuk menghasilkan teks percakapan yang mengalir di berbagai topik, model penalaran berfokus pada penguraian masalah secara logis, menempuh langkah-langkah tertentu, dan sampai pada jawaban yang terstruktur.
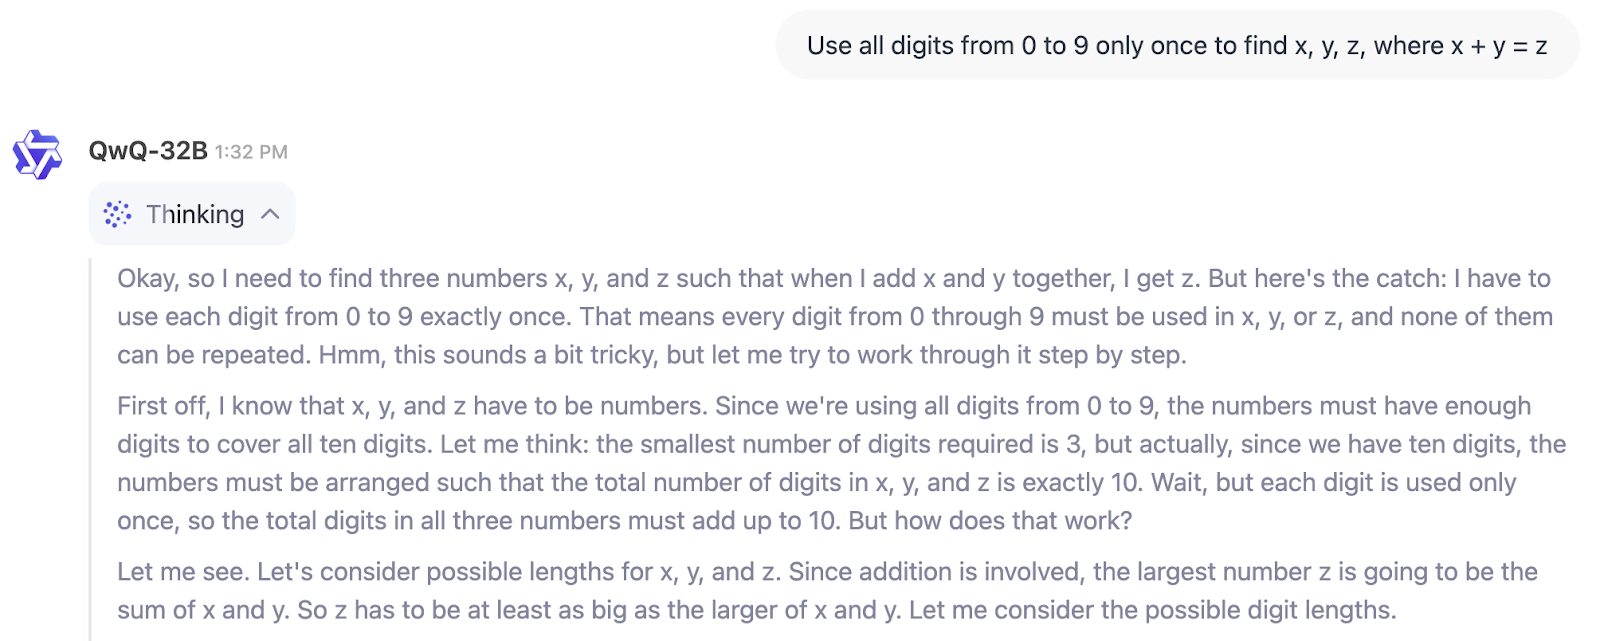
Pada contoh di bawah, kita dapat melihat langsung proses berpikir QwQ-32B:
Jadi, siapa yang cocok menggunakan QwQ-32B? Jika Anda mencari model untuk membantu menulis, brainstorming, atau meringkas, ini bukan pilihannya.
Namun jika Anda membutuhkan sesuatu untuk menangani masalah teknis, memverifikasi solusi bertahap, atau membantu di bidang seperti riset ilmiah, keuangan, atau pengembangan perangkat lunak, QwQ-32B dirancang untuk penalaran terstruktur seperti itu. Model ini sangat berguna bagi insinyur, peneliti, dan pengembang yang memerlukan AI yang mampu menangani alur kerja logis, bukan sekadar menghasilkan teks.
Ada juga tren industri yang lebih luas untuk diperhatikan. Mirip dengan bangkitnya small language models (SLM), dengan QwQ-32B kita mungkin sedang menyaksikan kemunculan “small reasoning models” (istilah ini saya karang sendiri). Mengapa saya mengatakan demikian? Ada perbedaan hingga 20 kali lipat antara 671B parameter pada DeepSeek-R1 dan 32B pada QwQ-32B, namun QwQ-32B tetap mendekati performanya (sebagaimana akan kita lihat di bagian tolok ukur di bawah).
QwQ-32B dibangun untuk bernalar melalui masalah kompleks, dan sebagian besar kemampuannya berasal dari cara pelatihannya. Berbeda dengan model AI tradisional yang hanya mengandalkan pra-pelatihan dan fine-tuning, QwQ-32B menggabungkan reinforcement learning (RL), metode yang memungkinkan model menyempurnakan penalarannya dengan belajar dari coba-coba.
Pendekatan pelatihan ini semakin populer di bidang AI, dengan model seperti DeepSeek-R1 menggunakan pelatihan RL multi-tahap untuk mencapai kemampuan penalaran yang lebih kuat.
Kebanyakan model bahasa belajar dengan memprediksi kata berikutnya dalam kalimat berdasarkan sejumlah besar data teks. Meskipun efektif untuk kefasihan berbahasa, cara ini tidak serta-merta membuatnya mahir memecahkan masalah.
Reinforcement learning mengubah ini dengan memperkenalkan sistem umpan balik: alih-alih hanya menghasilkan teks, model mendapatkan ganjaran saat menemukan jawaban yang tepat atau mengikuti jalur penalaran yang benar. Seiring waktu, ini membantu AI mengembangkan penilaian yang lebih baik saat menghadapi masalah kompleks seperti matematika, pengkodean, dan penalaran logis .
QwQ-32B melangkah lebih jauh dengan mengintegrasikan kemampuan terkait agen, yang memungkinkannya menyesuaikan penalaran berdasarkan umpan balik lingkungan. Artinya, alih-alih sekadar menghafal pola, model dapat menggunakan alat, memverifikasi keluaran, dan menyempurnakan responsnya secara dinamis. Peningkatan ini membuatnya lebih andal untuk tugas penalaran terstruktur, di mana sekadar memprediksi kata tidaklah cukup.
Salah satu aspek paling mengesankan dari pengembangan QwQ-32B adalah efisiensinya. Meski hanya memiliki 32 miliar parameter, model ini meraih performa yang sebanding dengan DeepSeek-R1, yang memiliki 671 miliar parameter (dengan 37 miliar yang diaktifkan). Ini menunjukkan bahwa penguatan skala reinforcement learning bisa sama berdampaknya dengan memperbesar ukuran model.
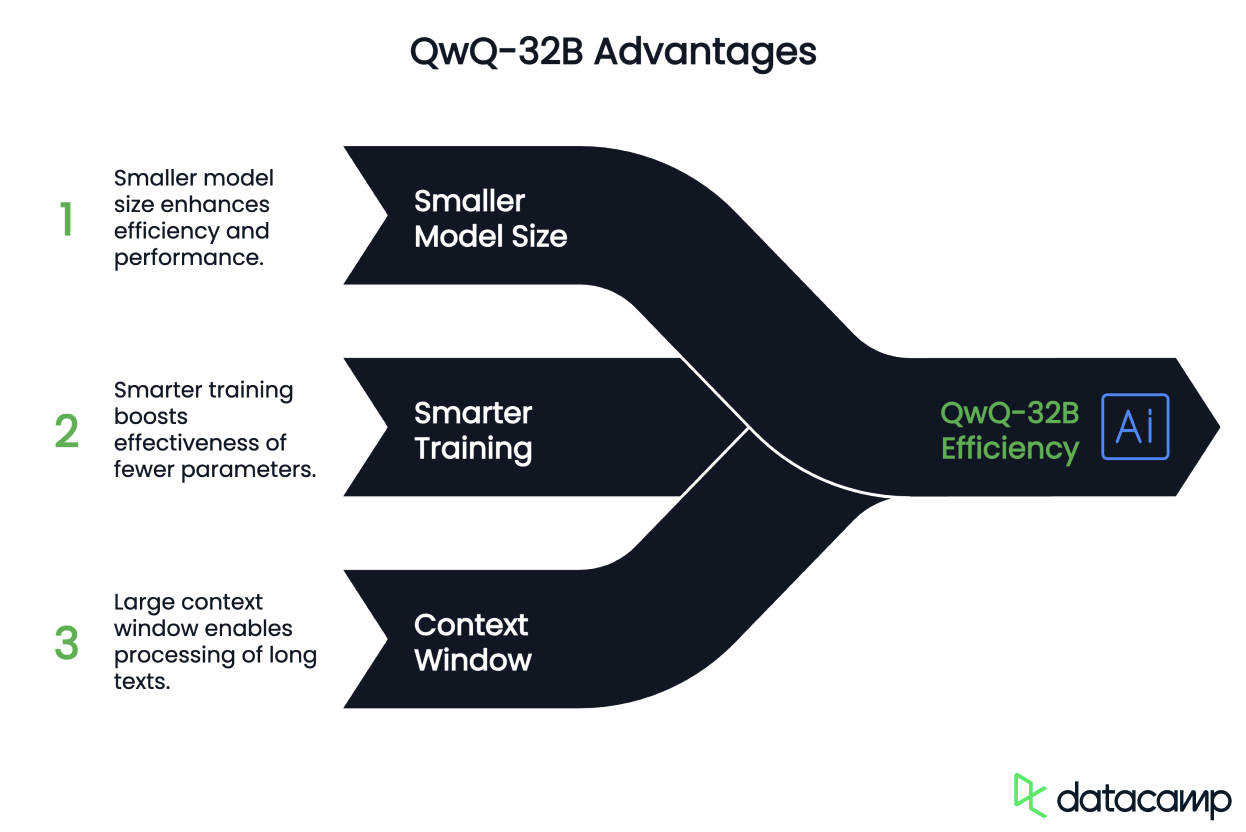
Aspek kunci lain dari desainnya adalah context window 131.072 token, yang memungkinkannya memproses dan mempertahankan informasi pada teks yang panjang.
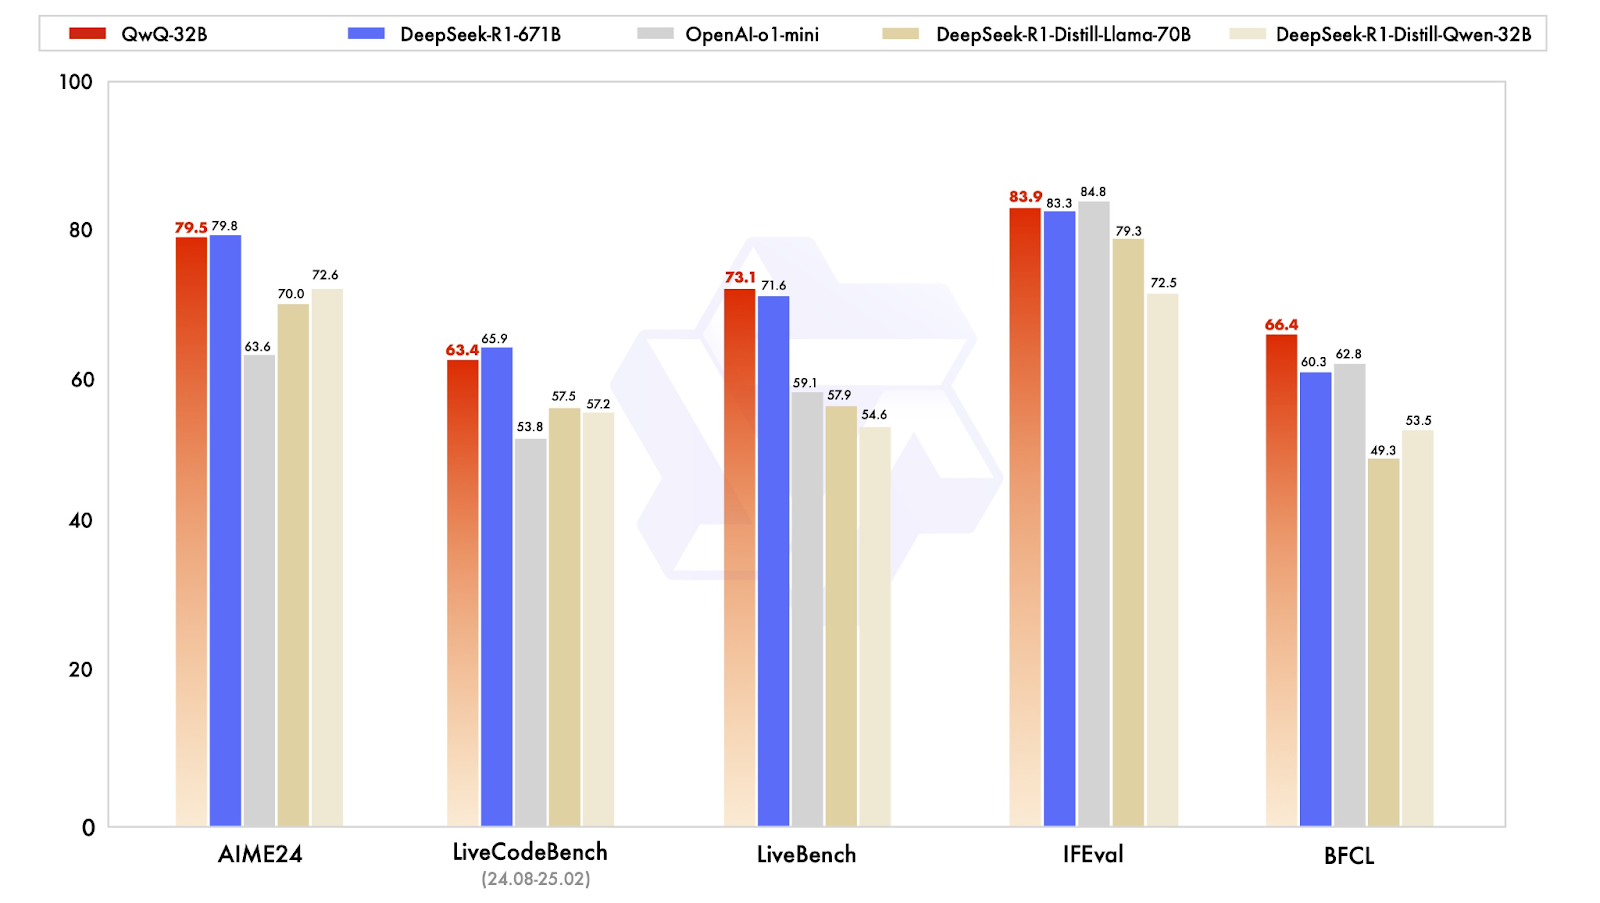
QwQ-32B dirancang untuk bersaing dengan model penalaran mutakhir, dan hasil tolok ukurnya menunjukkan bahwa model ini mendekati DeepSeek-R1 secara mengejutkan, meski ukurannya jauh lebih kecil. Model diuji pada beragam tolok ukur yang mengevaluasi matematika, pengkodean, dan penalaran terstruktur, di mana model ini sering tampil setara atau mendekati tingkat DeepSeek-R1.
Sumber: Qwen
Salah satu hasil paling mencolok berasal dari AIME24, tolok ukur yang dirancang untuk menguji pemecahan masalah matematika. QwQ-32B meraih skor 79,5, tepat di belakang DeepSeek-R1 dengan 79,8 dan jauh di atas o1-mini dari OpenAI (63,6) serta model distilasi DeepSeek (70,0–72,6). Ini sangat impresif mengingat QwQ-32B hanya memiliki 32 miliar parameter dibandingkan 671 miliar pada DeepSeek-R1.
Tolok ukur penting lainnya, IFEval, yang menguji penalaran fungsional dan simbolik, juga menunjukkan QwQ-32B tampil kompetitif, dengan skor 83,9—sedikit di atas DeepSeek-R1! Model ini hanya sedikit di bawah o1-mini dari OpenAI, yang memimpin kategori ini dengan skor 84,8.
Untuk model AI yang ditujukan membantu pengembangan perangkat lunak, tolok ukur pengodean sangat penting. Pada LiveCodeBench, yang mengukur kemampuan menghasilkan dan menyempurnakan kode, QwQ-32B meraih 63,4, sedikit di belakang DeepSeek-R1 dengan 65,9 tetapi jauh di atas o1-mini dari OpenAI dengan 53,8 . Ini menunjukkan bahwa reinforcement learning berperan besar dalam meningkatkan kemampuan QwQ-32B untuk bernalar secara iteratif melalui masalah pengodean, bukan sekadar menghasilkan solusi sekali jadi.
QwQ-32B meraih skor 73,1 pada LiveBench, evaluasi keterampilan pemecahan masalah umum, sedikit melampaui skor DeepSeek-R1 sebesar 71,6. Keduanya jauh melampaui o1-mini dari OpenAI, yang memperoleh 59,1. Hal ini mendukung gagasan bahwa model kecil yang dioptimalkan dengan baik dapat memperkecil kesenjangan dengan sistem kepemilikan berskala besar, setidaknya untuk tugas-tugas terstruktur.
Barangkali hasil paling menarik ada pada BFCL, tolok ukur yang menilai penalaran fungsional secara luas. Di sini, QwQ-32B meraih 66,4, melampaui DeepSeek-R1 (60,3) dan o1-mini dari OpenAI (62,8) . Ini menunjukkan bahwa pendekatan pelatihan QwQ-32B—terutama kemampuan agen dan strategi reinforcement learning—memberinya keunggulan di area yang memerlukan fleksibilitas dan adaptasi, bukan sekadar pola yang dihafal.
QwQ-32B sepenuhnya open-source, menjadikannya salah satu model penalaran berkinerja tinggi yang tersedia bagi siapa pun untuk dieksplorasi. Baik Anda ingin mengujinya secara interaktif, mengintegrasikannya ke dalam aplikasi, atau menjalankannya di perangkat keras sendiri, ada berbagai cara untuk mengakses model ini.
Bagi yang ingin mencoba model tanpa menyiapkan apa pun, Qwen Chat menawarkan cara mudah untuk berinteraksi dengan QwQ-32B. Antarmuka chatbot berbasis web memungkinkan Anda menguji kemampuan penalaran, matematika, dan pengodean model secara langsung. Meskipun tidak seluwes menjalankan model secara lokal, cara ini memberikan gambaran langsung mengenai kekuatannya.
Untuk mencobanya, Anda perlu mengakses https://chat.qwen.ai/ dan membuat akun. Setelah masuk, mulai dengan memilih model QwQ-32B di menu pemilih model:
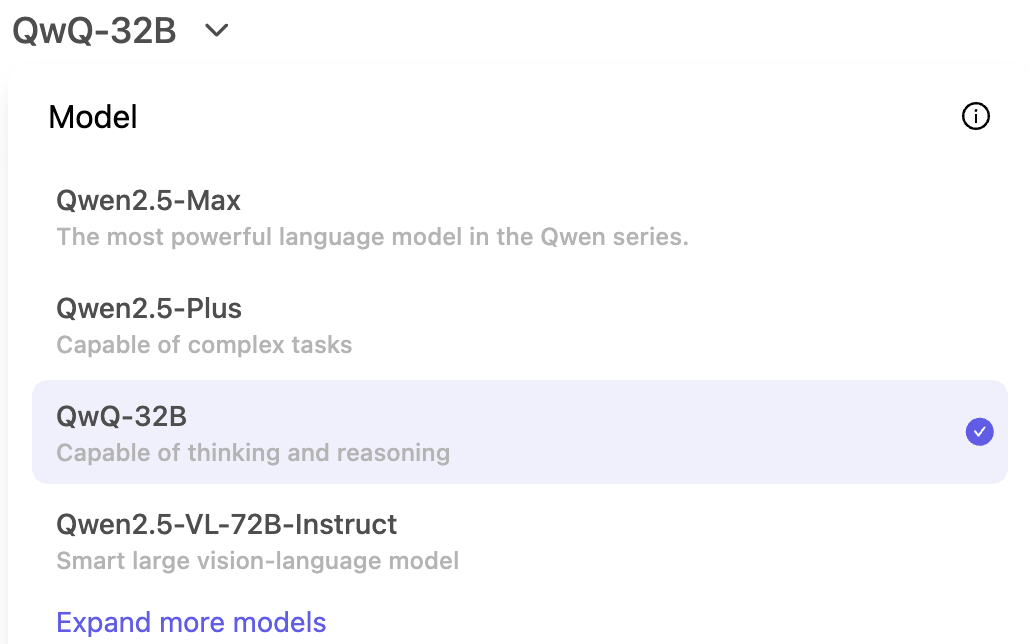
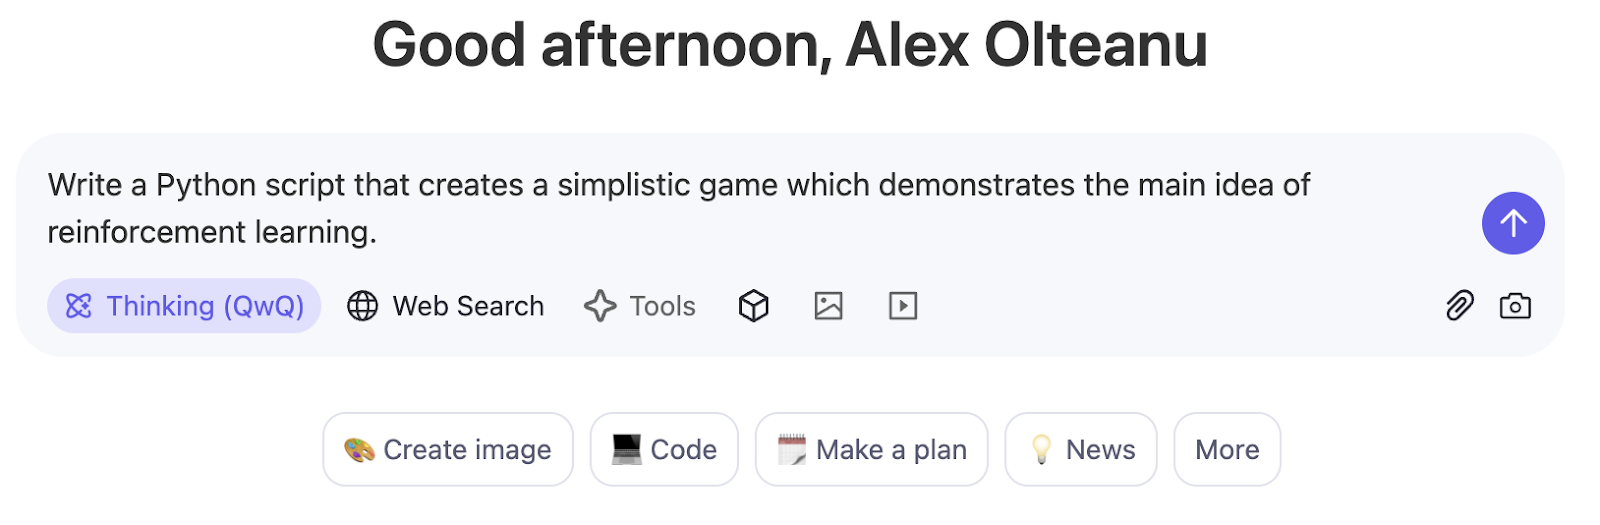
Mode Thinking (QwQ) aktif secara default dan tidak dapat dimatikan pada model ini. Anda dapat mulai memberi prompt di antarmuka berbasis chat:
Pengembang yang ingin mengintegrasikan QwQ-32B ke alur kerja mereka dapat mengunduhnya dari Hugging Face atau ModelScope. Platform ini menyediakan akses ke bobot model, konfigurasi, dan alat inferensi, sehingga memudahkan penerapan model untuk riset atau produksi.
QwQ-32B menantang anggapan bahwa hanya model raksasa yang dapat tampil baik dalam penalaran terstruktur. Meski jauh lebih sedikit parameternya dibandingkan DeepSeek-R1, model ini memberikan hasil kuat dalam matematika, pengodean, dan pemecahan masalah bertahap, menunjukkan bahwa teknik pelatihan seperti reinforcement learning dan optimasi konteks panjang dapat berdampak signifikan.
Yang paling menonjol bagi saya adalah ketersediaannya sebagai open-source. Sementara banyak model penalaran berkinerja tinggi tetap terkunci di balik API kepemilikan, QwQ-32B dapat diakses di Hugging Face, ModelScope, dan Qwen Chat, sehingga lebih mudah bagi peneliti dan pengembang untuk menguji dan membangun dengannya.
Pelajari AI dengan kursus-kursus ini!
Program
Program
Program
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




