
什么是 QwQ-32B?
QwQ-32B 不只是常见的聊天式 AI 模型——它属于另一个类别:推理模型。
多数通用型 AI 模型(如GPT-4.5 或 DeepSeek-V3)旨在围绕广泛话题生成流畅的对话文本,而推理模型则专注于将问题逻辑拆解、逐步求解,并给出结构化答案。
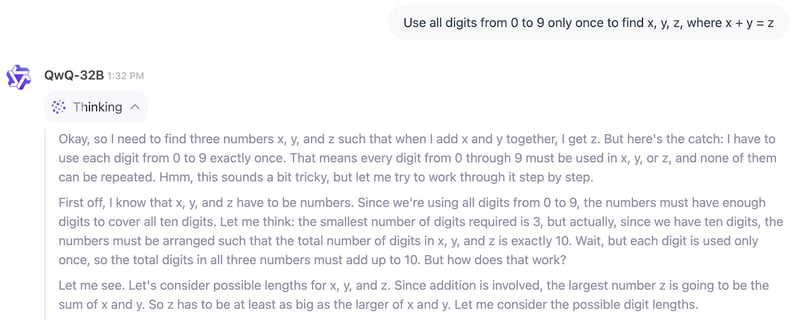
在下面的示例中,我们可以直观看到 QwQ-32B 的思考过程:
那么,谁适合使用 QwQ-32B?如果您想找一个写作、头脑风暴或摘要的模型,这不是合适的选择。
但如果您需要解决技术问题、验证多步解法,或在科学研究、金融、软件开发等领域获得辅助,QwQ-32B 正是为这类结构化推理而生。它对工程师、研究人员和开发者尤其有用,因为他们需要的是能处理逻辑流程而非仅仅生成文本的 AI。
还需注意更广泛的行业趋势。类似于小型语言模型(SLM)的兴起,我们或许正在 QwQ-32B 身上见证“小型推理模型”的出现(这个术语是我现编的)。为什么这么说?因为 DeepSeek-R1 的 6710 亿参数与 QwQ-32B 的 320 亿之间相差 20 多倍,但 QwQ-32B 的性能仍然相当接近(如下方基准测试部分所示)。
QwQ-32B 的架构
QwQ-32B 旨在对复杂问题进行推理,其中很大一部分源自其训练方式。不同于仅依赖预训练和微调的传统模型,QwQ-32B 引入了强化学习(RL),这一方法通过试错学习帮助模型优化推理能力。
这一训练思路在 AI 领域日益受到重视,如 DeepSeek-R1 便采用多阶段 RL 训练来强化推理能力。
强化学习如何提升 AI 的推理
大多数语言模型通过在海量文本上预测下一个词来学习。虽然这种方式能带来良好的流畅度,但并不一定擅长解决问题。
强化学习通过引入反馈机制改变了这一点:模型不再只是生成文本,而是因找到正确答案或遵循正确的推理路径而获得奖励。久而久之,这有助于 AI 在处理数学、编程和逻辑推理等复杂问题时形成更好的判断。
QwQ-32B 更进一步,融入了与智能体相关的能力,使其能根据环境反馈调整推理。这意味着模型不只是记忆模式,还能使用工具、校验输出,并动态优化回答。这些改进让它在结构化推理任务中更可靠,仅靠词语预测已远远不够。
更小的模型,更聪明的训练
QwQ-32B 开发中最令人印象深刻的一点,是其高效性。尽管只有 320 亿参数,它的表现可与参数高达 6710 亿(激活 370 亿)的 DeepSeek-R1 比肩。这表明,扩大强化学习的规模,带来的效果不逊于一味增大模型体量。
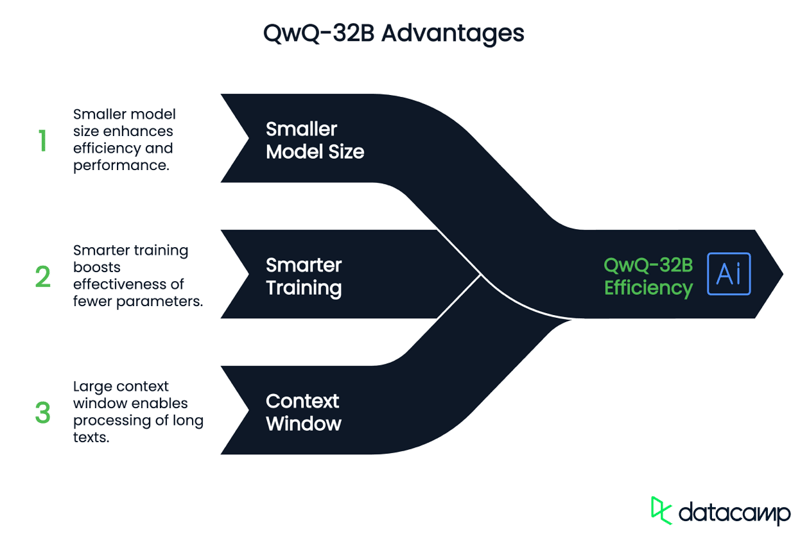
其设计的另一关键点是 131,072-token 的上下文窗口,使模型能够处理并保留长文本中的信息。
QwQ-32B 基准测试
QwQ-32B 旨在与最先进的推理模型竞争,而其基准测试结果显示,尽管体量更小,它的表现已非常接近 DeepSeek-R1。该模型在一系列评估数学、编程与结构化推理的基准上进行了测试,且经常达到或逼近 DeepSeek-R1 的水平。
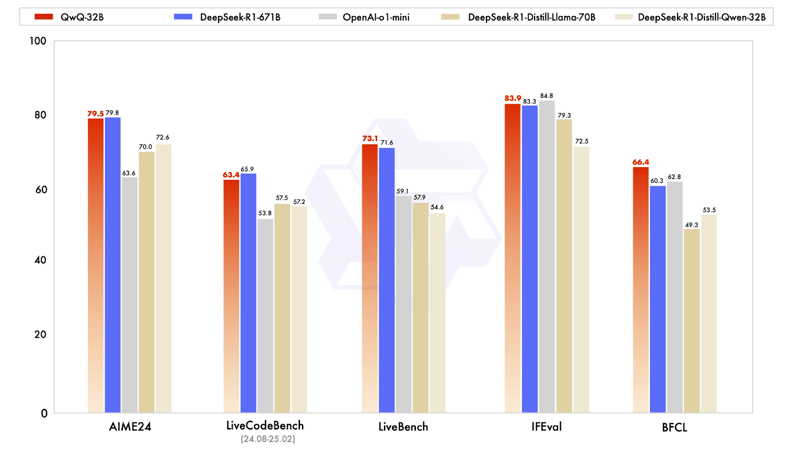
来源: Qwen
数学与逻辑推理表现强劲
最具代表性的结果之一来自 AIME24,这是一项用于测试数学解题能力的基准。QwQ-32B 得分 79.5,略低于 DeepSeek-R1 的 79.8,但明显领先于 OpenAI 的 o1-mini(63.6)及 DeepSeek 的蒸馏模型(70.0–72.6)。考虑到 QwQ-32B 仅有 320 亿参数,而 DeepSeek-R1 多达 6710 亿,这一成绩尤为亮眼。
另一项关键基准 IFEval(测试函数式与符号推理)中,QwQ-32B 也展现了竞争力,得分 83.9——略高于 DeepSeek-R1!但与本项领跑者 OpenAI 的 o1-mini(84.8)相比仍有微弱差距。
编程能力与智能体行为
对于旨在辅助软件开发的 AI 模型,编程基准至关重要。在衡量代码生成与优化能力的 LiveCodeBench 上,QwQ-32B 得分 63.4,略低于 DeepSeek-R1 的 65.9,但显著领先于 OpenAI 的 o1-mini(53.8)。这表明,强化学习在提升 QwQ-32B 迭代式解决编程问题的能力上发挥了重要作用,而非只给出一次性的答案。
QwQ-32B 在 LiveBench(通用问题求解评估)上得分 73.1,略高于 DeepSeek-R1 的 71.6。两者均显著高于 OpenAI 的 o1-mini(59.1)。这进一步支持了这样一种观点:在结构化任务中,小而优化得当的模型也能缩小与大型专有系统之间的差距。
在函数式推理上更胜一筹
或许最有意思的结果来自 BFCL,这是一项评估广义函数式推理的基准。在此,QwQ-32B 取得了 66.4 的成绩,超过了 DeepSeek-R1(60.3)与 OpenAI 的 o1-mini(62.8)。这表明 QwQ-32B 的训练方法,尤其是其智能体能力与强化学习策略,使其在需要灵活性与适应性的解题场景中具备优势,而不仅仅是依赖记忆化的模式。
如何获取 QwQ-32B
QwQ-32B 完全开源,是少数高性能推理模型中可供任何人试验使用的选择之一。无论您想在线交互测试、集成到应用,还是在自有硬件上运行,都有多种途径可获取该模型。
在线与 QwQ-32B 交互
如果您只想在无需配置的情况下试用模型,可以通过 Qwen Chat 轻松与 QwQ-32B 交互。该基于网页的聊天界面可直接测试其推理、数学与编程能力。虽然不如本地运行灵活,但能直观展示其优势。
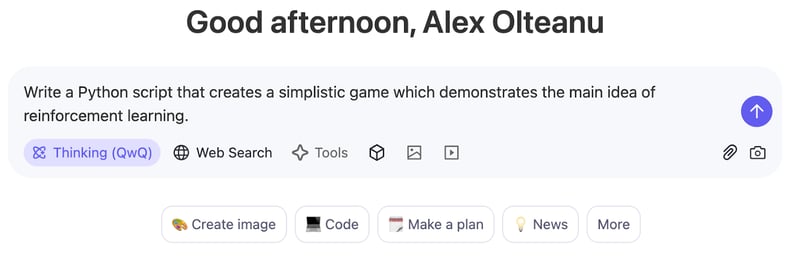
试用需访问 https://chat.qwen.ai/ 并注册账号。登录后,在模型选择菜单中选取 QwQ-32B:
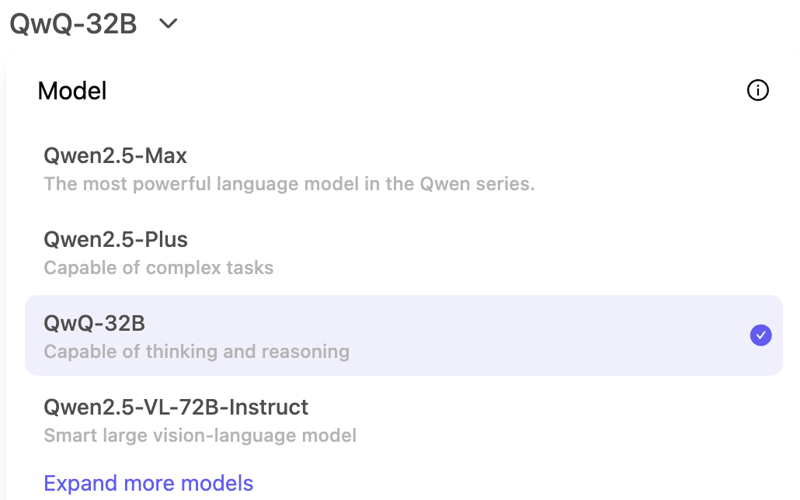
默认会启用思考(QwQ)模式,且在该模型下无法关闭。您可以直接在聊天界面开始提示对话:
从 Hugging Face 与 ModelScope 下载并部署
希望将 QwQ-32B 集成到自有工作流的开发者,可从Hugging Face 或 ModelScope 下载。上述平台提供模型权重、配置与推理工具,便于用于研究或生产部署。
结语
QwQ-32B 挑战了“只有巨型模型才能在结构化推理上表现出色”的观点。尽管参数量远少于 DeepSeek-R1,它在数学、编程与多步问题求解上都有不俗表现,显示出强化学习与长上下文优化等训练技术能带来显著影响。
对我而言,最亮眼的是其开源可用性。许多高性能推理模型仍被锁在专有 API 背后,而 QwQ-32B 可在 Hugging Face、ModelScope 与 Qwen Chat 上获取,便于研究者与开发者测试与构建应用。
常见问答
QwQ-32B 是否免费?
是的,QwQ-32B 完全开源,您可以通过 Hugging Face 和 ModelScope 等平台免费获取。不过,在本地运行或用于生产可能需要较高的硬件资源,从而带来额外成本。
QwQ-32B 能否进行微调?
可以。由于 QwQ-32B 开放权重,您可以针对特定任务进行微调。但对这一规模的模型进行微调需要强大的 GPU 与结构良好的数据集。部分平台(如 Hugging Face)提供参数高效微调工具,以降低计算成本。
能否在本地运行 QwQ-32B?
可以,但取决于您的硬件。由于 QwQ-32B 是致密的 320 亿参数模型,高效运行通常需要高端 GPU 配置,最好是多张 A100 或 H100。对于较小配置,量化等技术可降低内存需求,但性能可能有所折衷。
能通过 API 使用 QwQ-32B 吗?
目前通义尚未提供 QwQ-32B 的官方 API,但第三方平台可能提供托管的 API 访问。若要直接使用,您需要通过 Hugging Face 或 ModelScope 下载并手动运行模型。
QwQ-32B 是否多模态?
不是。QwQ-32B 是专注于推理与问题求解的纯文本模型。与 GPT-4o 等模型不同,它不处理图像、视频或音频。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。
随着QwQ-32B 的发布,阿里巴巴通义团队再次证明了其在 AI 领域的强劲竞争力。该模型的性能接近DeepSeek-R1 等领先推理模型,但体量仅为对方的一小部分——QwQ-32B 为 320 亿参数,而 DeepSeek 为 6710 亿。
如果您觉得 QwQ-32B 这个名字眼熟,那是因为它基于我们此前在这篇博客中测试过的 QwQ-32B-Preview:QwQ-32B-Preview。如今,随着正式版本的发布,通义团队进一步打磨了方法,强化了模型的推理能力,并将其以开源形式广泛开放。
在这篇文章中,我将去伪存真,梳理 QwQ-32B 的关键信息——它如何工作、与其他模型相比表现如何、以及如何获取使用。